Artificial Analysis · X更新于

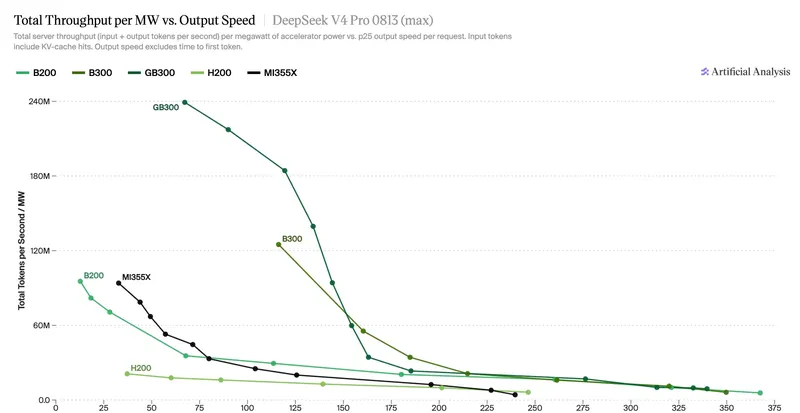
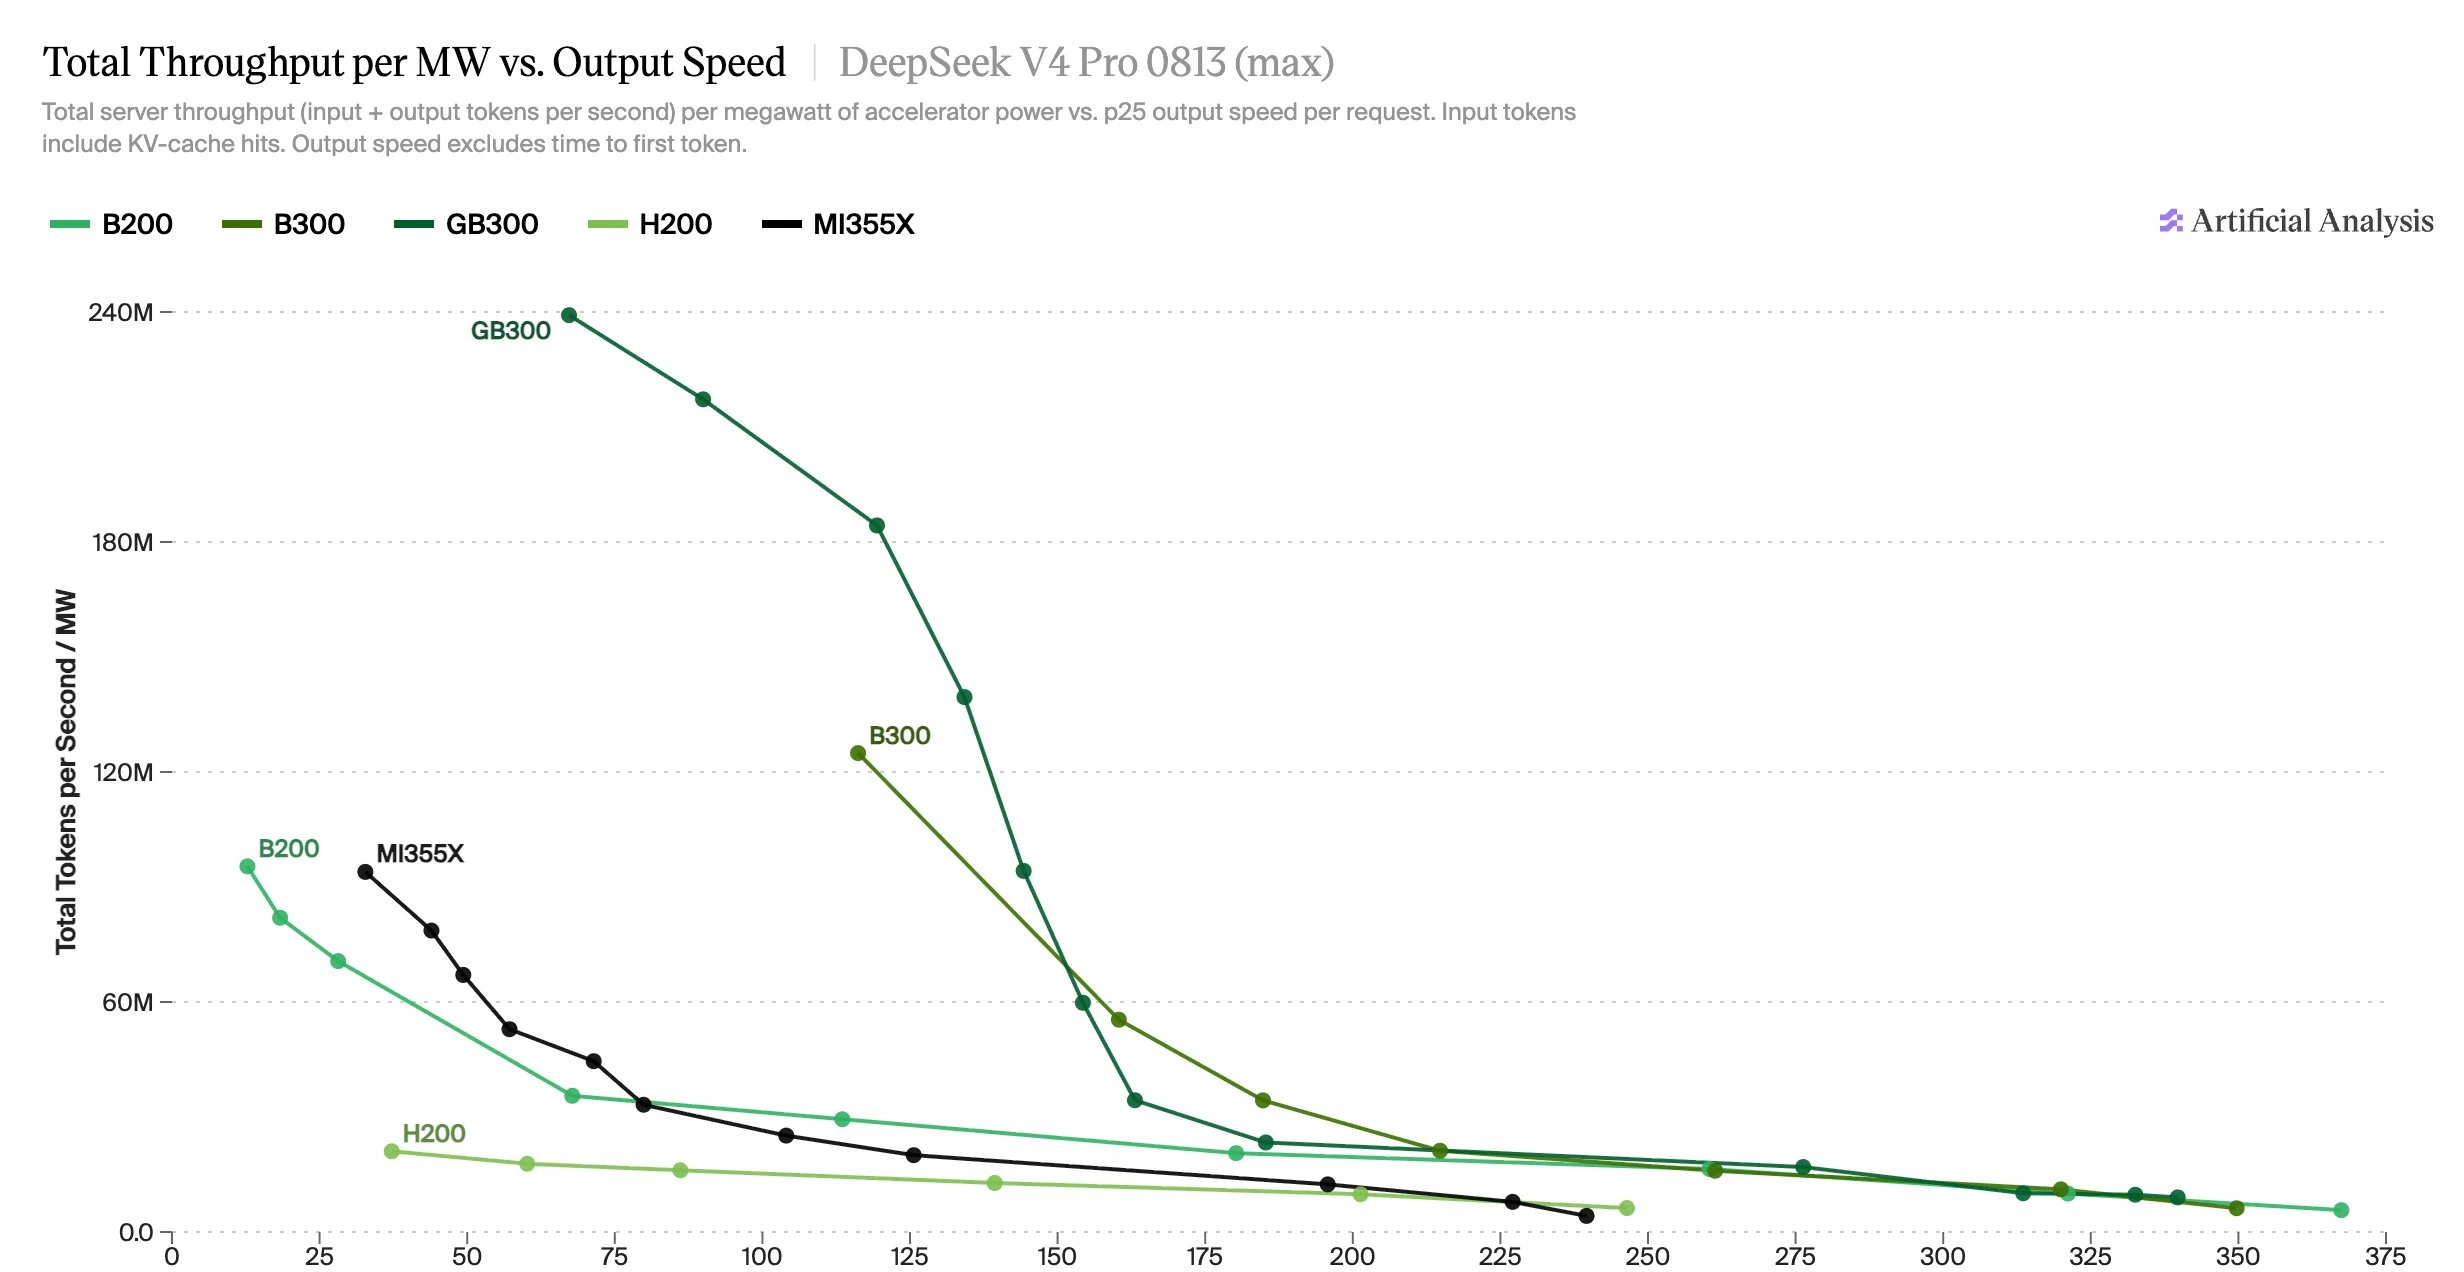
MI355X 在 DeepSeek V4 Pro 0813 上表现最强。在每用户 35 到 75 tok/s 之间,其每 MW 吞吐量比 B200 高约 15% 到 40%……

Artificial Analysis实测,在DeepSeek V4 Pro 0813服务中,MI355X在每用户35至75 tok/s区间每MW吞吐比B200高约15%到40%,峰值约94M tokens/s per MW(33 tok/s每用户),但超过约80 tok/s后B200反超,单agent为240 tok/s对367 tok/s,而B300双8-GPU节点配置可达125M tokens/s per MW。

配图来源 · Artificial Analysis · X

MI355X 在 DeepSeek V4 Pro 0813 上表现最强。在每用户 35 到 75 tok/s 之间,其每 MW 吞吐量比 B200 高约 15% 到 40%,在每用户 33 tok/s 时达到峰值约 94M tokens/s per MW,这一水平 B200 只有在 13 tok/s 时才能达到。在每用户约 80 tok/s 以上,B200 开始领先,而对于单个 agent,差距变为 MI355X 的 240 tok/s 对 B200 的 367 tok/s。其他 NVIDIA 硬件的分离式多节点配置大多高于两者,例如 B300 使用两个 8-GPU 节点在每用户 116 tok/s 时达到每 MW 125M tokens/s。
原始出处

Artificial Analysis · X

内容说明

原始发布及相关权利归来源方。

机器翻译 · 请以原文为准