
核心要点
- 评估(Evals)会对你的 agent 的运行结果打分,以便你检查它的行为是否符合预期。 入门时,选择一种行为,从真实的 trace 中构建一个小数据集,并运行一个基线。上线前使用离线评估,生产环境中使用在线评估,并把新出现的失败转化为数据集示例。
- 能用代码评估器就用代码评估器,不能用时用 LLM 评审,再用人工检查来校验两者。 对于需要多个步骤的 agent,要评估完整的对话线程、轨迹和最终状态。
- 像 Terminal-Bench 这样的基准测试是离线评估,任务更长并有各自的环境。 Harbor 运行这些测试,并将结果记录到 LangSmith 实验中。
在你构建和发布 agent 的过程中,你需要一种方法来检查它的行为是否符合预期,无论是在开发阶段,还是在真实用户开始依赖它之后。
在传统软件中,相同的输入会产生相同的输出,因此单元测试可以检查精确的结果。而 agent 则因以下几个原因更难测试:
- 输出在多次运行之间会有变化,即使是同一个请求
- 多个答案都可能正确,因此检查完全匹配是不够的
- agent 会自行选择步骤,因此即使输出正确,也可能来自“错误”的路径。例如,agent 可能调用了并不需要的工具,或未经用户许可就执行了某个操作。
Agent 评估就是解决方案。它们会对 agent 的运行结果打分,且这些检查会考虑到上述各种变化。与它们所评估的 agent 类似,这些测试并不是万能的,最佳的评估套件取决于团队、他们的产品以及他们想要优化的目标。
在过去几年中,我们在开发 LangSmith(LangChain 的 agent 工程平台)的过程中,团队遇到了 许多 不同的评估问题。本文将介绍一些关于如何开始使用 agent 评估的最常见问题,以及你可以在工作流中使用的不同类型的评估。
我们应该从哪里开始?
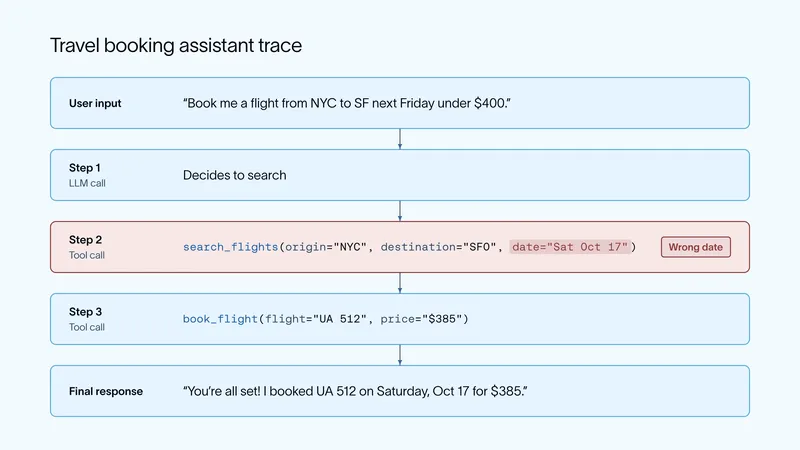
每一次评估都始于理解你的 agent 实际做了什么。trace 是 agent 一次运行的记录,包括它的输入、输出以及中间的每一次模型和工具调用。阅读一部分 trace 样本,看看它如何处理请求以及在哪里出错。你发现的问题会告诉你应该首先测试什么。从小处着手。
- 选择一种你关心的行为。 例如,对于一个旅行助手,一种行为可以是它是否按照用户要求的日期和价格范围进行预订。
- 从 trace 中构建一个小数据集。 数据集是一组示例的集合,每个示例都是一个单独的测试用例,包含一个输入,通常还有一个期望输出。十到二十个某行为的示例就足以开始,在 LangSmith 中,你可以直接从 tracing 视图将 trace 添加到数据集。如果你的 agent 还没有上线,可以让你的团队或一小群可信的设计合作伙伴进行测试(即 dogfooding),并基于这些 trace 开展工作。
- 运行一个基线。 用当前版本的 agent 对数据集进行运行,并将结果保存为一个实验。实验包含在数据集上运行某一版本 agent 的结果,以及你的评估器给出的分数。之后你将用这个实验来比较未来版本 agent 的性能。
- 发现新的失败就添加进来。 你在生产环境或测试中看到的每一个失败都会成为一个新的示例。
持续向数据集中添加失败案例,你就拥有了一个改进循环。找到一个失败,将其添加到数据集中,改进智能体,然后重新运行。随着你识别出更多需要评估的智能体行为,你将按照上述相同的模式扩展你的评估套件。
离线评估和在线评估有什么区别?
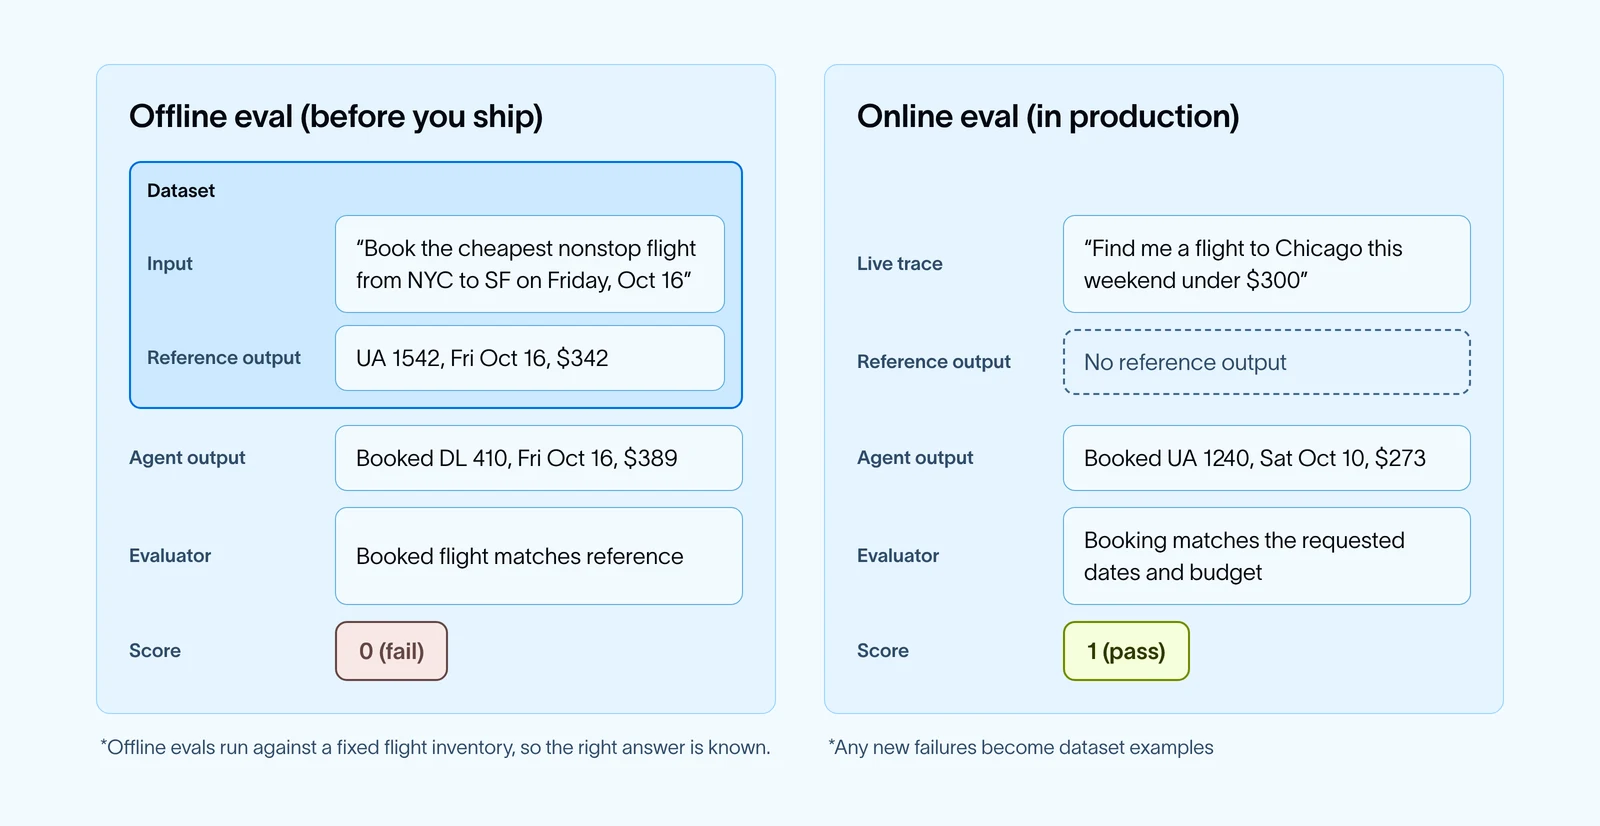
评估可以而且应该在发布更改之前以及智能体上线之后运行。发布之前,评估可以告诉你某个更改是让智能体变好了还是变差了。发布之后,评估可以告诉你智能体在真实用户中的表现如何。
离线评估 在 你发布更改之前 针对数据集运行你的智能体。你可以选择示例输入,还可以包含预期输出(也称为参考输出)。利用数据集,你可以比较不同智能体版本之间的实验结果。它们最适合用于测试新的提示词、模型或工具,并在问题到达用户之前捕获回归。
像 Terminal-Bench 这样的基准测试也是离线评估,它们建立在一组固定任务之上,以便你比较智能体、模型或版本。Harbor 会运行它们并将结果记录到 LangSmith 实验中,我们将在下文更详细地介绍。
在线评估 在真实生产轨迹进入时 对它们进行评分。通常没有参考输出可供比较,因此它们依赖于代码检查和 LLM 判官来独立对运行进行评分。它们最适合用于监控质量,并找出你的数据集遗漏的问题。
两者都需要,而且它们相互促进。在线评估标记出的失败会成为你离线数据集中的新示例。
在 LangSmith 中 构建数据集 进行离线评估有几种方法。你可以从头编写示例,从现有轨迹中添加运行记录,发送你的团队在 标注队列中审查过的运行记录,上传 CSV 或 JSONL 文件,或者根据已有的一些示例生成合成示例。
随着评估套件的增长,你需要决定是向现有数据集添加示例,还是创建一个新数据集。经验法则如下:
- 将示例保留在 同一数据集中 ,前提是它们使用相同的评估器测试相同的行为,这样实验结果才能长期保持可比性。
- 在以下情况创建 新数据集 :输入看起来不同(比如单个请求 vs 完整对话)、需要不同的评估器,或者数据集服务于不同目的,比如每次拉取请求时运行的小型集合 vs 发布前运行的大型集合。
在单个数据集内,你还可以使用 splits 来运行一部分示例。
有哪些不同类型的智能体评估器?
评估器是为一次运行打分的逻辑。常见的有四种类型。大多数团队先从一到两种开始,再随时间逐步增加。
- 代码评估器 以确定性的方式检查事项,比如预订价格是否低于用户的预算。它们快速、廉价且一致,但对确定性输入和输出的需求限制了其用处。
- LLM-as-a-judge 使用模型来评判代码无法判断的事情,比如助手的回复是否清楚地确认了航班细节。
- 人工审核 由你的团队或领域专家直接为运行打分。它较慢,但对于主观质量以及校验其他评估器而言,这是最佳的信号来源。它通常用于较小的样本,进而指导 LLM 评估器的判断。
- 成对评估器 将两个输出并排比较并选出更好的一个,这在两个提示词或两个模型之间做选择时很有用。
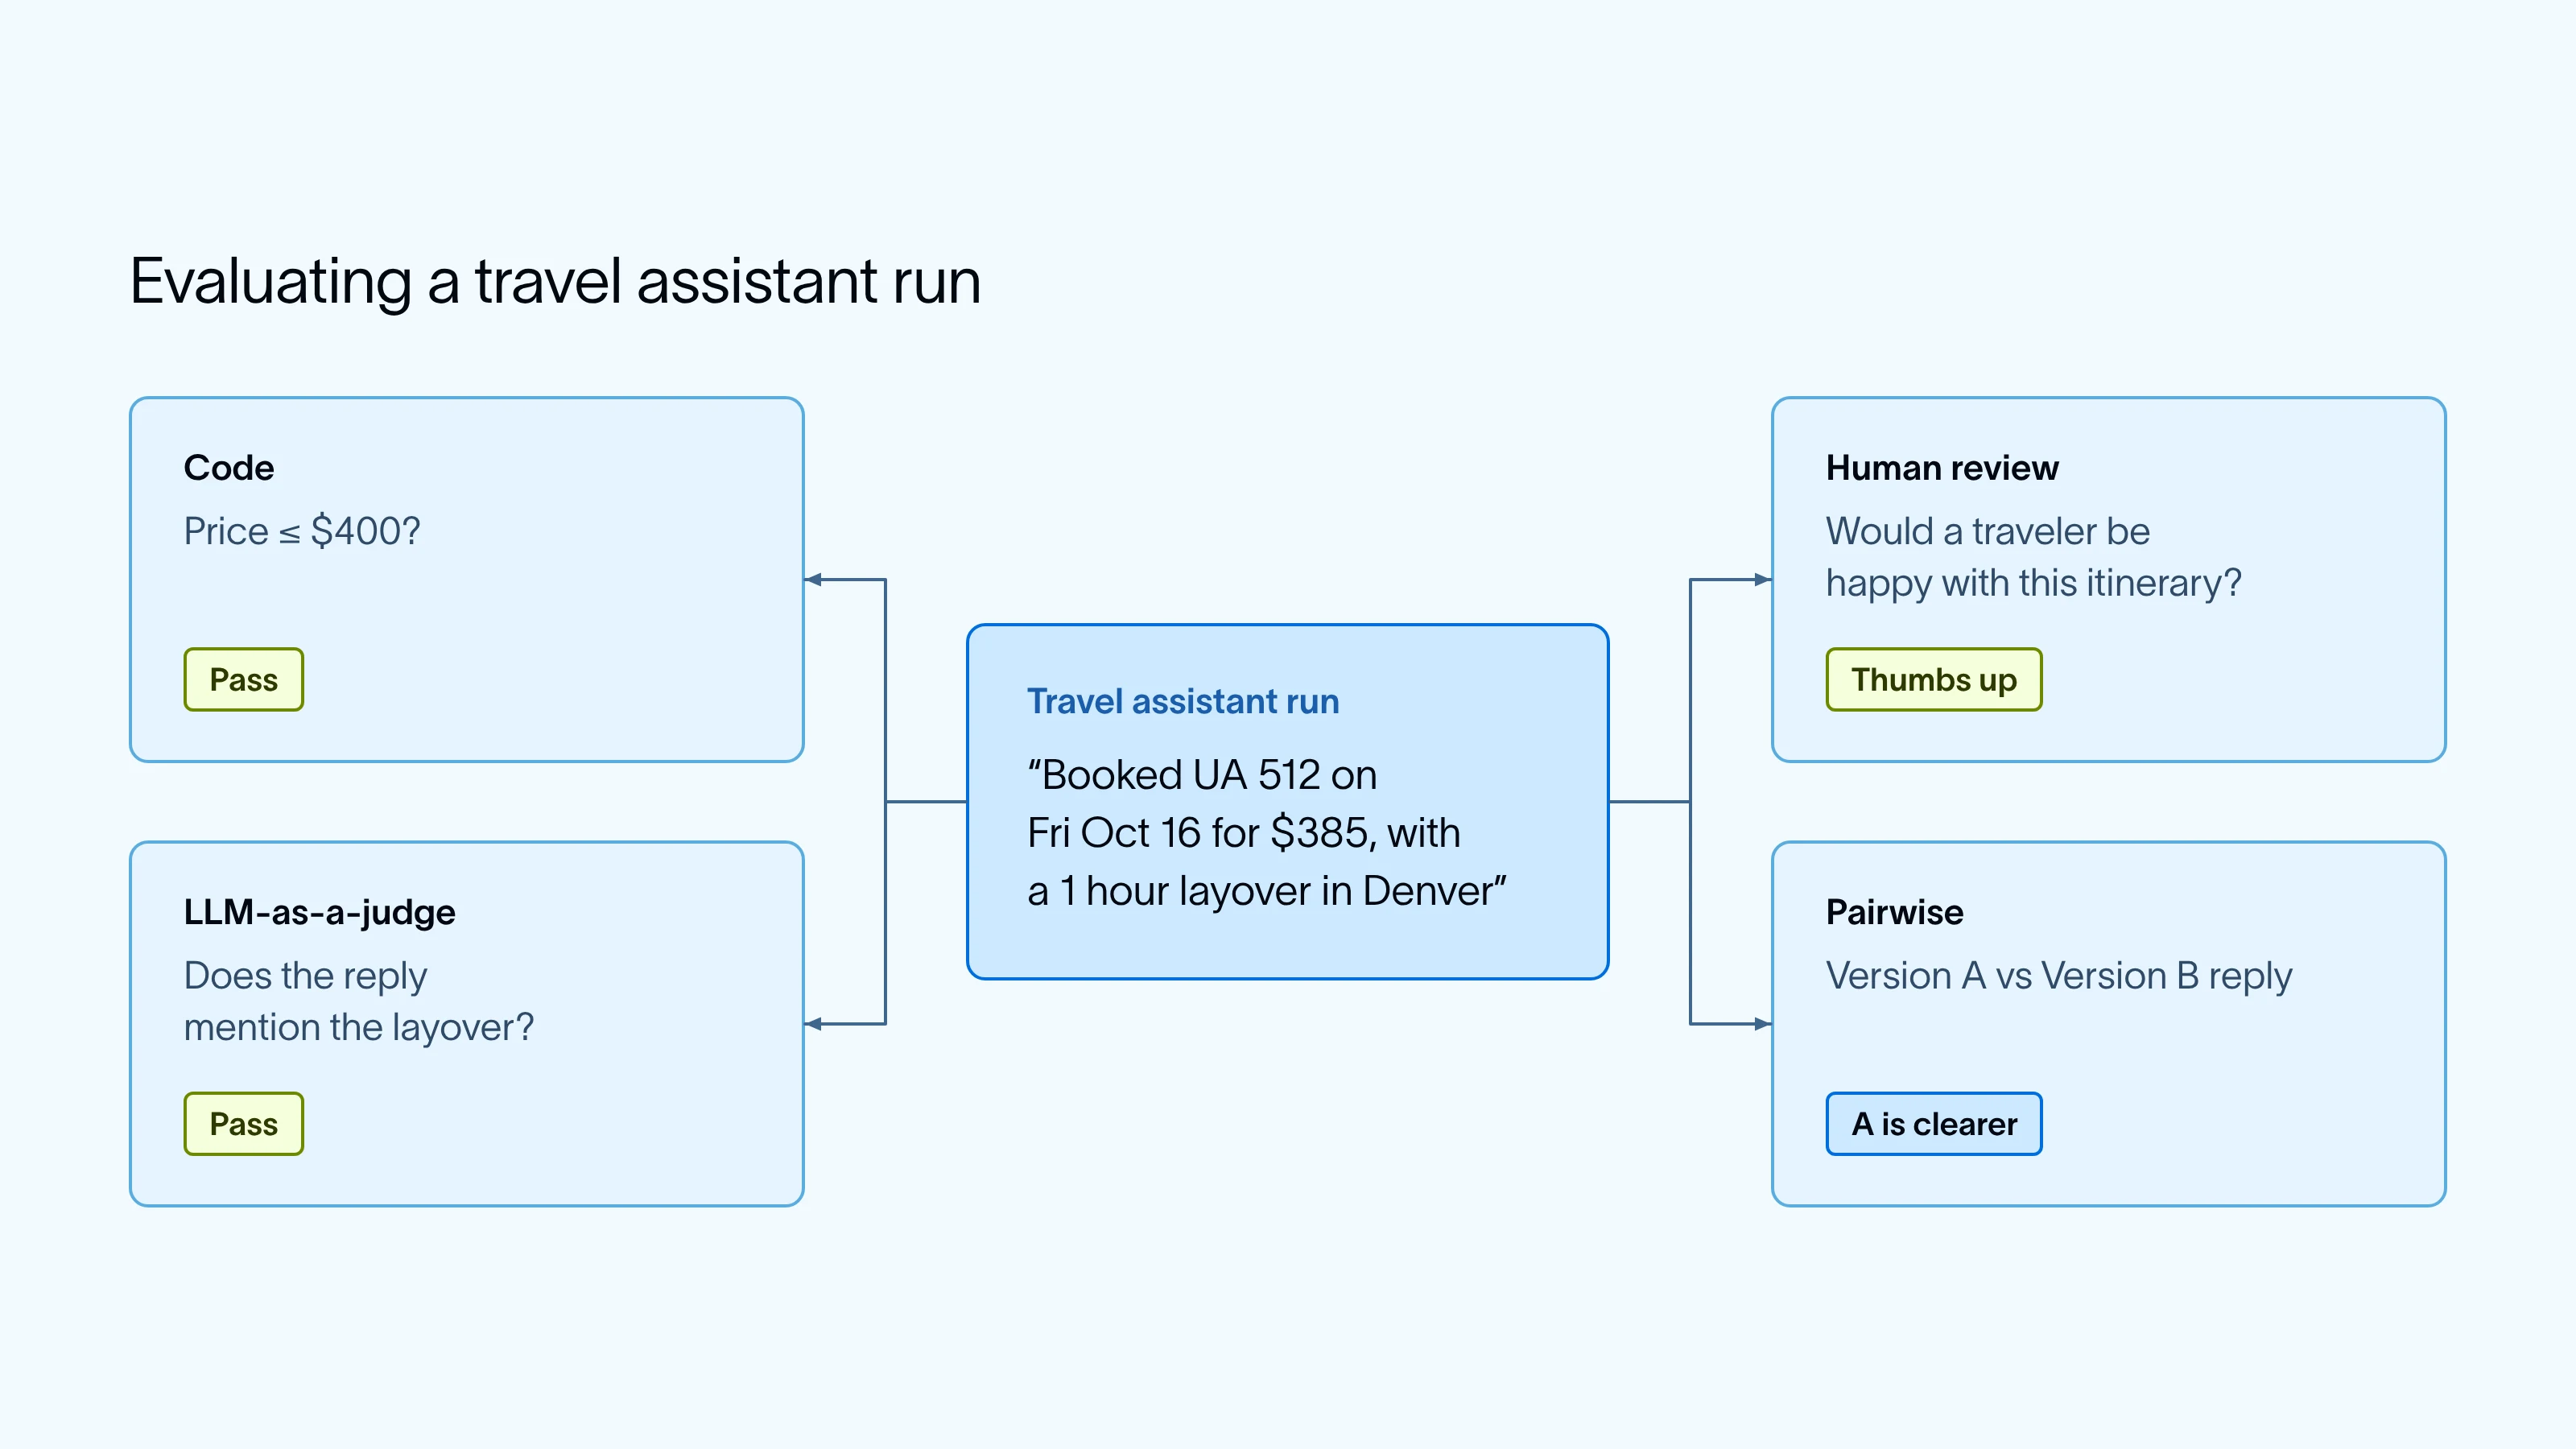
这些评估器中的任何一个都可以指向智能体运行的不同部分。一次评估可以打分的对象包括:
- 单个步骤。 例如,是否
search_flights以正确的日期被调用。 - 最终响应。 例如,回复是否确认了智能体实际预订的航班。
- 完整对话。 例如,最终预订是否反映了用户在多轮对话中要求的每一项变更
- 环境最终状态。 例如,智能体在自己的容器中运行后,模拟预订系统中的预订记录。基准测试通常使用这种设置,你有时会听到它们被称为容器化评估。
你能信任一个 LLM 评委吗?
LLM 评委使用模型来评判难以用代码检查的输出,比如一个答案是否得到检索文档的支持。评委很灵活,但它们可能不一致,并偏离团队的判断。以下几个习惯能让它们变得可靠:
- 将评委的评分与人工评分进行比较。 让团队中的某人对一部分运行样本进行评分,并检查裁判在哪些地方不一致。调整裁判的提示词或示例,直到两者对齐为止。 标注队列 在 LangSmith 中让这一切变得简单。我们的 LLM-as-a-judge 文档 为您逐步讲解。
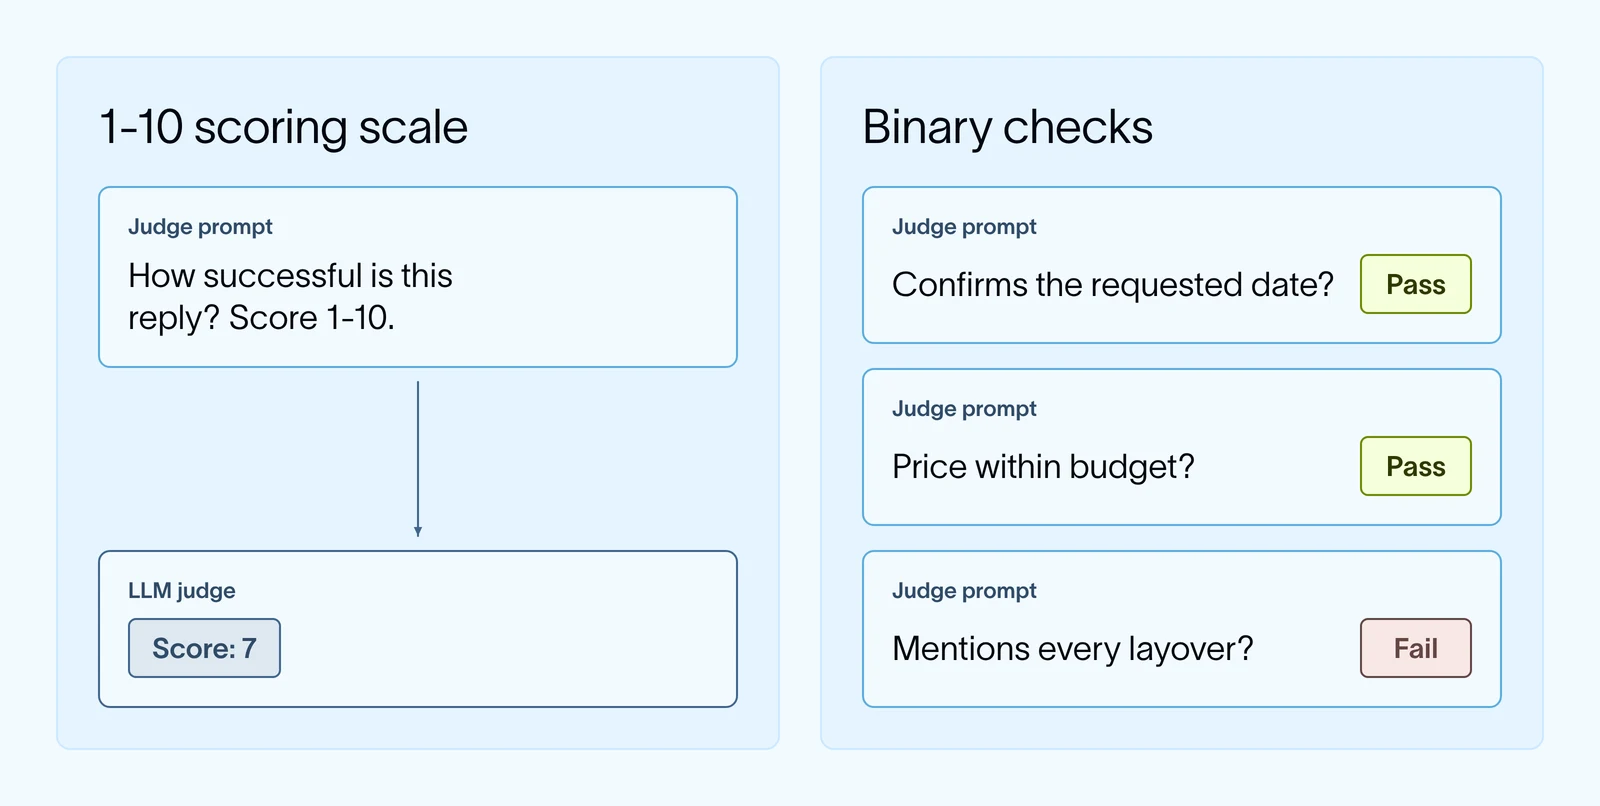
- 提出范围狭窄的问题。 在我们的旅行社示例中,问“回复是否提到了每一个中转站?”比问“这个回复好吗?”更容易判断。
- 定义一个精确的评分量表。 二元的通过或不通过,或者一小组带标签的类别,比1-10分制的评分更具可复现性。评判者可能很难区分6分和7分。
评估与基准测试是一回事吗?
基准测试(benchmark)是一种离线评估,由一组任务组成。任务是基准测试中的单个测试用例,包括指令、容器中的环境,以及对结果进行评分的测试脚本。随着智能体(agent)能力的提升,简单的 LLM 评判者或基于代码的评估往往已不够用。智能体现在可以执行代码、编辑文件并与服务交互。为了对这种多步行为建模,基准测试会在容器中搭建隔离的基础设施。这让开发者能够以离线方式测试智能体行为,就像智能体在生产环境中工作一样。
基准测试与较简单的 LLM 评判器和基于代码的评估在几个方面有所不同:
- 任务涉及更多步骤。 要完成单个任务,智能体可能需要通过数十次工具调用来安装软件包、编辑文件和运行命令。
- 每个任务都自带一个环境。 代理(Agent)现在可以在诸如带有代码仓库、文件和工具的沙箱等环境中执行操作。每个任务都配有自己独立的环境供代理在其中工作。
- 评分检查代理做了什么。 一个测试脚本会在运行结束后检查环境的状态,例如测试是否通过或正确的文件是否存在。你仍然可以审查轨迹,但分数来自代理执行的操作及其留下的状态。
以我们的旅行助手为例,一个基准测试任务可能会给代理一个模拟预订系统,并附带一个请求,例如“一场暴风雨取消了旅行者飞往丹佛的航班。请为他们重新订票,并相应调整其酒店预订。”代理完成后,测试脚本会检查数据库中的预订记录。
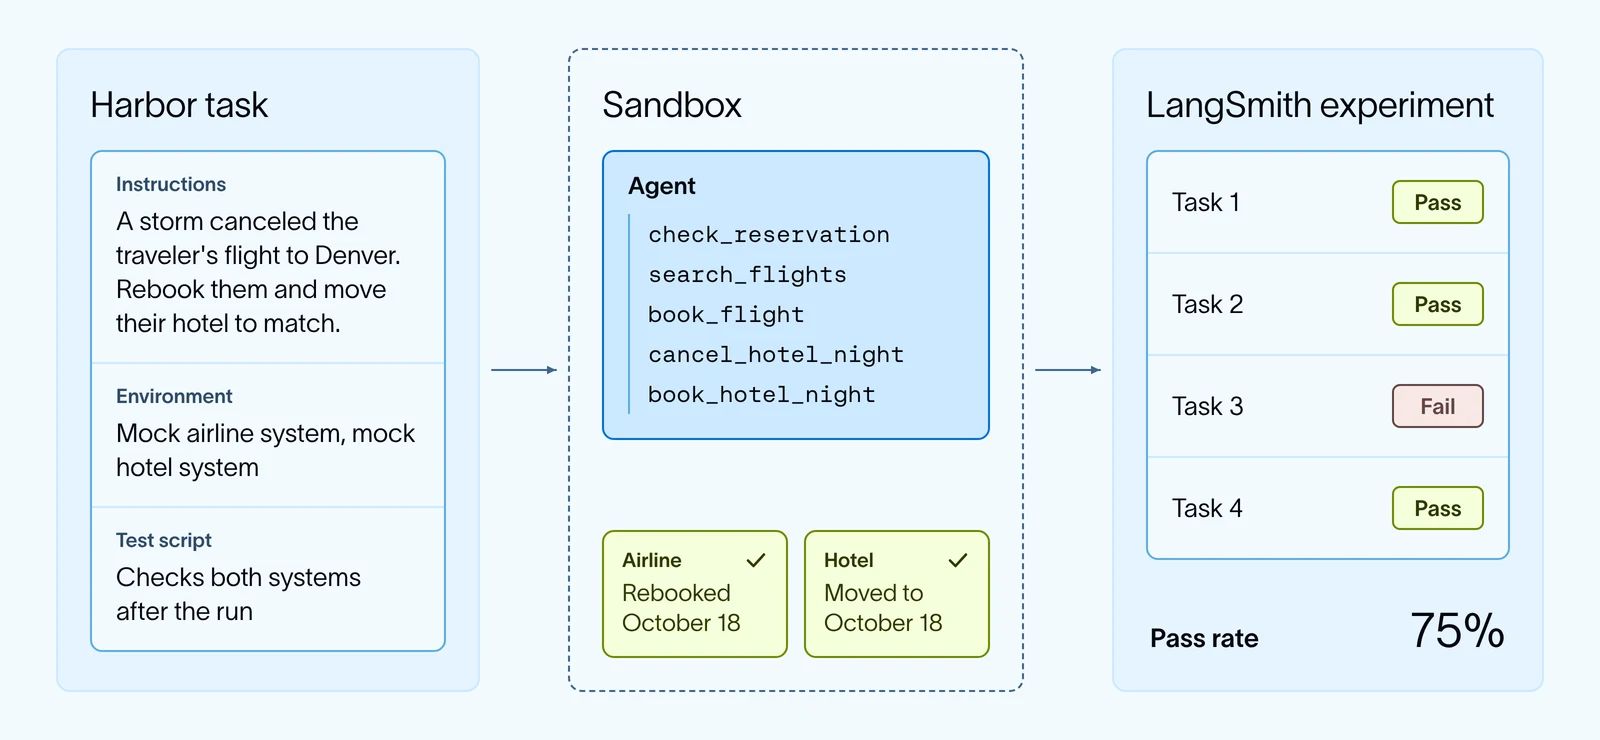
Harbor 是一个开源的评估工具集(eval harness),为测试这些更长的任务提供脚手架。它是驱动 Terminal-Bench 的框架,你可以使用相同的任务格式为自己的 agent 构建基准测试。借助 LangSmith 集成,每次 Harbor 运行都会记录为一个 LangSmith 实验。Harbor 会为每个任务构建一个容器,你可以使用 LangSmith 追踪(traces)让每个环境更接近你的 agent 在生产环境中看到的情况。基准测试结果随后会与你其他的评估结果并列展示,你可以打开任何一次运行,查看完整追踪及其得分。
我们使用这套装置来 在 Terminal-Bench 2.0 上改进 Deep Agents 通过审查轨迹来找出失败模式,然后更改测试框架。我们还用它来构建 IssueBench,这是 LangSmith Engine 的基准测试。每个 IssueBench 任务会向 Engine 提供一批追踪记录(traces),并评估它是否能将正确的记录归入相应的问题簇。
为构建你自己的智能体基准测试遵循与上述评估相同的步骤,只有几处改动:
- 从追踪记录中收集任务。 在 LangSmith 跟踪记录中查找失败案例,然后将每一个失败转化为一个 Harbor 任务,并为其配备专属环境,例如一个填充了用户预订信息的模拟预订系统。
- 明确“好”的定义。 创建基于你的评分标准打分的LLM评委或基于代码的评估。
- 在比分上进行爬山。 运行该智能体并利用评分对更改进行 A/B 测试。你可以设置一个智能体循环来替你完成这一过程。它会对你的智能体进行编辑、重新运行基准测试,并保留或回滚每项更改,类似于 Andrej Karpathy 的 autoresearch 来自几个月前的循环。
如何在不高成本的情况下评估生产流量?
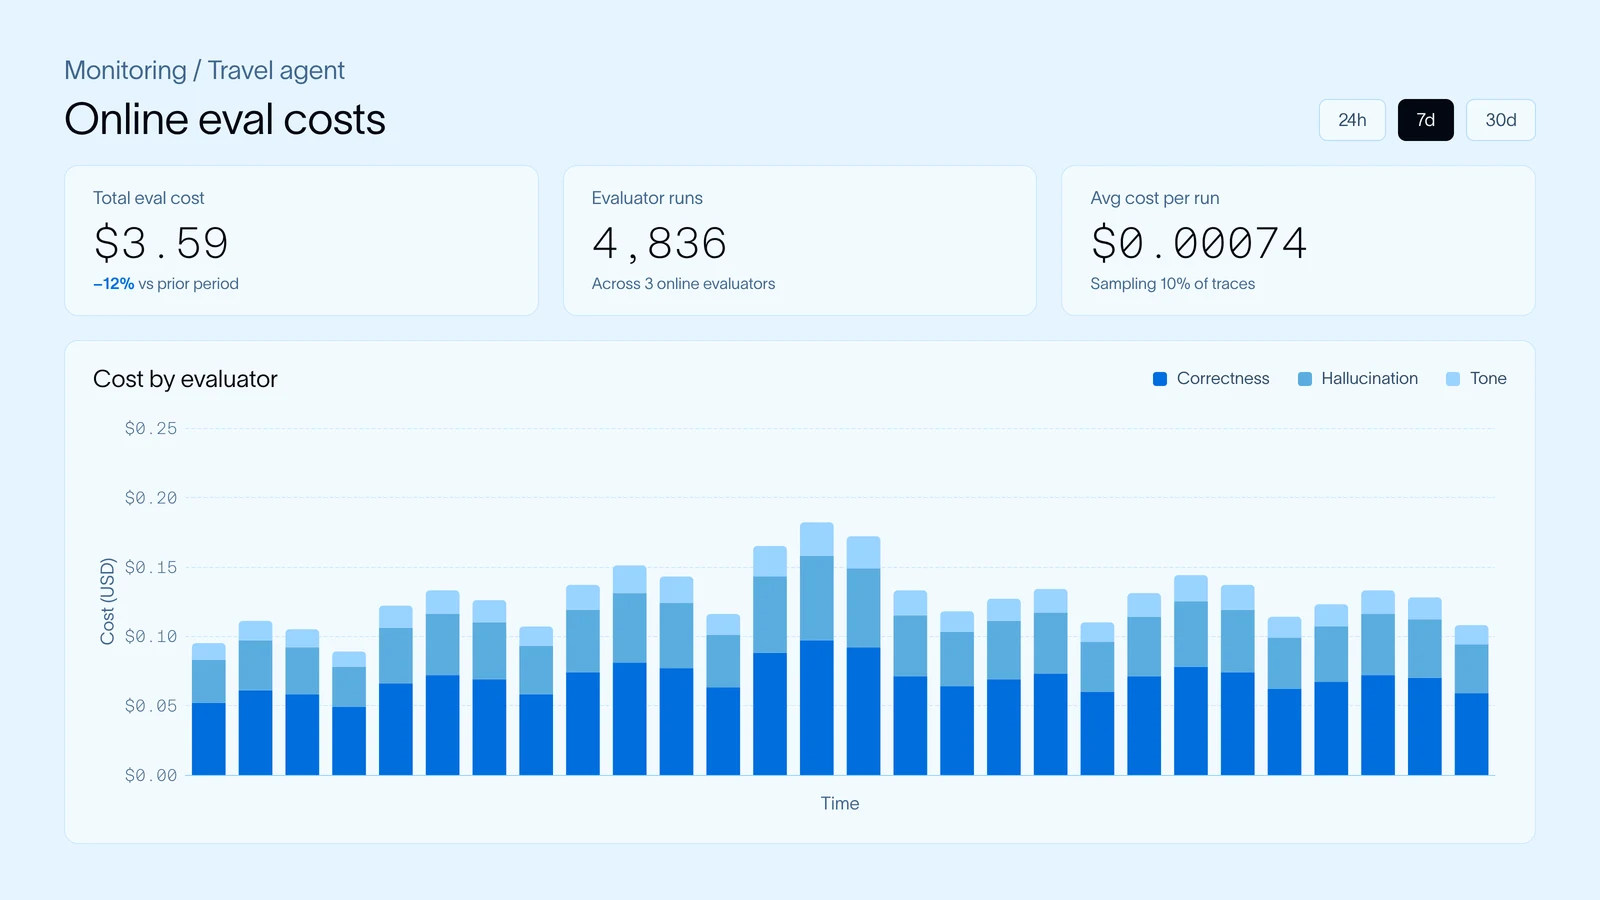
离线评估在固定数据集上运行,因此成本可预测。在线评估在实际流量上运行,因此如果 LLM 评判器为每条追踪打分,你的评估成本会随着每一位新用户的增加而增长。为了让成本保持在可控范围内:
- 采样与滤波。 在线评估者 在 LangSmith 中可以对一部分流量进行评分,或仅对匹配筛选条件(如负面用户反馈)的追踪进行评分。
- 尽可能使用代码检查。 检查预订是否符合请求日期,或者代理是否在预订前进行了搜索,成本几乎为零。
- 使用更便宜的裁判模型。 在我们 Jev-as-a-Judge 实验中,TypeSafe AI 的 Jev 在每一个通过/失败判定上都与人工标注一致,总成本仅为 0.34 美元,而 Claude Sonnet 4.6 的成本为 28.17 美元。
在线评估成本会随时间保存在 LangSmith 中,因此团队可以监控其支出。
你需要自己构建智能体评估吗?
不,尤其是在评估常见的智能体问题时。一个很好的切入点是我们的 LangSmith 中预构建的 LLM 评估器模板 用于幻觉或 PII 泄露等典型检查。将其添加到数据集或追踪项目中,并编辑其提示词以适配你的智能体,例如告诉评判者我们的旅行助手绝不应预订超出用户预算的内容。
我们的开源 agentevals 包还内置了针对智能体消息和工具调用的评估器。它们可以将你的智能体调用的工具与参考列表进行比较,或者让 LLM 评判者判断这些步骤是否合理。
你还可以在多个数据集之间复用离线评估器,并将其作为在线评估器运行于生产追踪之上(仅当评估器不需要参考输出时才有效)。
对于特定于你的智能体的评估, Eval Engineering Skill 可在 Claude Code 或 Codex 等编码智能体中运行,它会读取你的代码库和追踪记录,并与你一起编写可运行的评估。
LangSmith Engine 也可以通过从生产追踪中提取数据来自动为你编写评估。当它识别出一个问题簇时,会将失败的追踪转化为数据集示例,并将其参考输出写成 断言,例如“在用户请求的日期预订航班。”
如何评估多轮对话?
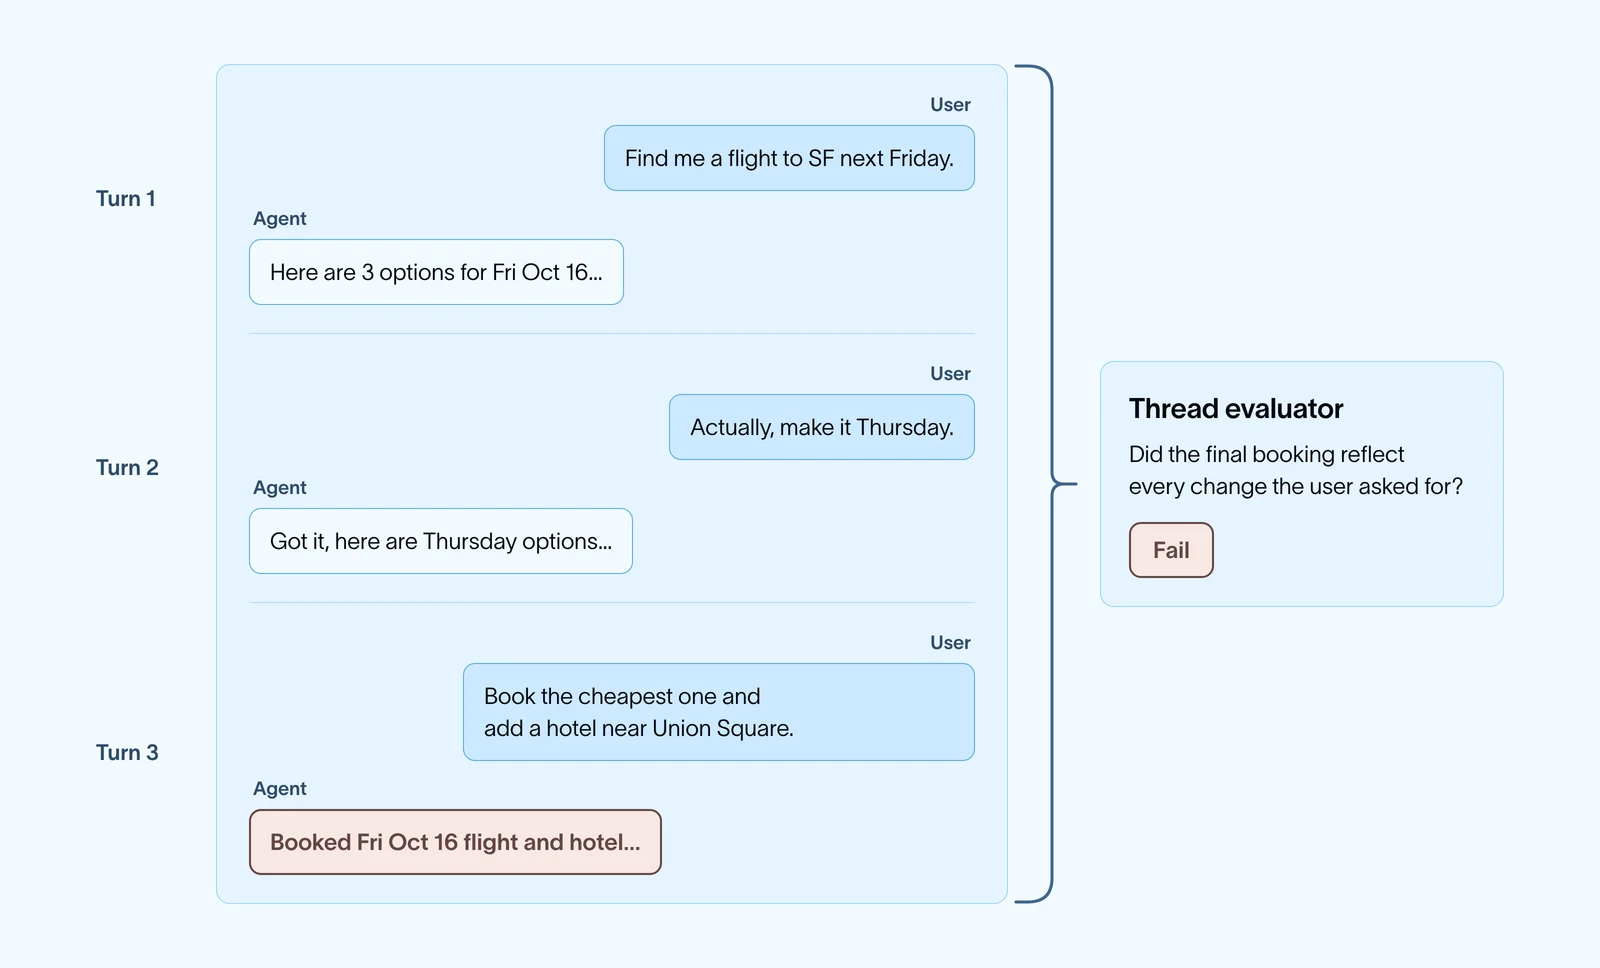
许多智能体需要跨多轮工作。例如,用户可能会先向我们的旅行助手询问航班,然后更改日期,再添加酒店。每一轮单独来看可能都没问题,但整个对话却出了错。
要在 LangSmith 中评估对话,请在你的追踪元数据中传入一个线程 ID,这样每一轮都会被归入一个 线程(thread)。线程是来自同一对话的一系列追踪。在此基础上,你可以附加在线评估器,在对话结束后对整个线程打分,例如提问:“最终预订是否反映了用户要求的所有更改?”或“用户是否不得不重复表达自己?”LangSmith 还会将每个线程显示为一条 轨迹(trajectory),其中每条消息和每次工具调用按顺序各列出一次。
对于离线评估,你可以将完整对话作为示例存储在数据集中,或者用 LLM 模拟用户,从而测试智能体如何从头到尾处理一段对话。
如何评估智能体超出其最终输出的表现?
智能体要经历许多步骤,因此最终答案只能反映实际发生情况的一部分。除了最终回复之外,你可能还想检查:
- 路径,即智能体产生的消息和工具调用的序列。
- 最终状态,例如我们的旅行智能体创建的预订记录、它写入的文件,或它对代码库所做的更改。
随着生产环境中的智能体日益复杂,你可能需要一个专门的评估工具。具体来说,当智能体的工作就是它对某个环境所做的更改时。假设一个编码智能体被要求修复一个 bug。LLM 评判者可以阅读智能体的回复,但可靠的检验方法是在智能体完成后运行代码库的测试。为此,每次测试运行都需要拥有自己的干净代码库副本,以避免各次运行相互影响。Harbor 会为你完成这些设置。你可以运行使用 Deep Agents 构建的智能体于 LangSmith Sandboxes 中,并将每次运行及其追踪记录到 LangSmith 实验中。更多信息请参阅 Harbor x LangChain.
如果智能体不是使用 LangChain、LangGraph 或 Deep Agents 构建的,你能在 LangSmith 中对其进行追踪和评估吗?
可以!LangSmith 与框架无关,因此你可以追踪和评估使用任何框架构建的智能体,或者完全不使用框架的智能体。发送追踪有几种方式:
- 框架集成。 LangSmith 为流行的智能体框架提供了 集成 ,例如 OpenAI Agents SDK, Claude Agent SDK等。
- 模型提供商包装器。 如果你直接调用模型提供商,可以为 OpenAI 或 Anthropic 并且每次模型调用都会被追踪。
- 该
@traceable装饰器。 将其添加到你自己的函数中,例如旅行助手的航班搜索工具,以便 追踪任何步骤 您的代理的一部分。
一旦你的追踪数据进入 LangSmith,评估(evals)对任何框架的工作方式都是相同的。你可以将追踪数据添加到数据集中,通过将你的智能体传递给 SDK的 evaluate() function,并将在线评估器附加到生产流量上。
你如何从现有的评估技术栈迁移出去?
你不必从头开始。你已构建的大部分内容都可以迁移到 LangSmith:
- 数据集。 将现有测试用例以CSV或JSONL文件形式上传,或使用SDK创建它们。
- 代码评估器。 现有的评分函数通常只需少量修改即可作为 LangSmith 评估器运行。如果您的评估已经以测试形式运行,那么 pytest 和 Vitest 集成功能让您保留原有的设置。
- LLM 评委。 将你现有的评委提示词粘贴到界面中的 LLM-as-a-judge 评估器里,或者保留在代码中。
- 追踪。 LangSmith 可与任何框架配合使用,因此您可以从当前的智能体发送追踪数据,而无需重写它。
你如何报告结果?
离线实验可以显示每次发布是否有所改进。在线评估仪表板则显示性能在生产环境中随时间的保持情况。在 LangSmith 中,你可以直接比较实验结果,并创建自定义仪表板来跟踪诸如 token 成本、延迟和评估器得分等指标随时间的变化。基准测试为你提供一个稳定的分数,用于跨发布比较不同模型或代理版本。
下一步
如果你想深入了解,请阅读 《我们如何为深度智能体构建评估》,尝试 LangSmith 评估快速入门,或查看我们在 LangChain Academy 上关于 LangSmith Essentials.
的课程。更喜欢现场讲师授课?我将于2026年10月28日主持一场关于智能体评估的线上研讨会。在此 注册!