
TL;DR
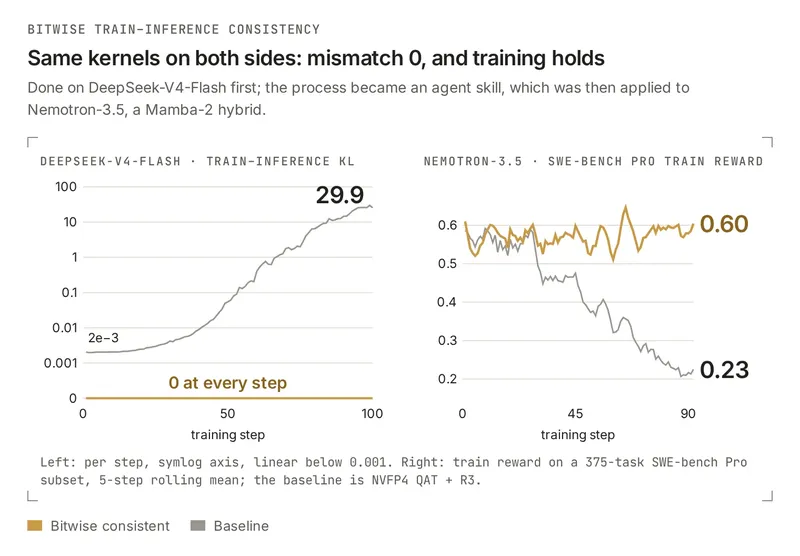
- 问题:高性能 RL 中推理侧的优化会改变数值,因此训练优化的策略并非采样时的那个策略。在 DeepSeek-V4-Flash 上,高性能基线的 train-inference KL 从 2e-3 升至 29.9,而奖励出现回落。
- 方法:训练前向直接调用 vLLM 的推理 kernel,并对这些高性能 kernel 进行修改,使 rollout 与训练对每个采样 token 都产生逐位一致的 logprob(diff = 0)。
- 结果:在 DeepSeek-V4-Flash 的 100 个训练步中,每一步的 diff 均为 0,同时达到基线 rollout 吞吐量的 91.3%。迁移到 Nemotron(Mamba 混合架构 + NVFP4)后,一致运行的 SWE-bench Pro 分数保持稳定,而基线从 0.56 降至 0.22。
- 开源:整个流程被打包为 agent skill,并连同配方和代码一起发布,降低了在新模型上实施此方法的成本。
- 进行中:DeepSeek-V4.1 已达到 0 diff;性能优化工作正在收尾,后续会单独发文。
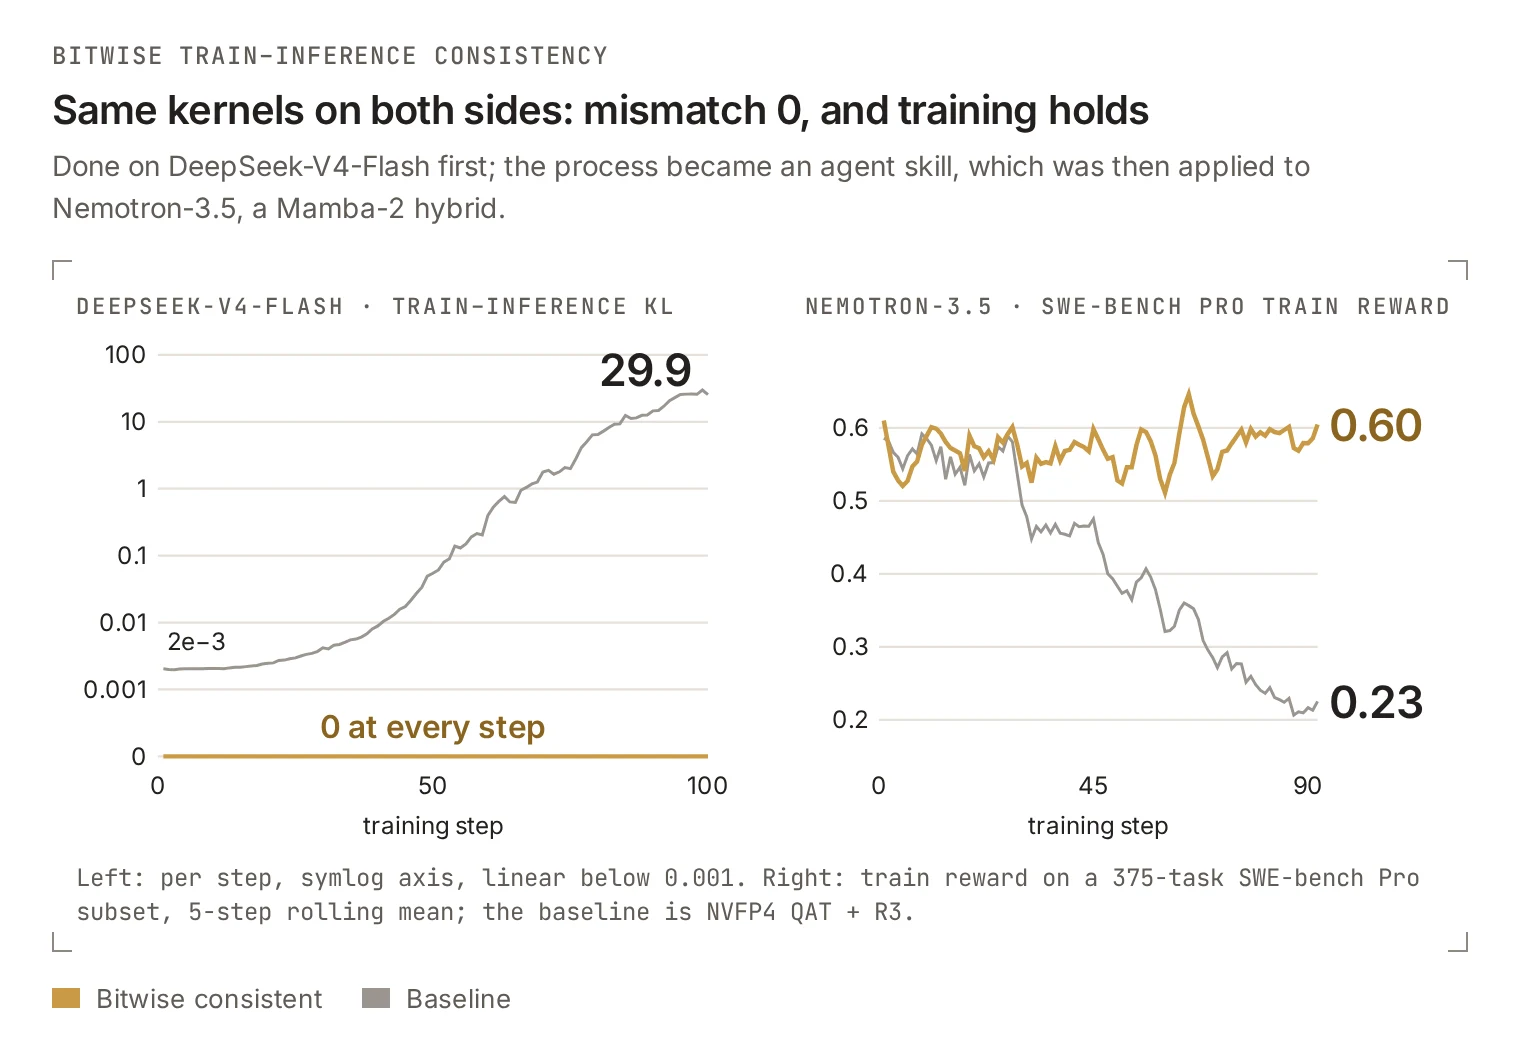
DeepSeek-V4-Flash 最先达到 0 diff;该流程随后被打包成 agent skill,并应用到 Nemotron-3.5(Mamba-2 混合架构)上。左图:DeepSeek-V4-Flash 的 train-inference KL;基线从 2e-3 攀升至 29.9,而一致运行在每一步都为 0。右图:Nemotron-3.5 在 SWE-bench Pro 上的训练分数(5 步滚动均值);一致运行保持在 0.6 左右,而基线跌至 0.23。
Rollout 占据 RL 训练时间的大头,因此训练系统会采用低精度计算、低精度 KV cache 以及通信和 kernel 优化。这些都会改变推理侧的数值。推理引擎生成一条响应;训练引擎重新计算其概率并更新模型。在权重完全相同的情况下,两侧对同一个 token 给出的概率却不同,于是训练优化的策略并非采样时的那个策略。这一差距会随更新不断拉大并使训练失稳。在我们的 DeepSeek-V4-Flash-Base 实验(未使用 TIS 等算法性修正)中,高性能基线的 train-inference KL 从 2e-3 升至 29.9,而奖励出现回落。
训练不稳定意味着更多的崩溃、回滚和重跑,有效训练占比更低,达到同样结果所需的总时间更长。我们的目标是 更快完成有效的 RL 训练:通过减少崩溃和重跑,用更少的端到端时间达到结果。
我们的方法:在高性能数值路径上,训练与推理对每个采样 token 都产生 逐位一致 的 logprob(diff = 0;第 2 节给出了精确定义),这才是真正的 on-policy RL。我们的实现方式是让训练前向直接调用 vLLM 的推理 kernel,并修改这些高性能 kernel,使结果不随 batch 组成、prefill 或 decode 阶段、或并行布局而变化(第 3 和第 4 节)。随后,一个 agent skill 降低了在新模型上实施此方法的成本,并使流程可迁移:它会告诉 agent 如何找到两侧首次出现分歧的算子,将其简化为最小复现,修复它并重跑回归测试。在 DeepSeek-V4-Flash 上,我们在高性能基线 rollout 吞吐量的 91.3% 处达到了 0 diff,并将该方法迁移到了采用 NVFP4 的 Mamba 混合架构模型 Nemotron 上。
本文测量的是数值一致性、训练曲线和 rollout 吞吐量。端到端的收益来自更少的崩溃和重跑,这只有在长时间运行中才能体现;该挂钟时间对比留待以后。此外,两个基线都没有经过充分调优或探索:每个只跑了单一配置,使用了 R3,但没有使用 TIS 或 MIS 等算法性修正。这里展示的基线崩溃仅反映这一配方;经过调优,基线未必会如此容易崩溃。
1. 现有方法:如何在三者之间权衡
更快完成有效的 RL 训练需要同时具备三个性质:
- A,高性能:rollout 和训练都快速,且低精度计算、低精度 KV cache 和通信优化都可用;
- B,高一致性:训练与推理对同样的权重计算出相同的策略;
- C,低成本与通用性:在新模型、新精度或新硬件上实现 A 和 B 所需的开发时间可接受。
这些条件很少能同时满足。放弃 B,你可以自由优化,但训练有不稳定的风险。放弃 A,你可以使用一致的内核,但推理会慢得多(数字见下表)。同时保留 A 和 B 则意味着逐模型、逐算子地对齐,因此 C 无法实现。
训练-推理失配并不是新问题;现有方法以不同方式在 A、B 和 C 之间做权衡:
| 方法 | 保留了什么 | 放弃了什么或付出什么代价 |
|---|---|---|
| 算法修正:TIS、MIS、FlashREINFORCE、Score Centering | A 和 C:不改动推理引擎,与模型无关,采用成本低 | B:数值差异仍然存在,只是其对更新的影响受到限制。代价:偏差、丢弃样本,并且随着低精度扩大差距,修正变得更加困难 |
| R3 (replay rollout expert routing,重放 rollout 专家路由) | A,以及 MoE 路由的 B | 只消除路由翻转;其他数值差异仍然存在 |
| QAT (训练前向模拟部署量化) | A:rollout 可以安全使用低精度;缩小量化导致的差异部分(改善 B) | 训练必须模拟量化,反向传播使用直通估计器(STE:反向传播将量化视为恒等);仅模拟权重会留下来自激活、KV、核函数和归约的差异 |
| 严格的数值对齐 (Thinking Machines、slime、IsoExec、本文) | B | A 或 C:通用的批不变核函数需要付出 A 的代价(Thinking Machines 的工作负载:26 秒变为 55 秒,改进注意力核函数后为 42 秒);在高性能路径上保持对齐则保住 A 并付出 C 的代价(slime、IsoExec、本文:按模型、按算子的对齐与验证) |
算法性校正涵盖几种机制:
- TIS (截断重要性采样, Yao et al.):用训练/rollout 概率比加权梯度,在上限处截断,以少量偏差换取有界的方差;
- MIS (掩码重要性采样, When Speed Kills Stability):不做截断;直接丢弃序列级概率比超过阈值的整条序列;
- FlashREINFORCE ((Hu、Zhang 等):用于异步智能体 RL;轨迹级漂移过滤(序列信任域)移除偏离过远的轨迹;
- 分数中心化 ((Marek & Ryabinin):通过加性校正项抵消每次更新累积的训练-推理漂移;可与重要性采样叠加使用。
这些方法减轻但不消除失配的影响:失配会把 on-policy 训练变成 off-policy 训练(Yao et al.);当失配较大且来源有多种时,token 级重要性采样是有偏的,训练更容易崩溃(Li & Liu);在 P1-VL中,截断重要性采样只是延迟了崩溃。R3(Rollout Routing Replay, Ma et al.)记录 rollout 时的专家路由并在训练中重放,仅消除路由翻转部分。
在最后一行,Thinking Machines Lab 用批不变核函数实现了真正的 on-policy RL(Defeating Nondeterminism in LLM Inference),以及表中列出的推理时代价,其中大部分来自尚未充分优化的 FlexAttention 集成; vLLM 和 TorchTitan 在训练中复用 vLLM 的前向内核,其位级一致的运行在更少的步数内达到了更高的奖励; slime 在 GLM-5 架构(MLA + DSA,与 DeepSeek-V3.2 结构相同)上对齐 logprobs;以及 IsoExec 由 Alexander Jiang 和 SkyRL 团队撰写,涵盖线性注意力(第 6 节)。
这些方法大多可以叠加:有些针对同一权重版本下引擎之间的数值差异,有些则针对权重版本之间的策略差异。在异步训练中,来自陈旧权重的 off-policy 仍会进入 TIS、MIS 或 Score Centering,但引擎仍可以在这些权重上实现数值对齐,而位级一致的运行则成为衡量此类校正的基线。QAT 也属于严格对齐:只有当训练前向应用相同的量化时,低精度 rollout 和训练才能位级匹配;我们的反向传播使用 STE。
我们采用保留 A 的最后一行路径,A 的标准是: rollout 吞吐量至少达到同等优化的高性能基线的 70% (rollout 是 RL 训练中最耗时的部分;训练侧开销未单独测量,见 3.2)。C 是该路径的薄弱点;第 5 节介绍 Agent + skill 如何弥补它。
2. 训练-推理一致性需要什么
在本文中,diff 指在每次更新前、使用相同权重版本和相同 token 前缀时,rollout 对每个有效 token(响应掩码内采样出的 token)的 logprob 与训练侧重算的 old-logprob 之间的差异。验收要求逐 token 差异 |p_rollout − p_train| 的最大值、均值和标准差,以及 k3 KL,全部精确等于 0。这是精确相等,而非阈值,并且在每次更新前进行检查;mini-batch 更新本身会改变策略,这一定义将其排除在外。该条件在我们已验收的任务(数学推理、多轮工具调用)和并行布局上成立,包括两侧使用不同布局的情况。
“训练和推理计算的是同一件事”可以拆解为四个维度加上一份共享的数值契约:
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
内核确定性(单 GPU)。 同一内核在相同输入上总是给出相同输出。GPU 默认并不保证这一点。一个例子是 split-K 矩阵乘法:不同的累加顺序会给出不同的结果,因为浮点加法不满足结合律。
批处理独立性。 一个请求的结果不得依赖于同批次的其他请求。推理时,引擎会动态合并和拆分批次以提升吞吐。训练时,micro-batch 大小、packing 以及每个专家的 MoE token 数量也会改变执行路径。各种优化(按批次大小选择 kernel、动态拆分数量)使给定请求依赖于同批次中的其他请求。
阶段一致性。 一个 token 在 prefill(一次处理多个 token)和 decode(一次处理一个)中必须得到相同的结果。推理引擎为每个阶段使用各自最快的 kernel;强制共享路径是一致性版本变慢的主要原因,也是优化的重点。
跨 GPU 一致性。 跨 GPU 的规约操作(AllReduce、reduce-scatter,以及 MoE all-to-all 之后合并专家输出)也必须固定,且要在两个层面。
- 在两侧 并行布局相同 的情况下,通信结果不得随时序和调度变化(固定通信库的算法、规约分块和精度,以及专家合并顺序)。
- 在 并行布局不同 的情况下(例如不同的 TP/EP 度),结果还必须在并行度变化时保持一致,这需要固定的规约树且代价更高。DeepSeek-V4 的方案则改为把跨 GPU 规约移出对比路径(4.5)。
每个维度防范两类根因之一:不同的操作顺序(并行累加或规约顺序随调度而定)或不同的计算路径(两侧,或不同批次形状,运行不同的 kernel 或分支)。达到 0 diff 意味着先消除静态差异,再固定动态路径选择使其忽略负载。
除这四个维度外,达到 diff = 0 还需要以下几点:
- 两侧相同的数值契约:相同的量化和舍入、相同的累加精度、相同的 kernel 运算。两个引擎可以满足全部四个维度,但如果计算方式不同仍然会出现不一致。
- 相同的离散选择:Top-K 和 MoE 路由会把一个 ulp 级的上游差异(浮点数末位的一个单位)放大为不同的 token 集合或专家组合。一旦上游一致,tie-breaking、输出顺序和合并规则也必须一致。
- 每步 1 次更新(step batch 等于 mini-batch):如果每步有多次 mini-batch 更新,从第二次起,训练权重就与采样权重不同,这是 diff = 0 不涵盖的,因此训练不再严格是 on-policy(在一个每步 4 次更新的数学任务中,每次更新后约有 7% 的 token 更换了专家组合)。
- 正确的前向之外还需正确的反向和恢复:四个维度只保证一致的前向。反向仍必须正确,且 checkpoint 恢复后的第一步仍必须保持一致。
第 4 节中的主要算子各自满足其中一项要求:dense GEMM 固定 kernel 选择以实现批处理独立性(4.1);FP8 KV cache 统一 prefill 和 decode 的读取以实现阶段一致性(4.2);Top-K 固定平局和顺序使离散选择一致(4.3);expert GEMM 在两种布局间保持同一数值契约(4.4);跨 GPU 规约移出对比路径以实现跨 GPU 一致性(4.5)。
diff = 0 表示两侧计算的是相同的东西,但不表示它适合训练:当每步有多次更新时,diff = 0 成立的同时路由会在更新之间漂移。diff = 0 是我们的工程目标,而非训练质量的充分条件,后者需要单独验收。
3. 参考方案:DeepSeek-V4-Flash
DeepSeek-V4-Flash 结合了低精度计算、稀疏注意力和多节点专家并行,是一个具有挑战性的配置。在 FP8 基础上,我们在 GB200 上进行了两次 100 步的训练:一个优化过的高性能基线版本,以及一个 diff = 0 的一致性版本。
任务:使用 DAPO 格式数据的数学推理,GRPO,以及带超长惩罚的奖励(因此奖励可能为负)。每次运行使用 8 台机器(32 块 GPU),每步 128 个 prompt × 8 个响应,每步 1 次更新(step batch = mini-batch)。两次运行都不使用 TIS、MIS 或类似修正,从而直接暴露引擎差异。
并行方式:DP 数据并行、EP 专家并行、CP 上下文并行(序列切分)、TP 张量并行。一致性版本的 rollout 运行 4 个 vLLM 引擎,每个为 DP8/EP8,TP=1;训练使用 EP32,CP4,TP=1。 两侧使用不同的并行布局 (4.5).
相关结构: MLA (多头潜在注意力,在缓存前先压缩 KV); DSA (DeepSeek 稀疏注意力:一个轻量级索引器对历史位置打分,Top-K 最多保留 2048 个,MLA 仅对它们做注意力); CSA 压缩器 (将历史 KV 压缩为更少的行); mHC (跨残差流混合,混合矩阵通过 Sinkhorn 迭代归一化);以及 43 层 MoE。SM100 是 Blackwell(这里使用的 GB200);SM90 是 Hopper。
3.1 核心决策:推理内核定义数值,训练仅增加反向传播
两个引擎最容易达成一致的方式是运行相同的代码;问题在于由哪一侧去适配。Rollout 主导 RL 的时间,其每个算子都为吞吐量做过调优;让训练作为参照就等于放弃这些优化。因此, 推理内核是数值参照:训练前向调用相同的 vLLM 内核来计算其数值,训练只增加反向传播。 推理侧也没有切换到通用的批次不变内核:它保留了高性能部署内核,并对其进行修改以满足第 2 节的要求。第 4 节中的每个算子都遵循这一取舍。
这一决定面临的挑战在于推理内核没有反向传播,且FP8量化不可微。因此前向与反向分开处理,前向值始终来自vLLM内核。每个模块用一个自定义的封装包装该内核 autograd.Function 其反向传播针对BF16主权重求导,FP8量化被视为恒等映射(直通估计器,STE)。反向传播大多复用现有内核:线性层和专家GEMM使用Transformer Engine的BF16 GEMM,稀疏注意力使用cuDNN前端的DSA反向,all-to-all使用DeepEP的反向;只有mHC、RMSNorm和SwiGLU等小算子使用手写的FP32导数。少数融合内核的输出无法用这种方式求导(注意力的q/k、压缩KV、路由权重、最终的logprob);对于这些,我们仅在PyTorch中为梯度重跑相同的计算,并保留内核的值: visible + (graph - graph.detach())。每次反向传播首先检查主权重自前向以来是否发生变化,因此重计算或异步更新不会混合不同版本的权重。
所有代价都落在训练侧,分为两类。 工程与验证: 梯度是替代量,并非量化算子的精确导数,因此逐位相同的前向不能证明梯度正确,该技能将反向与独立参考进行对比检查(第5节);反向只需正确,不必确定性。每个布局入口(例如4.4中的masked / contiguous)也需要各自的验证。 性能与内存: 训练前向必须保存推理内核的输入和输出以供反向使用;内存压力正是该配方启用完全重计算的原因,而重计算会运行两次前向。
3.2 结果以及代价由谁承担
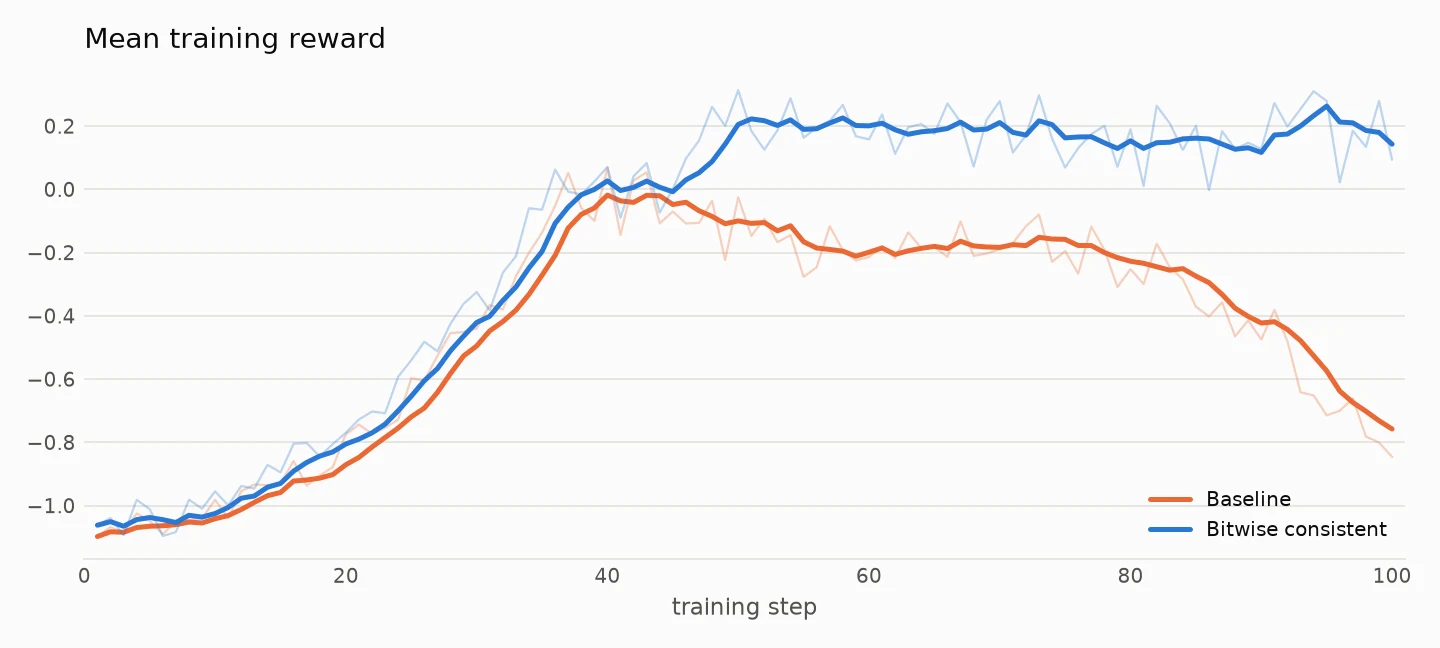
每步训练奖励。橙色:基线;蓝色:一致版本。粗线:当前步与之前4步的移动平均;细线:原始值。
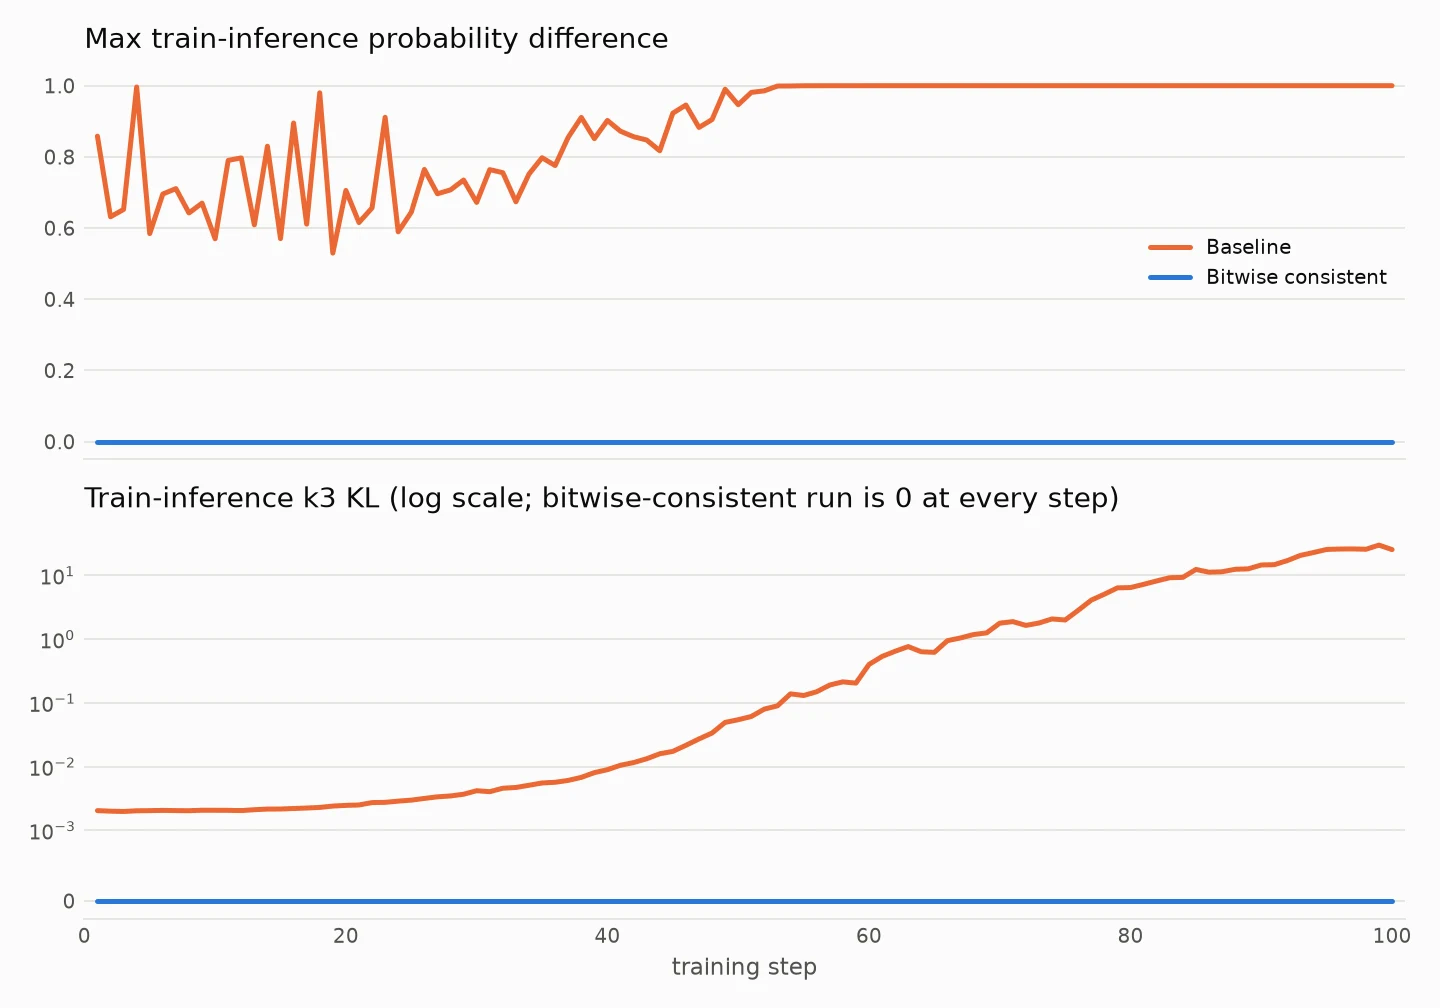
上:每步训练-推理最大概率差异;下:训练-推理KL散度(k3估计器 r − 1 − log r,全文均使用;对称对数刻度,零附近为线性)。最大差异对一次路由翻转或Top-K交换都有反应,因此基线从第1步起就相当大;KL显示整体水平。橙色:基线;蓝色:一致版本。一致版本的两个指标在每一步都是0。
在100步中,一致版本的rollout平均为24.22 token/ms,是基线(26.53)的91.3%:
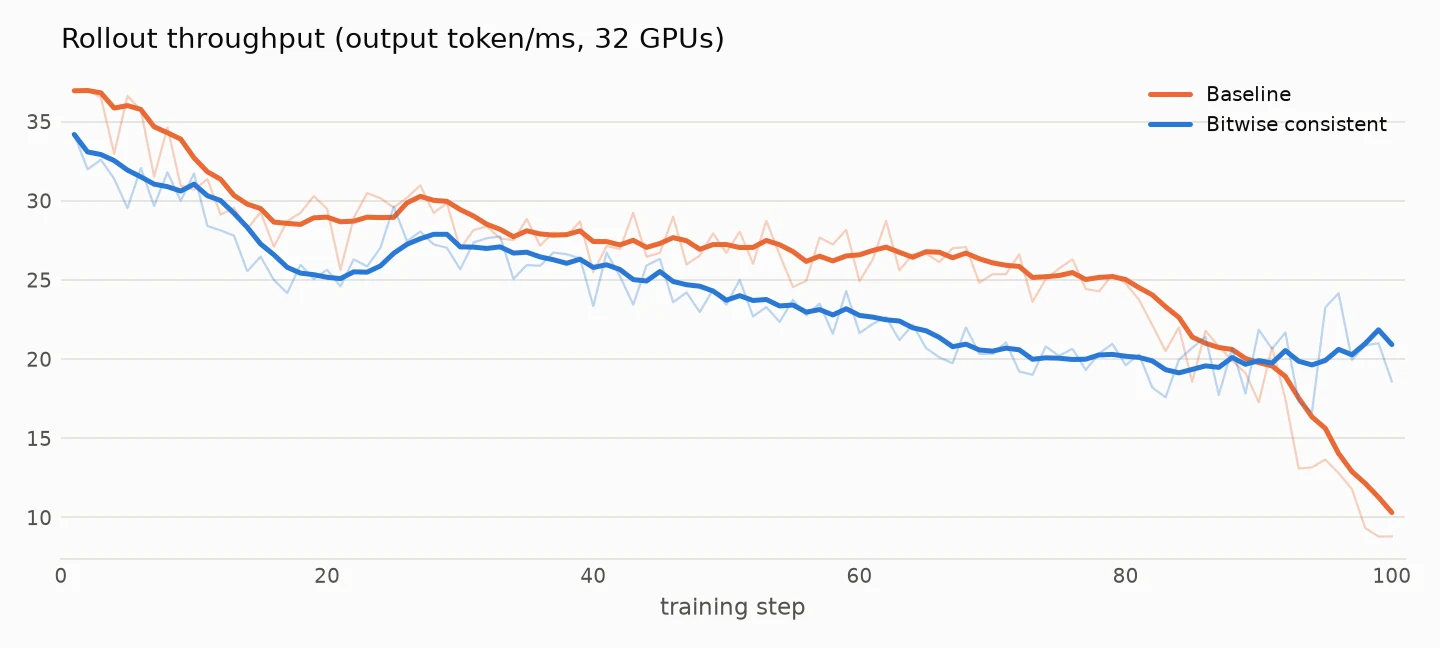
每步rollout吞吐量(输出token/ms,32块GPU求和)。橙色:基线;蓝色:一致版本。粗线:当前步与之前4步的移动平均;细线:原始值。
基线的训练-推理KL不断增长(2e-3到29.9),同时其奖励回落;一致版本保持在diff 0,其奖励保持稳定。另一个潜在收益是少一次前向:我们每步重算old-logprob只是为了测量diff;验收之后,训练可以改用rollout的logprob。
Rollout侧,本运行中测得:平均吞吐量为基线的91.3%(约低9%),高于第1节的70%下限。第90步之后基线的吞吐量下降,这抬高了比值;在相同步数内,其平均响应长度从约3,000 token降至约1,600 token。前89步为88.6%。两次运行的响应长度在整个训练期间不同,因此该比值也反映了不同的工作负载,而不仅仅是引擎的差异。
这一差距尚未归因到具体算子;第4节指出MoE LL通信和后端、注意力的gather与反量化,以及逐请求启动。
训练侧,未单独测量:根据第4节,开销包括每次前向对FP8权重的重新量化、串行的逐请求注意力和Top-K、一次额外的路由元数据分发,以及完全重计算(3.1),后者会运行两次前向。
一个独立的verl配方PR预览在32块GB200 GPU上报告了约10%的端到端开销:rollout接近持平,差距主要在训练侧。训练侧优化是下一步工作。
4. 逐算子:DeepSeek-V4配方中的技术选择
每一小节涵盖保留了什么、放弃了什么、速度如何恢复、以及还剩下什么代价。每个算子两侧各使用什么内核、反向如何编写,见该 技能.
逐算子主表
代价主要位于MoE通信和后端(4.4、4.5),其次是注意力的gather与反量化(4.2、4.3);稠密部分代价很小。
| 模块 | 保留 | 放弃 | 代价 |
|---|---|---|---|
| 稠密 GEMM(4.1) | 部署采用 W8A8 和 DeepGEMM;每个输出对应一种累加顺序 | FlashInfer 在 M<32 时的分支、小批量门控内核、融合 mHC 内核 | rollout:没有更快的小批量内核;training:每次前向传播都重新量化权重 |
| FP8 KV 缓存(4.2) | FP8 存储 | 直接读取 FP8 的解码内核 | rollout:解码中额外的 gather 和反量化;training:每个独立缓存 |
| Top-K(4.3) | DSA 稀疏注意力 | 默认 Top-K 平局裁决与输出顺序 | 每侧多一次排序,通过融合恢复;每请求多次 prefill 启动;训练:注意力与 Top-K 按请求串行 |
| 专家 GEMM (4.4) | FP8 分组 GEMM;路由在构造上即匹配,无需 R3 | FlashInfer TRT-LLM MoE | rollout:主要吞吐量差距;训练:对齐填充 |
| 跨 GPU 归约 (4.5) | 训练与 rollout 使用不同的并行布局 | TP>1 | rollout:LL 通信无法与计算重叠;训练:多一次路由元数据分发 |
| CUDA Graph (4.6) | 计算图 | 仅影响性能的快捷分支 | 按上界预留的工作区 |
| 其他(embedding、RMSNorm、o_proj、lm_head + logprob) | 现有内核,固定的归约顺序 | — | 小 |
4.1 稠密 GEMM:保留 FP8,对所有 M 使用同一累加顺序
保留。 DeepSeek-V4-Flash-Base 以 block-FP8 发布,部署路径为使用 DeepGEMM 的 W8A8。一致版本在两侧都使用它:每次训练前向按部署规则将 BF16 主权重量化为 block FP8,并调用推理 GEMM。BF16 rollout 会消耗计算与带宽;MXFP8 等单独的训练侧方案只能接近部署数值,这正是第 1 节 QAT 行的局限。
放弃。 推理引擎按形状选择内核:FP8 线性层在 M<32 时使用 FlashInfer,否则使用 DeepGEMM;路由门控在 16 个 token 或更少时切换到小批量内核;mHC 切分数量随 token 数增长。浮点加法不满足结合律,因此每一种都会使请求的结果依赖于其相邻请求。一致版本移除了这些分支:FP8 线性层始终以批不变模式使用 DeepGEMM,路由门控在所有批大小下都使用一个输出为 FP32 的 GEMM,小的 BF16 矩阵乘使用固定求和顺序的 Triton 内核,mHC 切分固定为 1。我们统一到 DeepGEMM 而非 FlashInfer,因为 DeepGEMM 具有批不变模式,已经是部署内核,且训练 M 较大。
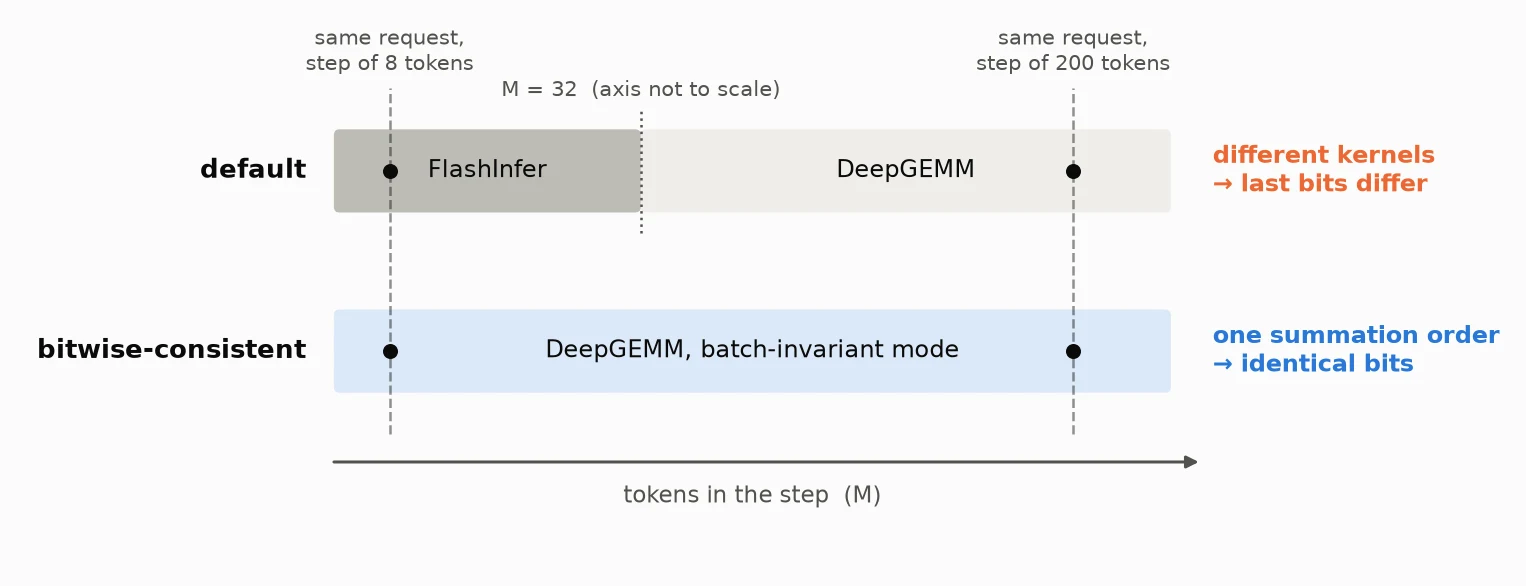
横轴:每步 token 数(示意)。默认路径在 32 处切换内核,因此同一请求在 8-token 步和 200-token 步中会分别经过 FlashInfer 和 DeepGEMM,且在最低有效位上不同。批不变模式只有一种求和顺序。
代价。 Rollout 失去了更快的小批量内核和一次 mHC 融合,但 Tensor Core 仍在使用。训练每次前向都要重新量化权重,包括重算时;缓存 FP8 权重可为多保留一份副本节省这部分时间。
4.2 FP8 KV 缓存:保留 FP8 存储,统一读取路径
保留。 KV 缓存以 FP8 存储,约为 BF16 的 57%,这直接决定了并发度。两次运行共享写入路径。
放弃。 默认 decode 使用直接读取 FP8 并按批划分工作的 FlashMLA 内核;prefill 则反量化为 BF16 并运行稀疏注意力。两个阶段运行不同的算法,且 decode 的划分依赖于其批大小。一致版本让 decode 走 prefill 路径:反量化并将选中的 KV 收集到 BF16 工作区,然后调用相同的 flash_mla_sparse_fwd。工作区按请求分配,大小仅受模型限制。此解码内核必须显式选择;仅一致性开关并不会改变它。
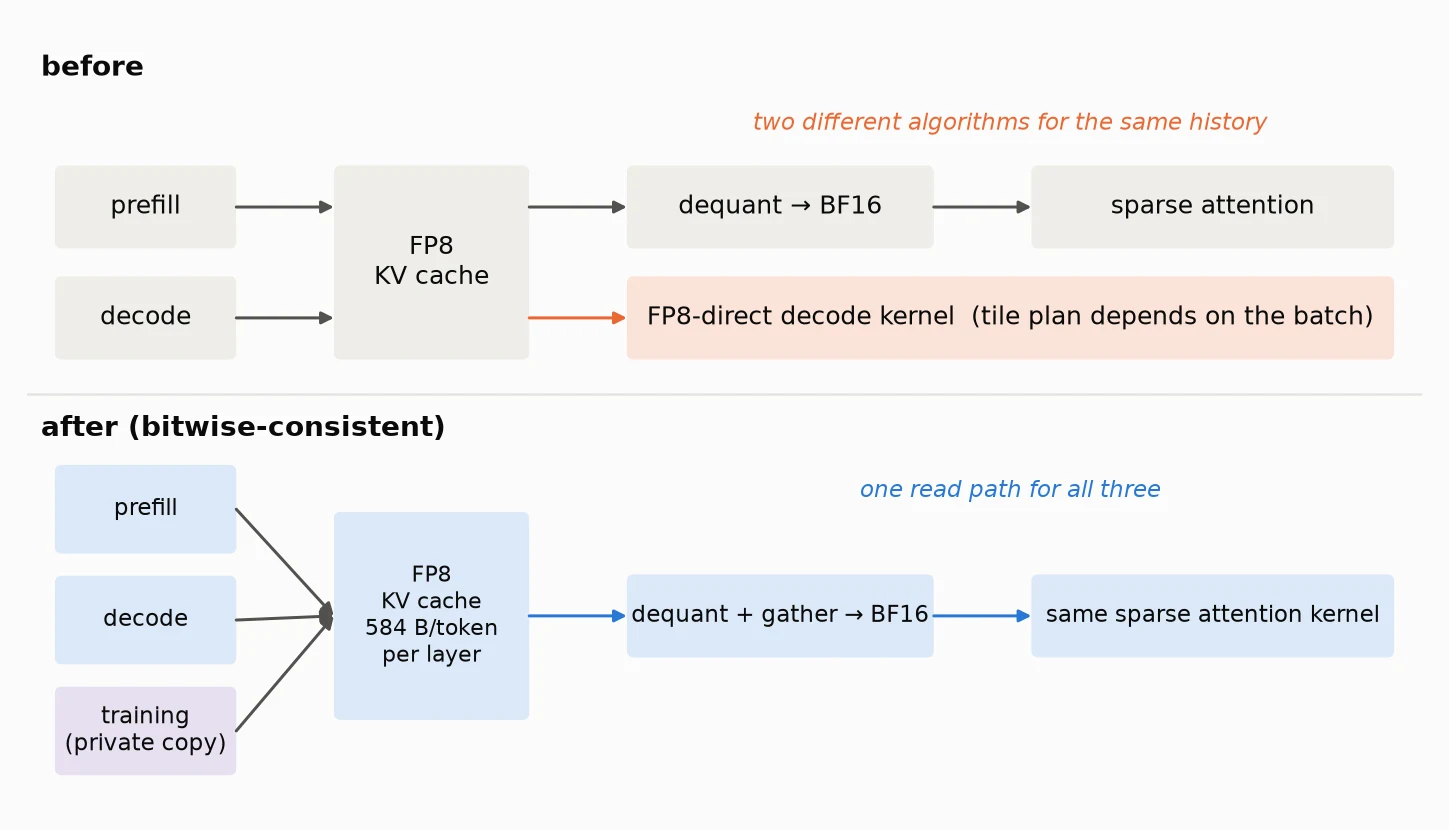
上:之前,prefill 和 decode 使用两种算法读取相同的 FP8 历史记录,且 decode 的分区取决于批次。下:prefill、decode 和训练(使用私有缓存副本)共享一条读取路径。
训练没有真正的缓存,但 K 必须经历同样的 FP8 往返:同一个融合内核将其写入私有 FP8 缓存,同样的反量化过程将其读回。
成本。 Decode 增加了 gather 和反量化,训练增加了一个缓存。这就是阶段一致性的代价;存储精度未受影响。目前每个请求每步生成一个 token;多 token 预测(MTP)和投机解码不在覆盖范围内。
4.3 稀疏注意力中的 Top-K:修复并列与顺序
问题。 DSA 索引器对每个历史位置打分,Top-K 最多选出 2048 个位置用于注意力。这一离散选择会把上游一个 ulp 的差异变成不同的上下文。打分首先做到对齐:索引器使用相同的 DeepGEMM 内核,prefill 读取连续 KV,decode 读取分页 KV,且两种读取在比特级完全一致。
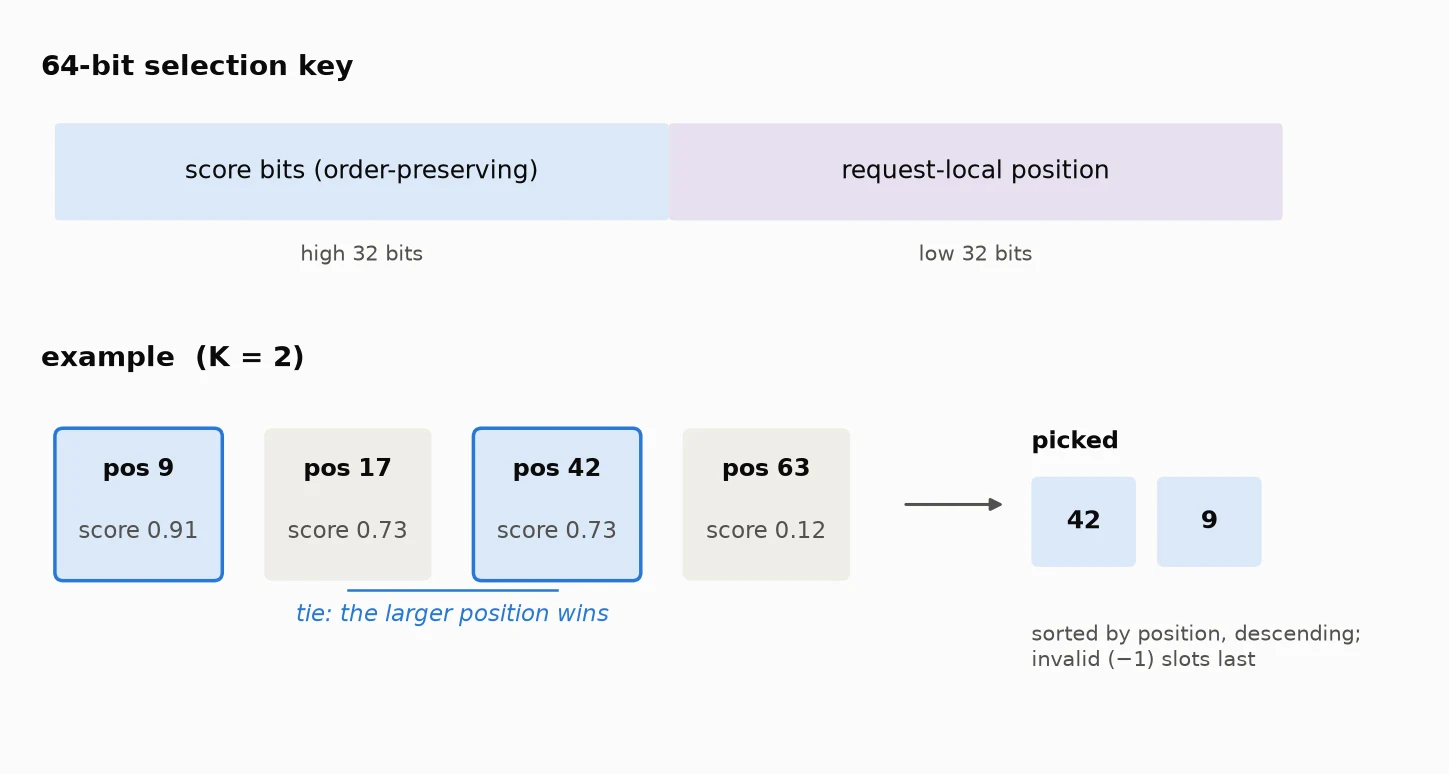
上:64 位选择键的布局。下:K = 2 的示例,其中位置 17 和 42 打平,键中的位置比特选中 42;选中的位置随后按位置降序排序,无效条目排在最后。
固定选择与顺序。 默认的 Top-K 依据线程调度来打破平局。一致性版本将分数与请求内位置组合成一个唯一键,因此平局时选择更大的位置。它使用请求内位置而非全局批次位置;否则请求在批次内移动会改变平局结果。仅有相同集合还不够:索引顺序决定注意力的累加顺序,因此选中的索引按位置降序排序,无效条目排在最后。
R3 式的替代方案记录 rollout 的索引并在训练中重放它们,但这对每个 token 每层多达 2048 个索引:对长响应而言每个序列达到 GB 量级。
训练侧。 训练前向使用相同的打分和 Top-K 选择相同的位置,但索引器不参与训练,主要是为了简单。这与现有做法一致: DeepSeek-V3.2 在训练 DSA 时将索引器的输入 detach,因此 RL 损失永远不会传到它,而 GLM-5 在 RL 中默认冻结索引器。
开销与恢复。 每一侧都多做一次排序。确定性 Top-K 每次调用耗时约 5.9 µs;将其与索引排序融合后,一致性版本的推理基准吞吐量提升 6.7%(配置见 4.4)。剩余的开销是 prefill 中多次按请求启动。
4.4 专家 GEMM:两种布局,相同的行结果
保留的部分。 路由专家的 FP8 分组 GEMM 主导了 MoE 层,而两侧以不同布局喂入该层。Rollout 使用 DeepEP 低延迟(LL)模式(原因见 4.5),得到按专家分块、每块固定容量的掩码布局。训练通过 DeepEP 普通模式处理大量 token,得到按专家打包的连续布局。
后端选择。 两个一致性侧都使用批不变(batch-invariant)模式的 DeepGEMM:它是开源的,具备批不变模式,并且是高性能部署内核。基线的 FlashInfer TRT-LLM MoE 以预编译 cubin 形式发布,因此我们无法修改它,也无法验证它是否批不变;cutlass 缺少块 FP8,triton 则落入一种不声明批不变性的批处理实现。单个专家 GEMM 在两侧耗时大致相同;基线更快是因为 TRT-LLM MoE 在多流流水线中将通信与计算重叠。
两种布局得到相同的行结果。 必须满足三个条件:
- 专家接收相同的 FP8 输入。 LL 在 dispatch 时量化,普通模式在 dispatch 之后量化,原本舍入方式不同;我们将两者统一为逐元素 round-to-nearest。
- 每一行的结果与布局无关。 量化按 token 进行,批不变 DeepGEMM 以固定方式累加每一行,因此一行的结果不依赖于其邻居。比特级路由器 + MoE 测试证实了这一点。
- 激活只舍入一次。 两个 GEMM 之间的 SiLU(gate) × up 以 FP32 计算,只有乘积被舍入为 BF16,然后再量化为 FP8。若在乘法之前将 SiLU 舍入为 BF16,可能相差一个 ulp,FP8 量化会将其放大为一次码字翻转。
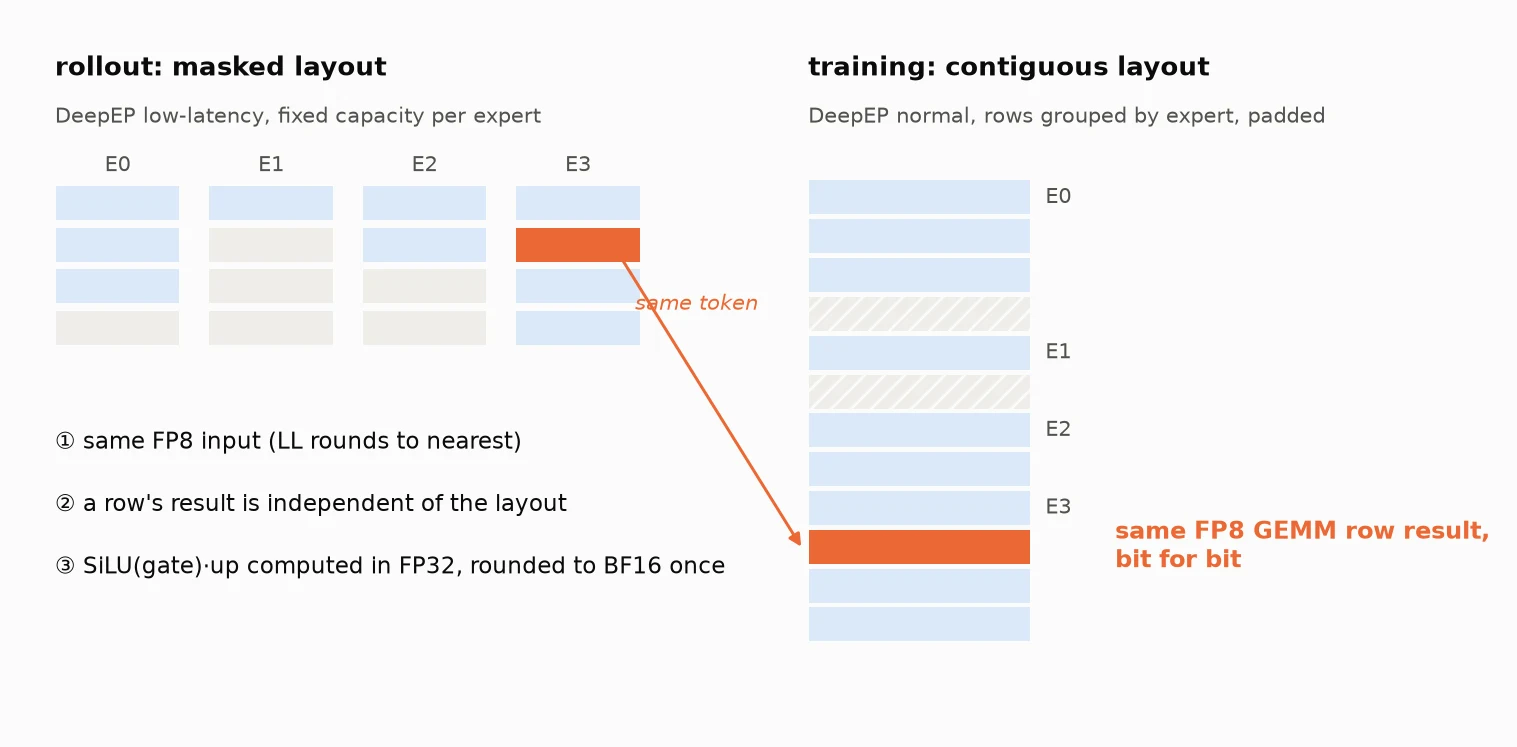
同一个 token(橙色)在 rollout 的掩码布局和训练的连续布局中处于不同位置,但这三个条件使其专家 GEMM 结果在比特级完全一致。灰色:空槽位;斜线:对齐填充。
无需 R3。 路由器的打分 GEMM 在所有批次大小下对比特级相同的输入使用同一个 FP32 输出内核,因此重算的路由与 rollout 一致。这假设每步 1 次更新(第 2 节)。
成本。 Rollout 放弃了 TRT-LLM MoE,但 GEMM 并不是差距的主要来源。在推理基准测试(GB200,DP8/EP8,256 并发,每请求 150 输入 / 3000 输出)中,一致性版本比基线慢 33% 启动,其中约 83% 来自不可重叠的 LL 通信(4.5)。训练会为反向传播保存中间结果,并对每个专家的行进行填充。下文的推理基准数据来自不同的优化阶段;只在同一句话内进行比较。
在比较性能之前,还要确认基线运行的是哪个内核:只要共享库存在,vLLM 就会启用批不变(batch-invariant)的 SiLU·mul·量化内核,而忽略一致性开关,因此任何携带该库的镜像在基线中也会运行它。
4.5 跨 GPU 规约:不处于被比较的路径上
问题。 Rollout 追求低延迟,使用 DP8/EP8;训练必须容纳长序列激活,使用 EP32 加 CP4。如第 2 节所述,不同的布局需要结果对并行度不变,通常通过固定且昂贵的规约树来实现。
选择。 本方案 将跨 GPU 规约排除在被比较的数值路径之外,其余通信只是移动数据而不改变数值:
- TP=1。 线性层没有 all-reduce。vLLM 的 all-reduce 会根据消息大小选择算法,因此 TP 会重新引入这种依赖;本方案在启动时拒绝 TP>1。
- EP 合并是本地进行的。 all-to-all 只搬运数据。专家输出返回到该 token 所属的 rank,并按 top-k 槽位顺序在 FP32 中累加,与 EP=8 还是 32、或哪个 rank 先应答无关。
- CP 不做归约。 相邻 rank 只交换边界隐藏状态,压缩后的 KV 在 CP 组内进行 all-gather:是拼接,不是求和。
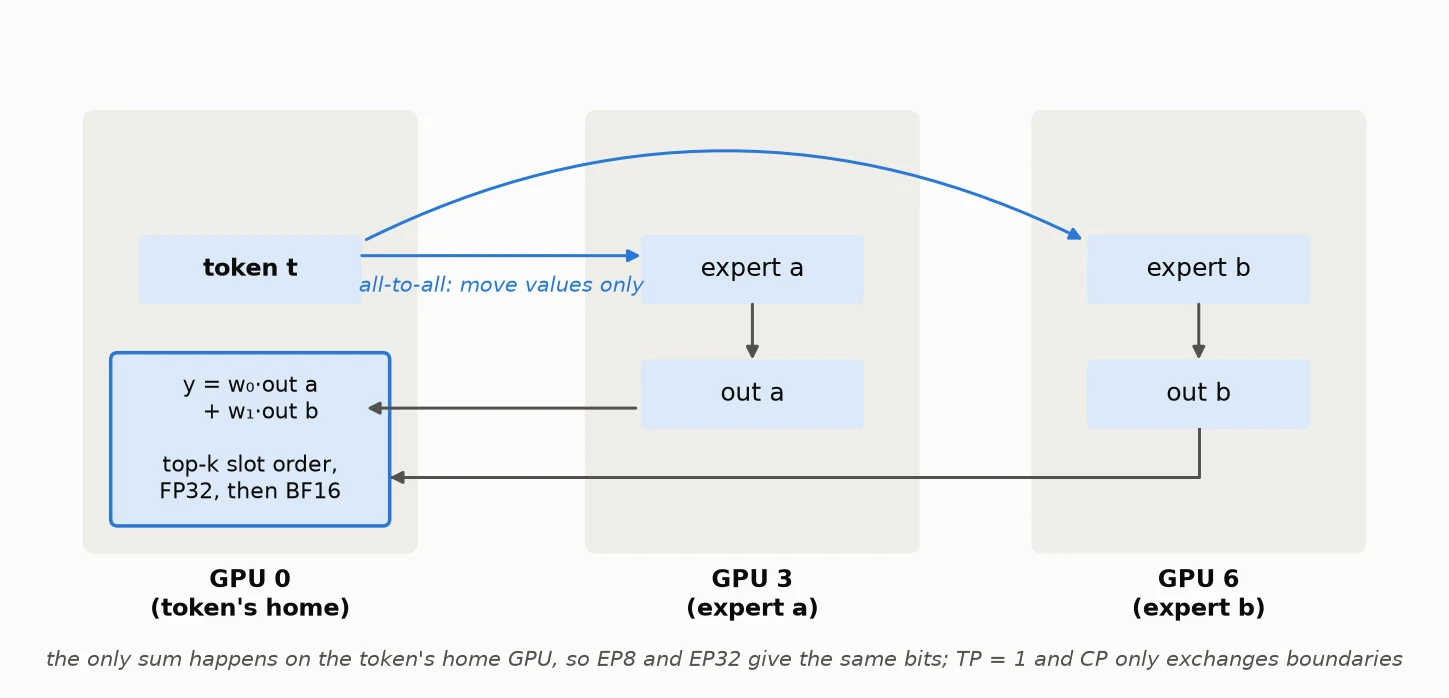
一个 token 的路径:all-to-all 只搬运数据,唯一的求和发生在该 token 所属的 GPU 上,按 top-k 槽位顺序在 FP32 中进行,因此 EP8 和 EP32 得到相同结果。
使数据搬运具有确定性。 在 rollout 中,每次调用每个 rank 最多发送固定数量的 token,且所有 rank 以锁步方式分段,因此通信形状是固定的。只有 LL 实现了这一点,而 DeepEP 的 normal 模式在 DP>1 时会禁用 CUDA Graph,所以 rollout 必须使用 LL。在训练中,normal 模式没有固定的到达顺序,因此路由元数据会再分发一次,并用比特级哈希将每个专家输出匹配到其 token 和槽位。
成本与恢复。 LL 模式每步运行 43 层 × 2 = 86 次串行的 all-to-all,无法与计算重叠。我们尝试的跨层重叠方案会在输入就绪前进行计算,破坏了批次独立性。交错两个微批次(DBO)慢了 39%:每层的专家权重被读取两次,而权重读取已经占用了 84% 的 HBM 带宽。
我们最终在推理基准上缩小了通信差距。首先要确认两次运行使用相同的传输方式:我们曾损失了两天时间,因为一个脚本把一致版本的 DeepEP 绑定到了以太网 RDMA(RoCE),而基线使用了快得多的 MNNVL。在传输方式匹配且共享专家放在辅助流上后,一致版本比基线快 3.2%(16834 对 16313 tok/s)。
TP>1 和解码上下文并行会把跨 GPU 归约重新放回被比较的路径上,目前尚不支持。
4.6 CUDA Graph:保留图并使其与一致性共存
为什么要保留它们。 解码时每个请求每步只有一个 token,每层要运行数十个小 kernel,因此启动开销会占主导;我们保留 CUDA Graph 以达到性能目标。图在三处与比特级一致性冲突。
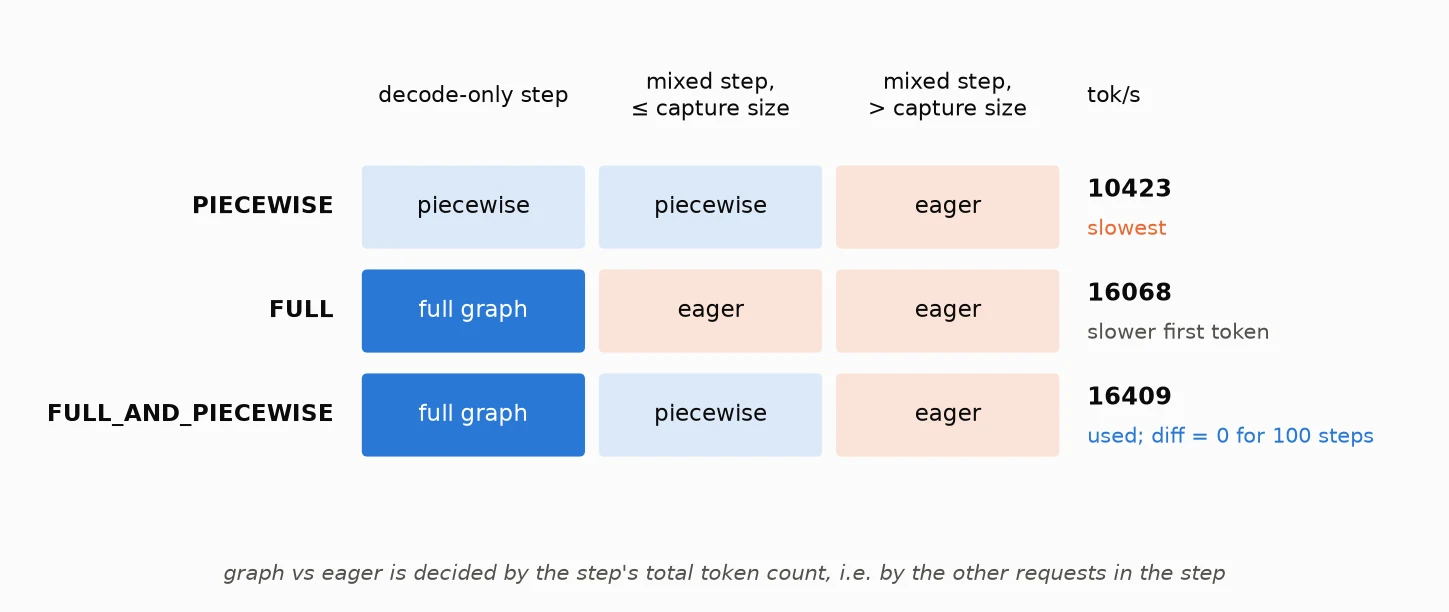
三种步骤中每种模式所走的路径,右侧是推理基准的吞吐量。请求会根据其批次在图模式和 eager 模式之间切换,因此两条路径必须比特级一致。
冲突 1:图还是 eager。 如果一步的总 token 数适合最大捕获大小,则该步在图中运行,否则在 eager 中运行,这取决于该步中的其他 token,因此两条路径必须比特级一致。那是我们遇到的第一个不一致:indexer 的短上下文快捷方式在捕获时根据虚拟输入的长度被固化进了图中。让检查只依赖静态上界解决了这个问题。
模式也有影响。PIECEWISE 不捕获注意力,FULL 在 DeepSeek-V4 上只捕获纯解码步骤。在推理基准上,FULL_AND_PIECEWISE 达到 16409 tok/s,FULL 为 16068,PIECEWISE 为 10423;FULL 每一步都与 eager 中的 prefill 混合运行,使首 token 时间从 764 ms 升到 1792 ms。我们使用 FULL_AND_PIECEWISE:纯解码步骤用完整图,混合步骤用分段捕获;在 100 步的运行中 diff 保持为 0。
冲突 2:图中不能有主机同步或依赖批次的形状。 这与一致性是一致的,许多设计同时满足两者:MoE 调度提示使用静态容量,而不是把每个专家的 token 数读回主机(4.4);LL 固定了通信形状(4.5);工作区只按模型上限确定大小,在捕获前分配然后锁定;仅用于性能的快捷分支在捕获时被禁用。
冲突 3:图捕获的是地址,而权重每步都会变化。 Rollout 必须把新权重复制进其原始存储,并原地重算由权重派生的参数,而不是分配新内存使图停留在旧地址上。只在第一步匹配是不够的,因此该 skill 会在更新、导出和重新加载之后再次比较。
成本。 按上界预留的工作区占用了一些内存。其他性能恢复手段(移除 rollout 中不必要的调试填充和冷启动、更快的 KV 缓存清零)对两次运行都适用;基线也必须获得这些改进,否则性能损失数字就毫无意义。
5. 用 Agent + skill 降低工程成本
A 和 B 可以共存,但第 4 节的主表及其中的关键选择需要专家判断:哪个后端是批次不变的,离散选择需要对齐平局和顺序,如何在不同通信模式间对齐量化与合并顺序,以及通信差距首先需要排除传输方式差异。新的模型、精度或硬件意味着从头再来,因此 C 不成立。
在 DeepSeek-V4-Flash 之后,我们发现这类工作大多分为两类,每一类都有可衡量的目标:
- 把 diff 降到 0。 固定权重和输入,找到两侧首次分歧的算子,将其缩减为最小可复现的 repro,修复它,然后在真实训练中验证。输出被直接比较。
- 在保持 diff 为 0 的同时优化性能。 分析性能热点,A/B 单一算子,并在每次更改后重新验证一致性。只有当加速不改变结果、且不仅体现在微基准测试中而是真实上线环境中时才算有效;不允许通过降低基线速度来缩小差距。
阅读代码、追踪调用链、定位差异、编写复现脚本、修改内核并重新运行回归测试是适合智能体执行的长时间工作,其成败取决于一致性比较和性能测量。
我们将其打包为一个 训练-推理一致性技能:它告诉智能体按什么顺序做什么,以及每一步必须达到什么标准才算通过,从而使流程可以迁移到其他模型上。
该技能设有 11 个关卡(C0–C10),并附带明确的通过条件。为加快冷启动,我们 先从完整模型中切出若干层构成一个小模型,在其中解决大部分问题,然后再转向完整模型。共五个步骤:
- 设定目标与基线(C0–C1)。 列出模型的各个模块及其精度和并行方式。将普通的非一致性版本(基线)调优到正常的高性能水平以供人工评审。它是“一致性版本慢多少”的分母。
- 在小模型上使推理自洽(C2–C4)。 小模型(通常是从完整模型中挑选的 4–6 层)必须覆盖每一个算子类别,保留相邻层之间的交互,并匹配逐层大小和量化方式,从而复现大部分局部数值问题。完整深度、长上下文、多 GPU 布局和内存压力仍须在完整模型上验证。首先使推理引擎内部自洽:同一个请求单独执行和在批次中执行结果一致,且整输入处理与逐 token 处理结果一致。同时,寻找会拖慢一致性版本的结构性问题。
- 接入训练(C5–C7)。 训练调用与推理相同的算子,重算推理生成的数据,并逐 token 比较;一旦不匹配,再逐层比较以找出首个分歧层。然后加入反向传播,并将梯度与一个独立于被测代码的参考实现进行比对:前向一致并不意味着梯度正确。
- 运行 RL,然后切换到完整模型(C8–C9)。 在小模型上,在真实训练框架中连续运行两次更新,并在每次更新前后于相同权重版本下进行比较。经人工评审后,切换到完整模型并逐步扩大规模,包括检查 checkpoint 恢复后的第一步。
- 恢复性能(C10)。 逐一优化开销最大的算子,每次优化后重新检查一致性,然后在交付镜像上与基线进行成对比较。
两个设计最为关键。其一, 由两个智能体并行推进基线和一致性工作:一个负责让基线变快,另一个负责构建一致性版本。调优后的基线被冻结以供人工评审,因此智能体无法通过放慢基线来缩小差距。其二, 我们把踩过的坑写进了流程:正在运行的程序必须与正在阅读的源码一致;checkpoint 不仅需要保存,还须验证恢复后的第一步;每一个性能结论都需要公平的基线和可追溯的原始数据;在比较通信瓶颈之前,确认两次运行使用相同的传输方式(来自 4.5 的教训)。
该技能降低了定位和回归的成本(节省尚未在此量化);它不能取代人工判断:基线、精度权衡和配方仍由人来评审。一个例子是每步多次更新导致的路由漂移:智能体根据症状构建了小规模复现,运行了判别性实验并排除了假设,而由人来决定改为每步 1 次更新。
6. 迁移:Nemotron,一个 Mamba 混合架构 + NVFP4
随后我们在一个结构上截然不同的模型上测试了参考配方和技能。
Nemotron-3.5-Lightning-30B-A3B (NVFP4) 是运行在 GB200 上的 Mamba-2 / 注意力 / MoE 混合模型(NVFP4 W4A16 路由专家、FP8 Mamba 投影、注意力使用 FP8 KV cache)。基线使用 NVFP4 QAT 训练(量化规则和导出来自 NVIDIA ModelOpt)+ R3 路由重放;一致性版本共享 vLLM 的前向计算,不使用路由重放。两次运行均使用 BF16 主权重和每步 1 次更新。
循环结构有先例可循。在 vLLM 社区中,Alexander Jiang 和 SkyRL 团队为 Qwen3.5-35B-A3B 中的 Gated DeltaNet(GDN)在 IsoExec 针对 Qwen3.5-35B-A3B 中的 Gated DeltaNet(GDN):它保留循环形式但按块并行计算,因此训练、prefill 和 decode 共享同一种舍入顺序,并且其 统一模型 为训练和推理提供单一模型定义和一组对齐的算子。IsoExec 的“零失配”在其执行契约范围内成立;端到端它仍报告微小的非零 logprob 差异(平均绝对差约为 1e-7),这与本文的“逐位相同”不同。Mamba-2 属于同一种线性递推。我们让 decode 精确重放 prefill 的分块算术,而不是使用它自己的单步递推,并且训练像统一模型那样导入与推理相同的算子。智能体 + 技能完成了这一对齐。
在 vLLM 中,每一个可能依赖于批次组成的算子都获得了批次无关的实现,训练(一个轻量的 Megatron-LM 分支)导入它们:
| 算子 | 一致的版本 |
|---|---|
| Mamba-2 SSD 扫描 | 解码精确重放预填充的分块算术、固定的 autune 配置、fp32 状态 |
| 注意力 | FlashAttention,使用固定的 split-KV,分裂数量与批次无关 |
| 路由专家(NVFP4 W4A16:4 位权重,16 位激活) | CuTe-DSL 分组 GEMM,单一 tactic,无 split-K,按槽位顺序进行 fp32 合并 |
| MoE all-to-all | 单边通信,固定的合并顺序 |
| 路由器 GEMM | 批次无关的持久化 matmul,fp32 输出 |
| 归一化 / FP8 量化 | 统一的批次无关内核;禁止改变数值的融合 |
结果:在 SWE-bench Pro 上训练
我们在远程沙箱中的 SWE-bench Pro 上运行智能体强化学习:每步 32 个任务 × 8 条轨迹,平均每条约 57K token,使用 GRPO,每次运行使用 8 个 GB200 节点。训练集是 SWE-bench Pro 中满足以下条件的 375 个任务:基础模型的 4 次采样尝试既非全部正确也非全部错误,且 gold patch 能在我们的沙箱中通过,因此下文分数是该子集上的训练奖励。两次运行使用相同的镜像和配方,未使用 TIS 或 MIS 等修正手段。每步 1 次更新时,更新前 rollout logprob 与训练侧重计算之间的 KL 即为该步的 train-inference KL。
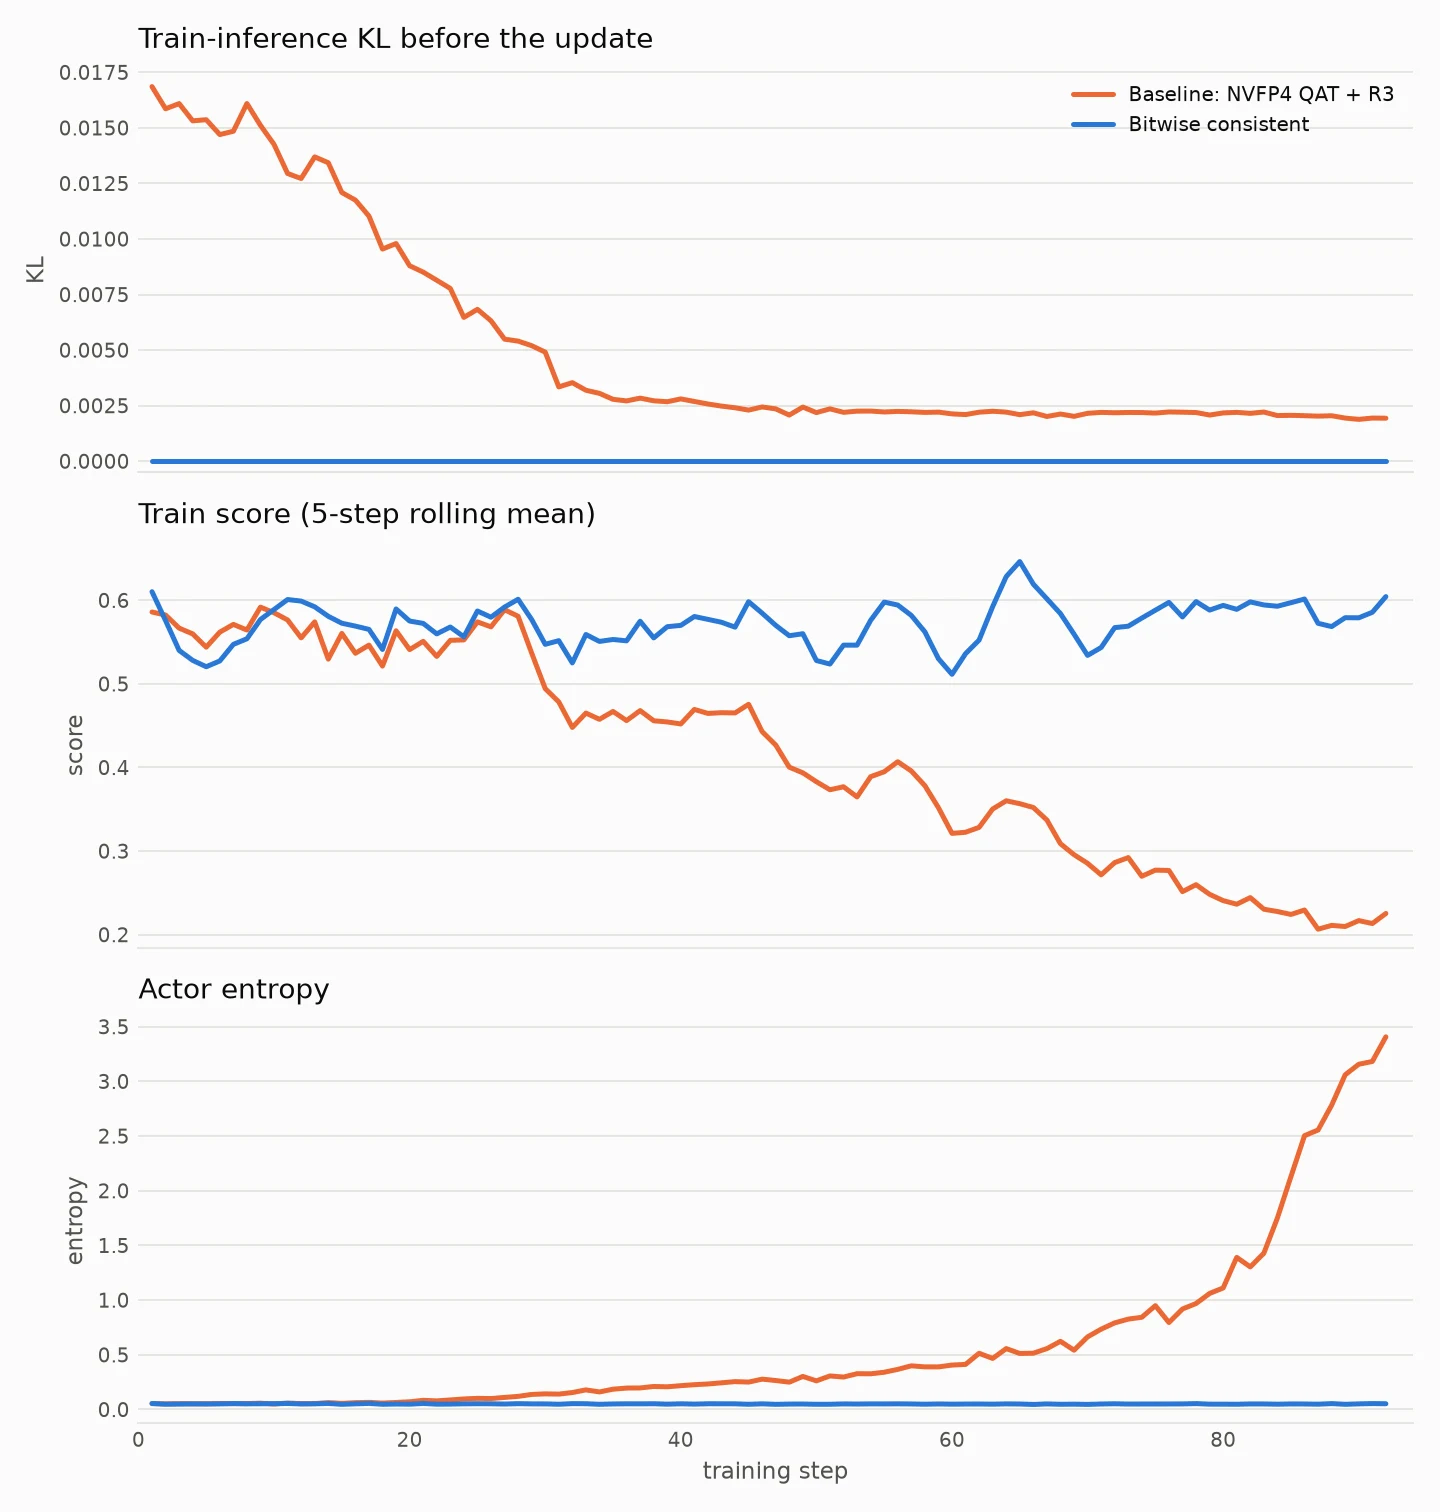
上:每步 train-inference KL;中:训练分数(当前步与前 4 步的移动平均);下:actor 熵。橙色:基线;蓝色:一致版本。一致版本在第 10 步时仅有少量轨迹从沙箱返回,因此其分数被排除。
- 一致版本:train-inference KL 每一步都精确为 0,熵保持在 0.05 左右,分数从 0.56(前 10 步)升至 0.59(后 10 步),没有下降。
- 基线:train-inference KL 从约 0.015 降至约 0.002,但熵从 0.05 升至 2.6,分数从 0.56 降至 0.22(前 10 步与后 10 步对比)。
- rollout 速度:在前 30 步中,两次运行都处于健康状态时,一致版本的 rollout 吞吐量为基线的 87.5%,仅慢 12.5%。
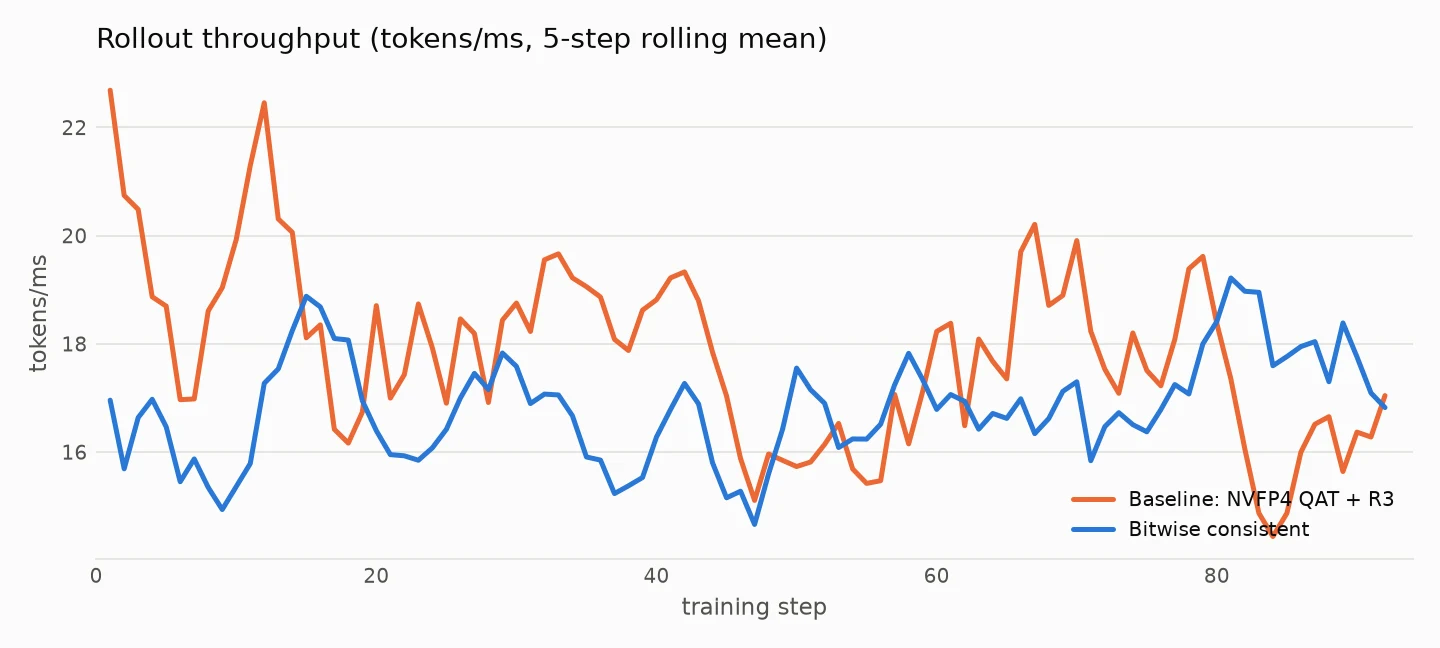
每步 rollout 吞吐量(token/ms,当前步与前 4 步的移动平均)。橙色:基线;蓝色:一致版本。
7. 开源
我们将这些成果开源,让其他人借助该技能、现成代码和基于自己模型的智能体,以更少依赖资深工程师逐算子检查的方式实现 train-inference 一致性。发布内容包括:
- train-inference-consistency 技能:完整工作流(C0–C10)、十份指南,以及 logprob 对比和梯度交叉验证等关键实践;
- DeepSeek-V4:在 Megatron 和 vLLM 上达到 0 diff 的真正 on-policy RL 配方, verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (BF16 主权重,在训练前向和权重同步时量化为部署用的 NVFP4):
- 与训练按位一致的 vLLM 推理: aoshen02/vllm#85;
- 与 vLLM 对齐的训练 actor: aoshen02/Megatron-LM#7;
- 两项 verl 改动: aoshen02/verl#11;
- train-inference 一致性配方与统一镜像 Dockerfile: aoshen02/verl#12.
欢迎提出 issue、PR,以及在你自己的模型上使用该技能的反馈。
下一步:DeepSeek-V4.1 的 train-inference 一致性已达到 0 diff;性能优化正在进行中,将另行发文。
致谢
感谢(机构按字母顺序排列):