
思考
摘要
Timestral 是 Mistral 首个时间序列基础模型系列,仅用 209M 参数即可提供最先进的概率性多变量预测,在关键基准上超越更大的模型,同时支持过去和未来协变量。该模型提供四种规模(5M 至 209M 参数),在精度和效率之间取得平衡,可在 CPU 上高效运行,并在各领域的零样本预测中表现出色。该模型结合了合成预训练、协变量感知注意力机制和长上下文学习,并可通过 Mistral Forge 提供微调选项以实现领域适配。
今天,我们发布 Timestral,这是我们首个时间序列基础模型系列。我们最大的模型仅有 209M 参数,却在该领域三大主要公开基准 GIFT-Eval、TIME 和 fev-bench 上均排名第一,仅用此前最先进模型三分之二的参数就超越了其性能。
Timestral 提供概率性多变量预测,并支持仅过去协变量和已知未来协变量。我们的模型系列位于预测精度与模型规模的帕累托前沿,在每个规模上都提供领先性能。相关结果已提交至 GIFT-Eval 和 TIME 排行榜。
时间序列基础模型(TSFM)
时间序列是企业中最常见的数据类型之一,从传感器遥测数据到可观测性指标皆是如此。基于时间序列的预测为容量规划、能源、供应链、风险和维护方面的决策提供支持。
工业工厂根据生产计划预测工艺传感器,在设备故障之前发现设备漂移,并针对数千个资产规划产能和备件。财务团队预测资金流、交易量和波动性,以指导数千个账户的头寸、对冲和资金管理。
ARIMA 和线性回归等经典模型仍是预测时间序列的成熟工具。这些模型通常只拟合单一序列,且仅从该序列的历史中学习。
PatchTST 等深度学习模型增加了跨多个相关序列学习非线性模式的能力,但它们通常仍需在每个数据集上从头训练,因此所学内容无法迁移到新领域。
时间序列基础模型将预训练方法引入时间序列领域。我们的模型在庞大而多样的语料库上训练,学习可跨序列迁移的模式,能够对其从未见过的数据零样本预测,即使是在数据稀缺的领域也是如此。
基准测试结果
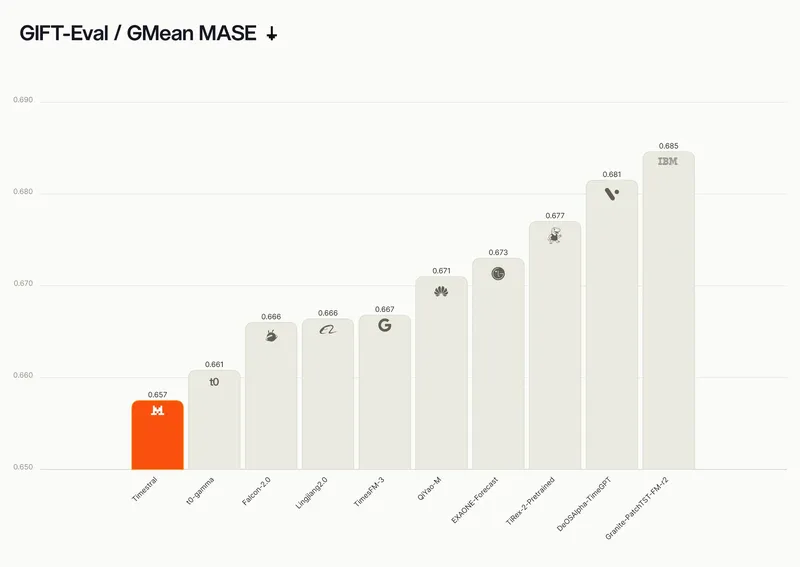
我们在三大主要公开预测基准 GIFT-Eval、TIME 和 fev-bench 上评估了 Timestral。在预训练零样本模型中,它在全部五项指标上均排名第一。这些结果来自单一检查点,未使用集成方法。
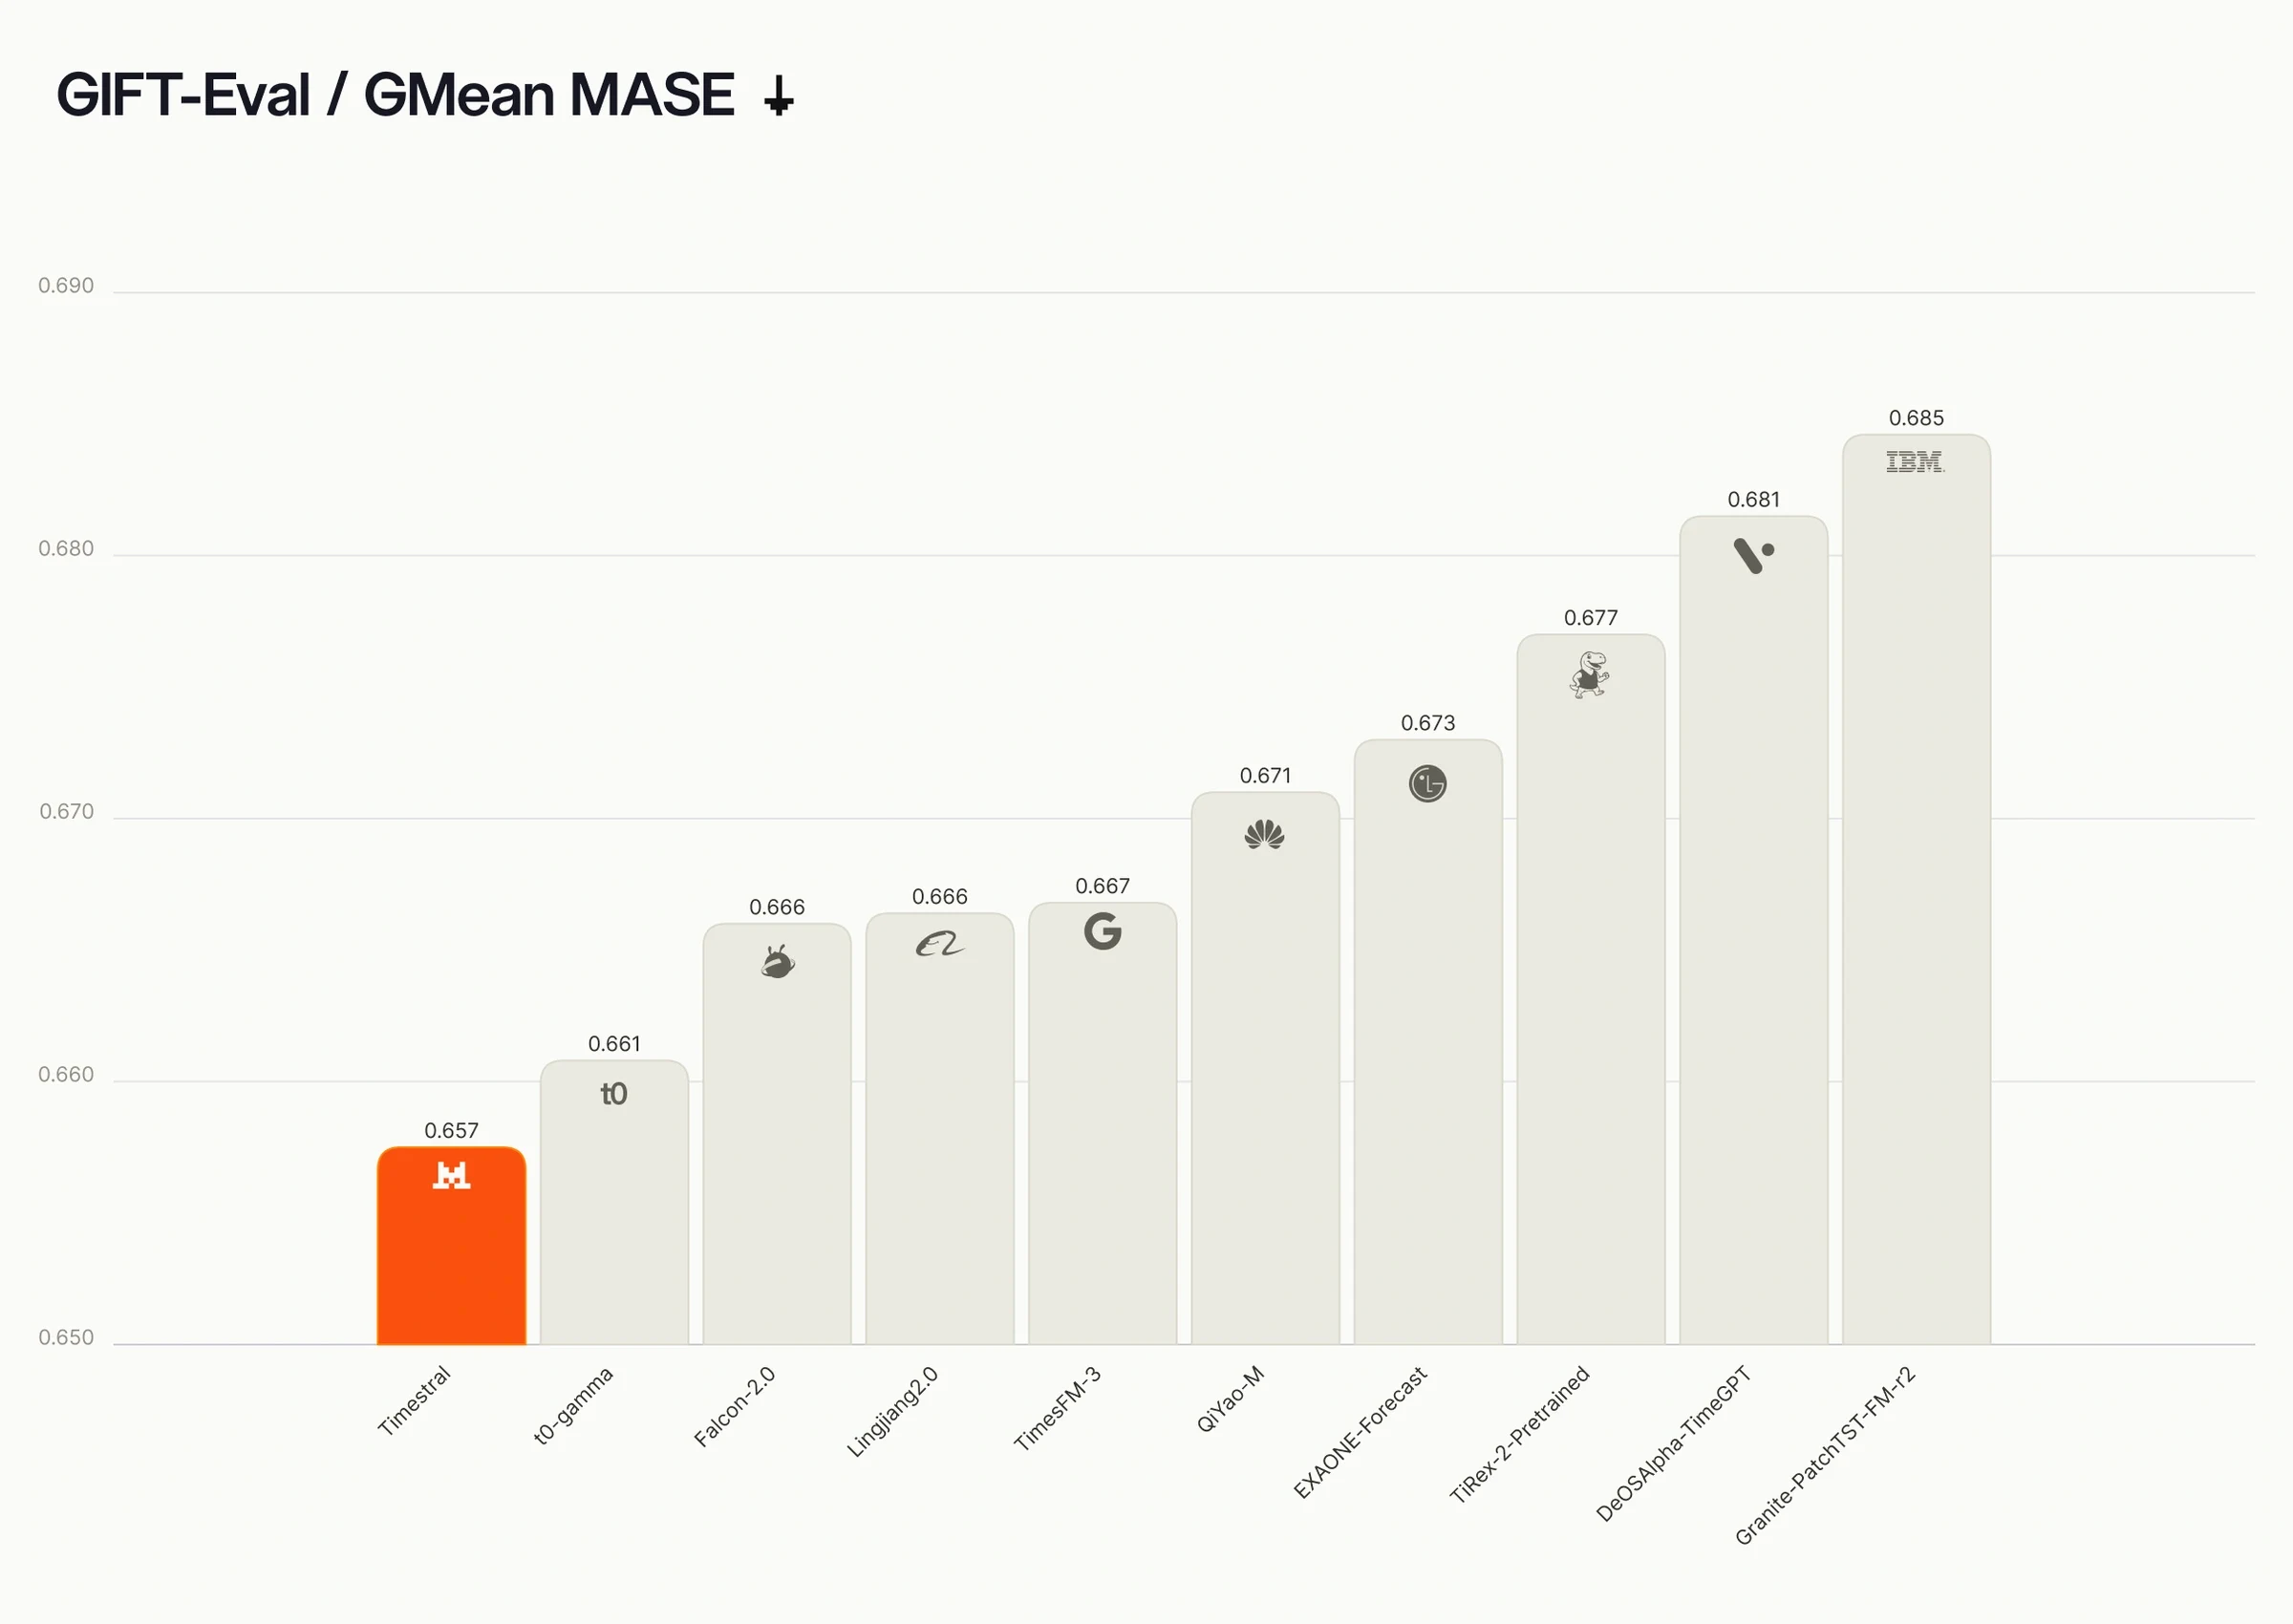
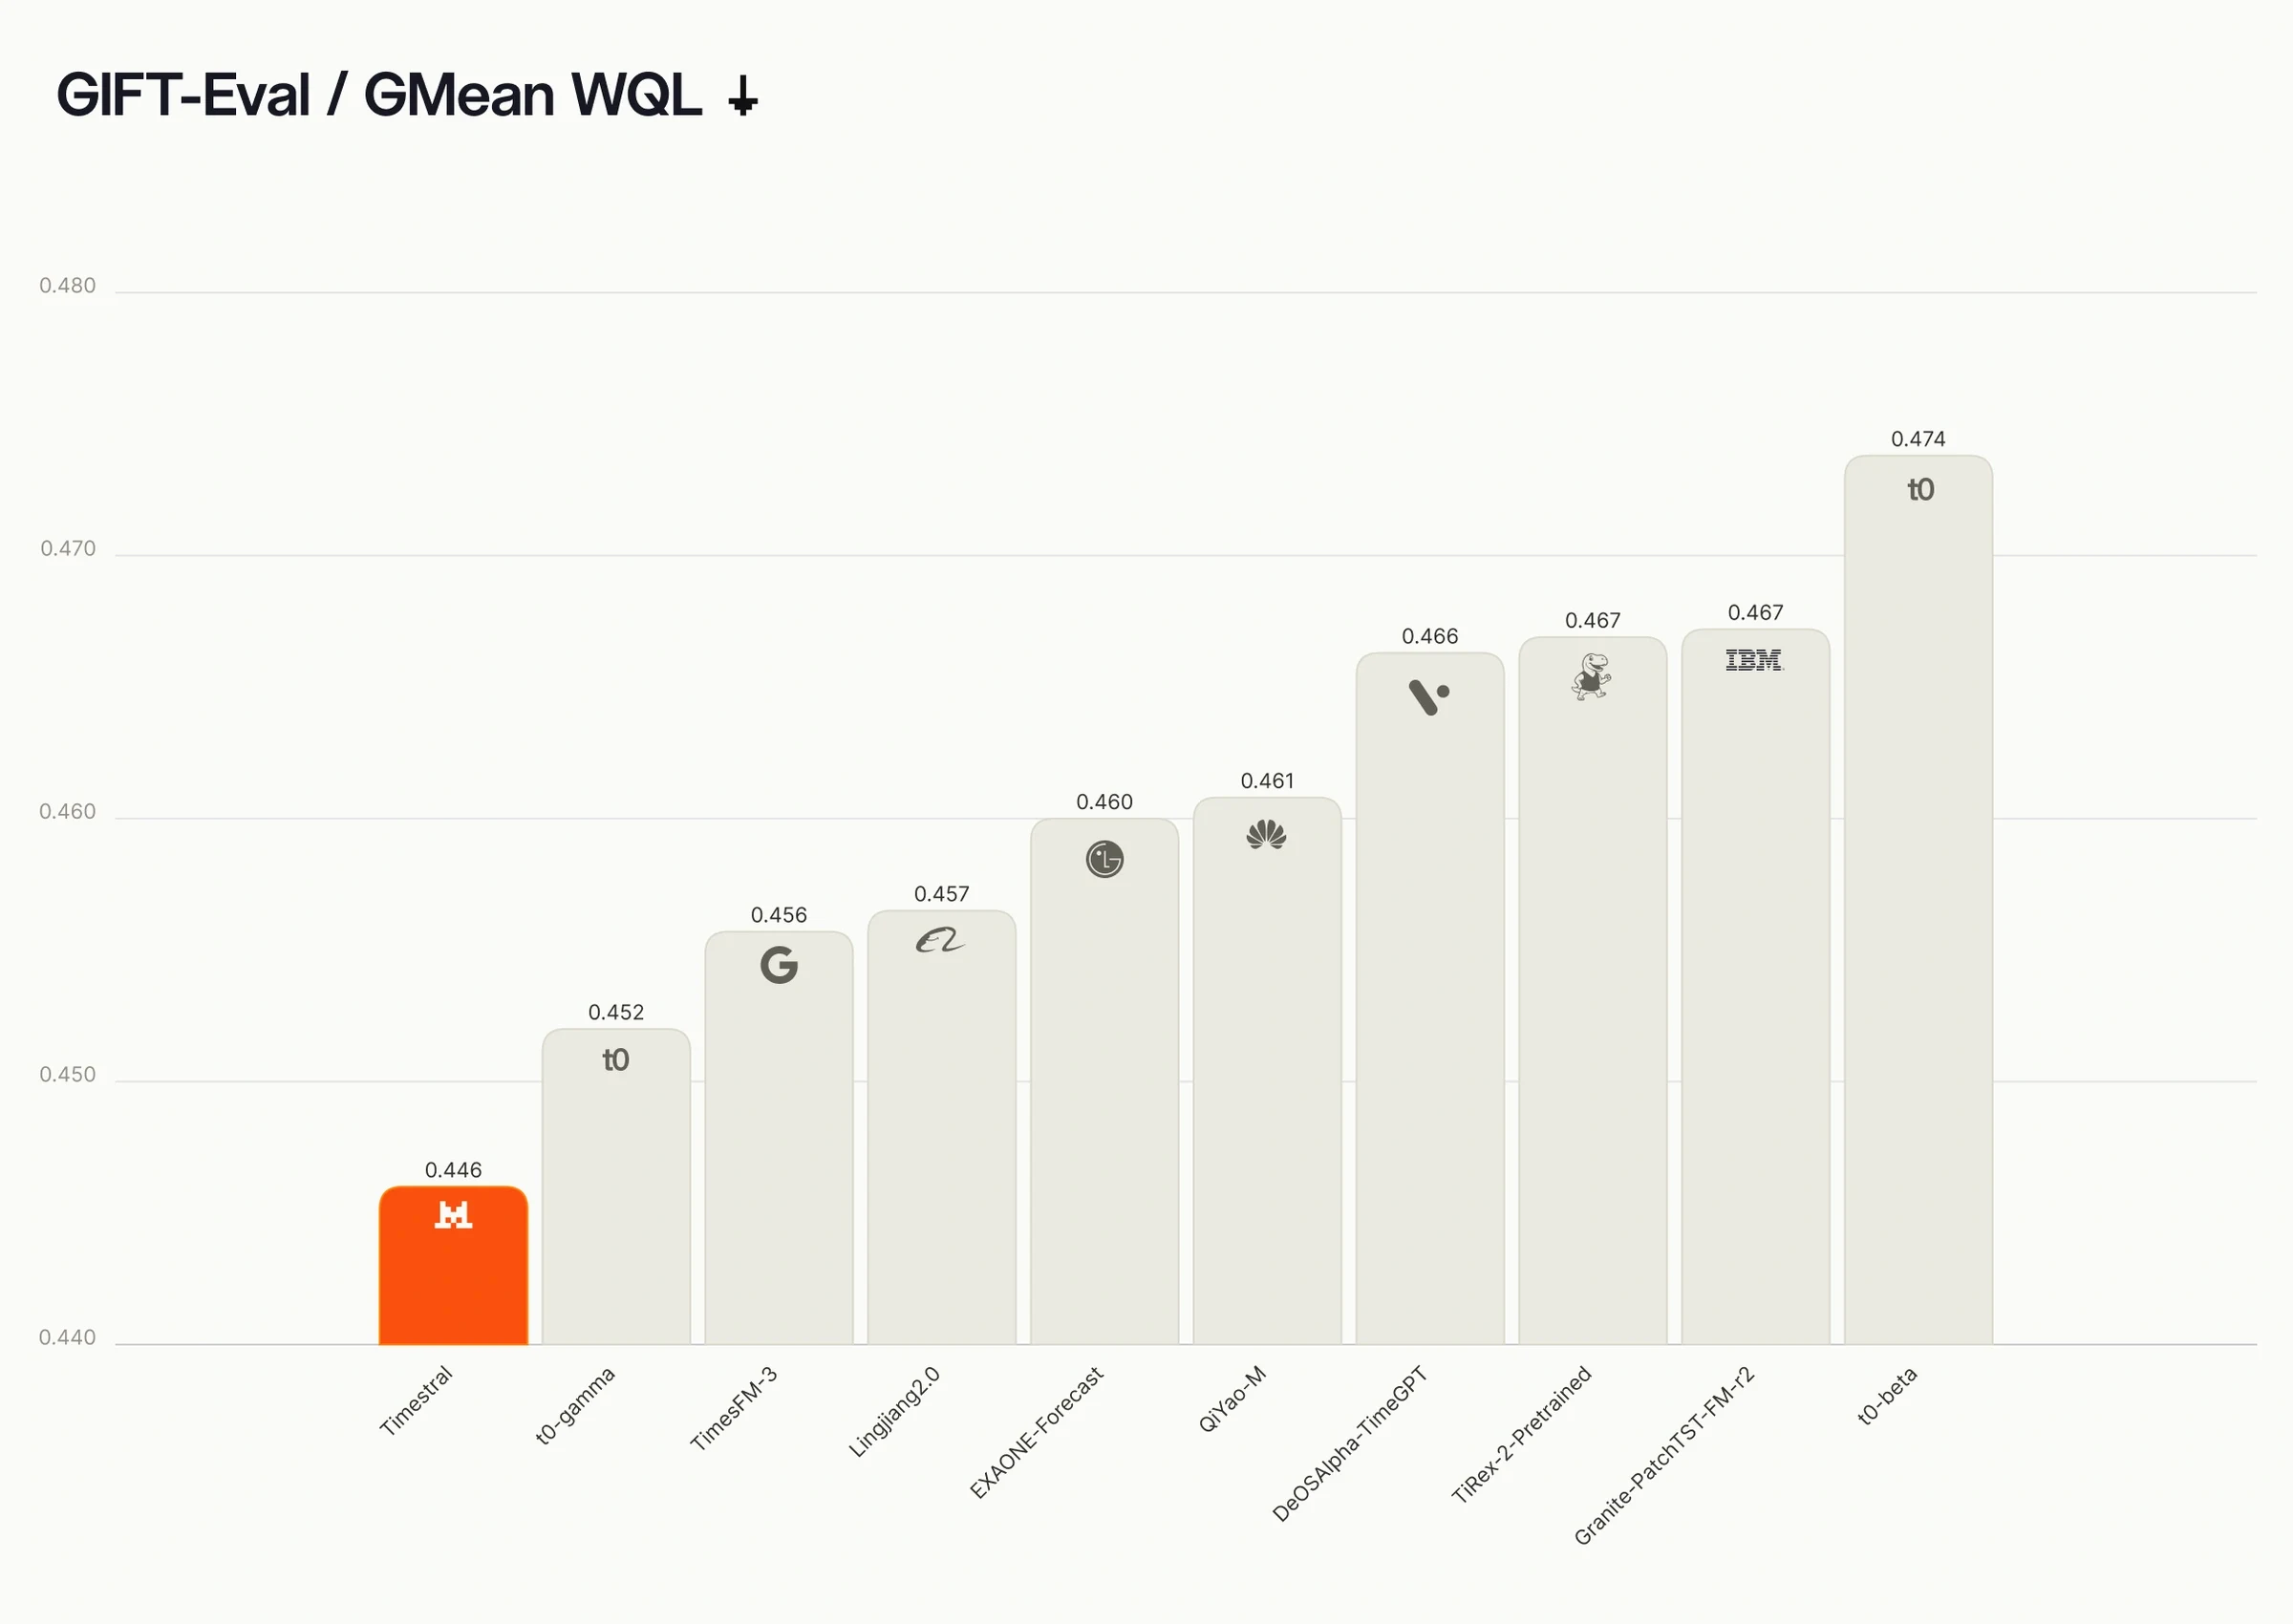
GIFT-Eval,83 个可比的预训练和零样本条目中的前十名。数值越低越好。
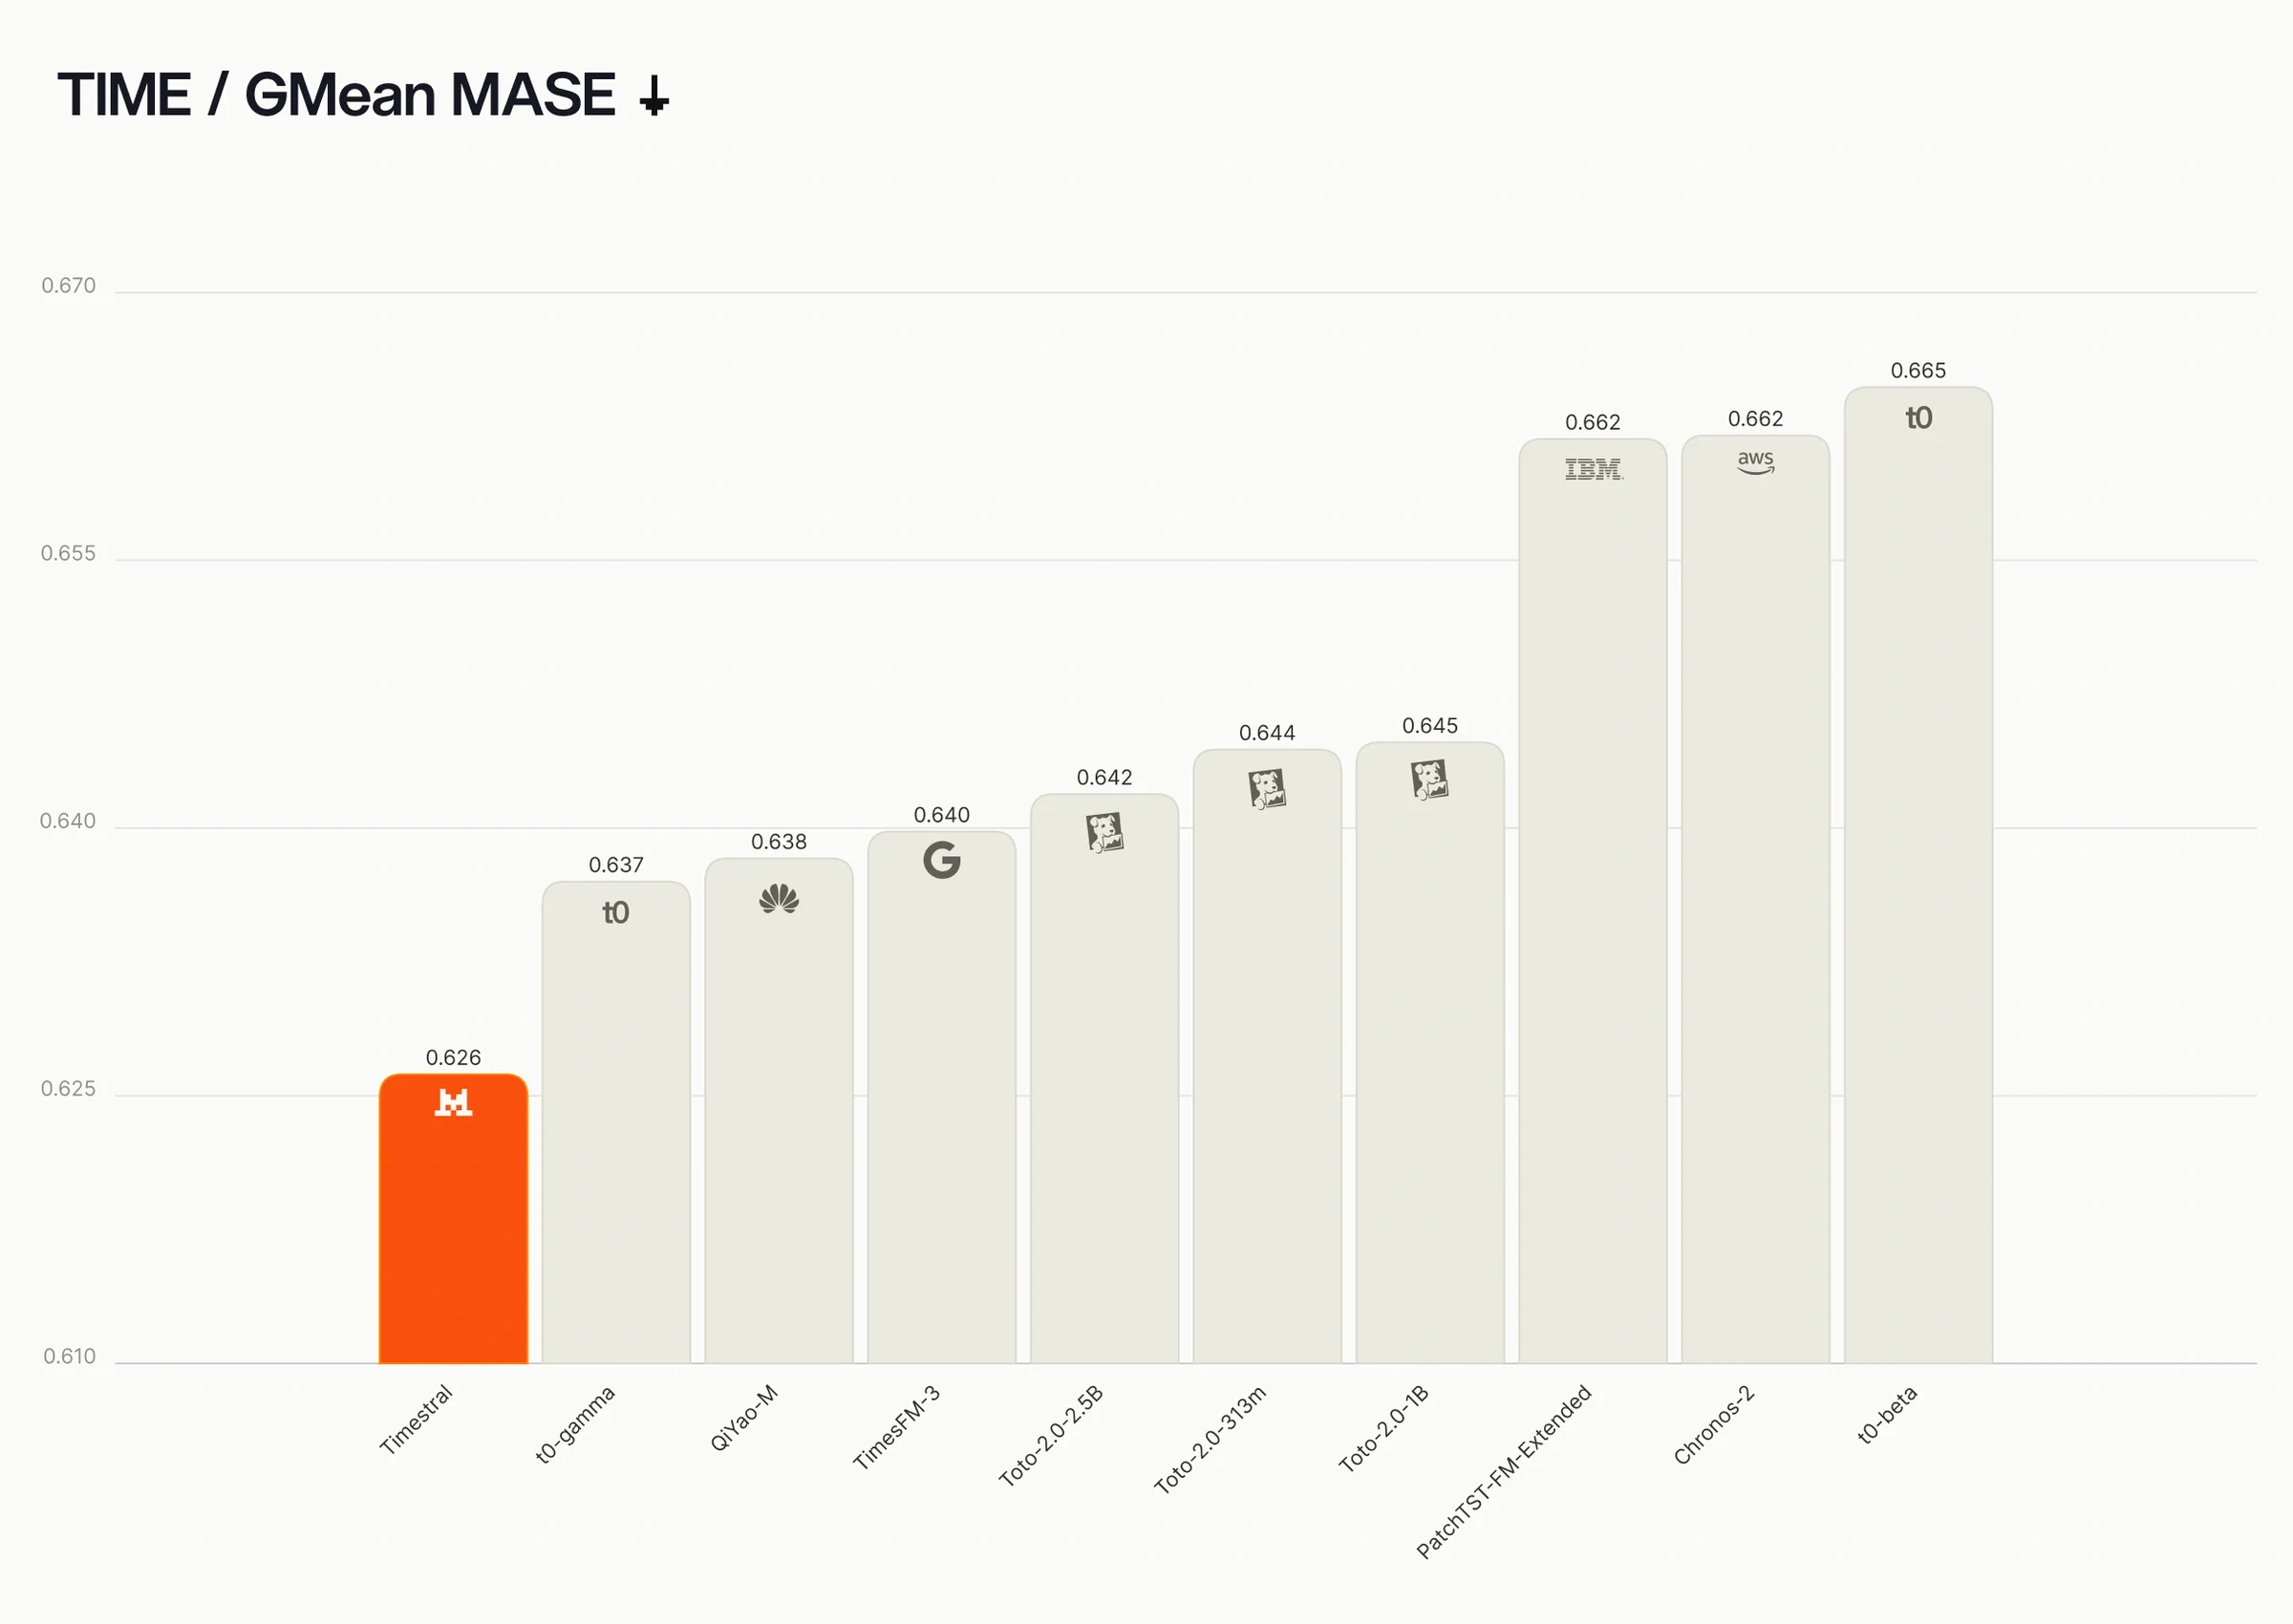
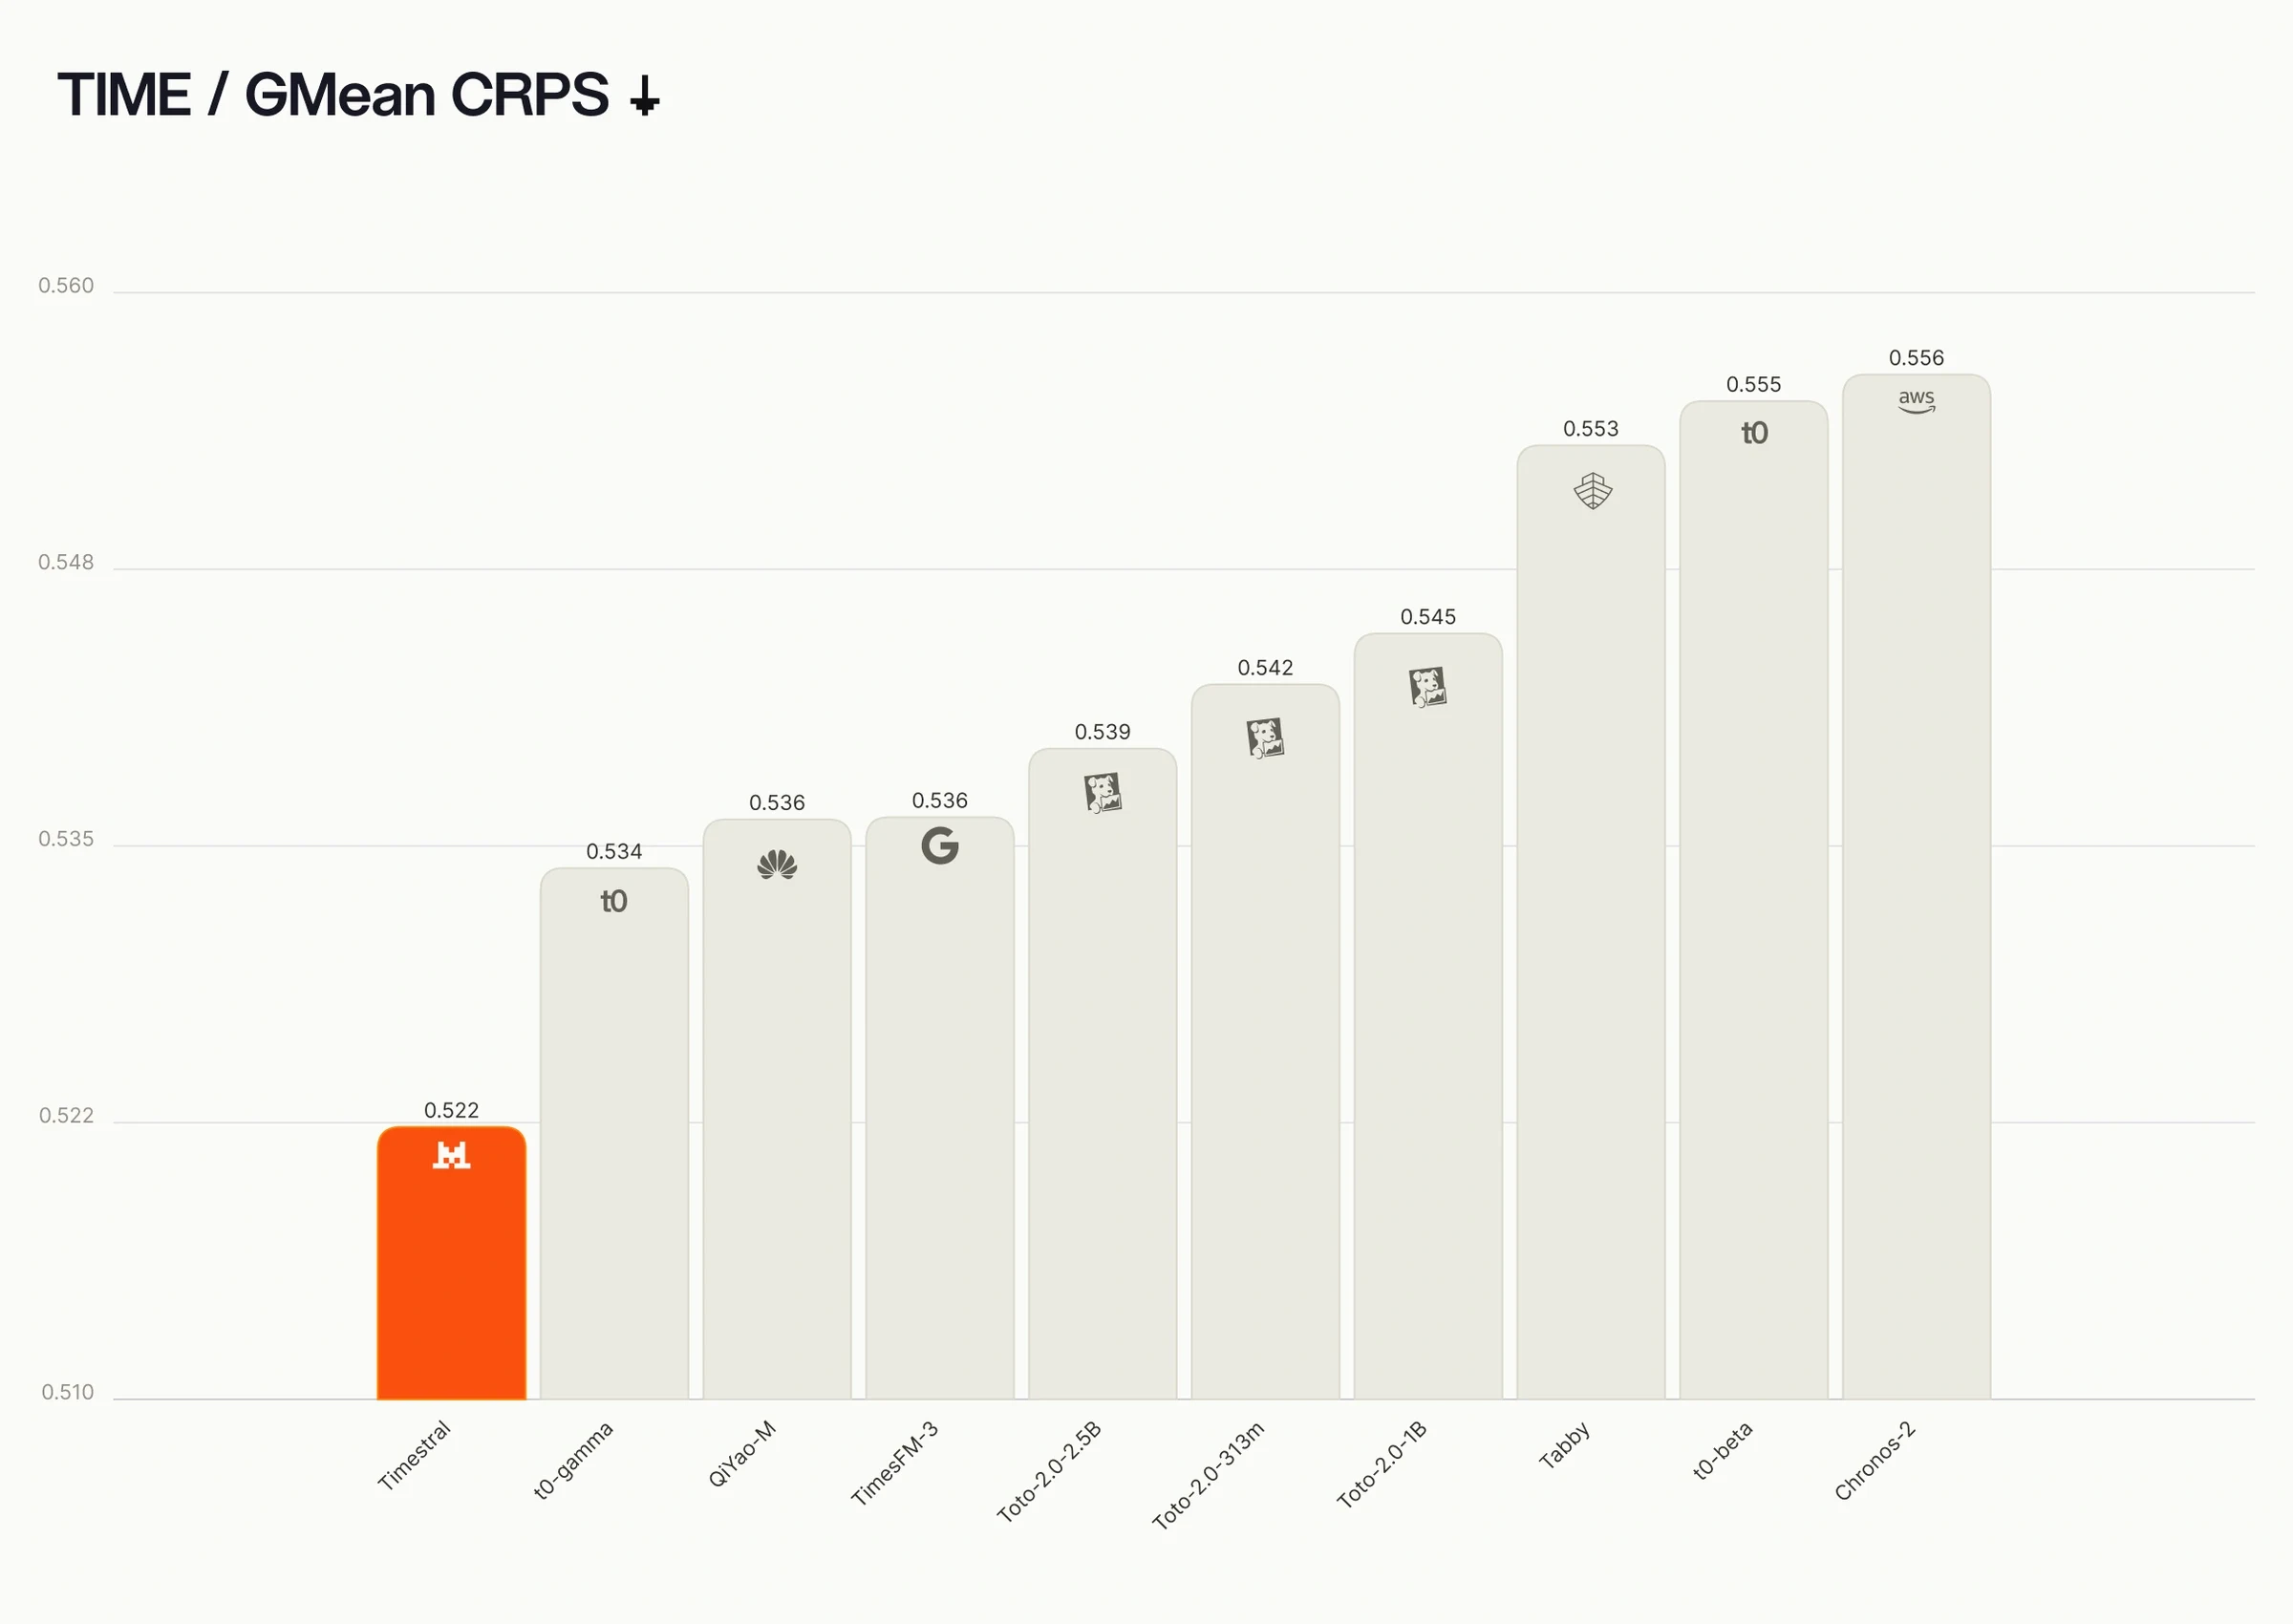
TIME,35 个排行榜条目中的前十名。两项指标均为数值越低越好。
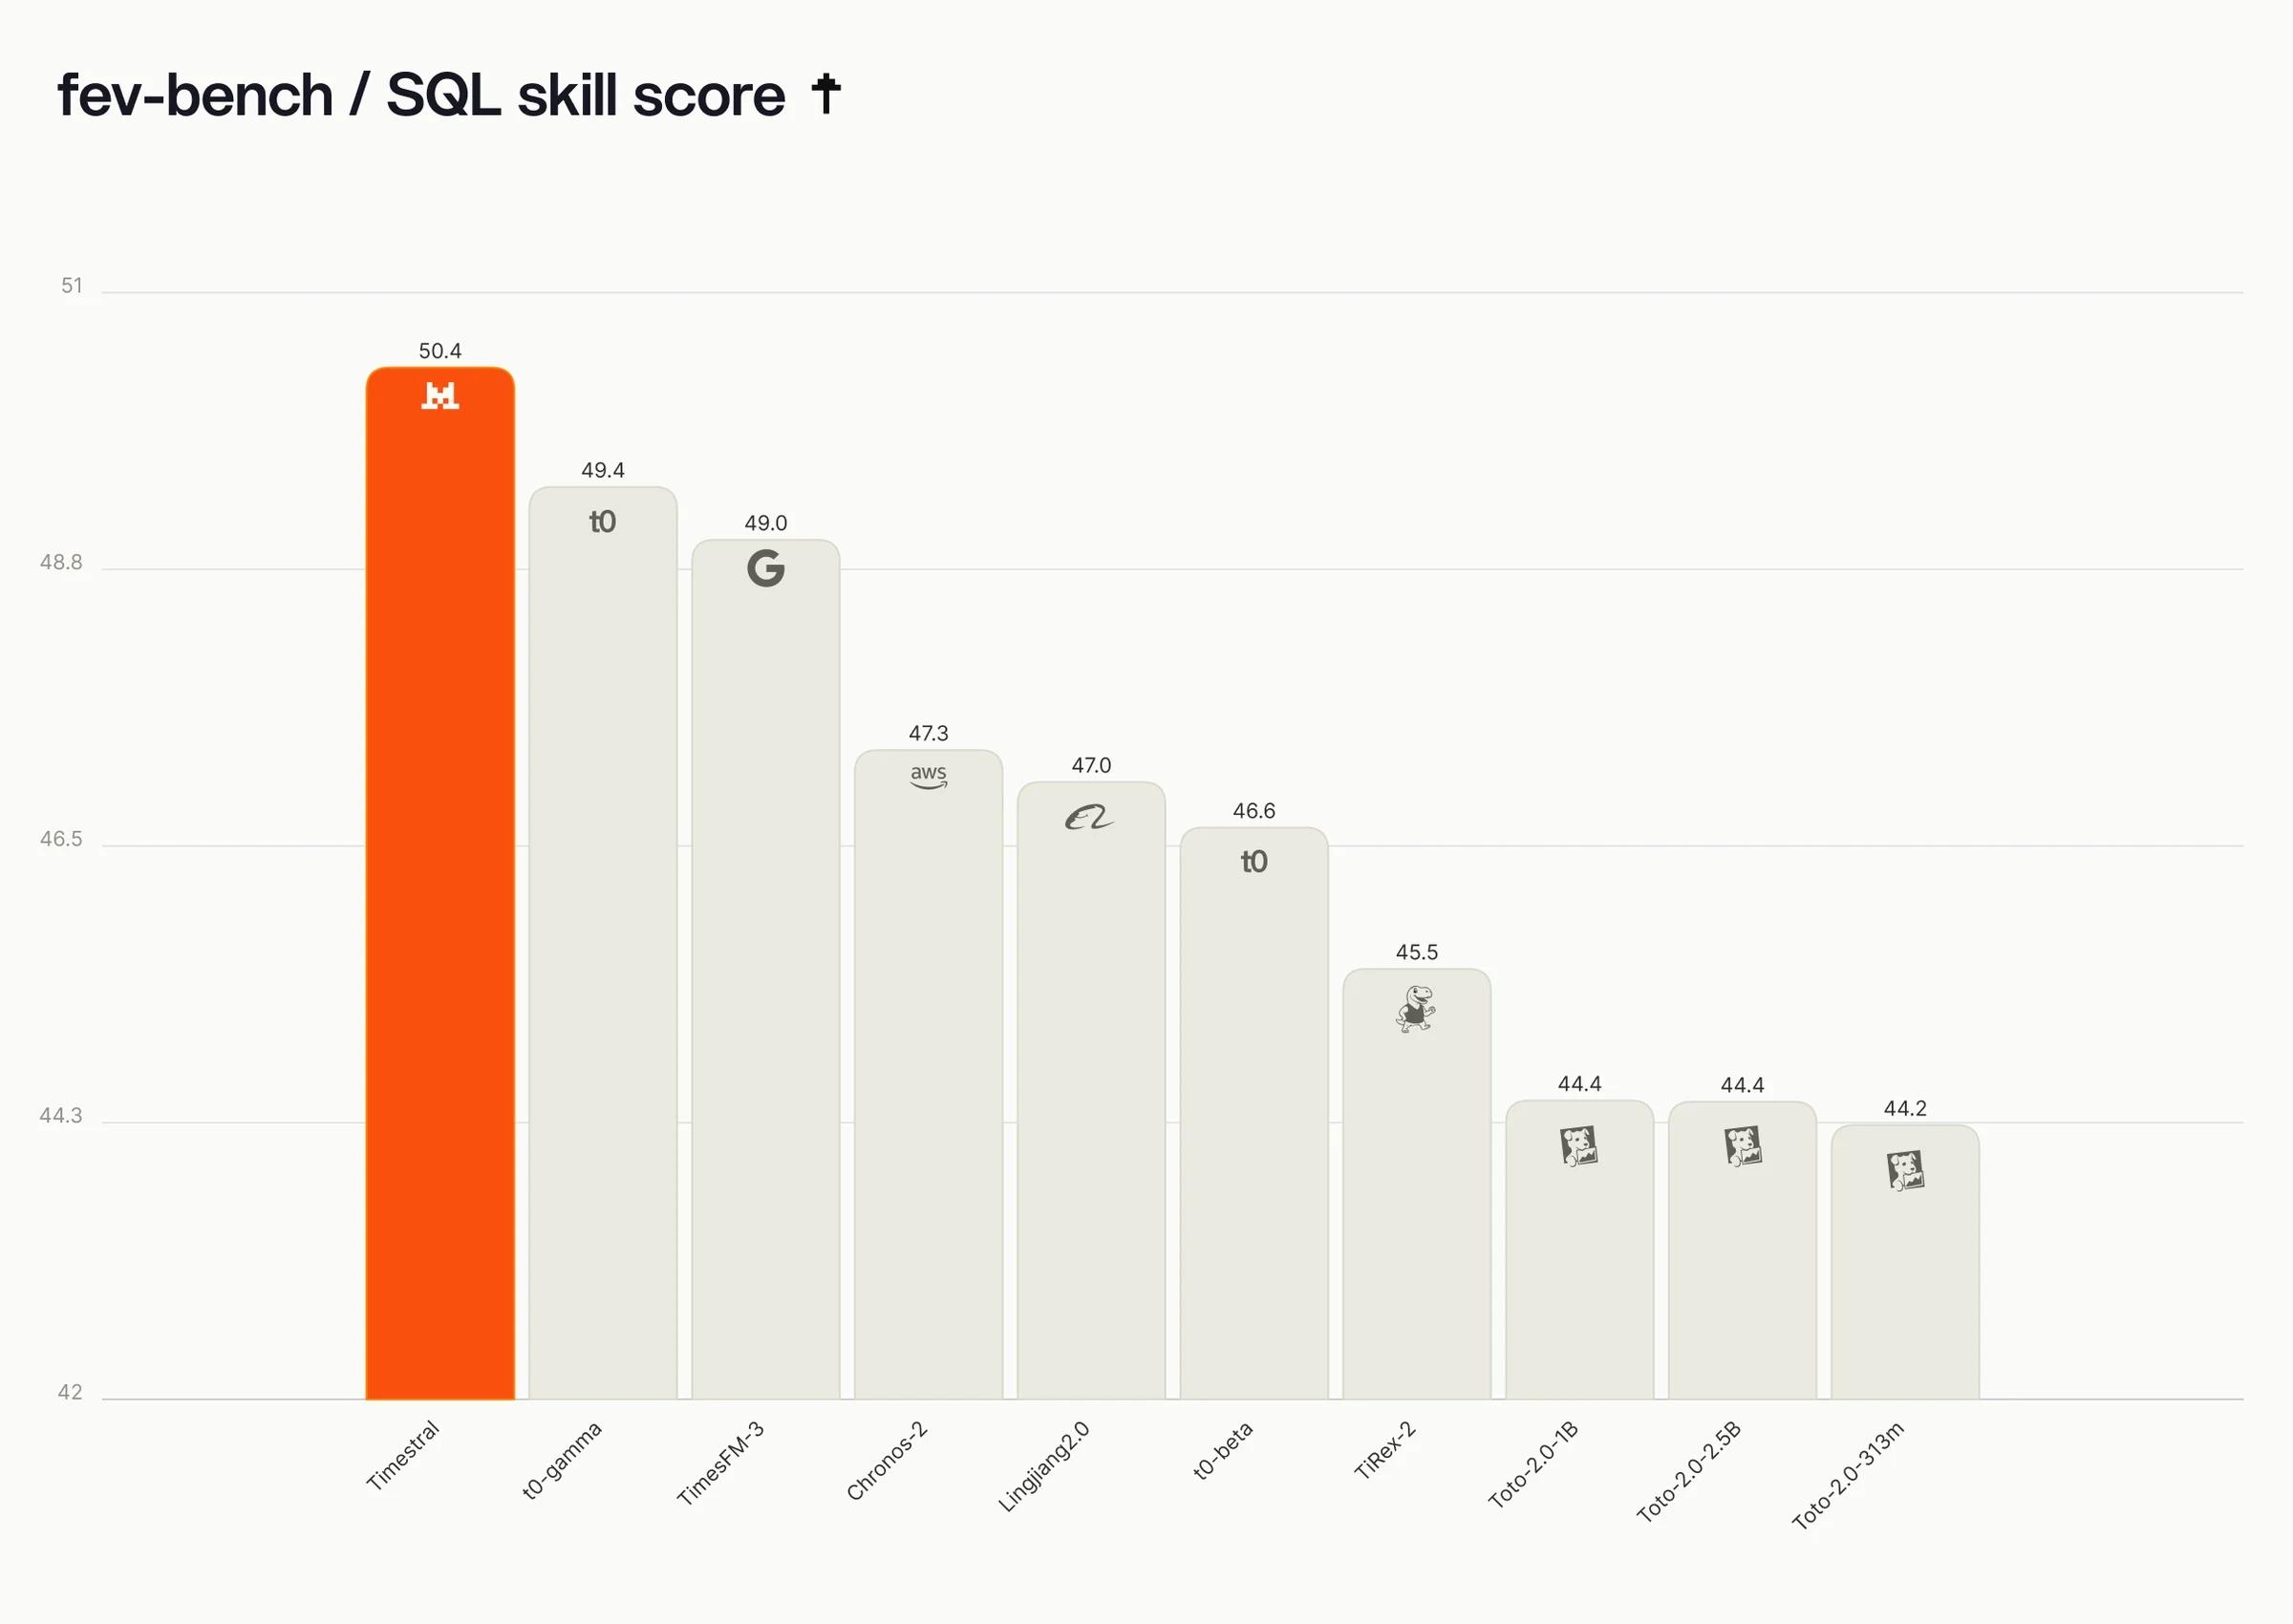
fev-bench,37 个排行榜条目中的前十名,按 SQL skill score 排序。数值越高越好。
为每种规格优化的模型系列
Timestral 已被优化为一个包含四个模型的系列:5M、28M、123M 和 209M 参数。较大的模型提升预测性能,较小的模型则更快、更便宜。这四个模型共享相同的架构和训练配方。每个规模都位于精度与模型规模的帕累托前沿:对于每个模型规模,没有公开模型能预测得更好。
GIFT-Eval、TIME 和 fev-bench 上的得分与模型规模对比(显示为 1 − skill score)。数值越低越好。我们的 28M 模型在 GIFT-Eval 和 TIME 上击败了规模约大四倍的 Chronos-2。我们的 209M 模型以更少的参数击败了 TimesFM-3 和 Falcon-2.0。
Timestral 在推理时不需要 GPU。在一台 8 线程的标准服务器 CPU 上,基于三周的 15 分钟历史数据预测未来一天,5M 模型需要 10 ms,209M 模型需要 140 ms。较小的模型以一定精度换取速度:28M 模型比 209M 模型快五倍,123M 模型的得分与 209M 模型相差不超过 0.2%,而延迟仅为后者的四分之三。
一个工业示例
考虑一家拥有数千个设备传感器的工业工厂。Timestral 可以通过多种方式改进对该数据的预测。
多变量预测。 泵的振动、温度和压力并非独立变化。其中一个指标的上升往往可以解释或导致另一个指标的变化。Timestral 对相关序列进行联合建模,因此可以利用这些依赖关系,而不是孤立地预测每个传感器。
概率预测。 单个预测值可能无法展示全貌。Timestral 预测完整的分位数集合,团队因此可以看到不确定性的范围,设置与之匹配的警报阈值,并围绕风险而非单个数字来规划维护。
类别协变量。 有些协变量取值于一组类别而非连续数字,例如星期几,或机器的状态(运行中、空闲、维护中)。将这些变量编码为数字会强加它们本身并不存在的顺序或尺度。Timestral 直接将它们作为类别输入,以改进预测。
已知未来协变量。 传感器行为的某些驱动因素是已知的,例如生产计划、计划停机和天气预报。Timestral 可以基于这些因素进行条件预测,从而提高预报质量,使计划中的负荷增加成为预期之内,而不是被标记为异常。
从模型到系统
Timestral 是一个数值模型,可以在现有的监控管道中运行,也可以与我们的语言模型配对,用于多模态智能体工作流。
在工厂中,它可能看起来是这样的:
Timestral 持续运行于工厂的传感器数据流之上,在异常发生时实时检测。
当它在某台泵上标记出异常时,一个代理会对信号进行嵌入,并与历史传感器数据的嵌入进行比较,以找到相似的历史故障。
随后,该代理会启动子代理进行根因分析,参考来自该工厂的上下文信息,例如维护记录、班次日志和操作员笔记、设备手册、过往工单以及相关设备的读数。
代理根据这些发现起草一份建议的诊断报告,附上支持证据和可能的后续步骤。
工厂经理得到的是一份由传感器数据支撑的诊断和计划,而不仅仅是一条警报。
关键技术贡献
这些成果是多个想法结合的产物。每一项都将在技术报告中详细描述。
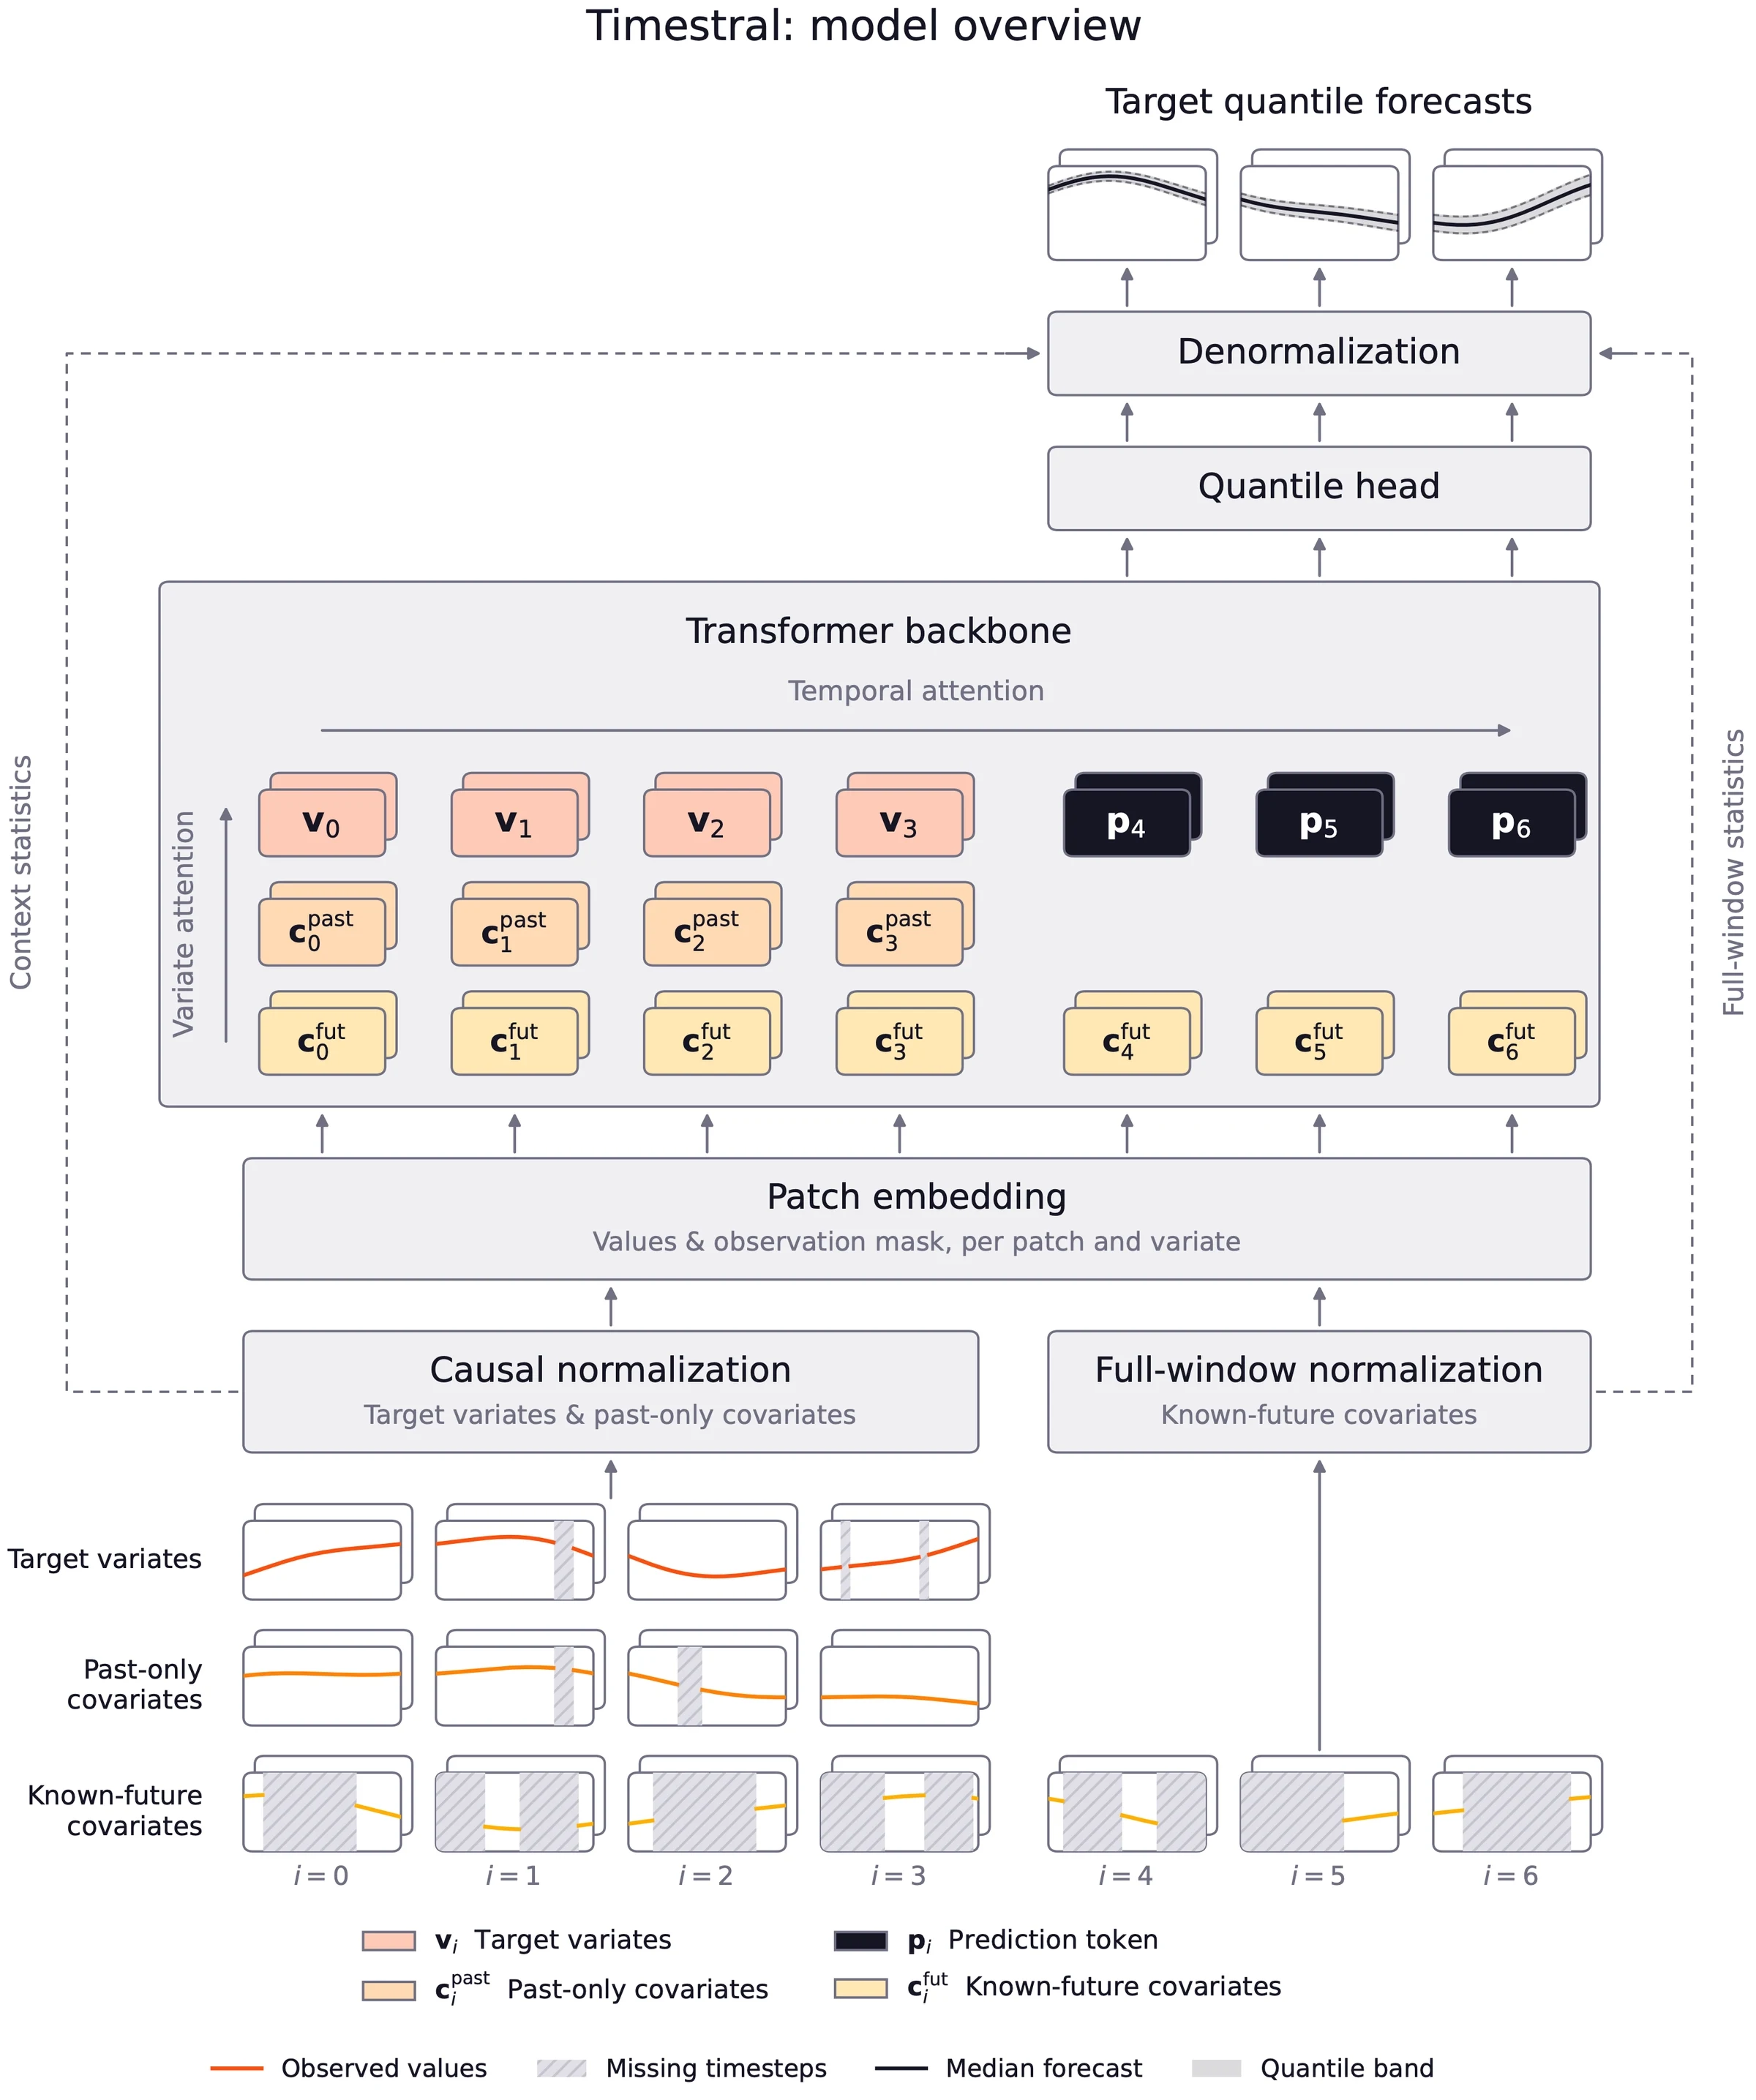
解耦视界预测(Decoupled Horizon Forecasting)。 采用连续补丁掩码训练的因果解码器,如 Toto 2.0 和 TimesFM-3,会掩蔽待预测的值,使其看起来像缺失值,因此也无法作为后续预测的上下文。我们的方法 DHF 将两者分离:完整历史保留在序列中,学习到的预测 token 读取其之前的历史。这样,每个观测值都同时作为目标和上下文,真正的缺失值仍被标记为缺失,且训练视界长度和缺失数据增强可以相互独立地调整。
协变量感知注意力(Covariate-aware attention)。 每条输入序列都被赋予一个角色:目标变量、仅过去协变量或已知未来协变量。已知未来协变量在整个窗口内可见,而目标保持因果性,信息仅从协变量流向目标。因此,Timestral 可以使用节假日日历或天气预报,而不会将目标自身的未来泄露到其预测中。
合成数据优先(Synthetic-first data)。 大部分训练数据是合成的。我们首先生成了具有连贯时间动态的单变量过程,包括趋势、季节性和多样的噪声模式。然后,我们使用多变量合成器,通过在这些过程之间引入非线性依赖来构建多变量序列。
两阶段训练(Two-stage training)。 Timestral 首先在纯合成数据上以 8192 的上下文大小进行大规模预训练,然后在真实与合成数据混合的数据上以 4 倍长的上下文进行后训练。目标函数是覆盖 21 个分位数的 pinball 损失,它是 CRPS 的离散近似。
一个可以被适配的模型
公开基准衡量的是通用性能,但生产数据在行为和结构上可能大不相同。随着市场改变状态、设备老化和需求模式变化,数据也可能随时间发生漂移。持久的价值在于能够将模型适配到领域内数据,并随着分布变化持续对其进行再训练。
对于想要更进一步的组织,Timestral 可通过以下方式获取 Mistral Forge,即我们用于语言模型的同一训练流水线。它支持:
零样本推理 ,开箱即用。
架构扩展,例如领域特定的协变量。
在专有数据上微调,在保持通用性能的同时专注于某一领域。
对训练数据的控制,包括调整训练配比、重放预训练数据,以及生成反映目标领域的合成数据样本。对数据的完全控制确保了我们在回测中使用的任何数据都未在预训练中出现过。
完整流水线可以部署在客户自己的硬件上,包括物理隔离(air-gapped)环境。
下一步
我们已发布了一个 GitHub 仓库 因此您可以在自己的数据上运行 Timestral。包含完整结果的技术报告随后将发布。如需解决更专业的预测问题,或希望在研究方面开展合作,请与我们联系。
Timestral | |
|---|---|
类型 | 时间序列基础模型(TSFM) |
参数量 | 5M、28M、123M 和 209M |
上下文长度 | 32,768 个时间步 |
输出 | 概率预测,21 个分位数 |
输入 | 多变量目标、仅过去协变量和已知未来协变量 |
部署 | 本地部署、VPC 或物理隔离环境 |
许可 | 修改版 MIT |
Timestral
新
Mistral 的时间序列基础模型。具有最先进的概率预测能力,参数规模为 5M–209M,可在 CPU 上运行。
概率预测
发现