
亮点
- 架构:总参数量 816B,每个 token 激活 42B,具有 1M 上下文窗口。
- 量化:Meta 以 BF16 和 NVFP4 两种格式发布了该模型。MXFP4 权重由 AMD 发布。
- 多模态:通过与 Muse Glimmer 相同的 Perception Encoder 实现原生图像和视频感知,并额外支持音频。
- 并行:在 Nvidia 和 AMD 上均支持张量并行和流水线并行。在 Nvidia 上支持 EP、TEP、DEP 和 PD 分离。TPU 上也有初步支持。
- 推测解码:我们训练了一个 DSpark 草稿模型,在 CUDA 和 ROCm 上均受支持,可加速模型性能,并在 SPEED 基准上进行了测试。
用法
两家厂商均有预构建镜像可用:
- Nvidia:vllm/vllm-openai:muse-spark-open
- AMD:vllm/vllm-openai-rocm:muse-spark-open
请注意,在代码(PR #61879)被审核并合并之后,该模型才会在 nightly PyPI wheel 上可用,这通常需要大约一周时间。
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
要以纯文本使用此模型:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
对于多模态感知:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
实现细节
模型架构
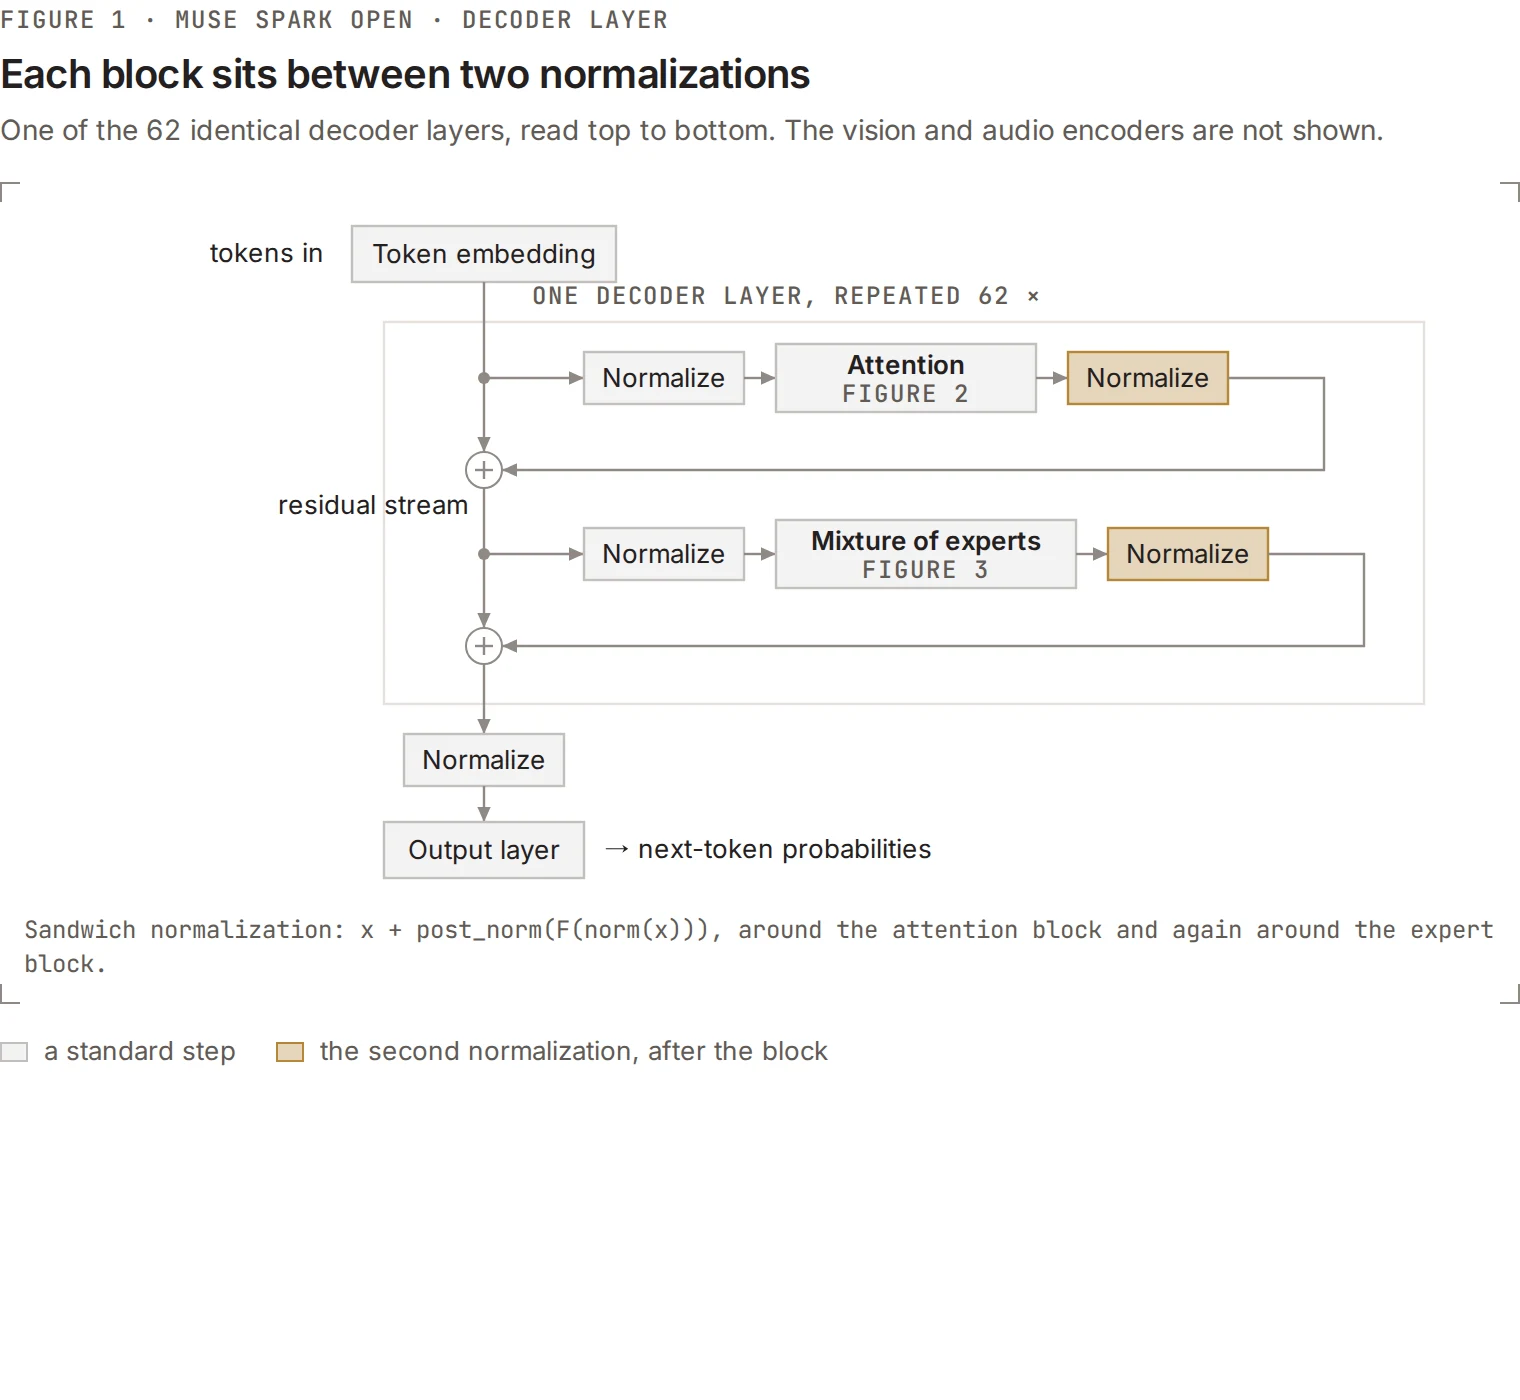
Muse Spark Open 是一个混合专家模型,总参数量为 816B,包括文本解码器,外加一个 2B 视觉编码器和一个小型音频编码器。解码器有 62 层,每一层都是混合专家层。各权重分布如下:
| 部分 | 大小 |
|---|---|
| 每层 256 个专家 | 799 B |
| 注意力 | 13.5 B |
| MoE 潜在投影 | 4.2 B |
| 嵌入层和输出层 | 3.3 B |
| 视觉塔(独立) | 1.9 B |
该模型架构与 Muse Glimmer 类似。对于尚未使用过 Muse Glimmer 的人来说,此模型架构中有几处值得仔细研究。
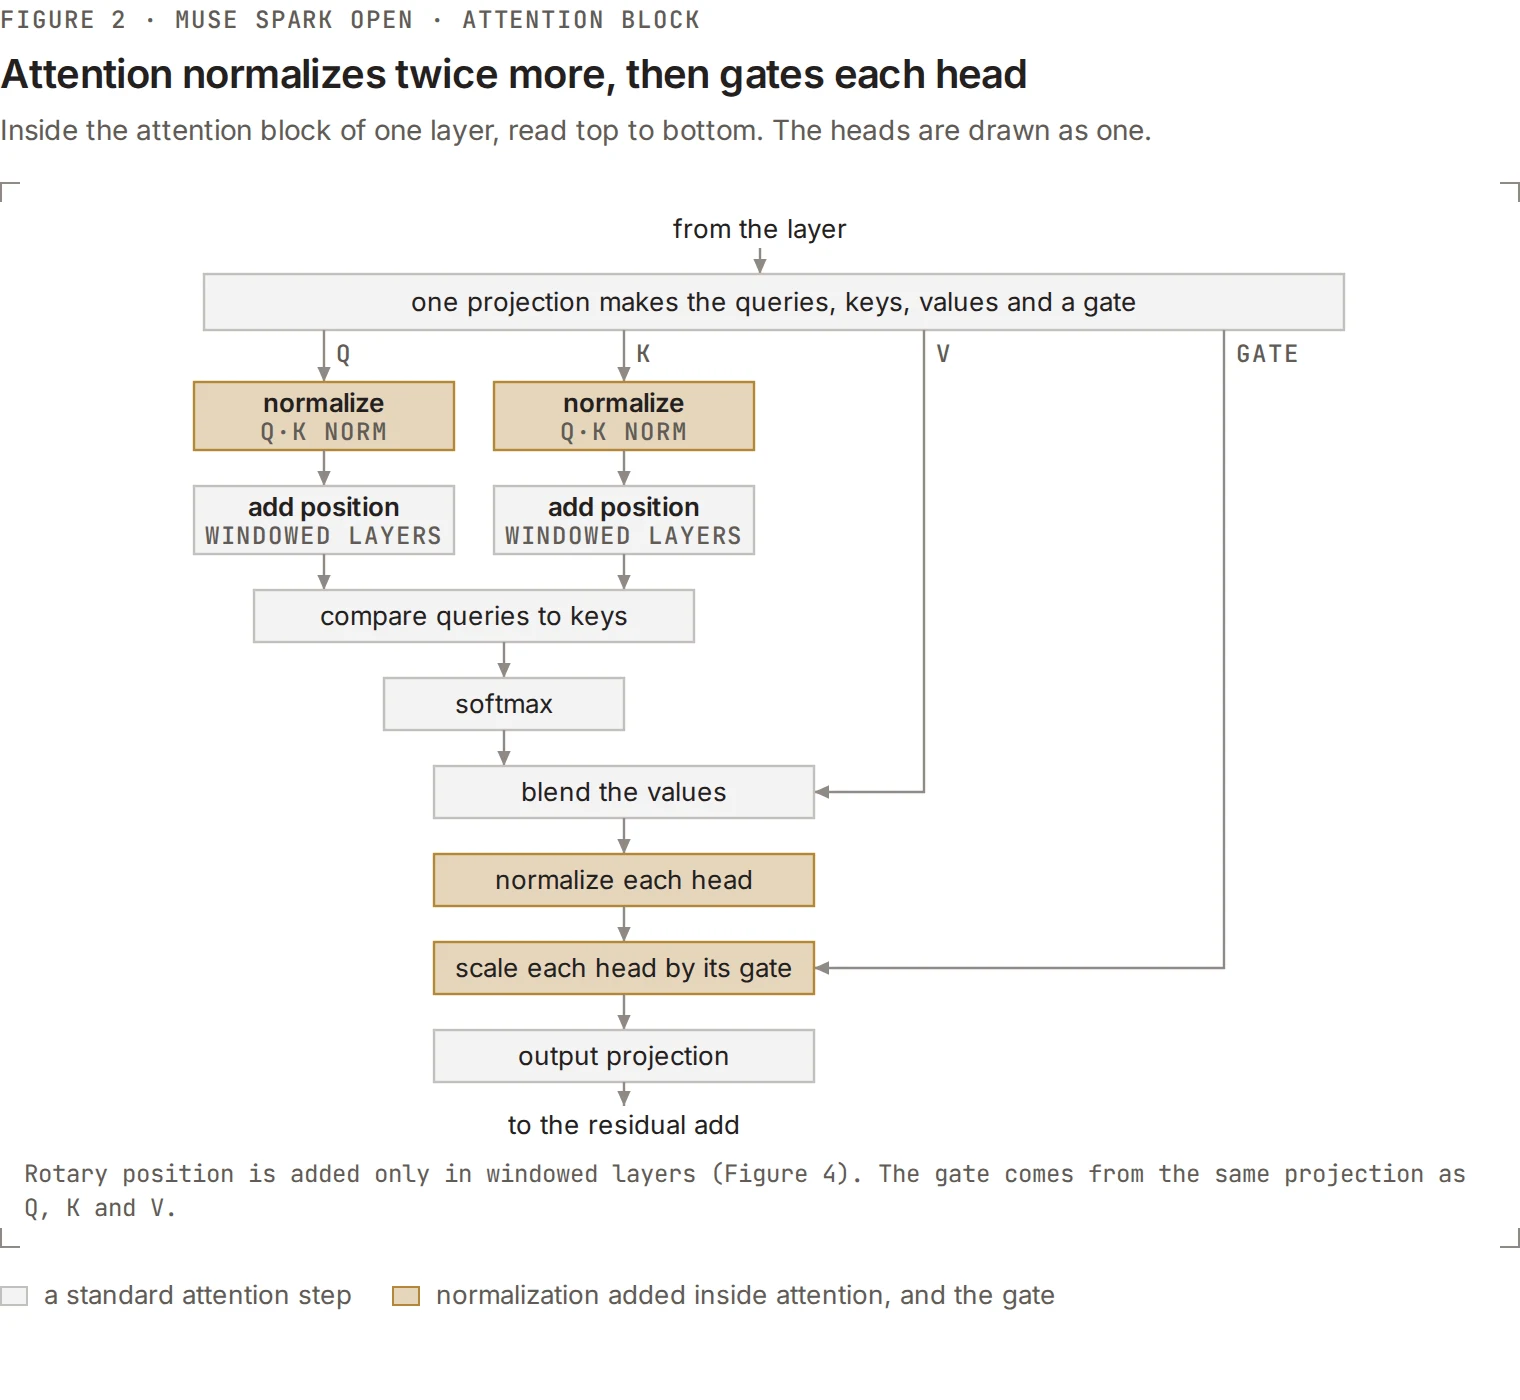
三明治归一化。 大多数解码器在每个块之前放置一个归一化层,得到 x + F(norm(x))。Muse Spark Open 与 Muse Glimmer 类似,在前后各放置一个,就像三明治的两片面包夹着块,得到 x + post_norm(F(norm(x)))
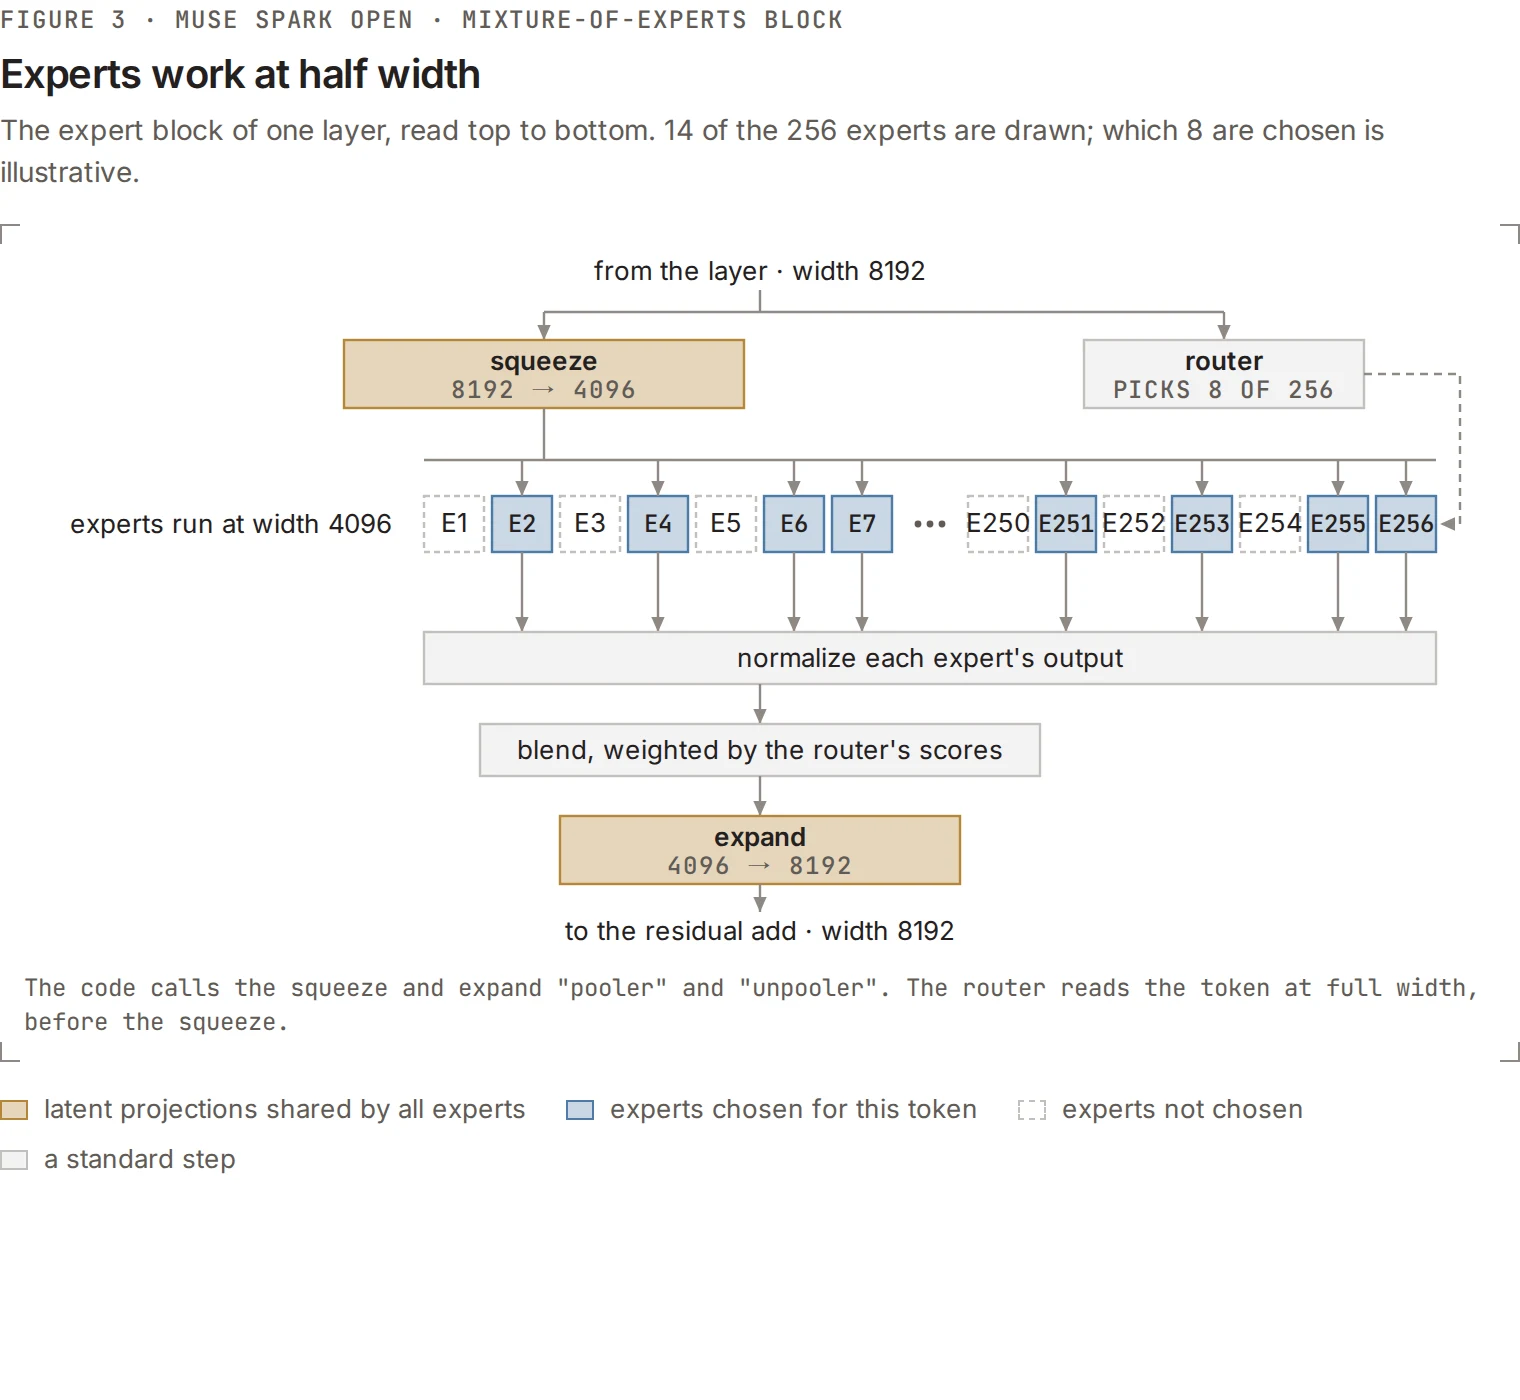
潜在 MoE。每个混合专家(MoE)层都带有两个额外的矩阵,由该层的全部 256 个专家共享。代码将它们称为 pooler 和 unpooler,尽管两者都不是通常意义上的池化,而是两个学习到的投影,用于压缩和扩展维度。pooler 是一个 8192 × 4096 的矩阵,在每个 token 进入专家之前将其宽度减半;而 unpooler 在之后恢复完整宽度。因此专家完全在 4096 而非 8192 的维度上工作,这实际上将两个专家投影层所需的参数数量减半了。
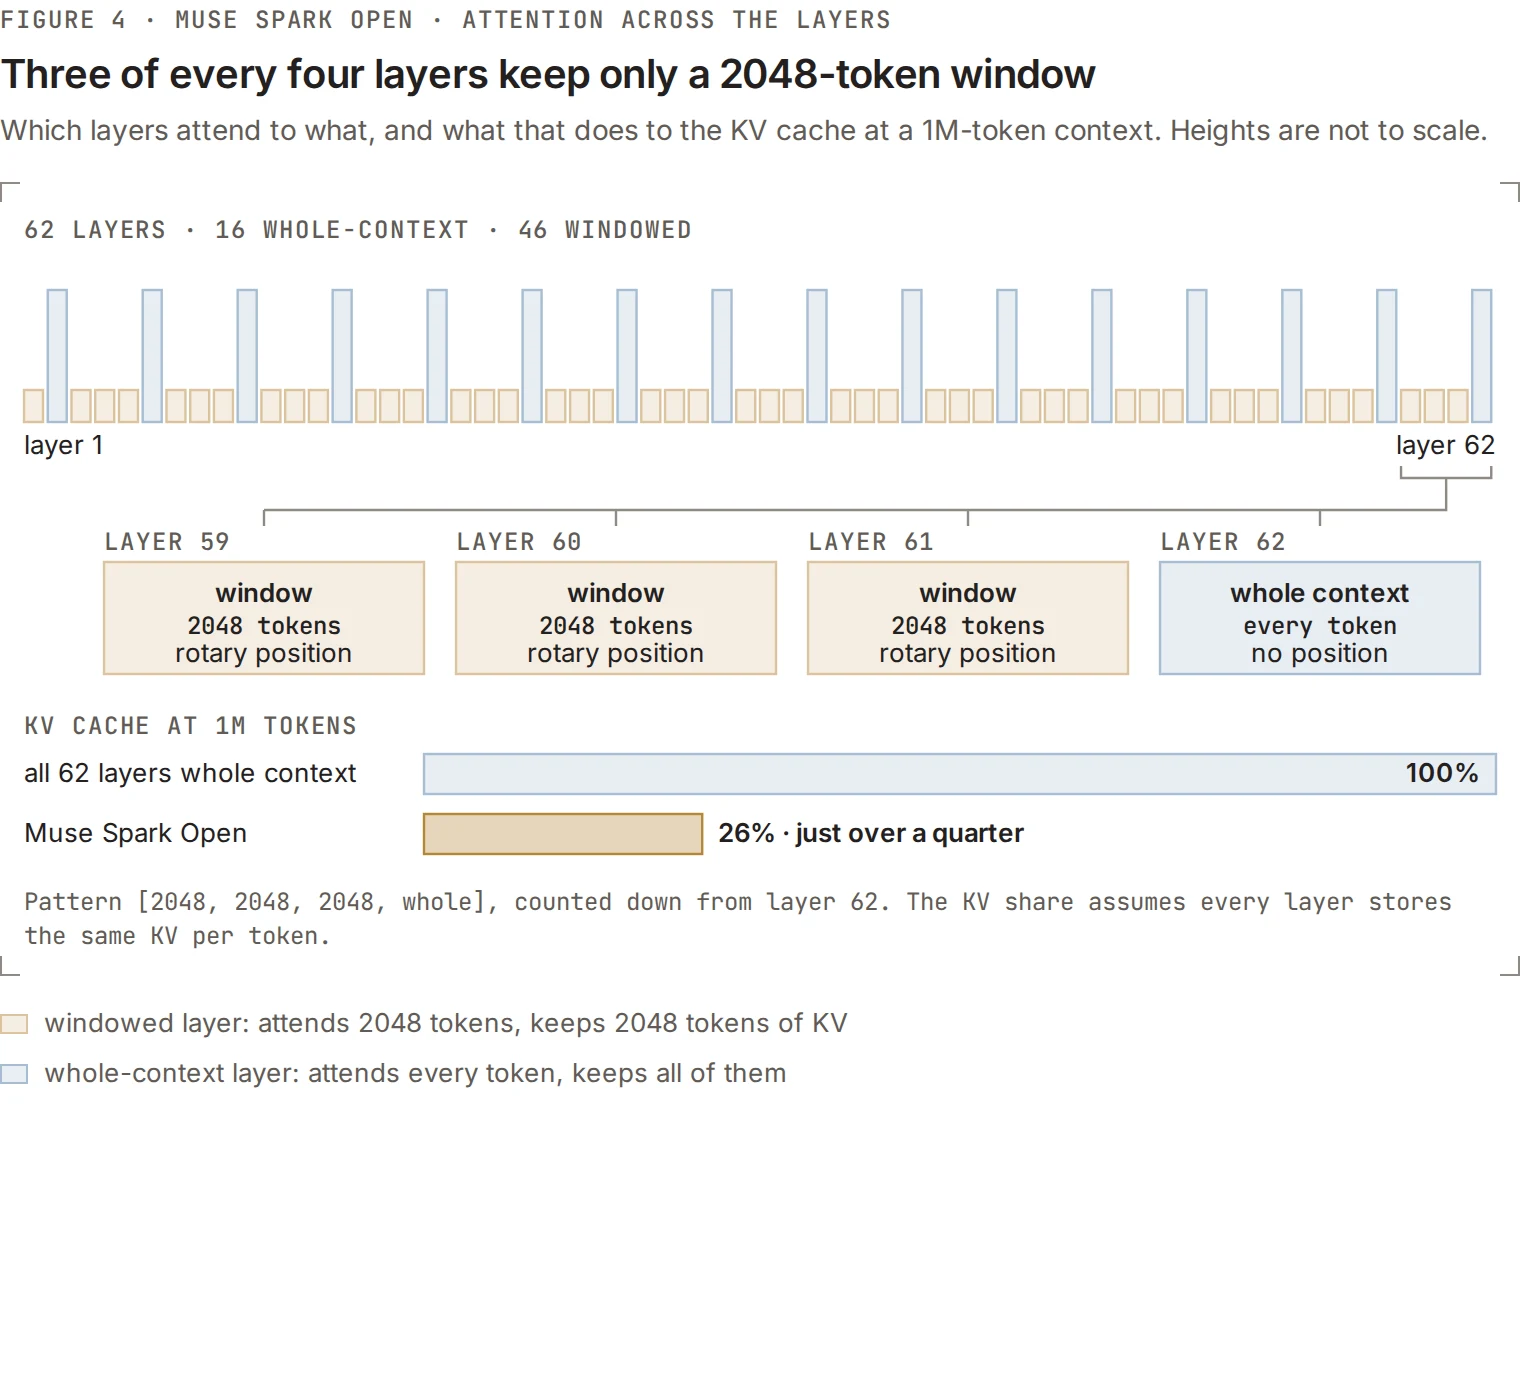
混合注意力。 层在完整注意力与滑动窗口注意力(SWA)之间以 4 为周期交替,其中三层关注 2048-token 的窗口,第四层则关注整个上下文。该周期以堆栈末端为锚点,因此最后一层始终是完整注意力层。在 62 层中,这给出了 46 个窄层和 16 个宽层,窄层仅保留最近的 KV。在 1M token 时,这将缓存降到全部使用完整注意力所需大小的约 ¼。这正是使 1M 上下文长度变得经济可行的原因。
视觉编码器。 Muse Spark Open 使用与 Muse Glimmer 相同的 Perception Encoder,这是一个 2B 参数的塔,以图像的原生分辨率读取图像,而不是将其调整为正方形。视频通过同一编码器处理:帧在加载时作为一系列采样的视频帧被采样,时间戳在提示词中被 token 化。
音频编码器。 音频以 24 kHz 的原始波形读取,每 1920 个采样(即 80ms)经过一系列变换成为一个 token。整个音频编码器仅有 118M 参数。请注意,视频的音轨不会被处理。要为模型同时提供片段的图像和声音,请在同一请求中将视频和提取的音频作为两个单独的内容部分发送。
DSpark
为了加速 Muse Spark Open 在 vLLM 上的推理,我们使用 DSpark 训练了一个推测器(speculator),这是一种投机解码算法,使用块扩散在单次传递中提出最多七个草稿 token。基于置信度的调度有助于即使在较大批量下也能保持显著的加速,而投机解码在传统上在此类场景下收益递减,如下方结果所示。
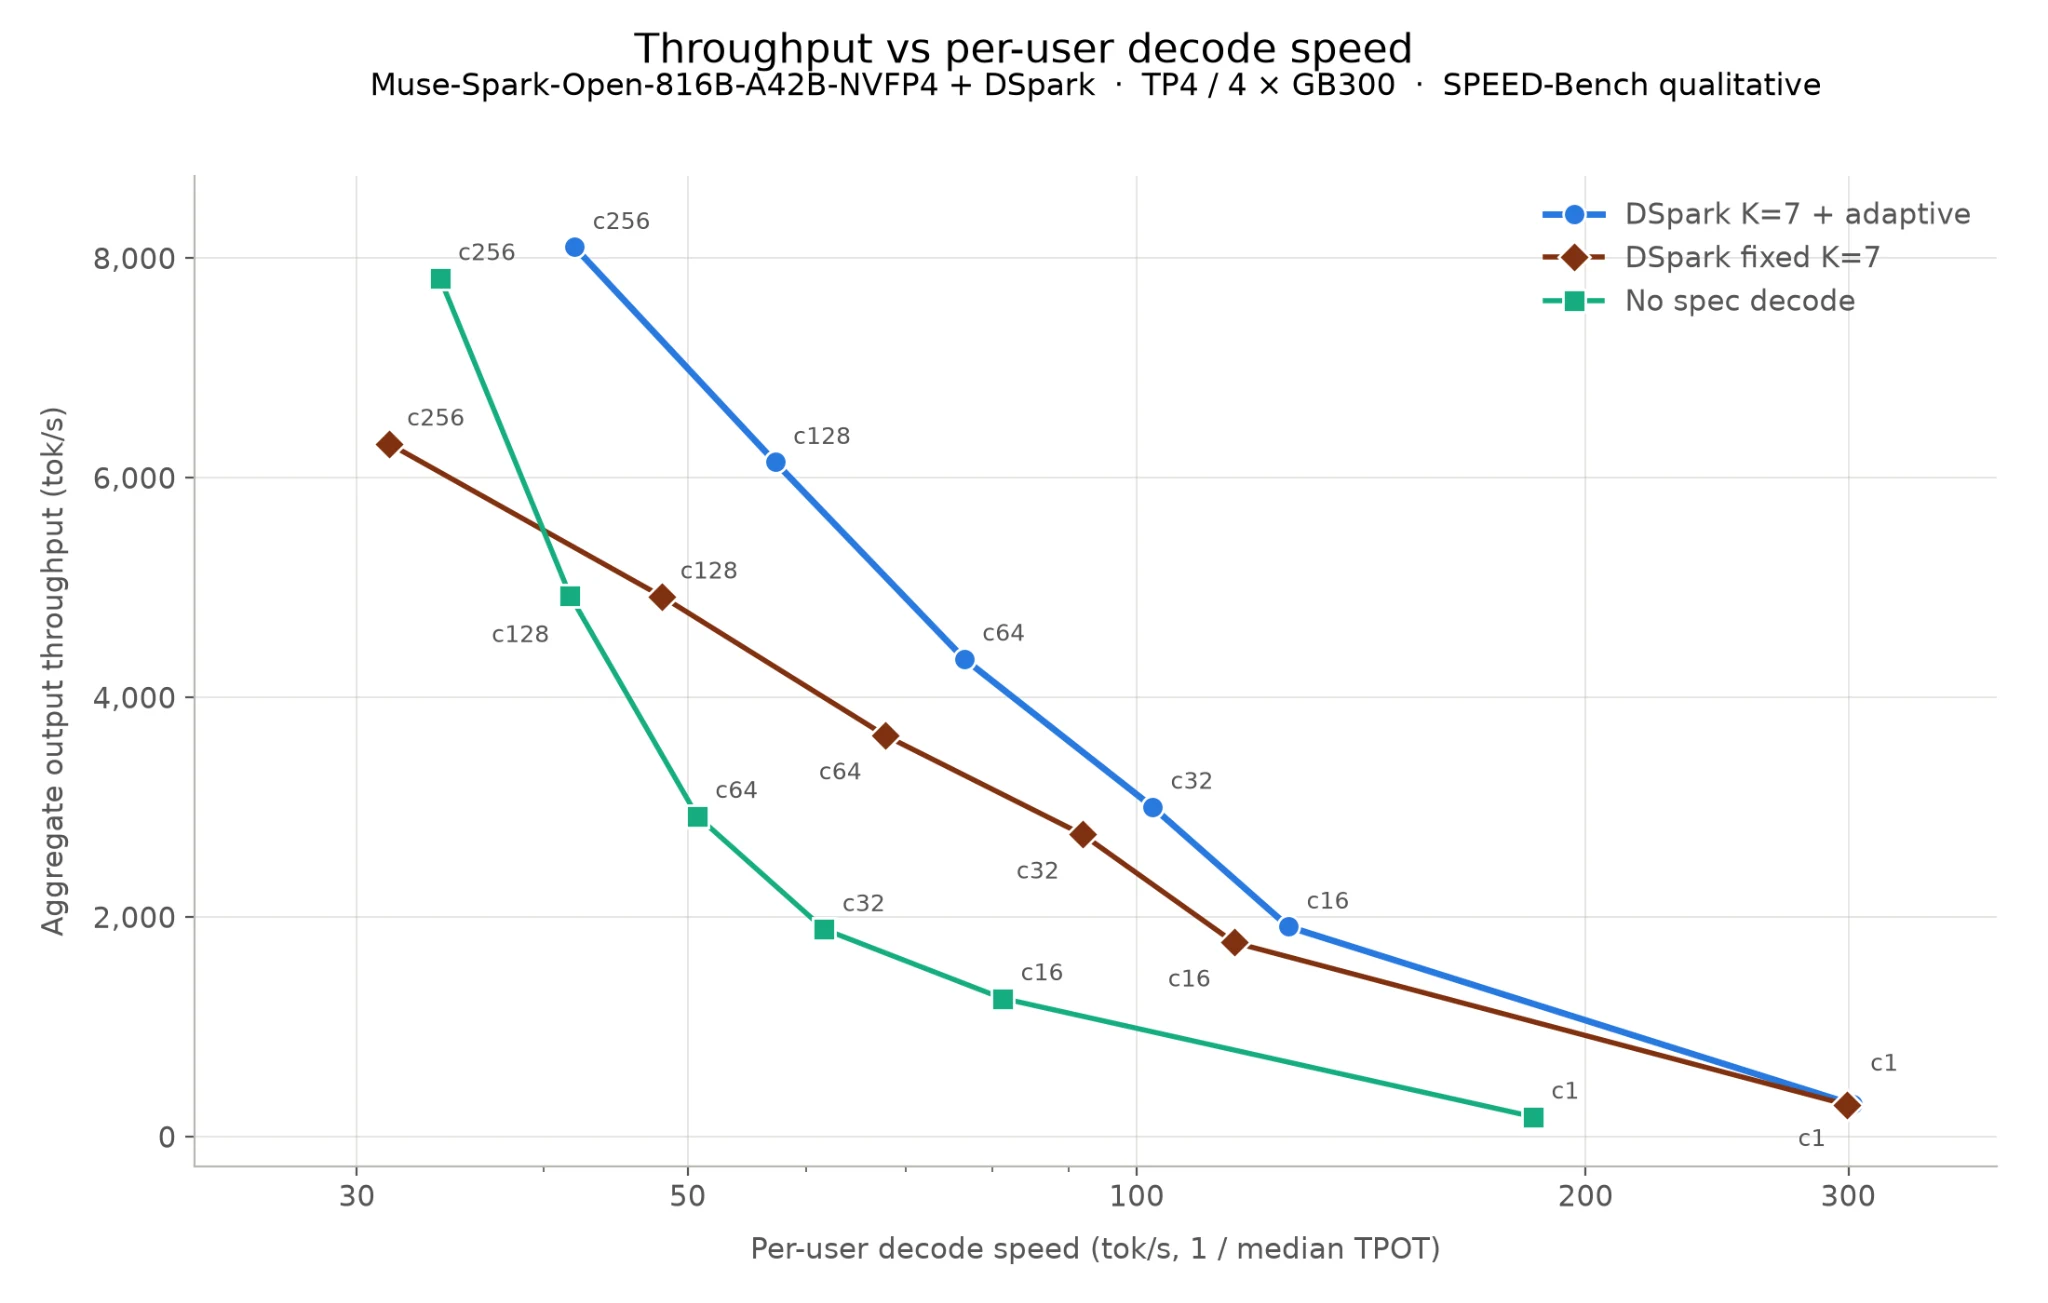
我们的推测器还使用 Muse Spark Open 的滑动窗口注意力来保持草稿生成的轻量,即使面对 1M-token 的上下文也是如此。这些选择共同使其非常适合涵盖广泛批量大小和上下文长度的生产工作负载。
要启用它,请在服务器启动时添加以下内容:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
Nvidia 团队通过融合归一化、门控和残差内核;融合的 MoE 收尾与张量并行通信及 RMSNorm;新的低延迟 BF16 GEMM 实现并降低编译开销;带融合 MNNVL 集合通信的 TEP pooler/unpooler 分片;由归一化的 FP32 输出馈送的 TF32 路由 GEMM;以及对数据传输、硬件支持和运行时可靠性的改进,全面提升了 Muse Spark Open 在 FlashInfer 和 vLLM 上的推理性能。
AMD
感谢 AMD 团队,我们还在 AMD Instinct™ MI355X GPU 上以 FP8 和 MXFP4 量化格式支持了该模型,提供了改进的推理性能和部署效率。请注意,ROCm 目前同时支持张量并行和流水线并行。
TPU
我们已在 TorchTPU 之上添加了对 Muse Spark Open 在 TPU 上的支持。请联系我们或 Google 获取代码访问权限。我们还为 Muse Spark Open 构建了 megakernels 。借助 DSpark 投机解码(接受长度 = 6),它们在 4 TPU v7 芯片上达到超过 650 tokens/sec,在 8 个芯片上超过 960 tokens/sec。在没有投机解码的情况下,它们仍分别提供超过 270 和 350 tokens/sec。
vLLM 中的强化学习
vLLM 从第 0 天起就支持 Muse Spark Open 上的 LoRA RL,作为 rollout 引擎与 Verl FSDP2 作为训练器配合使用。vLLM 提供应用了 LoRA 适配器的原始 NVFP4 检查点服务。训练器在相同权重的 BF16 反量化版本上运行,仅更新适配器(rank 32,alpha 64),该适配器覆盖注意力、MoE 潜在投影以及所有路由专家。它还重放 rollout 的 MoE 路由(R3),并且在每一步之后仅将适配器同步回 vLLM。
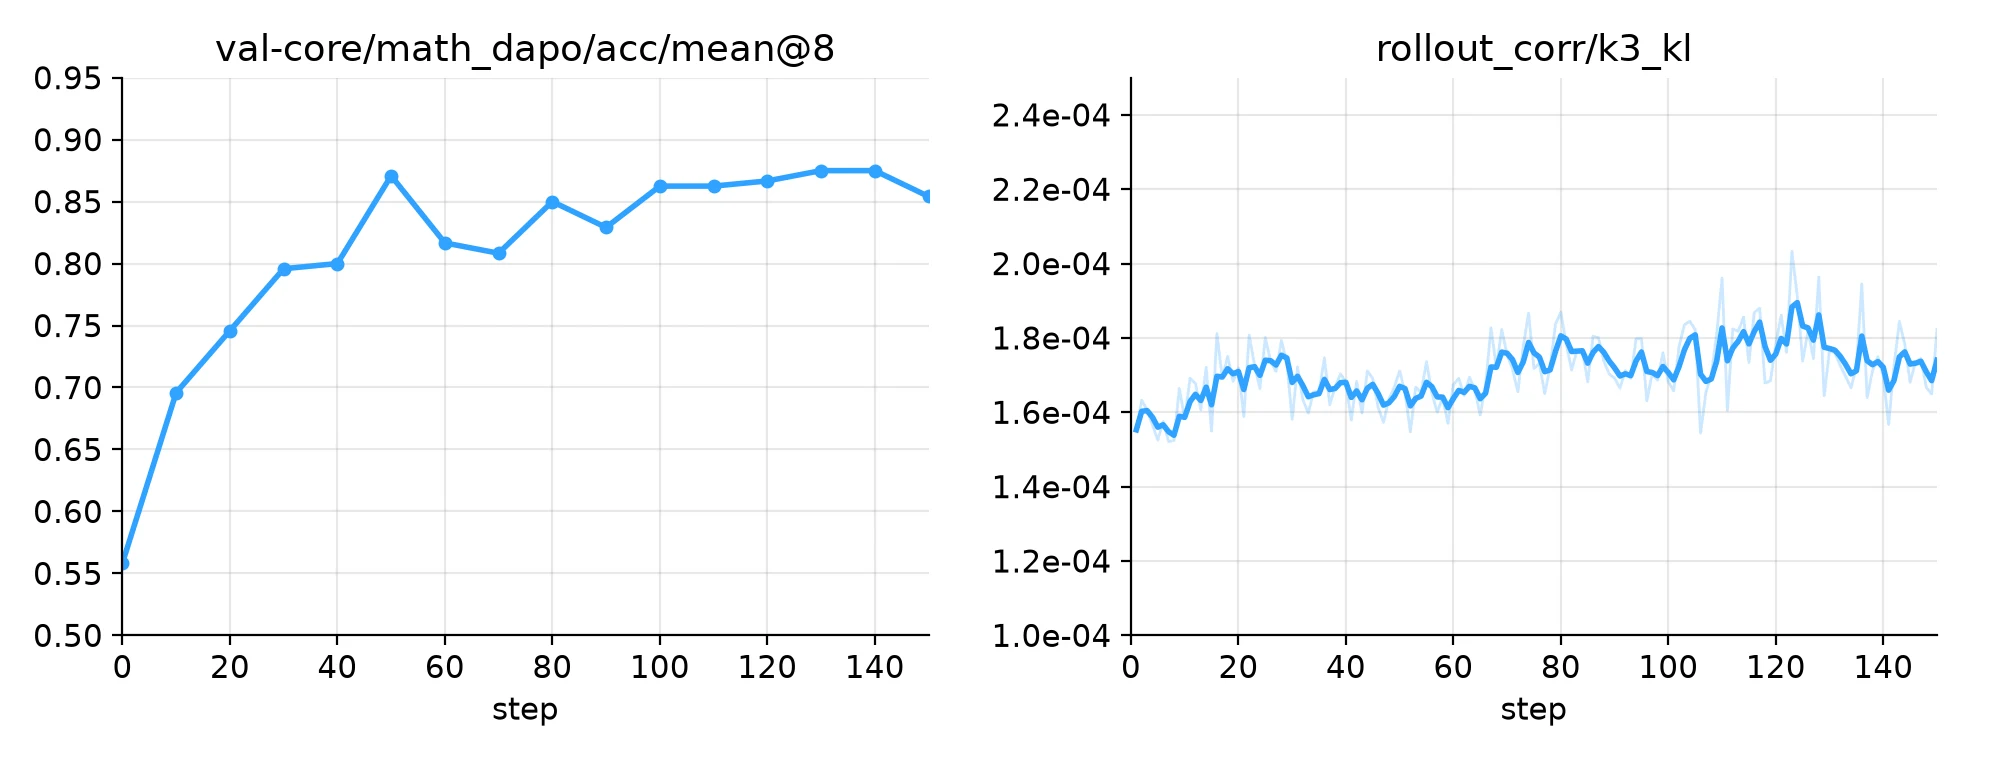
我们使用 GRPO 在 DAPO-Math-17K 上训练了 150 步,使用 16 GB300 GPU,每步对 32 个提示各采样 8 个响应,每个响应最多 4K token。AIME-2024 上的准确率(mean@8)从训练前的 0.56 提升到训练结束时的 0.85。在整个训练过程中,训练器与 vLLM 的对数概率之间的 k3 KL 保持在 2×10⁻⁴ 附近。更多详情请见 https://github.com/verl-project/verl/pull/8257。在 vLLM 生态系统中,Titan RL 也使用 vLLM 作为其 rollout 引擎,以提供 day-0 RL 支持。
致谢
我们向 Meta Superintelligence Labs 团队和 vLLM 社区致以诚挚感谢,感谢他们紧密合作,为 vLLM 上的 Muse Spark Open 提供 Day 0 支持。我们还要感谢 Inferact 训练 DSpark speculator 并完成 TPU 集成,同时感谢 NVIDIA 和 AMD 提供的关键硬件优化。
贡献者:
- Inferact:Jie Li、Zifeng Mo、Zixi Qi、Jeff Ma、Ziqi Zhao、Dakai An、Ao Shen
- Meta:Beto de Paola、Sidhartha Reddy Potu
- Nvidia:Cyrus Chang、Duncan Moss、Marek Pikulski、Seong Hee Lee
- AMD:Andy Luo、Hongxia Yang、Haichen Zhang