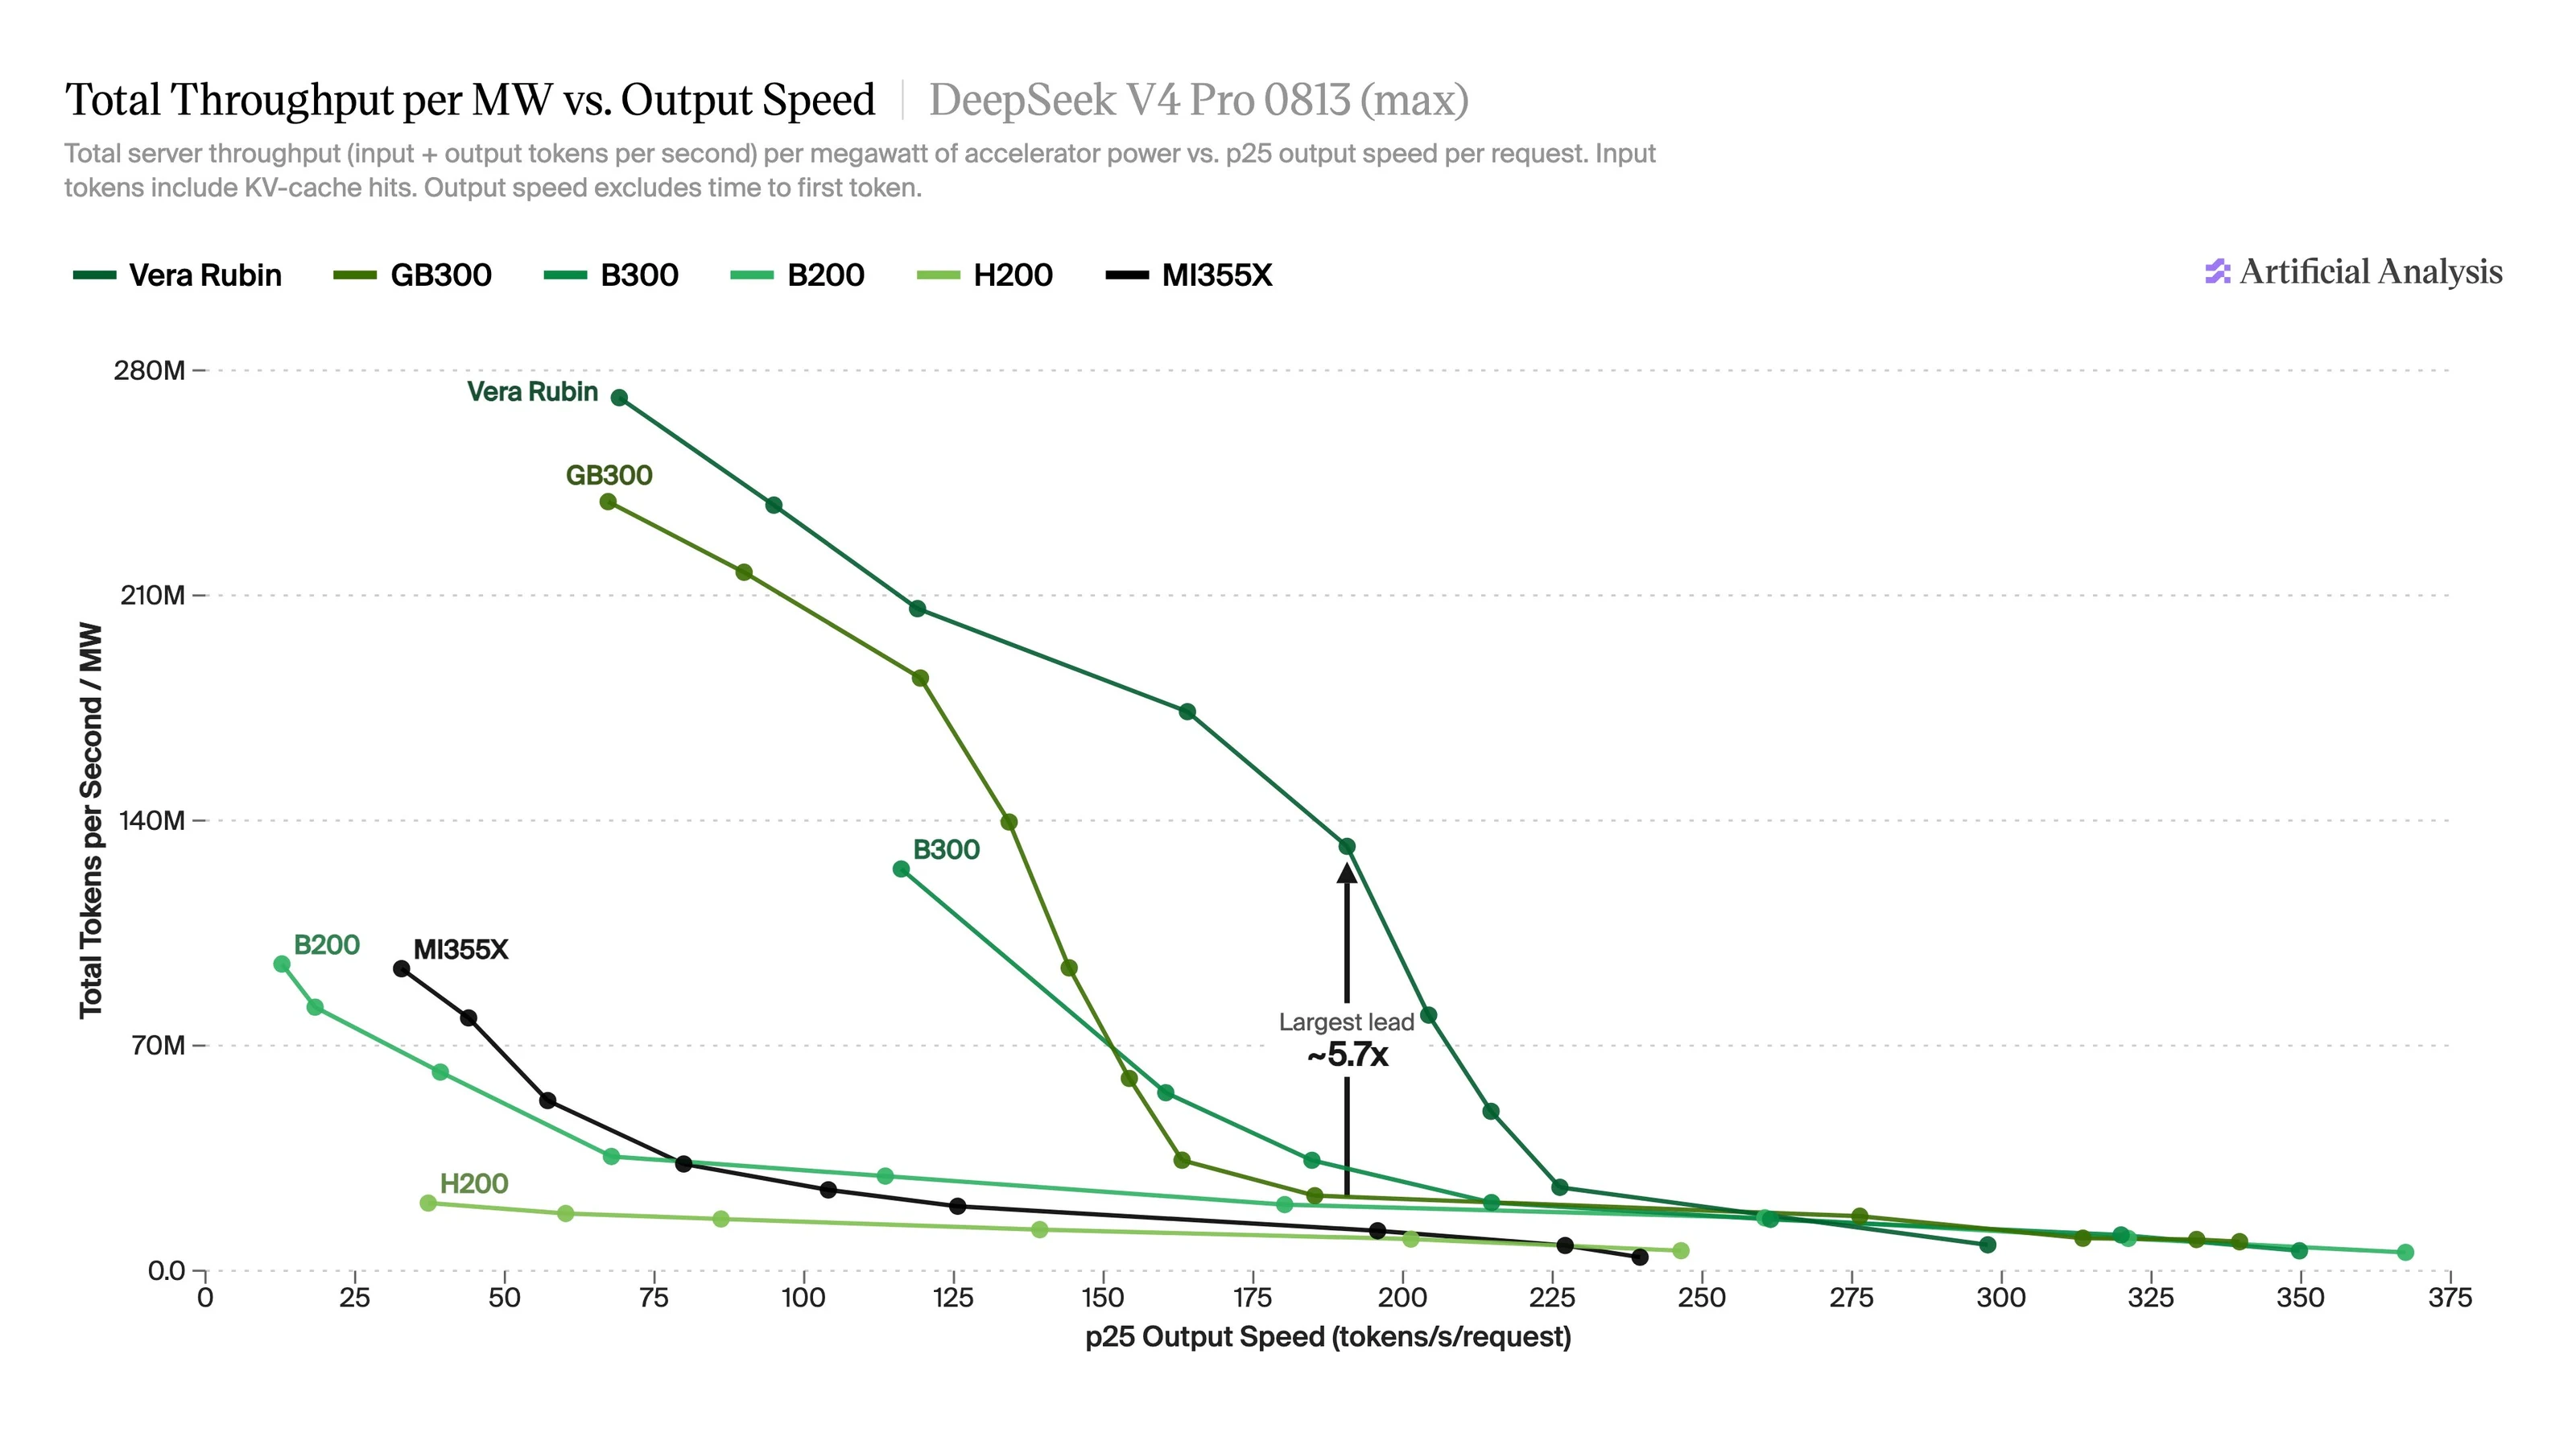
NVIDIA 的 Vera Rubin NVL72 的初步结果现已在 AA-AgentPerf 上线,在 DeepSeek V4 Pro 上每兆瓦总吞吐量最高可达其前代 GB300 NVL72 的约 5.7 倍,在 DeepSeek V4.1 Flash 上约为 5.4 倍,在 GLM-5.2 上约为 3.0 倍,在 Kimi K3 上约为 2.8 倍
Vera Rubin 是 NVIDIA 对 Blackwell 的继任产品,Vera Rubin NVL72 是其机架级系统,包含 72 个 Rubin GPU 和 36 个 Vera CPU。每个 Rubin GPU 拥有与 Blackwell Ultra 相同的 288 GB 内存,但内存带宽为 2.4 倍,NVLink 带宽为 1.7 倍,密集 NVFP4 算力为 2.3 倍。所有 Vera Rubin 结果均由 NVIDIA 提交,使用 TensorRT-LLM 和 vLLM 并配合 NVIDIA Dynamo 运行
AA-AgentPerf 是我们的智能体推理性能基准测试。它回放真实的智能体编码会话,包括长缓存上下文和工具调用延迟,以对日常智能体工作负载中的推理性能进行现实的衡量。我们测量每兆瓦实测 GPU 功耗的总系统吞吐量,以及在不同并发水平下每个智能体的输出速度(跨请求的 p25),以展示系统利用率与单个用户体验之间的权衡
初步结果:
➤ Vera Rubin 的领先优势在更快的每用户速度下最大,而 GB300 的吞吐量则大幅下降。在 DeepSeek V4 Pro 上,每用户从约 120 提升到约 165 tok/s 会使 GB300 损失其每兆瓦吞吐量的 81%,而 Vera Rubin 仅损失 16%
➤ 在峰值吞吐量下两者更为接近,在 DeepSeek V4 Pro 上 Vera Rubin 为每兆瓦 272M tokens/s,GB300 为 239M(1.14 倍);在 DeepSeek V4.1 Flash 上为 571M 对 395M(1.45 倍);在 GLM-5.2 上为 272M 对 201M(1.35 倍);在 Kimi K3 上为 70M 对 56M(1.26 倍)。我们预计随着 Vera Rubin 内核和其他服务软件的优化,两个系统之间的差距会进一步扩大
➤ Vera Rubin 在我们的排行榜上创下了 DeepSeek V4.1 Flash(906 tok/s,所有模型中的最快结果)、GLM-5.2(408 tok/s)和 Kimi K3(255 tok/s)的最快每用户速度
祝贺 @nvidia 取得如此强劲的结果!
阅读完整分析:https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf