
Kimi K3 优化工作内幕:理解瓶颈以及让推理更快的关键决策
本文内容- AgentX:工作负载与结果
- Kimi K3 内幕:专家、注意力与循环状态
- 1. 缓存:保持会话状态可供复用
- 2. MoE:消除 GPU 之间的重复工作
- 3. 内存流量:融合操作并去除不必要的拷贝
- 4. MLA:借助 AMD AITER 汇编实现更快的长上下文解码
- 5. KDA:并行化 prefill 与投机验证
- 6. 投机解码:选择起草多少个 token
- 接下来该优化什么
- 贡献与致谢
在 AgentX 上,一套配备八块 GPU 的 AMD Instinct MI355X 系统使用 vLLM 服务 Kimi K3,可提供 高出 24.4% 的每秒每 GPU 总 token 数 (相对于在 50 tokens/s/user P90 交互性下的 NVIDIA HGX B300)。按照基准测试的拥有成本模型,它可提供 高出 87.4% 的每美元 token 数.
在这篇文章中,我们将剖析 AMD Instinct MI355X 上 Kimi K3 背后的工程实践,把 vLLM 的服务决策与 GPU kernel 及底层硬件联系起来。我们将解释这些优化为何奏效,并帮助读者建立直觉,以便发现浪费的工作、识别瓶颈,并找到自己推理栈中的下一个优化点。
交互性是 P90 响应 token 间延迟的倒数,不包括首 token 时间。总 token 数包括复用的输入和生成的输出。
来源: SemiAnalysis InferenceX,2026 年 10 月 9 日快照。 对比配置.
公布的稠密矩阵峰值性能为:AMD Instinct MI355X 为 10.1 PFLOP/s MXFP4,NVIDIA B300 为 13.5 PFLOP/s FP4。两者均拥有 288 GB HBM3E 和 8 TB/s 峰值内存带宽。达到这一服务性能反映了 AMD 及 vLLM 社区合作者持续的软件工程努力。
AgentX:工作负载与结果
公开的 AgentX 基准测试使用合成 token 重放真实的编码智能体会话轨迹,保留请求长度、时序和前缀共享模式。该工作负载在缓存无限的情况下提供超过 96% 的理论前缀复用率。投机运行使用固定的合成接受率参考。
在 50 tokens/s/user P90 交互性下,AMD Instinct MI355X 可提供约 7,567 总 tokens/s/GPU,相比之下 6,083 为 NVIDIA HGX B300,即 24.4% 的吞吐量优势。采用 SemiAnalysis 建模的 TCO(分别为 每 GPU 小时 1.50美元对2.26美元),这意味着 每美元 TCO 的总 tokens 为 18.16 百万对 9.69 百万:每美元多出 87.4% 的 tokens.
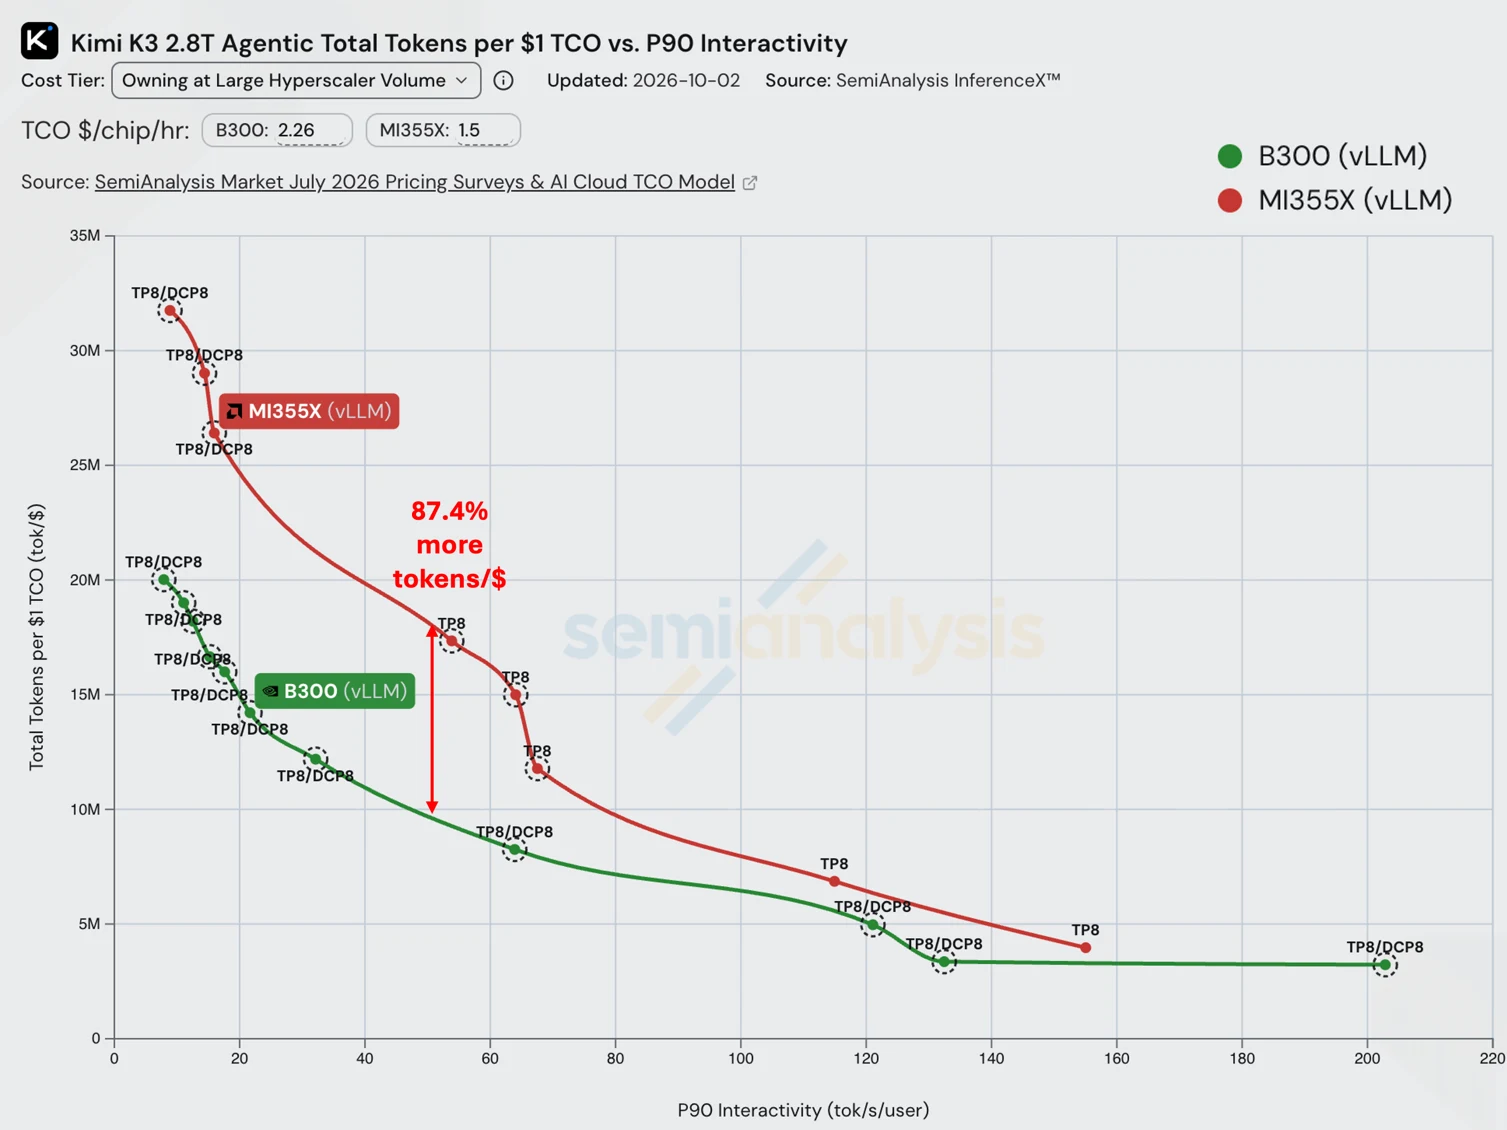
SemiAnalysis InferenceX 公开曲线,并标注了每用户每秒 50 tokens 的目标。 基准测试说明.
公开曲线比较的是完整的推理服务技术栈。每项优化旁边的测量数据来自独立测试,用于解释在所述配置下的单个机制。
深入 Kimi K3:专家、注意力与循环状态
代理的一轮后续对话可以复用大部分前缀,但处理较短的续写内容仍会触及三类数据。
Kimi K3 使用两种注意力机制。它的 24 个 MLA 层 保留一份随对话增长而扩展的压缩 KV 历史。新的查询仍会查阅该历史。它的 69 个 KDA 层 则改为携带固定维度的状态矩阵,并随着新 token 到达而更新它们。 模型配置.
在 MoE 层中,路由器选择专家网络来变换每个 token。它们的权重在各请求之间共享。
MLA 随对话增长保留更多历史。KDA 更新固定维度的状态;保留较早的检查点意味着要保存该状态的额外副本。
跨轮次: 缓存复用与卸载(第 1 节)。
模型单步内: 专家投影、内核交接以及 MLA/KDA 调度(第 2–5 节)。
选择草稿深度: 已提交输出与完整周期成本之比(第 6 节)。
1. 缓存:保持会话状态可供复用
DCP 减少 GPU 显存中的重复历史;CPU 卸载将可复用状态保存在其外部。
DCP:在 GPU 之间共享历史
在 TP8 下,每个 GPU 处理 Kimi K3 的 96 个 MLA 查询头中的 12 个,但存储完整的压缩 KV 历史。张量并行划分头而不划分缓存。
采用 八路解码上下文并行(DCP8)时,每个 GPU 存储八分之一的缓存位置。在解码期间,各 GPU 交换查询,针对各自的本地历史进行计算,并合并各自的部分答案。
两个 GPU 展示了 TP8/DCP8 所使用的同一划分方式。这一额外的划分适用于 MLA 历史;KDA 状态在各头之间保持其现有划分。
每个部分答案都携带归一化信息,以便合并时能正确加权各分片。 #51705 将 ROCm AITER DCP 路径扩展到多 token 验证。
对于一个 142,000 token 的对话,估计的 MLA 负载为 24 层 × 142,000 位置 × 576 FP8 字节 ≈ 每个 GPU 1.96 GB。DCP8 将其降至约 245 MB(分配开销之前)。每个 GPU 针对 八分之一 的历史处理八倍数量的头,因此主要的注意力计算量大致不变。
CPU 卸载:保存不再适合放入 HBM 的状态
当状态不再适合放入 GPU 显存时, AMD 方案的原生 vLLM CPU 卸载会将 MLA 历史和 KDA 检查点保存在主机 DRAM 中。
缓存命中需要匹配的恢复点。如果 MLA 历史已到达 token 3,072,但最新的兼容 KDA 检查点在 2,048,请求必须从 2,048 恢复并重新计算剩余前缀。
一个可用的恢复点需要在所有必需的层级上具备兼容的状态。此处列出的位置仅为示例。
将注意力块尾部与 KDA 检查点一同保存,可以对齐它们的恢复位置(#54736)。恢复该状态是用传回 GPU 的开销来换取避免的前缀重算。一旦请求恢复,其新 token 仍可能让多个 GPU 重复相同的计算。
2. MoE:消除跨 GPU 的重复工作
在单个 GPU 上,路由专家输出投影会返回其使用者所期望的完整向量。在原始的 ROCm 路径中,先前的归约和归一化使所有八个 GPU 获得相同的潜在输入,并且每个 GPU 都持有完整的权重。 因此,同一个投影运行了八次。
输出坐标可以在 GPU 之间划分,但每个 rank 仍需要完整的结果。Kimi K3 已经为其共享专家的部分结果设置了 all-reduce。
每个 GPU 只将自己拥有的路由输出加到其共享专家部分结果上。现有的 all-reduce 即可组装出完整结果,无需新的集合通信(#51253)。该 ROCm 实现基于相应的 CUDA 策略。
两个 GPU 展示了输出坐标的归属。两种路径都使用一次现有的 all-reduce,并向每个 GPU 返回相同的完整结果。
每个输出坐标的路由贡献恰好被接收一次。完整的投影权重仍然保持复制。
在该 PR 于 8 块 AMD Instinct MI355X GPU、TP8 下的测试中,在并发 8–128、随机 8K 输入/1K 输出请求且禁用前缀缓存的条件下,输出吞吐量提升了 3.05–4.91%。
释放 GPU 内存以保留更多缓存状态
每个 rank 现在只计算其分配到的投影坐标,同时保留完整的权重。
只加载每个 rank 所使用的行可以节省约 每 GPU 3.85 GiB 在 TP8 下跨 92 个 MoE 层(#59591)。融合路径的计算保持不变;额外空间可容纳 MLA 历史记录和 KDA 检查点。
此更改是在用于头条公开结果的图像生成之后才落地的。其单独的 AgentX 实验发现 在并发 32 和 48 时吞吐量仅提高不到 1%,但在 70 时提高了 28.9%,其中报告的前缀缓存命中率从74.8%上升至80.1%。
单独的 #59591 测量: 八块 AMD Instinct MI355X GPU,TP8/DCP8,FP8 KV,30 分钟运行,无 CPU offload 或投机解码。各点显示报告的运行结果;未报告重复运行的不确定性。
高并发下更大的增益与缓存压力一致。在相同缓存容量下比较两种实现将有助于分离这一效应。
更多内容 专家路由和四位激活.
3. 内存流量:融合操作并移除不必要的拷贝
在每块 GPU 内部,下一个值得关注的点是内核之间传递的数据。
Kimi K3 的单 token KDA 路径运行了三个计算内核和两次输出拷贝。卷积在一个已经融合了 Q/K 归一化、衰减和 beta 门控以及循环更新的内核之前运行;输出归一化在其后运行。融合后的 HIP 路径在一次启动中执行这些操作,并直接写入目标缓冲区(#50654).
中间交接保留在片上。卷积历史和循环状态仍会写入 GPU 内存以供下一个 token 使用。
单 token、非投机的 KDA 解码于 #50654。之前使用融合的 Triton 归一化路径。计数依据源代码;投影不在视图内。保存状态的读取和写入仍然存在。
AttnRes 将较早层块的输出与运行中的残差混合。将该混合与 RMSNorm 相结合,使临时混合保留在寄存器中(#50593)。为后续层保存的运行残差保留其 BF16 舍入;混合在归一化过程中保持 FP32。测试要求持久的更新完全一致,并允许归一化输出存在数值容差。
采用 AttnRes 融合后,在八块 AMD Instinct MI355X GPU 上以 TP8、100K 输入/1K 输出请求且禁用前缀缓存的条件下,输出吞吐量提升了 14.2%。长 prefill 延迟基本不变。
仅为使用输入的内核拷贝输入
ROCm 矩阵乘法调度器在选择内核之前先对输入进行打包。当它选择回退路径时,该内核读取原始输入,拷贝便被闲置。将打包移入专门的分支中移除了这些拷贝(#58566).
性能剖析使浪费显而易见: 每个解码步骤 69 次不必要的拷贝,每个 KDA 层一次。每次仅移动 1,792 字节,但耗时约 4.8 微秒。更快地移动这些字节几乎无济于事;启动开销占主导。
在该 PR 的 TP8、并发为一、六草案、384K 上下文的性能剖析中,被移除的拷贝占每步 0.339 ms 的拷贝内核时间。
4. MLA:使用 AMD AITER 汇编实现更快的长上下文解码
Kimi K3 在 TP8 下每个 GPU 有十二个查询头。填充到十六个后,AMD AITER 的汇编解码路径变为可用。在所报告的长上下文测试中,每个输出 token 的耗时从 43.8 毫秒降至 23.6 毫秒。
该对比使用 TP8、无 DCP、并发数为 1。适配器在 #50578 中复制四个查询头,将它们打包进十六头布局并丢弃其输出。DCP8 则呈现不同的 96 头形状。
这保持了模型的运行方式,因为每个查询头独立地对缓存位置进行注意力计算。增加另一个头不会改变原始头的 softmax。在此解码路径中只有查询被填充;存储的压缩 KV 历史大小保持不变。
一段长对话给注意力机制带来了大量工作,但这些工作需要在 GPU 上分散进行。在我们检查的历史代码中,一个保守的 调度提示 将 Gluon 路径限制为 每个请求一个工作组。该工作组仍然处理整个对话。填充使 AMD AITER 的汇编路径变为可用,其采用 不同的策略 来将历史划分为并行片段并合并结果。
历史分区是分配给同一 GPU 内工作组的任务。图中为便于说明展示了四个分区;被检查的汇编策略选择了十六个。KV 存储保持不变。
| 输入 / 输出 token | 原始 Gluon 路径 | 填充后的汇编路径 |
|---|---|---|
| 1K / 1K | 22.9 毫秒/token | 22.8 毫秒/token |
| 32K / 1K | 43.8 毫秒/token | 23.6 毫秒/token |
PR 报告的每个输出 token 平均时间:八块 AMD Instinct MI355X GPU,TP8,并发为 1,MXFP4 模型权重,BF16 注意力以及普通的单 token 解码。
短输入情形几乎没有变化;长输入情形下每个输出 token 的时间几乎减半。这些服务测量包括查询准备和输出处理。
5. KDA:并行化 prefill 和推测性验证
MLA 可以将保留的历史拆分给多个工作组。KDA 带来了更难的调度问题:每个 token 依赖于前一个状态。 #54038 中的融合 prefill 在传入状态已知之前,先为每个 token 组准备组合变换。
例如,“将状态减半并加二”,然后“再减半并加一”,可合并为“取初始状态的四分之一并加二”。这条规则可以在初始状态到达之前计算。
KDA 通过矩阵变换实现这一点。对组摘要的有序扫描确定每组的初始状态;然后各组并行重放它们的 token。Token 顺序保持不变,但每组不再等待前一组的重放。
分组增加了一次额外遍历,并将融合 chunk 路径从两次启动扩展到四次。当序列或注意力头较少、并行工作量太少时它才有帮助;否则,额外的遍历成本可能超过其收益。
在每组内,循环遍历在 chunk 之间将状态保留在矩阵累加器寄存器中,避免了全局内存的写入和重新加载。 状态存储示意图。
在一项独立的三后端对比中,在 4K 和 16K 输入长度下,融合 KDA 比 Triton 多提供了 5.3–5.6% 的输入吞吐量:八块 AMD Instinct MI355X GPU,TP8,并发 32,禁用前缀缓存,单 token 输出。这测量的是完整后端。 基准测试结果.
为推测性验证使用更小的 tile
短的验证批次需要不同的切分方式。在 TP8 下,每块 GPU 有 12 个 KDA 头,每个头有 128 列值。将每个头拆分为四个 32 列 tile 只会在 256 个计算单元上启动 48 个工作组。 #58045 切换为四列 tile,将数量提高到 384。
每个 tile 拥有不同的值列,并按顺序遍历同一 token 序列。更窄的 tile 将独立工作组的数量从 48 增加到 384。
在一块 AMD Instinct MI355X GPU 上(TP8 维度、一个序列、四个验证位置)的独立 graph-replay 内核测试中,每层时间从 16.20 微秒降至 5.61 微秒(2.89×)。这包括更窄的 tile、单波工作组、等长特化以及被提升的与 token 无关的工作。参差不齐的批次保留动态路径;测试会对输出和循环状态进行比较。
6. 推测性解码:选择起草多少个 token
更快的验证可以改变值得检查的草稿token数量。有用的速率是已提交输出除以完整的草稿–验证–提交流程周期时间。
例如,AgentX的固定接受参考在三个草稿下每个周期预期提交3.00个token,四个草稿下为3.36个,包括恢复或奖励token。这相当于每个周期的提交输出多出12%。 只有当完整周期比三个草稿用时增加不到12%时,四个草稿才能提升吞吐量。
这是在受控接受参考下的示例性比较。12%的阈值是一个成本预算;此处并未测量完整周期的增长。
The 公开的 AMD 配方 在使用 DCP1 时采用三到七个 draft,并在更大的 DCP8 并发设置下禁用投机执行。
接下来要优化什么
正在进行的 prefill/decode 分离工作提供了另一个观察点:worker 之间的负载均衡,以及传输是否能在其数据被需要之前完成。
对于其他模型或工作负载,请从已部署的请求形状出发,做三项检查:
比较各个 rank。 是否有多块 GPU 在集合通信之前计算了相同的结果,而集合通信本可以组装出该结果?
跟踪缓冲区。 每个临时张量在选定路径上是否都有消费者?数据能否留在片上?
统计独立工作量。 实际的 head、token 和 tile 是否能产生足够多的 workgroup 来分散负载?
以你所需的响应速度测量完整请求,并检查输出和保存的状态。只有当更快的 kernel 能缩短阻塞下一个 token 的工作时,它才有意义。
贡献与致谢
Kimi K3 的工作涵盖 超过 50 个已合并的 AMD/ROCm 相关 vLLM PR ,来自 AMD、Embedded LLM 及更广泛的社区,同时还包括 AITER 的开发、集成、评审和基准测试。贡献覆盖注意力机制、循环结构、MoE、量化、图执行、缓存支持以及平台集成。
特别感谢:Pin Siang Tan、Jun Kang Chow、Ye Hur Cheong、Hongxia Yang、Seungrok Jung、Bill He、Yichao Zhu、Hyukjoon Lee、Andy Luo、Mrinal Karvir、Richard Li、Sun Peng
Andy Friedrich, Ethan Yang, Tang Rui, Andreas Karatzas, Ankur Singh, Yihua Cheng, Badr Ba Sowid, Benjamin Chislett, Taoyu Zhu, Bill He, Bin Ding, Bowen Bao, Brandon Zhang, Chaemin Lim, Charles Wu, Chuan (Richard) Li, Felix Li, Cameron Quilici, Weishu Deng, Dewei Wang, Divakar Verma, Douglas Lehr, Edwin Lim, Yudong Pan, Elvir Crnčević, Fang Che, Fangzhou Ai, Xingran Fan, Fulu Li, Felix Marty, Canlin Guo, Summer Yang, Haichen Zhang, Yufeng He, He Liu, Hongxia Yang, Hyukjoon Lee, Yifan Qiao, James E T Smith, Jiahui Cao, Yanyuan Qin, Jonathan Chen, Juntian Liu, Shao-Chun Lee, Kedar Potdar, Kevin H. Luu, Kuan-Fu Liu, Kuntai Du, Kyle Sayers, @lalala-sh, @linnea-lin-00638949, Yinfeng Liu, Lucas Wilkinson, Gabriel Wu, Markus Hartikainen, Maithili Joshi, Jeff (Junze) Ma, Matthew Wong, Misha Goin, Micah Williamson, @minmengdie, Matvei Pashkovskii, Mathews Neha, Nicolò Lucchesi, Nick Hill, Nicholas Susanto, Oxana Korzh, Pei Zhang, @ppalanga, Peiran Qin, Qiuyang Yue, Rita Brugarolas, Rebecca Lee, Ryan Rock, Rohan Potdar, @Saddss, Samuel Shen, Sean Filimon, Seungrok Jung, Shantipriya Parida, Shanshan Shen, Shengnan Xu, Simon Danielsson, Siraj Shaikh, Stacy Roberts, Stefan Koncarevic, Asan Stefanski, Minghui Jiang, Tarık Saraç, Tun Jian Tan, Lingpeng Jin, Vansh Bhatia, Maksim Vedenev, Ye Hur Cheong, @wenwzhan, Wei Zhao, Xavier Aguilar, 张笑冰, 郭晓虎, 李欣, 吕旭东, 任雁雪, 叶文涛, 王永勤, Riggins Chen, 洪超, 沈宇辰, Matt Qin, 朱轶超, Roger Wang, 龚正, 朱江云, Zvi Grinberg, 朱永烨.
基准测试说明
比较目标下的服务配置
| P90 交互性(tokens/s/user) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 和 50 | SimpleCPU offload;DCP8 / 无草稿至 DCP1 / 三个草稿 | Mooncake offload;DCP8 |
| 150 | 仅 GPU;DCP1;五至七个草稿 | Mooncake offload;DCP8 |
两个系统均使用八块 GPU、TP8、FP4 权重和 FP8 KV。数值在每个已发布的 offload 或仅 GPU 系列内按相同交互性进行插值;并发数、DCP 和草稿深度可在边界运行之间变化。固定的 AMD 配方(YAML) 和 NVIDIA 启动器 给出了镜像标签和完整设置。
回放使用 cc-traces-weka-062126 数据集和 固定的 AIPerf 测试框架,预热不计入,并在 固定的合成接受曲线下进行一小时的性能剖析。配方给出了种子、会话开始和预热设置。下载的数据集修订版本未被记录。闭环回放可能产生不同的已完成请求组合。
软件与 offload。提交使用 vLLM 36768d1bf (AMD)和 5894fdf98(NVIDIA)。配置的主机缓存预算分别为每块 GPU 224.875 和 281 GB;连接器和镜像设置见链接的配方。
成本。SemiAnalysis 的 大型超大规模云厂商拥有成本模型 和 已发布的 GPU 成本常数 使用 AMD Instinct MI355X 每块 GPU 小时 1.50 美元,NVIDIA HGX B300 为 2.26 美元。Total tokens/$ = total tokens/s/GPU × 3,600 ÷ 建模的 $/GPU-hour。部分资本和利用率假设仍未公布。在 50-token 交互性目标下,该比较显示每 token 的建模成本低 46.6%。
快照。 SemiAnalysis InferenceX 数据 检索日期为2026年10月9日;提交日期分别为2026年9月30日(AMD)和2026年8月16日(NVIDIA)。PR 基准测试使用其声明的工作负载; #59591 是在标题图片之后的单独实验。
| 已公布的规格,每 GPU | AMD Instinct MI355X | NVIDIA B300 GPU |
|---|---|---|
| 低精度稠密矩阵峰值 | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| GPU 显存 | 288 GB HBM3E | 288 GB HBM3E |
| 峰值显存带宽 | 8 TB/s | 8 TB/s |
来源: AMD Instinct MI355X, NVIDIA HGX B300, NVIDIA 显存规格。基准测试细节: AgentX 方法论.
技术说明:专家路由与精度
Kimi K3 在每个 token 中从 896 个专家中选出 16 个,因此即使是较大的服务器批处理,每个专家的行数仍然可能很少。由此产生的专家分块可能包含填充。
A4W4 减少了另一部分流量:其中的集成方案 #53940 将激活值从八位改为四位,而权重保持四位。总流量还包括 BF16 中间输出和专家分块填充。
技术说明:KDA 精度与片上内存
每个数据块仍需解析其内部token之间的依赖关系。内核将它们组合成一个变换,供后续的矩阵乘法使用。这带来两个实际问题:哪种精度能保留答案,以及芯片上能容纳多少临时数据?
一个小例子可以说明这个思路。将前面的修正代入后面的修正中,每个答案都可以直接用已知输入来表示。得到的系数表已经考虑了整条依赖链:
在这个标量示例中,位置一对位置三的影响有两条路径:直接为 −1/8;通过位置二为 (−1/4) × (−1/4) = 1/16。两者相加得 −1/16,即表格左下角的元素。对角线上方的零表示后面的位置不能影响前面的位置。
实际的序言部分会计算64×64块内依赖矩阵的逆矩阵。后续的矩阵乘法使用这个变换来计入这些依赖关系。
逆矩阵的中间值可能会增大并相互抵消。过早舍入会丢失最终结果所需的信息。该实现使用AMD原生的 FP32矩阵指令,对敏感的逆矩阵运算保留FP32输入和累加。只有计算完成的逆矩阵才被舍入为BF16用于后续乘法。 内核实现.
为什么FP32累加无法恢复已舍入的输入
考虑从256.5中减去256。两个输入在FP32中都是精确的。在这个量级下,将256.5转换为BF16会把它舍入为256:
| 输入精度 | 以FP32执行的减法 | 结果 |
|---|---|---|
| 保留原始FP32输入 | 256.5 − 256 | 0.5 |
| 先将输入舍入为BF16 | 256 − 256 | 0 |
FP32减法无法在开始之前恢复已经丢失的信息。这些简单的数值说明了为什么逆矩阵使用原生的16×16×4 FP32矩阵指令,同时保留输入和累加精度。
FP4模型同样依赖于更高精度的运算。它们的性能取决于让这些数值路径保持高效。
序言部分还有本地内存预算的限制。AMD将其片上共享暂存区称为LDS。Q和K分块复用存储空间,因为它们在不同时间被需要;三角输入矩阵只存储其十个已占用的16×16块。工作组请求 79.5 KiB,向上取整为 80 KiB,即AMD CDNA 4计算单元 160 KiB LDS预算.
分配以1,280字节为单位向上取整。图中多出的那一KiB跨越了一个驻留阈值:两个分配不再能同时容纳。这是一个容量计算;寄存器和其他资源还可能带来额外的限制。
可以通过保留足够多的未使用LDS来跨越该阈值,同时保持内核二进制不变,以此测试这个阈值。如果运行时间几乎没有变化,说明多出的那个驻留工作组对该形状的贡献很小。
数据块之间的状态
组摘要和起始状态仍需跨越内核边界;请求的检查点和最终状态会被保存。
免责声明
本文档所提供的信息仅供参考,可能包含技术上的不准确之处、遗漏和排版错误。本文所含信息可能会发生变更,并可能因多种原因而变得不准确,这些原因包括但不限于产品和路线图变更、组件和主板版本变更、新型号和/或新产品的发布、不同制造商产品之间的差异、软件变更、BIOS 刷新、固件升级或类似情况。任何计算机系统都存在无法完全预防或缓解的安全漏洞风险。AMD 不承担更新或以其他方式更正或修订此信息的义务。但是,AMD 保留修订此信息并不时对其内容进行更改的权利,且 AMD 无义务将此类修订或更改通知任何人。本信息按“现状”提供。AMD 不对本内容作出任何陈述或保证,并且对可能出现在本信息中的任何不准确、错误或遗漏不承担任何责任。AMD 特别声明不承担任何有关不侵权、适销性或适用于任何特定用途的默示保证。在任何情况下,即使 AMD 已被明确告知存在此类损害的可能性,AMD 也不对任何人因使用本文所含任何信息而产生的任何信赖、直接、间接、特殊或其他后果性损害承担责任。AMD、AMD Arrow 标志及其组合均为 Advanced Micro Devices, Inc. 的商标。本出版物中使用的其他产品名称仅用于识别目的,可能是其各自公司的商标。© 2026 Advanced Micro Devices, Inc. 版权所有。