
Reflection 的 Beam 已经在 Hugging Face 上发布!它是来自新成立的美国实验室 Reflection 的首个模型,而且是开源的!这是一个混合专家(MoEs)模型,拥有 501B 参数(每个 token 激活 23B),支持文本作为输入,并具有 1M token 的上下文窗口,且以 Apache 2.0 许可证发布。
Beam 专注于 编程 和 智能体(agentic) 用例。它面向那些希望在自己的硬件、基础设施或云上运行前沿规模模型,并希望根据自己的用例进行定制的团队。Beam 自带一个专用的开源 Rust 训练工具(harness),可为该模型提供最佳性能。
Beam 在 transformers 中有原生实现,vLLM 和 SGLang 等下游库也提供支持。我们与 Reflection 团队合作,为你带来了推理、SFT(监督微调)和 RL(强化学习)方案,以便你根据自己的需求使用该模型进行构建。除了在 transformers、SGLang 和 vLLM 中的 day-0 支持之外,本文还将向你展示如何运行它、如何进行后训练,以及我们用它构建了什么。
TL;DR
- 501B 参数的 MoEs LLM,每个 token 激活 23B。52 层,每个 MoE 层有 256 个专家,每个 token 路由 8 个。
- 文本输入,文本输出,具有 1M token 的上下文窗口。
- 检查点格式: BF16, FP8, 以及 NVFP4
- 可在多轮对话中保持在上下文中的推理能力(
preserve_thinking),以及带有专用语法的工具调用。该模型支持五个推理级别值:"low"、"medium"(默认)、"high"、"xhigh" 和 "max"。- 分词器中的响应模板。
- 配备 DFlash2 的推测解码起草模型
- Day-0 支持库:transformers、SGLang、vLLM。通过 Miles 进行全参数 RL。
- 自带一个 基于 Rust 的自定义 harness。
- Apache 2.0 许可证。
使用 Beam 构建
Reflection 将向使用 Beam 的最佳项目发放 10,000 美元 Hub 额度。你只需做出一个作品,并将其分享到 Hub 上:
- 你可以在 Spaces 上制作一个使用 Beam 模型的 demo
- 你可以为喜欢的硬件对其进行量化
- 你可以为你喜欢的问题生成一个合成数据集
- 你可以为 Beam 构建或与其一起构建一个 RL 环境
- 你可以对 Beam 进行基准测试并分享结果。
- 你可以给我们带来惊喜!
如果你用 Beam 构建了什么东西,就把它分享到 Hub 上,有机会赢得10,000美元。你只需构建 space、model 或 dataset 仓库,并将其分享到 模型的仓库页面。我们会收集所有链接,选出最佳作品,并将额度发放到你的 Hub 账户。
什么是 Beam?
Beam 是一个纯文本模型,专为长上下文(1M 上下文长度)推理和智能体工作而构建。它是一个稀疏 MoE 模型,每个 token 仅由网络的一小部分计算,因此它能以小得多的模型的速度运行,同时保持大模型的容量。
注意力机制
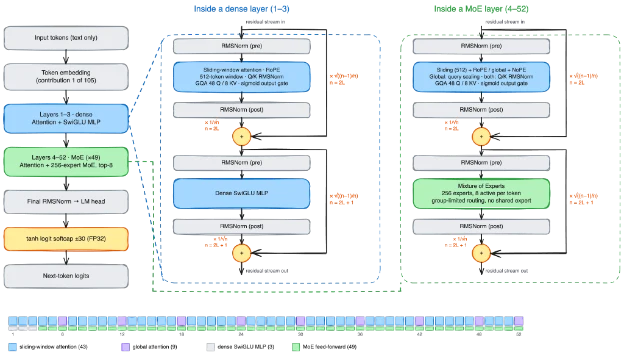
解码器有 52 层,隐藏层大小为 5,120。大多数层对之前的 512 个 token 使用滑动窗口注意力;每第六层以及最后一层会关注完整上下文。这意味着有 43 个滑动窗口层和 9 个全局层。
注意力块内部(两种层类型)
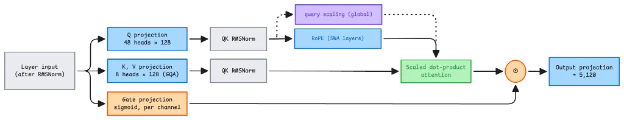
这两种层处理位置信息的方式不同。滑动窗口层使用 RoPE,因为在短窗口内相对位置最为重要。 全局层不使用位置编码。相反,每个查询会乘以一个随可见 token 数量缓慢增长的缩放器, (1 + (pos + 1) / 2048) ** 0.1。它起到温度的作用:随着上下文变长,softmax 保持其精度而不会变得平坦。实现中将这称为可扩展 softmax(scalable-softmax)查询缩放。
注意力采用分组查询注意力,有 48 个查询头和 8 个键值头,并对查询和键使用 RMSNorm。一个由层输入计算出的可学习 sigmoid 门控,在输出投影之前对每个头的每个通道进行缩放。
专家混合
前3层使用稠密的SwiGLU MLP。其余49层将其替换为一个拥有256个专家的混合专家模块,每个专家是一个中间大小为2,560的SwiGLU MLP,约39M参数。专家占模型参数的98.4%。
路由器遵循DeepSeek-V3的分组限制方案。它用sigmoid为全部256个专家打分,将其分为8组每组32个,保留最好的4组(按每组前两名得分之和排序),然后在其中选出前8个专家。Beam使用与DeepSeek-V3相同的分组大小,但没有共享专家。专家输出以归一化的路由器权重组合,并乘以2.5进行缩放。
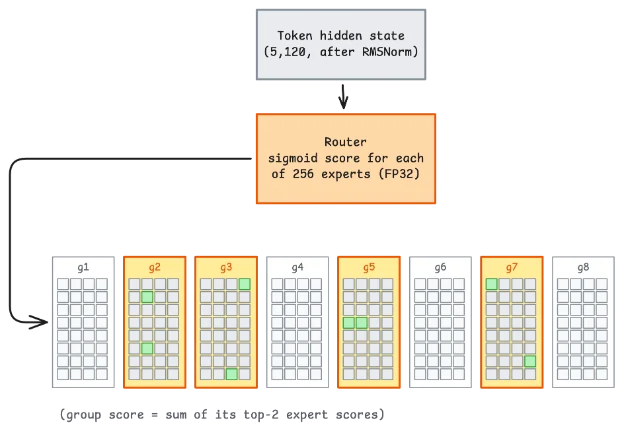
每个token只运行8个专家,因此模型用约23B参数计算每个token。全部256个专家都保留在内存中,因此部署需要501B模型的内存,但以23B模型的速度运行。BF16检查点在safetensors格式下约1 TB。NVFP4检查点为NVIDIA Blackwell GPU将大部分参数以4位精度存储,为保精度部分参数保留为BF16。Hub上还有FP8检查点,非常适合Hopper和Ampere系列芯片。
如果你想自行部署Beam,请查看下方的vLLM或SGLang指南。
残差流
残差连接是最具特色的部分。标准Transformer以权重1将每个子层输出加到流上,因此流随深度增长。
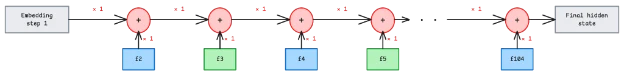
Beam将输入嵌入计为第1步。在第 k 步时,它以权重 1/sqrt(k) 加入子层输出,并以权重 sqrt((k-1)/k)保留现有流。两个权重的平方和为1,因此流从第一层到最后一层保持恒定尺度。在全部104次加法之后,每个子层输出和输入嵌入在最终隐藏状态中携带相同的权重。
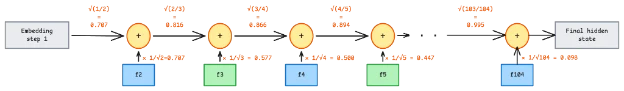
每个子层在前后也都进行归一化,最终的logits经过一个±30的tanh softcap,以FP32计算。实现固定了在FP32中计算的位置:路由器、SwiGLU乘积、归一化、RoPE、query缩放和softcap。
长上下文
混合注意力非常适合长上下文。每层为每个token缓存2 x 8 KV头 x 128维 = 2,048个值。如果全部52层都保留每个token,缓存将按每token 208 KiB增长。只有9个全局层保留整个序列。43个滑动窗口层各持有一个固定的512-token窗口并停止增长。因此缓存按每token 36 KiB增长,约为朴素速率的六分之一。
| 上下文 | 如果全部52层都是全局层 | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| 完整上下文 (1M) | 208 GiB | 36.08 GiB |
这些数字是按单个序列、以BF16、使用transformers动态缓存计算的。
基准测试结果
以下是由Reflection团队提供的不同精度级别的基准测试结果。
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| 智能体编程 / 终端 | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| 推理 | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE(无工具) | 36.0% | 36.0% | 34.8% |
| HLE(使用工具) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| 工具调用 / 搜索 | |||
| AutomationBench - 仅公开子集 | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| BrowseComp(带上下文管理) | 76.8% | 76.7% | 75.6% |
| DeepSearchQA(带上下文管理) | 80.5% | 79.6% | 81.1% |
| 通用能力 | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience (index) - 仅公开子集 | 10.8 | 8.8 | 9.8 |
硬件要求
部署该模型最实用的方式是使用 NVFP4 检查点,它保留了 bf16 检查点的大部分质量。NVFP4 将部分权重以 4 位存储,这样将 BF16 下的 501B 参数从 1 TB 缩减到约 280 GB。Blackwell GPU 原生支持运行 NVFP4,但比 Blackwell 更旧的 GPU(如 H200)无法运行。FP8 检查点适用于比 Blackwell 更旧的 GPU。
一块 B200 拥有 180 GB 的 HBM3e,因此两块(360 GB)可以容纳 Beam 的权重,但几乎没有剩余空间给激活值和 KV 缓存。建议规划四块 B200(720 GB),这会为长上下文和并发请求留出充足空间。你也可以在完整的 8xB200 节点上部署,或使用两块各 288 GB 的 B300,甚至 8xRTX Pro 6000。如果你没有 Blackwell 硬件,可以使用 Inference Providers(无服务器)来测试 Reflection。
推理支持
Beam 在发布 day-0 当天即获得 transformers、SGLang 和 vLLM 的支持。
Transformers
安装最新版本的 transformers。
pip install -U "transformers>=5.20.1"
运行 Beam 最简单的方式是使用文本生成流水线:
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
该流水线返回完整的聊天内容。最后一条消息就是 Beam 的回复,已经由响应模板解析完成。
再往下一层,使用 AutoModelForCausalLM 和 AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
Chat
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Beam 的分词器自带响应模板。 parse_response 读取该模板,并把原始输出转换成消息字典,其中推理过程、答案和任何工具调用分别位于不同字段。这避免了通常需要用正则表达式把推理、答案和工具调用相互拆分的做法。而且这些规则随分词器一起发布,因此解析出的结构与 Beam 训练时生成内容的格式相匹配。聊天模板可以预先写入 assistant 回合的一部分内容,解析器需要看到这部分内容。
工具调用
完整的工具调用示例def get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
同时也把 tools 传给 parse_response 。Beam 以其自己的 XML 风格文法内联写入工具调用参数,因此一个裸的 7 可能是数字或字符串。有了工具模式(schema),解析器会把每个参数转换为声明的类型。
多 GPU 与多节点
Beam 的配置定义了专家并行计划。专家并行把每个专家放在一个设备上。注意力、稠密层、嵌入和 LM head 在每个设备上都进行复制。这是 8B 参数,即 BF16 下的 16 GB。使用 DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
加载模型, torchrun 启动脚本,跨越 16 块 H200 GPU。这样每块卡持有 78 GB 权重。如果用 8 块 GPU,每块将持有 139 GB,这在 141 GB 的 H200 上没有剩余空间。设备数量必须能整除专家数量 256。
vLLM
Beam 在 vLLM 中获得 day-0 支持。以下命令以跨 16 块 GPU(两台 8x H200 节点)的张量并行方式提供 BF16 检查点服务,并暴露 OpenAI 兼容的 API:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
为了更快地生成,可添加 DFlash2 投机解码。一个小型起草模型(drafter)最多提前提出 15 个 token,而 Beam 在一次前向传播中校验所有 token,因此每一步可以接受多个 token。代价是为起草模型增加一点额外内存:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
两条命令都会启动一个 OpenAI 兼容的服务器,因此你可以把任何 OpenAI 客户端指向 http://localhost:8000/v1。有关其他服务配置,请参见 为 vLLM 提出的 Beam 配方.
SGLang
Beam 在 SGLang 中同样获得 day-0 支持。我们建议使用 DFlash2 投机解码来提供其服务,下面两条命令都开启了该功能。在 Blackwell 上,NVFP4 检查点可以放入 4 块 B300:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
在 Hopper GPU 上,请改用 8 块 H200 运行 FP8 检查点。只有三个标志会变化:检查点、张量并行大小(8 而不是 4),以及注意力后端(fa3 而不是需要 Blackwell 的 trtllm_mha):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
推理提供商
Beam 已在 Hugging Face Inference Providers 上提供,由 Baseten、Fireworks 和 Together 提供支持,更多提供商也将陆续跟进。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
推理端点
我们已为你设置好 Beam 配方,可在 FP8 或 NVFP4的目录中一键部署到 Inference Endpoints,或者使用以下命令安装: hf cli 如下:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
我们测试了什么
我们正在分享关于 Reflection Beam-501B-A23B 在五项任务上的一些 vibe 评测,每项任务分别通过 Reflection 平台以低推理强度和高推理强度各运行一次。这些是 vibe 评测,而非基准测试。如果你计划使用 Beam,这是熟悉它并观察它在具体用例上表现的绝佳方式,更重要的是,可以看到它在哪些方面占优、在哪些方面失利。
以下是我们运行的提示词概览以及来自 hub 的输出轨迹。完整的输入、输出、API 用量、任务测试装置、评分器和对话轨迹都在 这个公开的 Hugging Face bucket 中.
| 类别 | 提示词描述 | 低推理(tokens) | 高推理(tokens) |
|---|---|---|---|
| 多步工具调用 | 完成 ORD-742:比较库存、预订、附加费和到货日期;预订最便宜的合格仓库。 | ✅ 544 | ✅ 811 |
| 代码库上的长上下文检索 | 从三个完整源文件推导 Click 命令配置和两个调用结果;引用六个实现符号。 | 🔴 1,613 * | ✅ 5,007 |
| 沙盒中的终端任务 | 检查并修复一个 CSV 账本 CLI;修复所有 bug,保留测试,运行测试和 CLI 检查。 | ✅ 582 | ✅ 1,548 |
| 数学推理(AIME 风格) | {1, …, 16} 中有多少个八元素子集的和能被 17 整除?请给出论证。 | 🟠 829 † | ✅ 2,809 |
| 结构化输出 | 将一个乱序的修订日志转换为严格的 JSON:合并补丁、撤销、null、日期、货币和总计。 | ✅ 1,040 | ✅ 2,088 |
* Low 的长上下文回答正确涵盖了所有代码行为和全部六个源引用。然而,该回答不符合解析器的格式,所以这部分是提示词歧义造成的。
† Low 返回了正确答案,但省略了所要求的论证。High 给出了正确的单位根证明,并经独立审阅。
不要只听我们说。深入了解 bucket,根据您的用例或项目进行改写,并将 Beam 推向极限。
Beam 的后训练
您可以针对自己的用例对 Beam 进行微调。在这里,我们分享一些 TRL 和 Miles 中的示例,帮助您开始监督微调和强化学习。
使用 TRL 进行 SFT
让 Beam 适配您自己的数据的最快方法是使用 TRL 的 SFTTrainer 进行监督微调。为了让内存保持在可控范围内,我们使用 PEFT 训练 LoRA 适配器,而不是更新全部 501B 参数:
我们使用了 TRL 的 SFTTrainer 来让 Beam 适应一个简单的目标:以用户要求的语言进行推理。我们在 Multilingual-Thinking 上用 LoRA 进行微调,该方法只训练一小部分适配器权重,同时保持基础模型冻结。
该设置结合了加载时的模型分片、专家并行、FlashAttention 4 和序列打包。LoRA SFT 可以在单个配备 8 张 B300 GPU 的节点上运行,达到约 19,000 tokens 每秒的速度。对应的 H100 设置需要四个节点。
在 Multilingual-Thinking 上训练一个 epoch 后,Beam 在 16 个保留提示中的 16 个上都能以所要求的语言进行推理,而基础模型只有 16 个中的 3 个。这个小规模评估衡量的是语言遵循度,而不是推理本身的正确性。
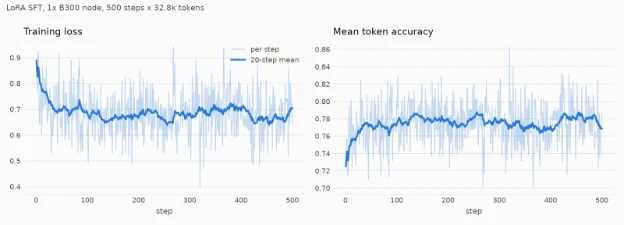
在 open-r1/Mixture-of-Thought 的推理子集上使用单个 8-GPU B300 节点进行一次 500 步的独立运行期间,训练损失(左)和平均 token 准确率(右)。这些训练指标来自官方的 TRL example PR.
使用 Miles 进行 GRPO
Reflection 和 RadixArk 构建了一个在 Miles 中用 GRPO 以 BF16 训练模型的方案。您可以更新完整模型,或使用 LoRA 训练适配器,同时保持基础权重冻结。Megatron 负责训练,SGLang 生成 rollout,Miles 在每次更新后将新权重发布到 rollout 引擎。我们审阅了该方案。
| 工作负载 | 参考配置 |
|---|---|
| 推理 / 评估,BF16 | 每个引擎 16x H200 |
| 全参数 GRPO,BF16(Miles) | 96x H200:64 训练,32 rollout。或者 64x H200 共置部署。 |
| LoRA GRPO,BF16(Miles) | 32x H200:16 训练,16 rollout。 |
| 全参数 GRPO,BF16,128-token 上下文(Miles) | 48x H200:32用于训练,16用于 rollout。Reflection 和 RadixArk 先在真实 checkpoint 上验证了这一配置。 |
该配方在 DAPO-Math-17K 上运行 GRPO,并在 AIME25 上评估。构建镜像、下载数据,然后将作业提交到由十二个 8x H200 节点组成的 Ray 集群:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
一次 rollout 中会发生什么:
样本: 32个 prompt 传入模型,每个生成8个响应。两个 SGLang 引擎分别在各16个 GPU 上提供 rollout 服务。
评分: 将框内答案与标签进行核对,对接近长度上限的响应给予软惩罚。
更新: 对全部256个样本执行一次优化器步骤。采用组相对优势并结合截断重要性采样,不使用 KL 或熵惩罚。
并行训练: 张量并行 8、专家并行 8、数据并行 8,并启用序列并行和完整重计算。
优化器: Adam 学习率恒定为 1e-6。梯度使用 BF16,主权重使用 FP32,动量使用 BF16。优化器状态通过节点本地 NVMe 流式传输,因此每个训练节点需要 2 TB 的临时存储。
评估: AIME25每五次rollout,每题八份样本。每二十次保存一个检查点。
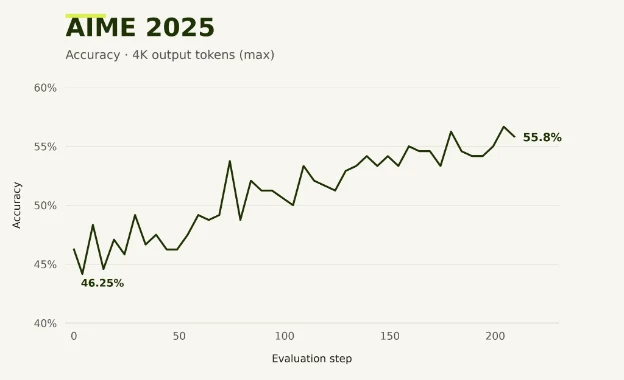
下一次 rollout 是在当前 rollout 训练的同时生成的,因此响应落后一次更新。Add --resume 以便从上一个检查点继续。 execute-colocate 在八个节点上运行同一配方,每个 GPU 轮流进行训练和服务。
使用 LoRA 训练
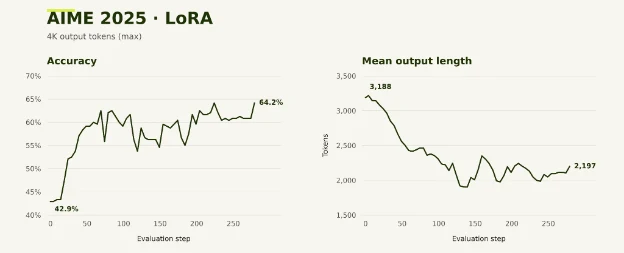
你也可以在四个 8× H200 节点上使用 LoRA 运行 GRPO:16 个 GPU 用于训练,16 个用于 rollout。该方案在 Beam 的注意力层、稠密 MLP 层和专家层上训练 rank-16 适配器,同时保持基础权重冻结。只有适配器权重会与 SGLang 同步,优化器状态保留在 GPU 内存中,从而无需使用 NVMe 优化器卸载。
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
使用 Beam 构建:演示
如果你使用 Beam 构建了什么东西,就把它分享到 Hub 上,即有机会赢得10,000美元。你只需构建一个 space、模型或数据集仓库,并将其分享到 模型的仓库页面。为了给您带来启发,这里是我们构建的一些东西。
嘿 Beam,构建一个原生本地 MacOS 应用程序吧!
在 Hugging Face,我们热爱在其硬件上原生运行的开源本地模型,但在 Mac 上构建原生应用可能很困难!让我们看看 Beam 能否帮上忙。
我们让 Beam 构建一个原生 MacOS 应用程序,将语音转换为文本,并方便地放置在你的光标处。我们想使用 MLX 来充分发挥 Mac Metal 的性能,并使用 Parakeet 模型实现出色的语音转文本效果。
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
我们使用 Beam 配合 Pi 编码框架构建了最初的原生 macOS 菜单栏应用,通过 MLX 运行 Parakeet。保存的运行记录包含后续提示;最终源码还包含了之后的 Codex 修复。上面的提示是构建需求的精简版本。
你可以在以下链接查看 Beam 在 pi 中构建此应用的代理轨迹: 这条轨迹。如果你想试用这个演示,请下载 源代码 或阅读 设置说明.
嘿 Beam,你如何在多个代理上扩展?
我们想看看 Beam 是否能通过将一个编程任务拆分给多个代理来取得更快的进展。我们将 Beam 与开源的 Pi 编码代理配对,并比较了三种设置:1. 一个代理单独工作,2. 五个持久化对等代理通过共享 Git 仓库协作,3. 一个主代理将工作委派给异步子代理。该框架运行在 Hugging Face jobs 上,推理通过 Reflection 的平台 API 完成。
对于任务,我们使用了 ProgramBench:代理必须根据编译后的可执行文件和文档重建一个程序,而不能看到其源代码或评估者的测试。每种设置都有相同的 8M API 令牌上限和每任务两小时的求解器时限,由其代理共享。我们保存了实现快照,并使用 ProgramBench-Tests 数据集.
中固定的隐藏测试套件对它们进行评估。我们的 分数与延迟关系图 显示通过测试的平均比例。时间轴对模型令牌使用固定的参考速率,加上实测的工具时间,而不是实际经过的墙钟时间。我们最初运行了五个任务。当前图表显示了 jq、xsv、FIGlet 和 hexyl 的事后子集;ripgrep 在所有三种设置中都被排除,因为对其保存的工件进行评分太慢了。已发布的结果保留了全部 15 个原始片段。
你可以在 Trackio 仪表板中检查运行情况,浏览 已发布的结果数据,并复用该 研究框架.
嘿 Beam,为我的代码库微调一个决策模型!
决策模型目前非常流行,因为它们在许多用例中速度极快且非常实用。我们从 Beam 开始,在 Beam 的配额用尽后继续在 Pi 中使用 GLM-5.3,以训练和评估一个用于开发人员事故分诊的自定义决策模型。
我们想看看一个编码智能体能否将事件分诊策略转化为一个小型、快速的决策模型。任务是阅读开发人员的事件报告,并选择负责团队、其严重程度,以及是否需要立即提醒某人。我们使用 Unsloth 对 Qwen3.5-0.8B 进行了微调,使其能够直接为这些选择打分。
首先,该工作流构建了一个合成数据集,其中包含按事件簇划分的2.3k个事件,用于训练、校准和测试。我们在Science Slurm集群上的一块H100 80GB上,以4-bit骨干网络训练了LoRA适配器和决策头,共三个epoch。
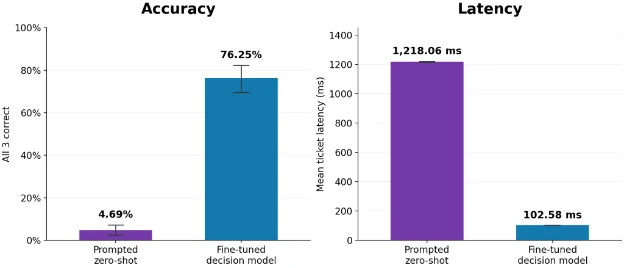
作为基线,我们向未经适配的模型提供完整的分诊策略和工单进行提示,不带示例,并要求它以 JSON 格式生成三项决策。在相同的 320 张合成测试工单上,微调后的决策模型在 76.25% 的情况下三项答案全部正确,而零样本提示仅为 4.69%。工单平均延迟从 1,218.06 毫秒降至 102.58 毫秒,实现了 11.9 倍的提速。
如果你想亲自尝试这个实验,请查看 工件存储桶 其中包含数据、代码、检查点和结果。
总结
Beam 是一个 501B 开源模型,你可以在自己的硬件上运行并修改它。从 BF16 检查点,或尝试其中一个量化版本 FP8, NVFP4。如果你用 Beam 构建了什么,欢迎在 discussions 标签页中分享.