
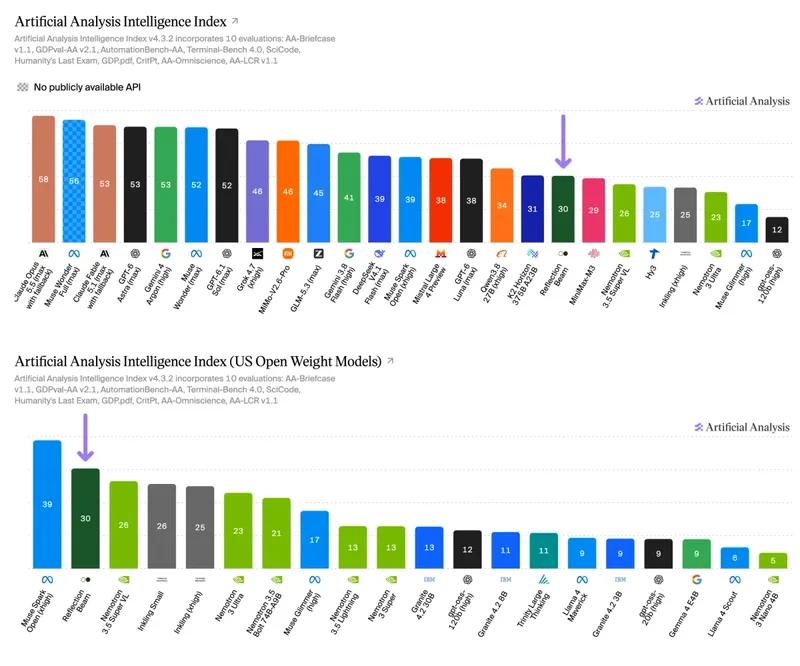
Reflection 的首个模型 Beam 在 Artificial Analysis 智能指数中得分为 30,在美国开放权重模型中位列第 2
查看模型页面 查看模型页面Beam 是一个开放权重模型,总参数量为 501B,激活参数量为 23B
要点:
➤ 在美国开放权重模型中位列第二:Beam 得分为 30,仅落后于 Meta 的 Muse Spark Open(39),领先于昨日发布的 NVIDIA Nemotron 3.5 Super VL(26)。在中国之外,只有 Muse Spark Open 和阿联酋的 K2 Horizon(31)得分更高
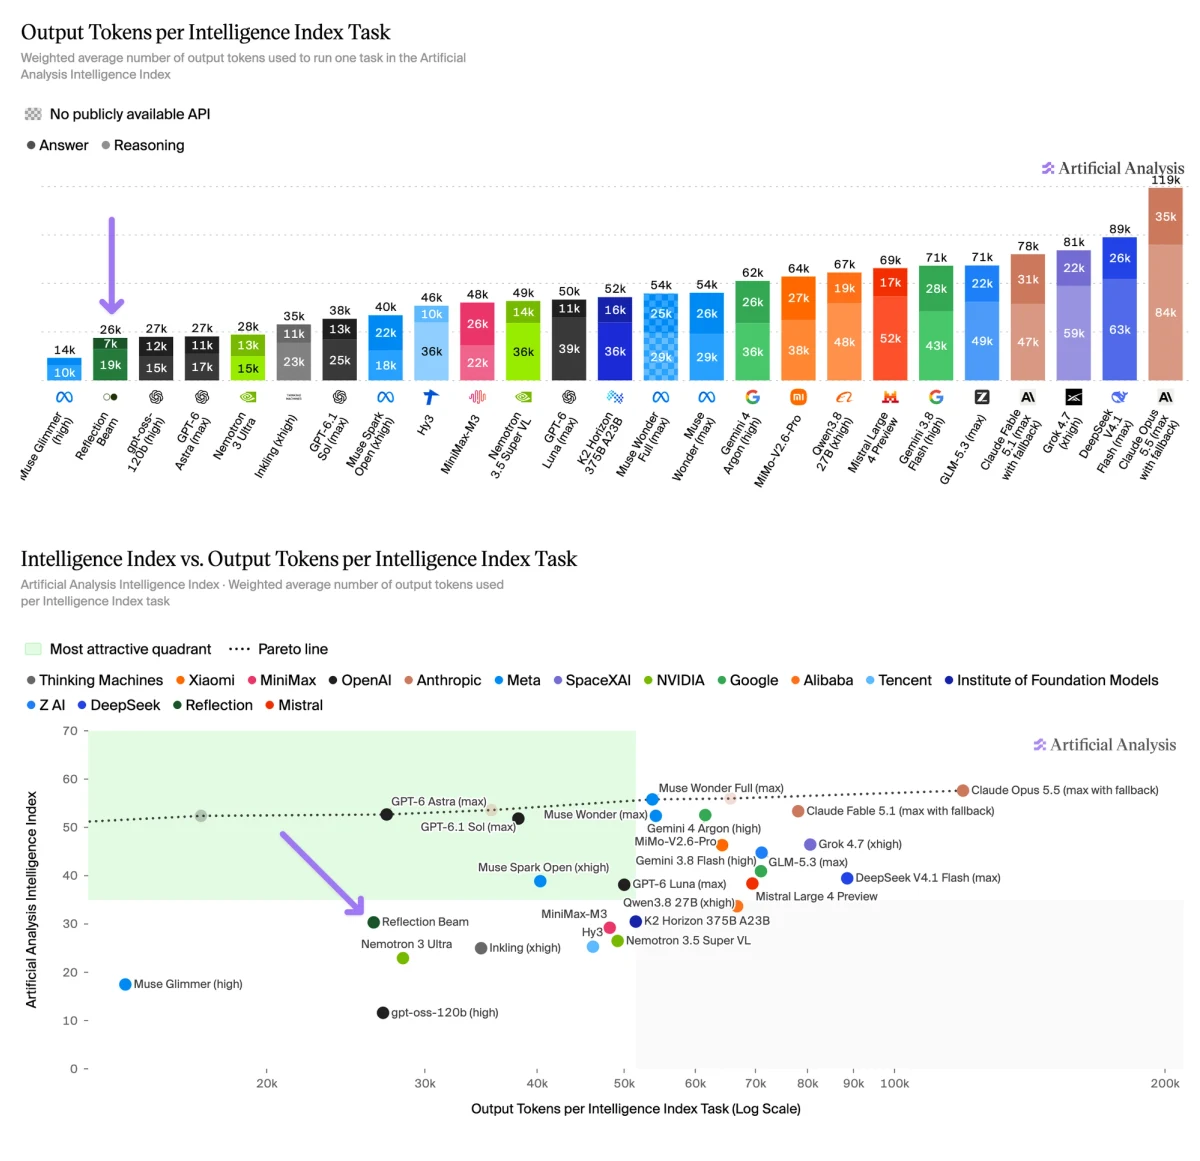
➤ 在同等智能水平下令牌效率高:Beam 在每个智能指数任务中使用约 26k 输出令牌,而领先其一分(应为:领先其一分)的 K2 Horizon 使用了两倍的量(约 52k)。专有模型仍然处于前沿,GPT-6 Astra(max)在相同预算(约 27k)下得分为 53
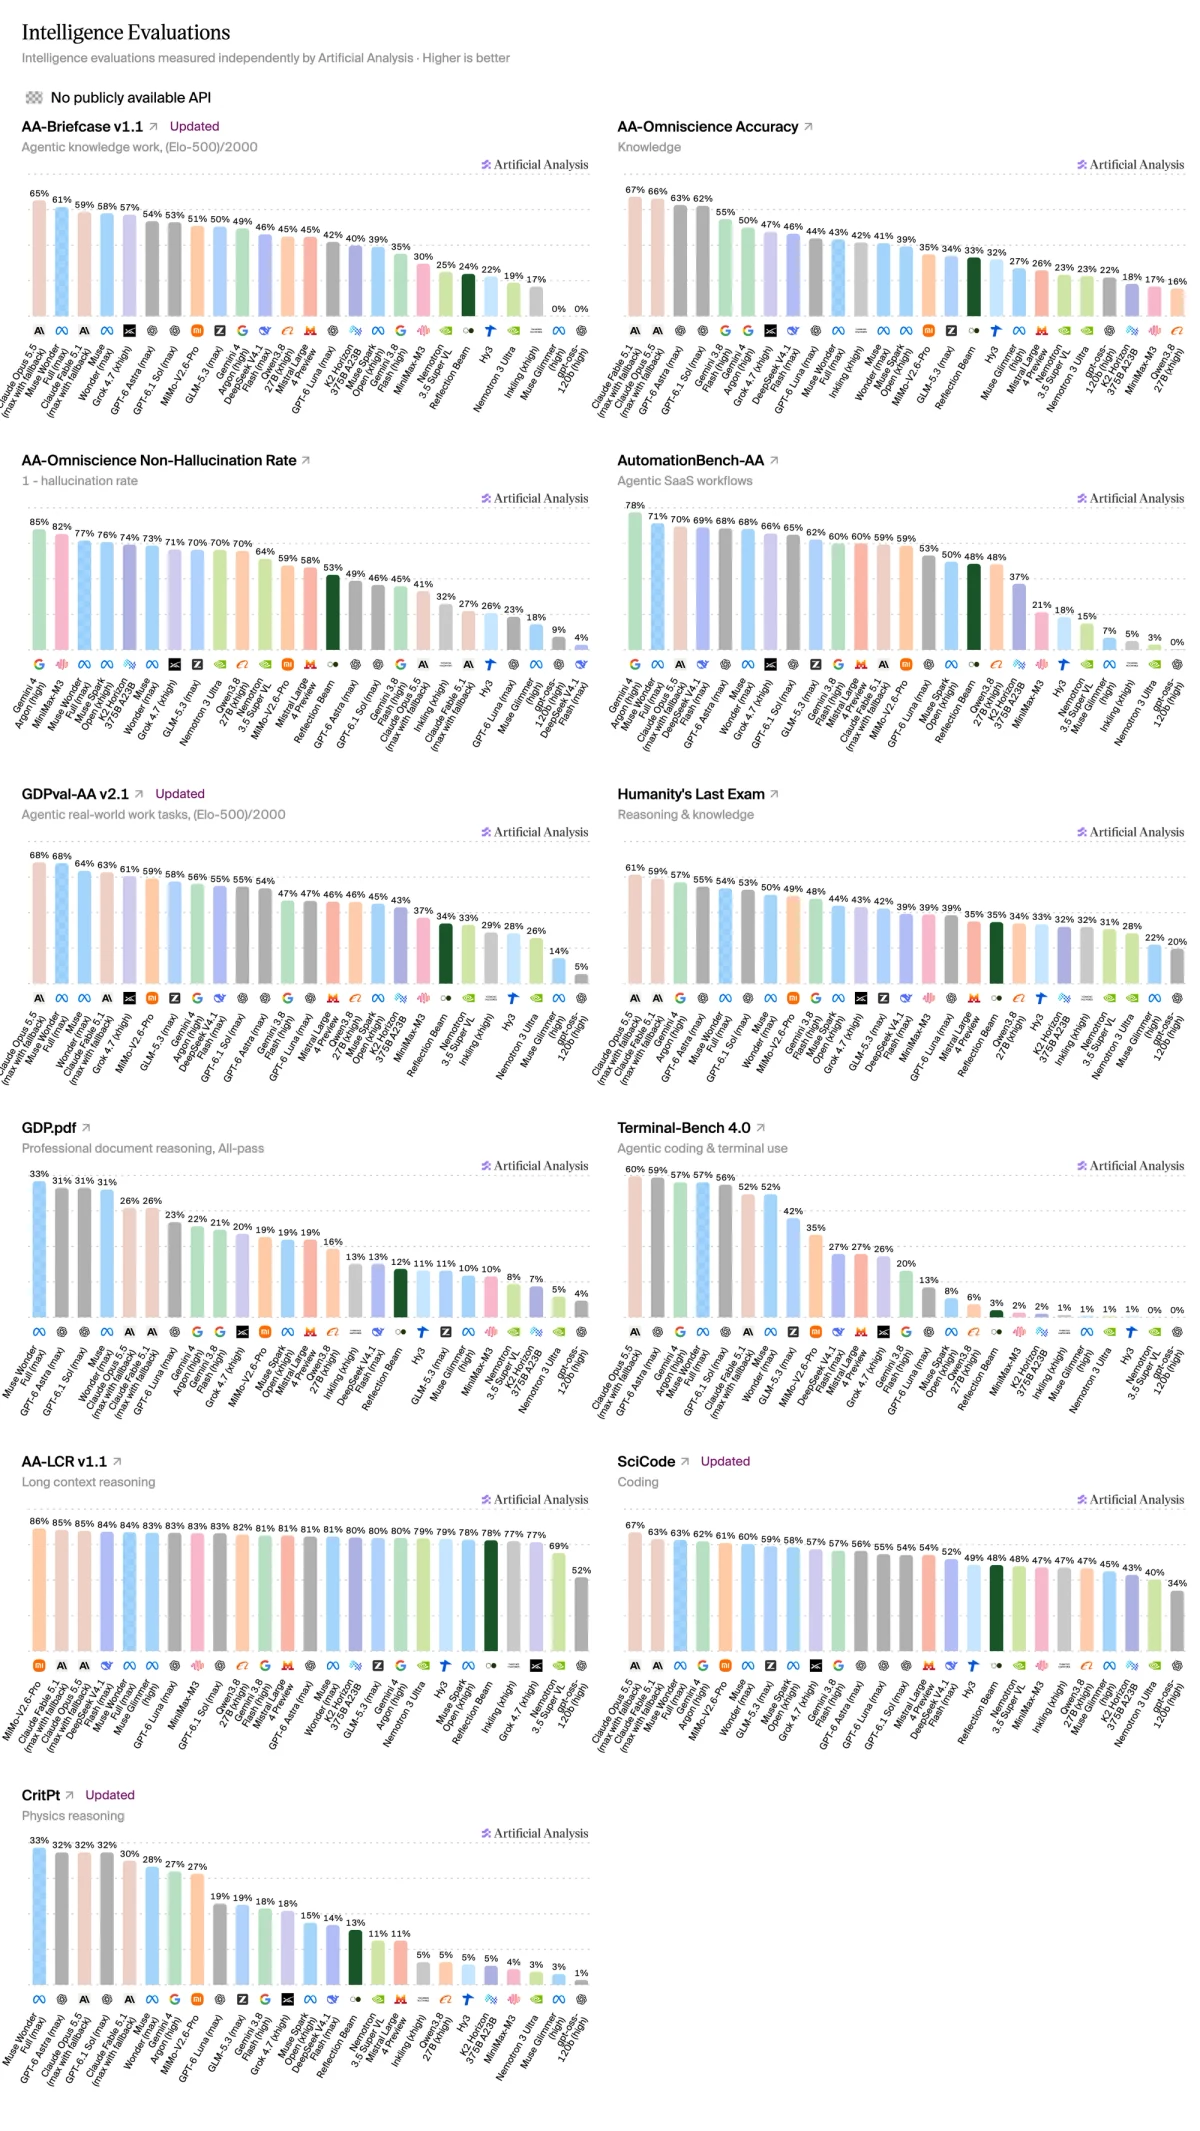
➤ 智能体工作流表现出色,终端能力较弱:Beam 在 AutomationBench-AA 上得分为 48.5%,领先 K2 Horizon(37.2%)11 个百分点,与 Qwen3.8 27B(48.2%)持平。Terminal-Bench 4.0 是其弱点,Beam 得分为 3.0%,落后于 Qwen3.8 27B(5.6%)和 Muse Spark Open(8.1%)
➤ 知道得更多,也猜得更多:在 AA-Omniscience 上,它正确回答了 33% 的问题,远超 K2 Horizon(18%)和 Qwen3.8 27B(16%)。但其幻觉率为 47%,而 K2 Horizon 为 26%,Qwen3.8 27B 为 30%,使 Beam 的净指数得分为 1.5,领先于这两个同类模型(−3.0 和 −10.0)
其他模型细节
- 上下文窗口: 1M 令牌
- 模态: 文本
- 参数量:501B / 23B
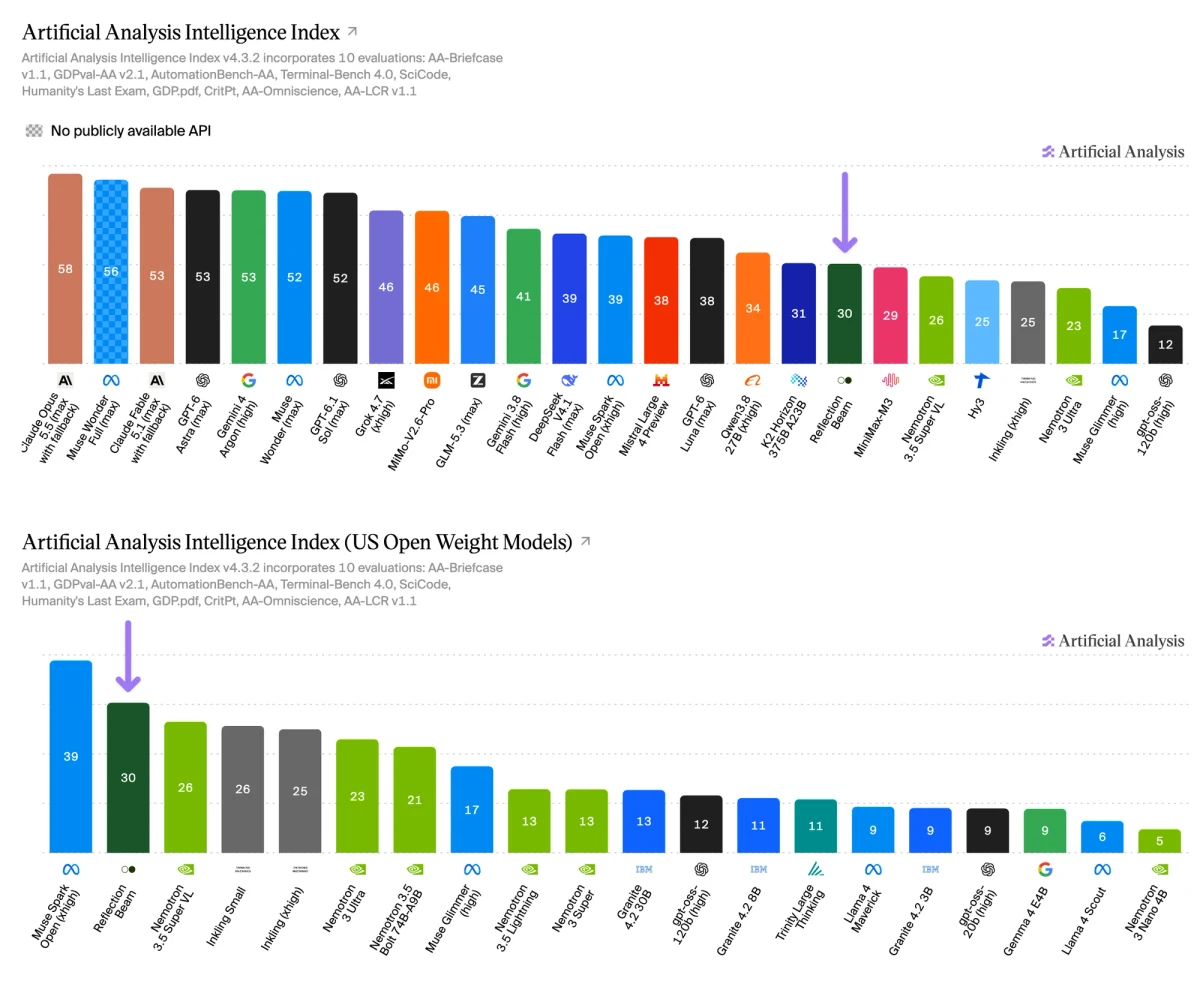
与开放权重同类模型的比较
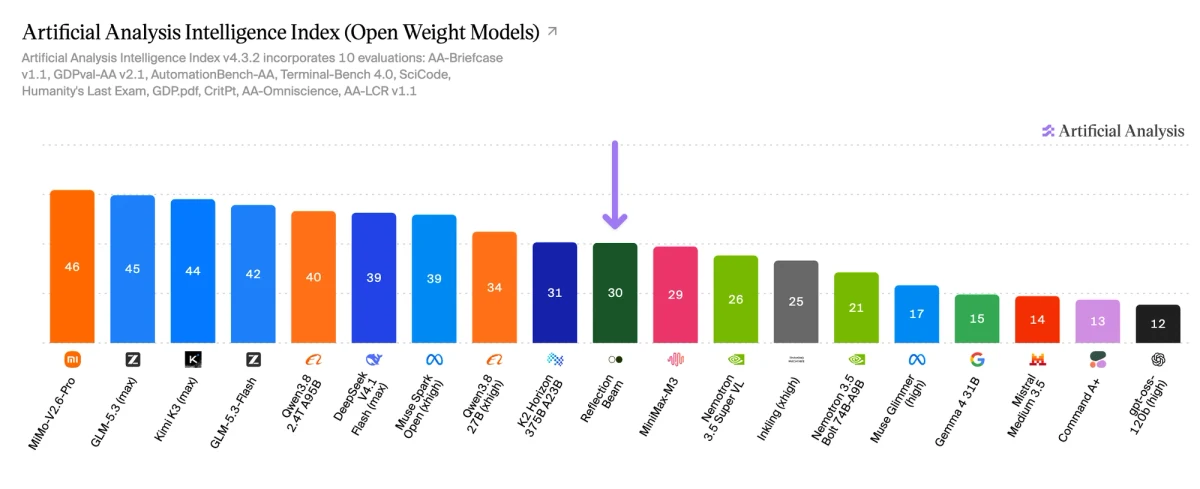
Beam 在与美国开放权重模型的对比中得分很高,落后于 Meta 的 Muse Spark Open(39),领先于 NVIDIA 的 Nemotron 3.5 Super VL(26),这三个模型均于本周发布。在所有开放权重模型中,它排名第十,落后 K2 Horizon(31)一分
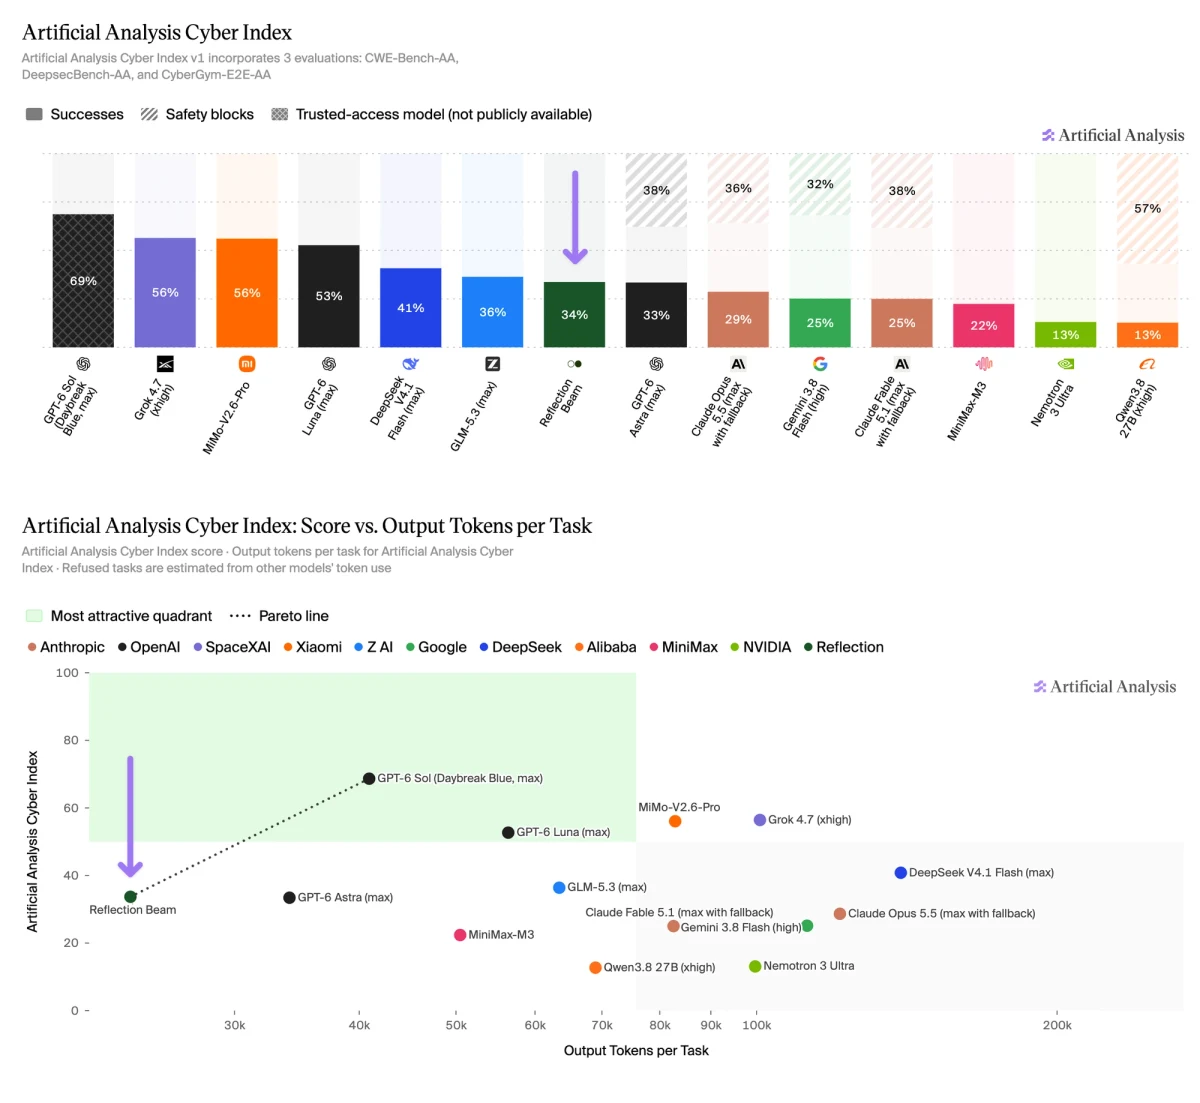
网络安全能力
Beam 在 Artificial Analysis 网络安全指数上完成了 34% 的任务,使其成为我们测试过的领先美国开放权重模型
得益于其令牌效率,它还处于网络安全指数与每任务输出令牌的前沿之上,与 GPT-6 Sol (Daybreak Blue) 并列
令牌效率极高
Beam 在每个智能指数任务中使用约 26k 输出令牌:约 19k 用于推理,约 7k 用于答案。其输出中只有 26% 用于最终答案,这是在 Intelligence Index v4.3 上测试的 219 个模型中第 28 低的占比
编程能力
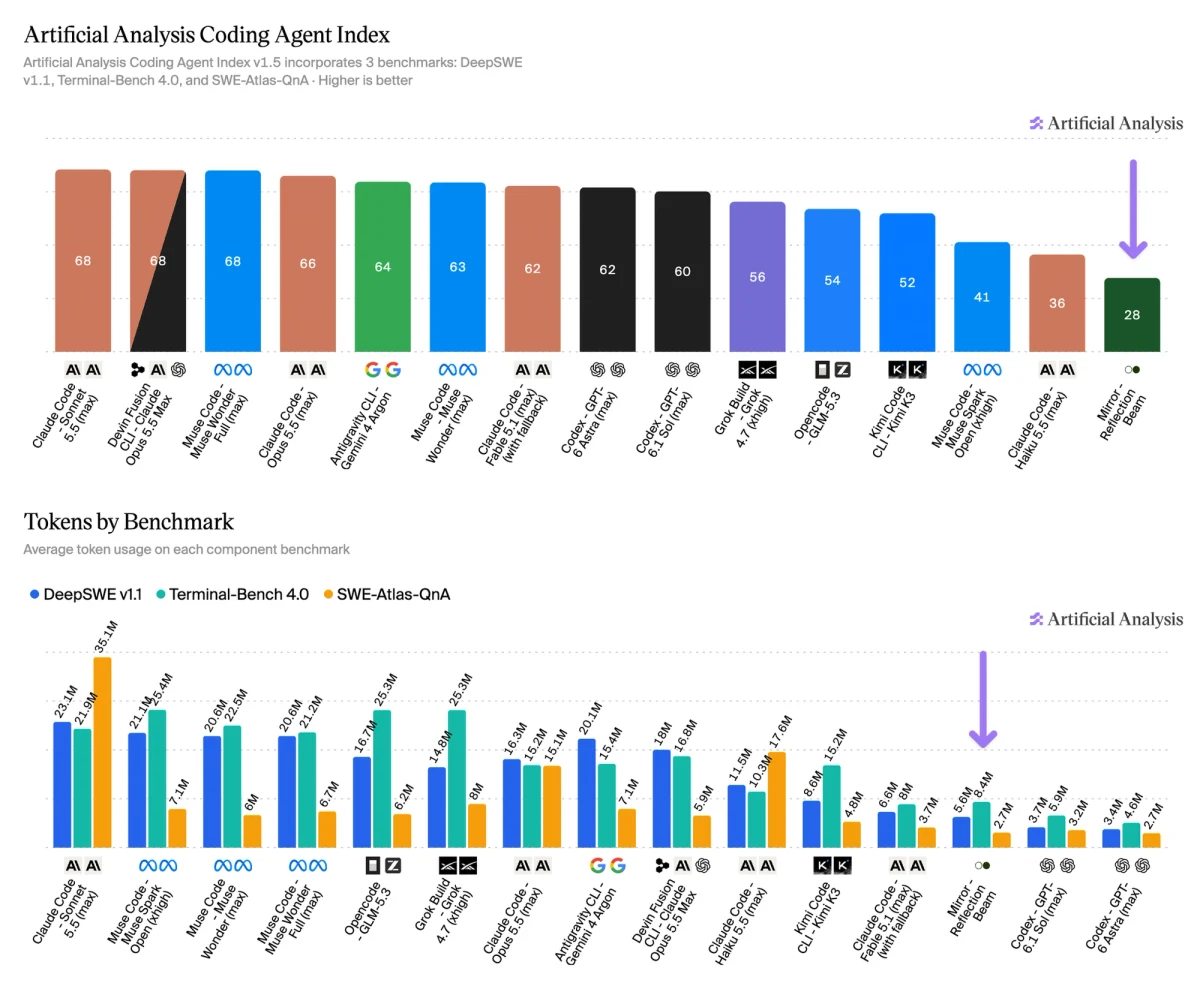
在 Reflection 的开源 CLI 框架 Mirror 中运行时,Beam 在 Artificial Analysis 编程智能体指数上得分为 28。它落后于下一组配置 Claude Code 搭配 Qwen3.8 Max(43)15 分,落后领先者(68)40 分。不过它非常节俭:只有 Codex 搭配 GPT-6 Astra 和 Codex 搭配 GPT-6.1 Sol 使用的令牌更少
智能指数组成部分
在智能指数的十项评估中,Beam 在 AutomationBench-AA(48.5%)和 CritPt(13.1%)上表现突出,其成绩是 K2 Horizon(4.6%)和 Qwen3.8 27B(5.4%)的两倍以上。它最弱的成绩出现在 Terminal-Bench 4.0(3.0%)和 AA-Briefcase(976 Elo)上
Beam 在 Artificial Analysis 页面上的完整详情 https://artificialanalysis.ai/models/reflection-beam