

谷歌的 Gemini 4 Argon 比数月来任何谷歌模型都更接近 AI 前沿
 Matthias Bastian
查看 Matthias Bastian 的 LinkedIn 个人主页
2026年10月16日
 谷歌
Google Deepmind 是第二个在 ARC-AGI-3 基准测试中突破 95% 的主要 AI 实验室。据 Epoch AI 称,测试结果在很大程度上取决于测试方法,而且 Argon 在数学和软件工程方面落后于竞争对手。
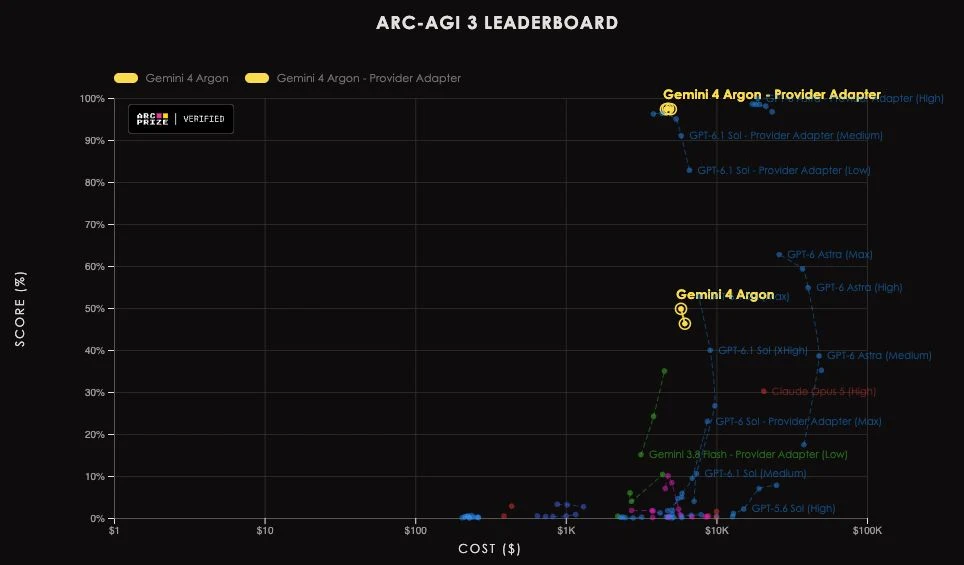
Google Deepmind 的新前沿模型 Gemini 4 Argon 使用“Provider Adapter Harness”在 ARC-AGI-3 上取得 97.5% 的成绩,成本为 4,800 美元,该测试设置使用了保留推理和上下文压缩等供应商特定功能。据 ARC Prize 称,谷歌现在是继 OpenAI 之后第二个在公认为最难的通用问题解决基准上突破 95% 大关的 AI 实验室。只有 GPT-6 Astra 得分更高,为 99.9%。
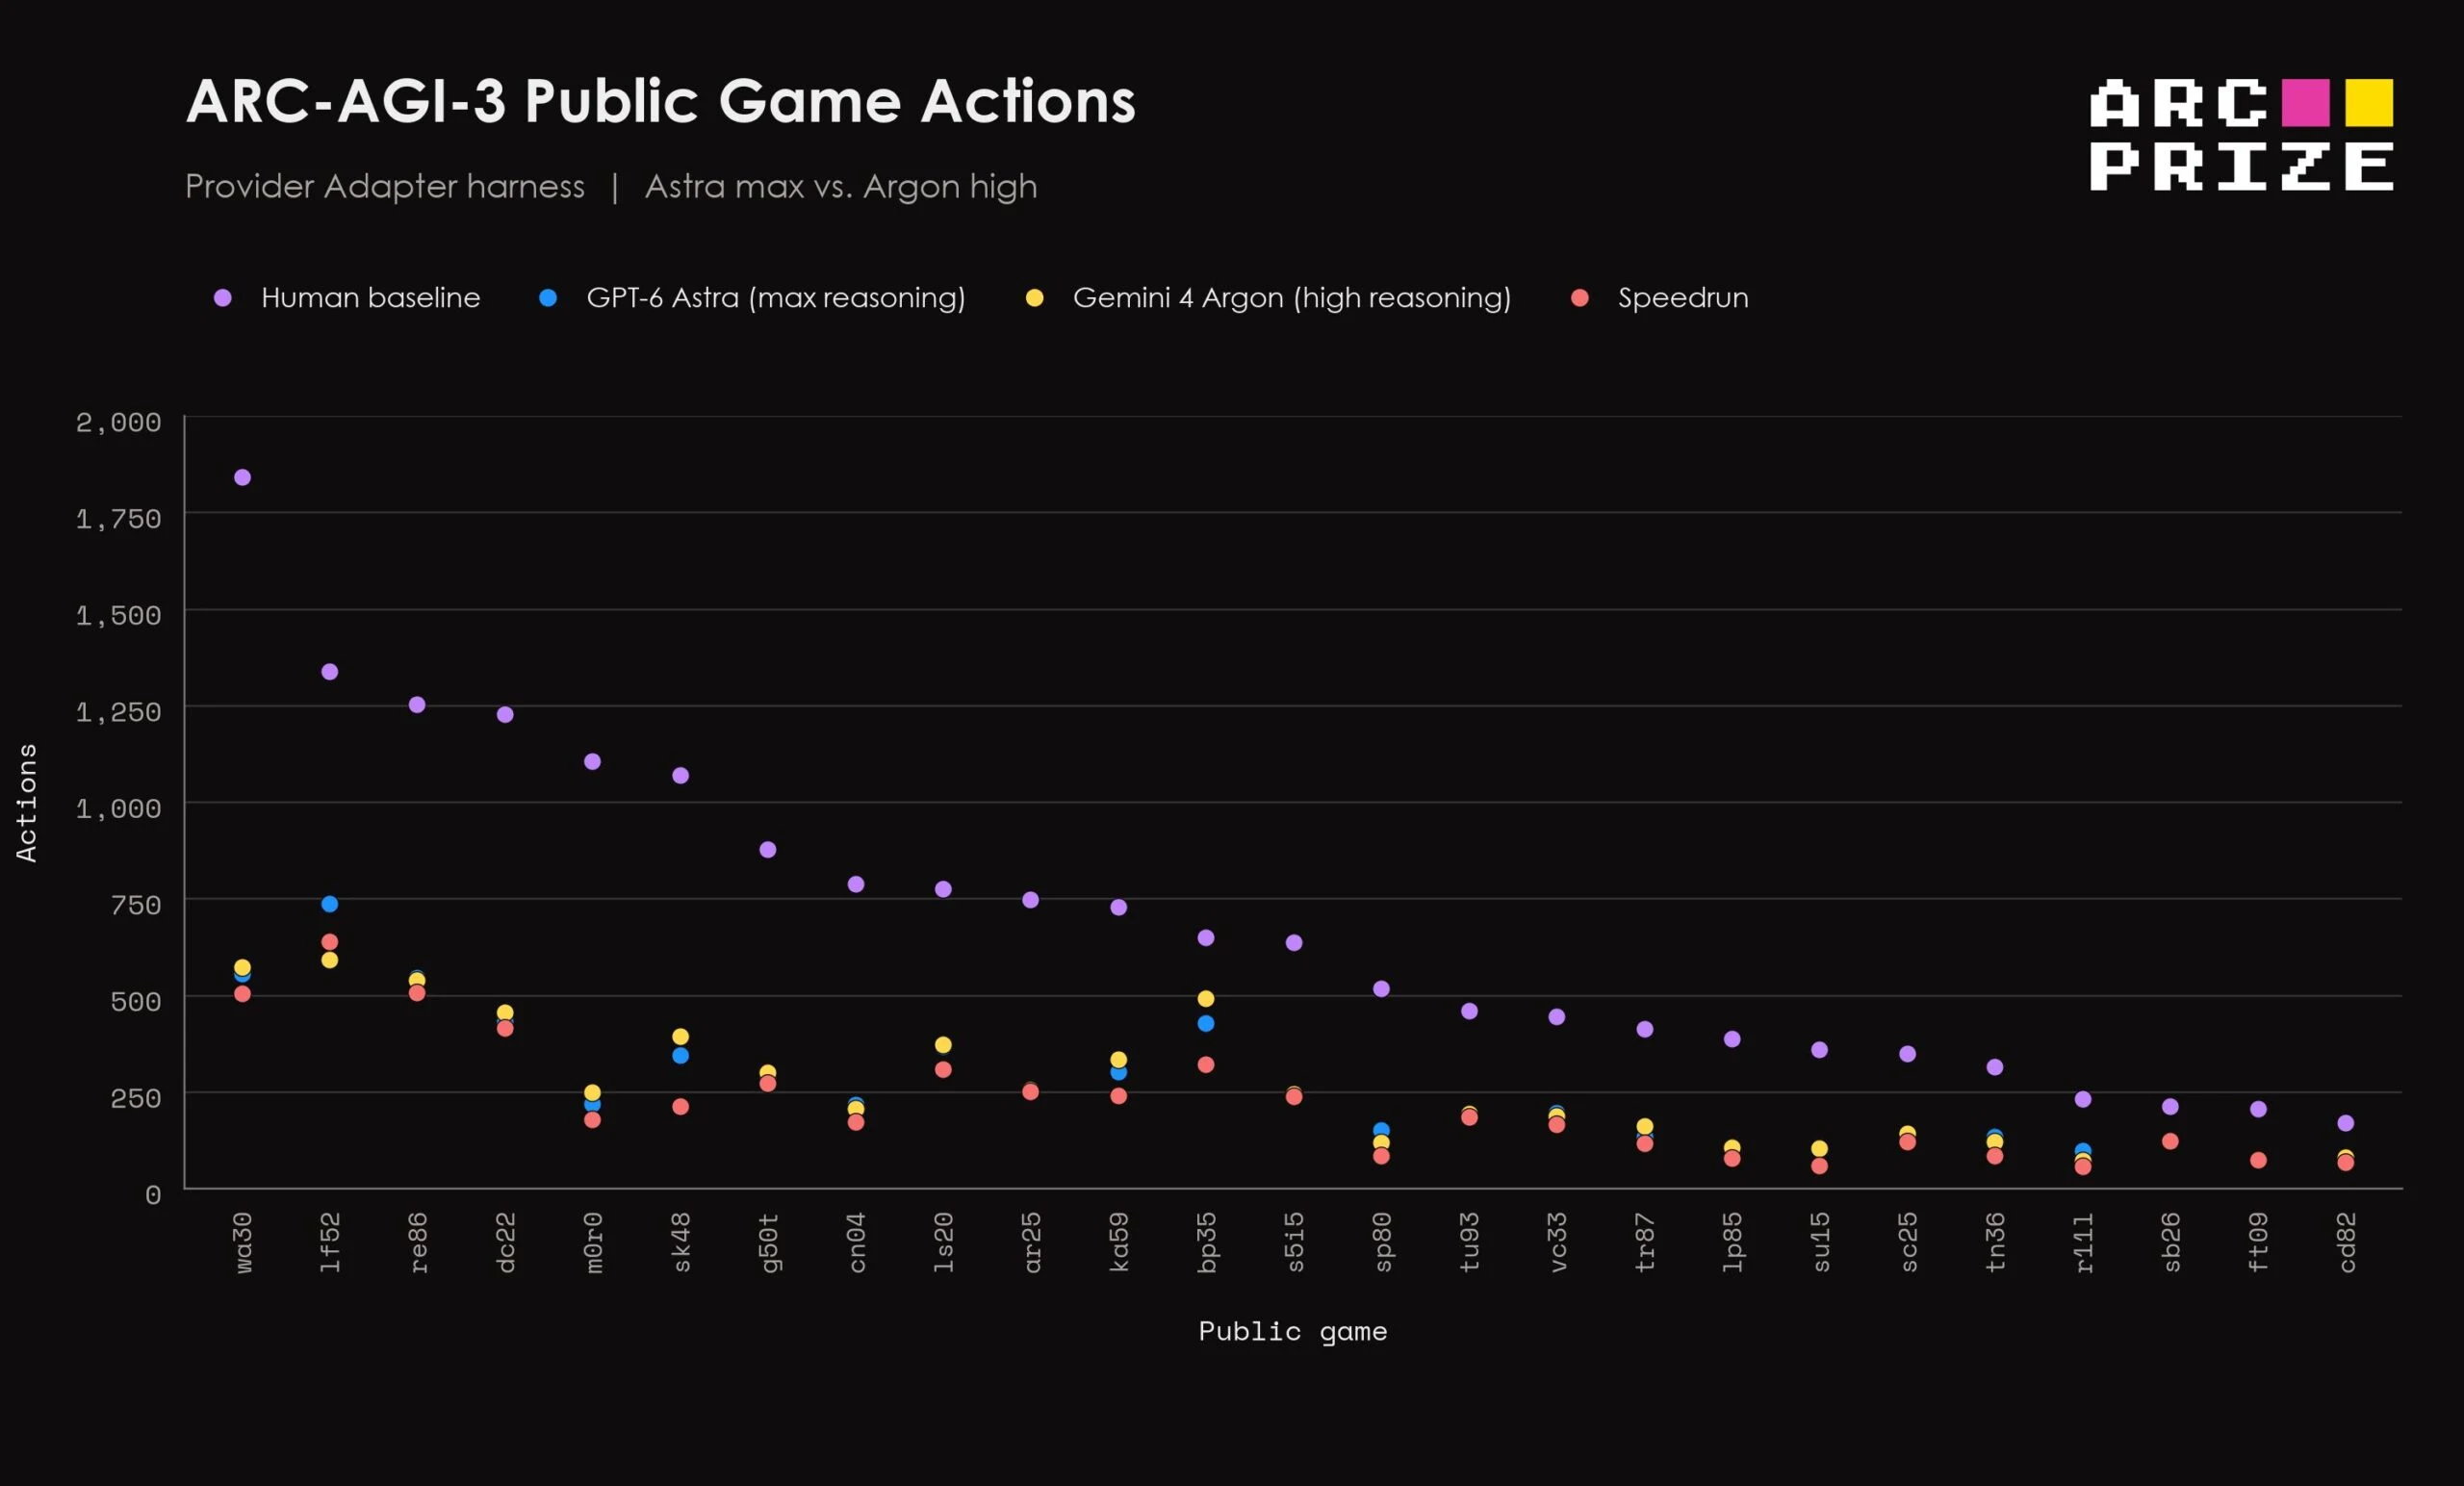
与 Astra 一样,Argon 在 25 个公开游戏中比人类基线少用 62% 的操作步骤。它在三个游戏中追平或打破了速通记录,并在另外六个游戏中与最佳时间相差不到 10%。在旧版本基准上,按照每百万输入 token 2 美元、每百万输出 token 10 美元的 introductory 价格,Argon 在 ARC-AGI-2 上得分为 91.3%(每任务 0.32 美元),在 ARC-AGI-1 上得分为 98.5%(每任务 0.16 美元)。
基准测试结果在很大程度上取决于测试设置
在只允许各轮之间进行简单笔记的“Standard Harness”中,Argon 在低推理档下得分为 49.8%,花费 5,800 美元。这一差距可追溯到 2026 年 7 月的一场争议,当时 OpenAI 的 GPT-5.6 Sol 曾利用两个 API 设置在 ARC-AGI-3 上击败 Claude Opus 5。Ad
GPT-5.6 Sol 在标准环境中仅得到 7.8%,该环境在每次操作后丢弃内部推理,并使用缺少较新 Claude API 功能的旧接口。这意味着 Claude 的测试条件与 GPT-5.6 不同。当使用 OpenAI 自己的 Responses API(包括“Retained Reasoning”和智能上下文“Compaction”)进行测试时,该模型跃升至 38.3%,击败了得分为 30.2% 的 Opus 5。OpenAI 辩称,基准测试总是同时衡量技术环境。ARC Prize 联合创始人 Francois Chollet 随后允许使用通用的、公开可用的 API 设置。
API 问题还导致 Argon 无法在 Standard Harness 中完成全部 55 个游戏, 据测试人员称。在低推理档下,系统完成了 42 个游戏(49.8%),中等档为 46 个游戏(46.3%)。在最高档,它仅完成了 19 个游戏,因此 ARC Prize 未公布分数。已报告的结果仍然通过纳入中断运行的部分得分覆盖了全部 55 个游戏。
Argon 缩小了差距,但在数学和编程方面落后
研究机构 Epoch AI 也追踪了谷歌的进展。Argon 在 Epoch 能力指数(ECI)上得分为 165 分 ,与 Fable 5.1 并列,仅落后于 Opus 5.5(167 分)和 GPT-6 Astra(166 分)。ECI 将 50 多个基准测试汇总为一个单一的能力量表,类似于 Artificial Analysis 构建其主评分的方式。
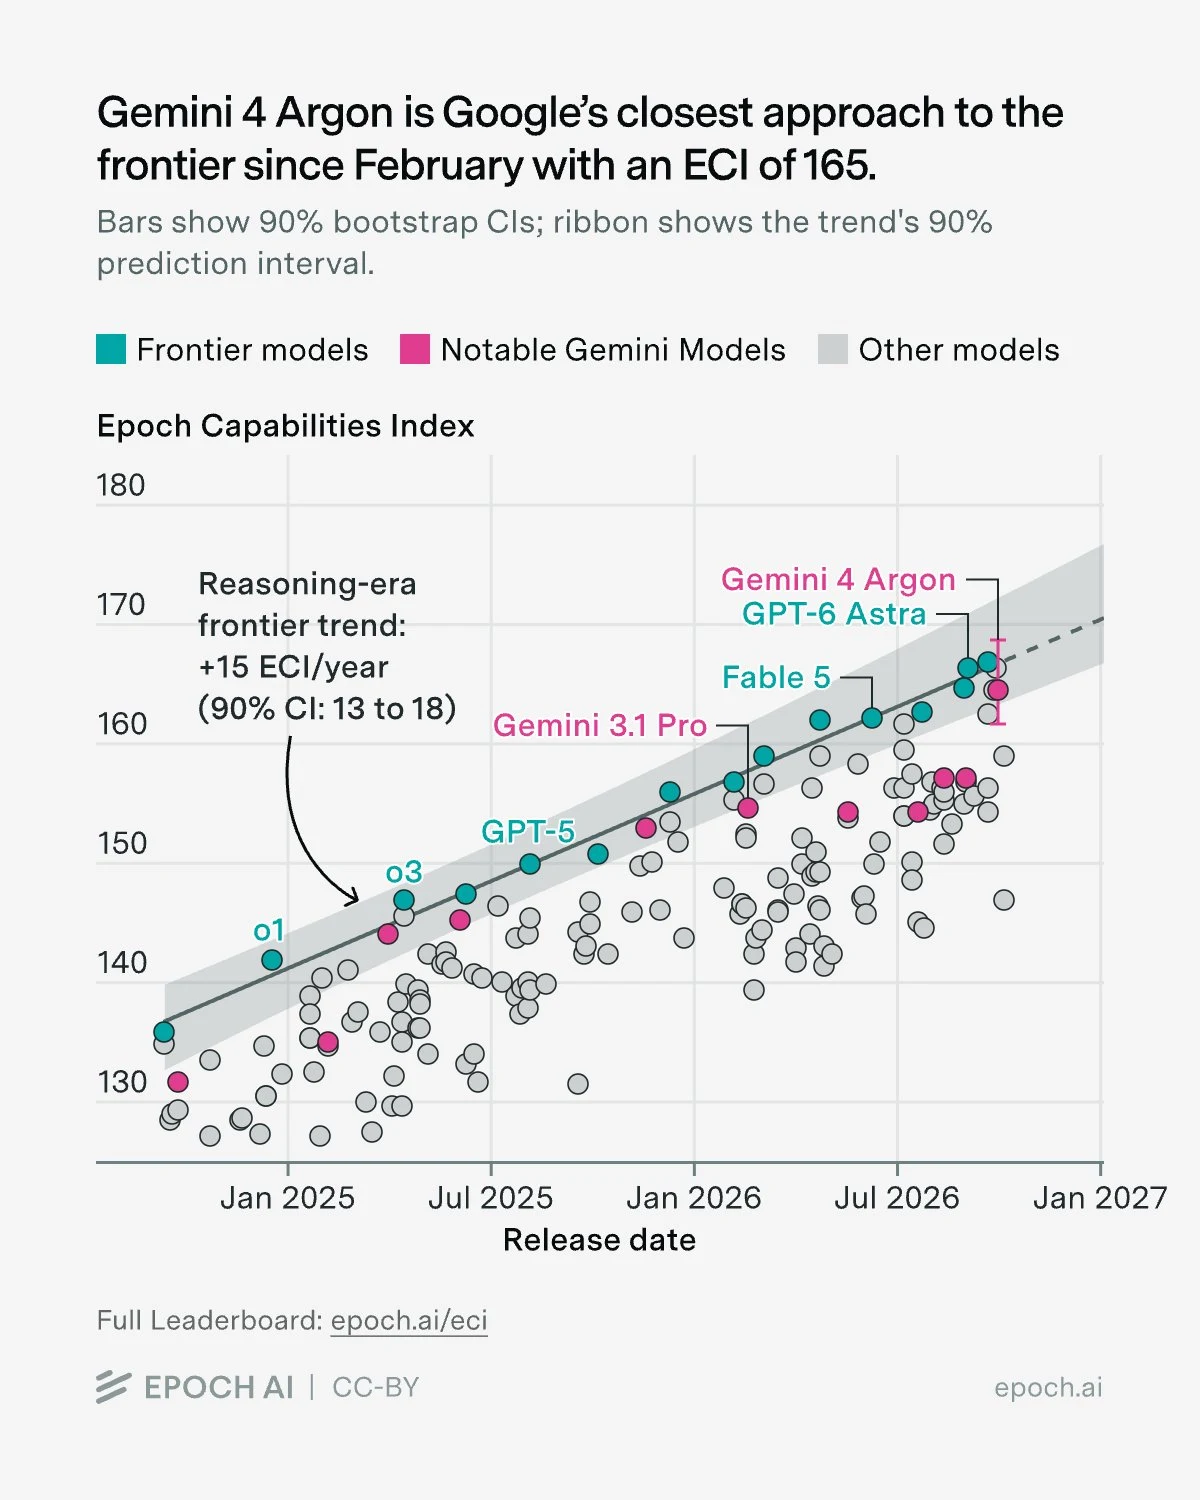
Argon 远超 Gemini 3.8 Flash(157 分),使谷歌自 2 月的 Gemini 3.1 Pro 以来首次如此接近榜首。 Artificial Analysis 和 Vals.ai 此前已确认这一趋势。Ad
不过,性能因领域而异。据 Epoch AI称,Argon 在多项知识、智能体和视觉基准测试中领先,但早期估计显示其在 Math ECI 上排名第八,在软件工程指数(SWE ECI)上排名第六。
AI News Without the Hype – Curated by Humans
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻通讯、每年六期独家 "AI Radar" 前沿报告、完整存档访问权限以及评论区的访问权限。
来源: EpochAI | ARC Prize