
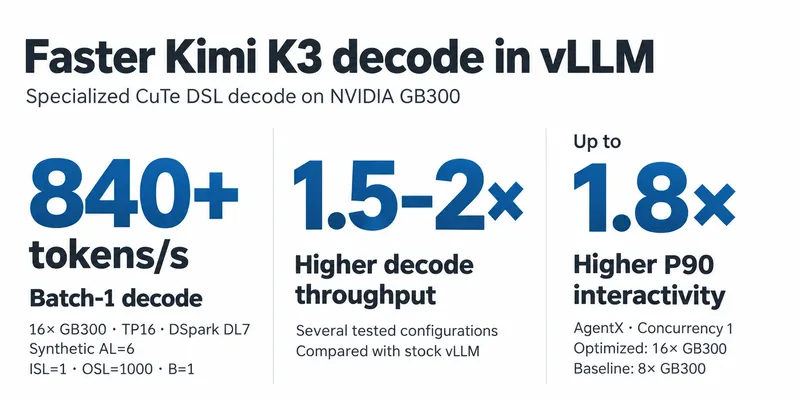
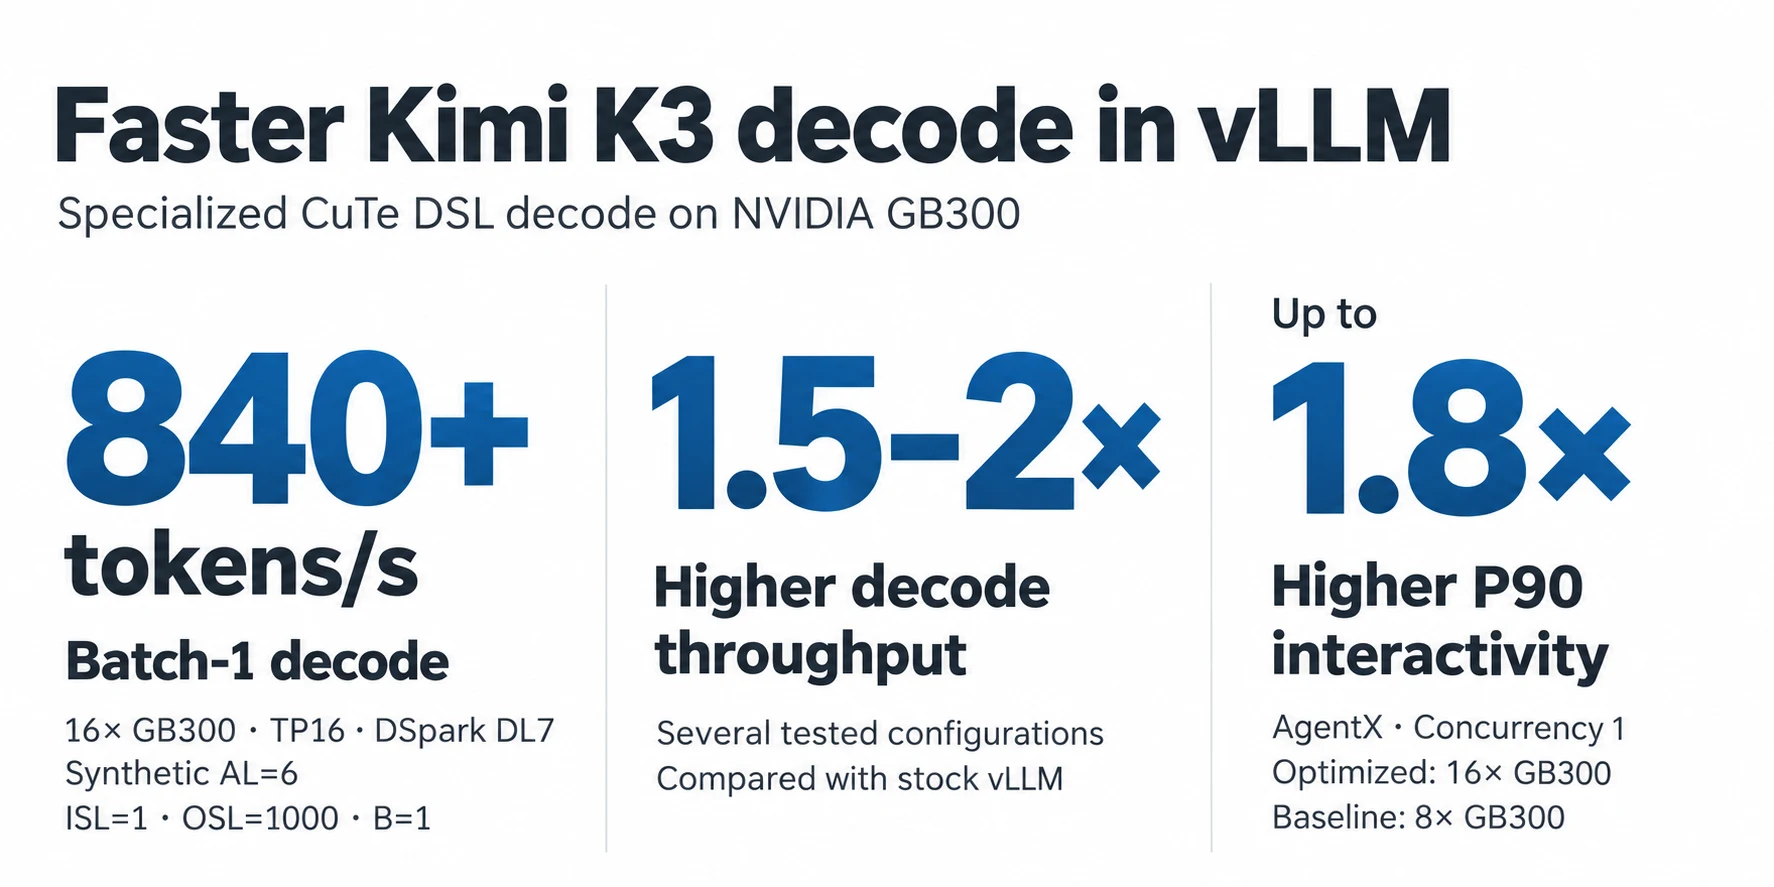
编码智能体现在可以协助完成模型优化中一些最困难的部分:编写复杂的 GPU 内核、执行跨算子融合、让计算与通信重叠,以及在不同 batch size 和 GPU 配置下调优执行。对于 Kimi K3,我们使用智能体辅助开发,在 NVIDIA GB300 上构建了统一的 CuTe DSL decode 路径,覆盖 attention、MoE 以及 8 或 16 GPU 间的通信。这些优化带来了超过 840 tokens/s 在使用 DSpark(合成 AL=6)于 16 块 NVIDIA GB300 GPU 上以 batch 1 进行, 1.5–2× 在多个测试配置中实现了更高的解码吞吐量,且最高可达 1.8× 在 AgentX 工作负载上更高的 P90 交互性。
面向智能体优化的推理代码的发展速度已超出我们的审查与维护工作流程。人工审查流程要求理解每个内核的每一行代码、梳理潜在问题并测试每种受支持的配置,这是非常耗时的 工作。另一方面,如果我们省略这项工作,就有可能交付存在缺陷的软件,导致其在生产环境中出现故障。
实现这两个目标的路径清晰可见:我们需要改变组织性能工作的方式。在进行智能体优化的同时,我们需要设计能够自动验证可靠性与性能的系统,并且我们需要对软件进行结构化设计,从设计上强制实现隔离与风险最小化。
拟议的 快速通道模型优化 RFC 为这一方法提供了基础。我们的指导原则是在控制风险的同时减少审查负担。为此,我们: 风险。为了实现这一目标,我们:
- 隔离变更。 将优化限制在模型代码之内。
- 限定范围,保留核心特性。 定义支持的硬件和工作负载,但保留生产级 LLM 使用所必需的特性。
- 系统地验证正确性。 运行一套成熟的性能与正确性基准测试,以确保完整性和可靠性,并在所有支持的配置上实现严格的性能提升。
- 规模化验证。 让贡献者在请求维护者关注之前,先在自己的 GPU 上运行标准评估并分享可复现的结果。
Kimi K3 是我们按照这一方法做出的首个贡献。本文将介绍我们如何优化 Kimi K3、如何建立发布和维护这些优化所需的信心,以及性能结果。
目录
第 1 部分:优化 Kimi K3
本贡献为 Kimi K3 引入了一条新的解码路径,它将几乎所有操作融合并替换为定制的 CuTe DSL 内核,这些内核针对特定子问题进行了调优。其目标是配备 8 或 16 块 GPU 的 NVIDIA Blackwell GPU,支持 1 到 64 的解码批次,并可选针对长上下文的解码上下文并行。这些 GPU 共享一个支持多播的 NVLink 域。 更多细节请参阅 PR.
1. 针对工作负载调优形状
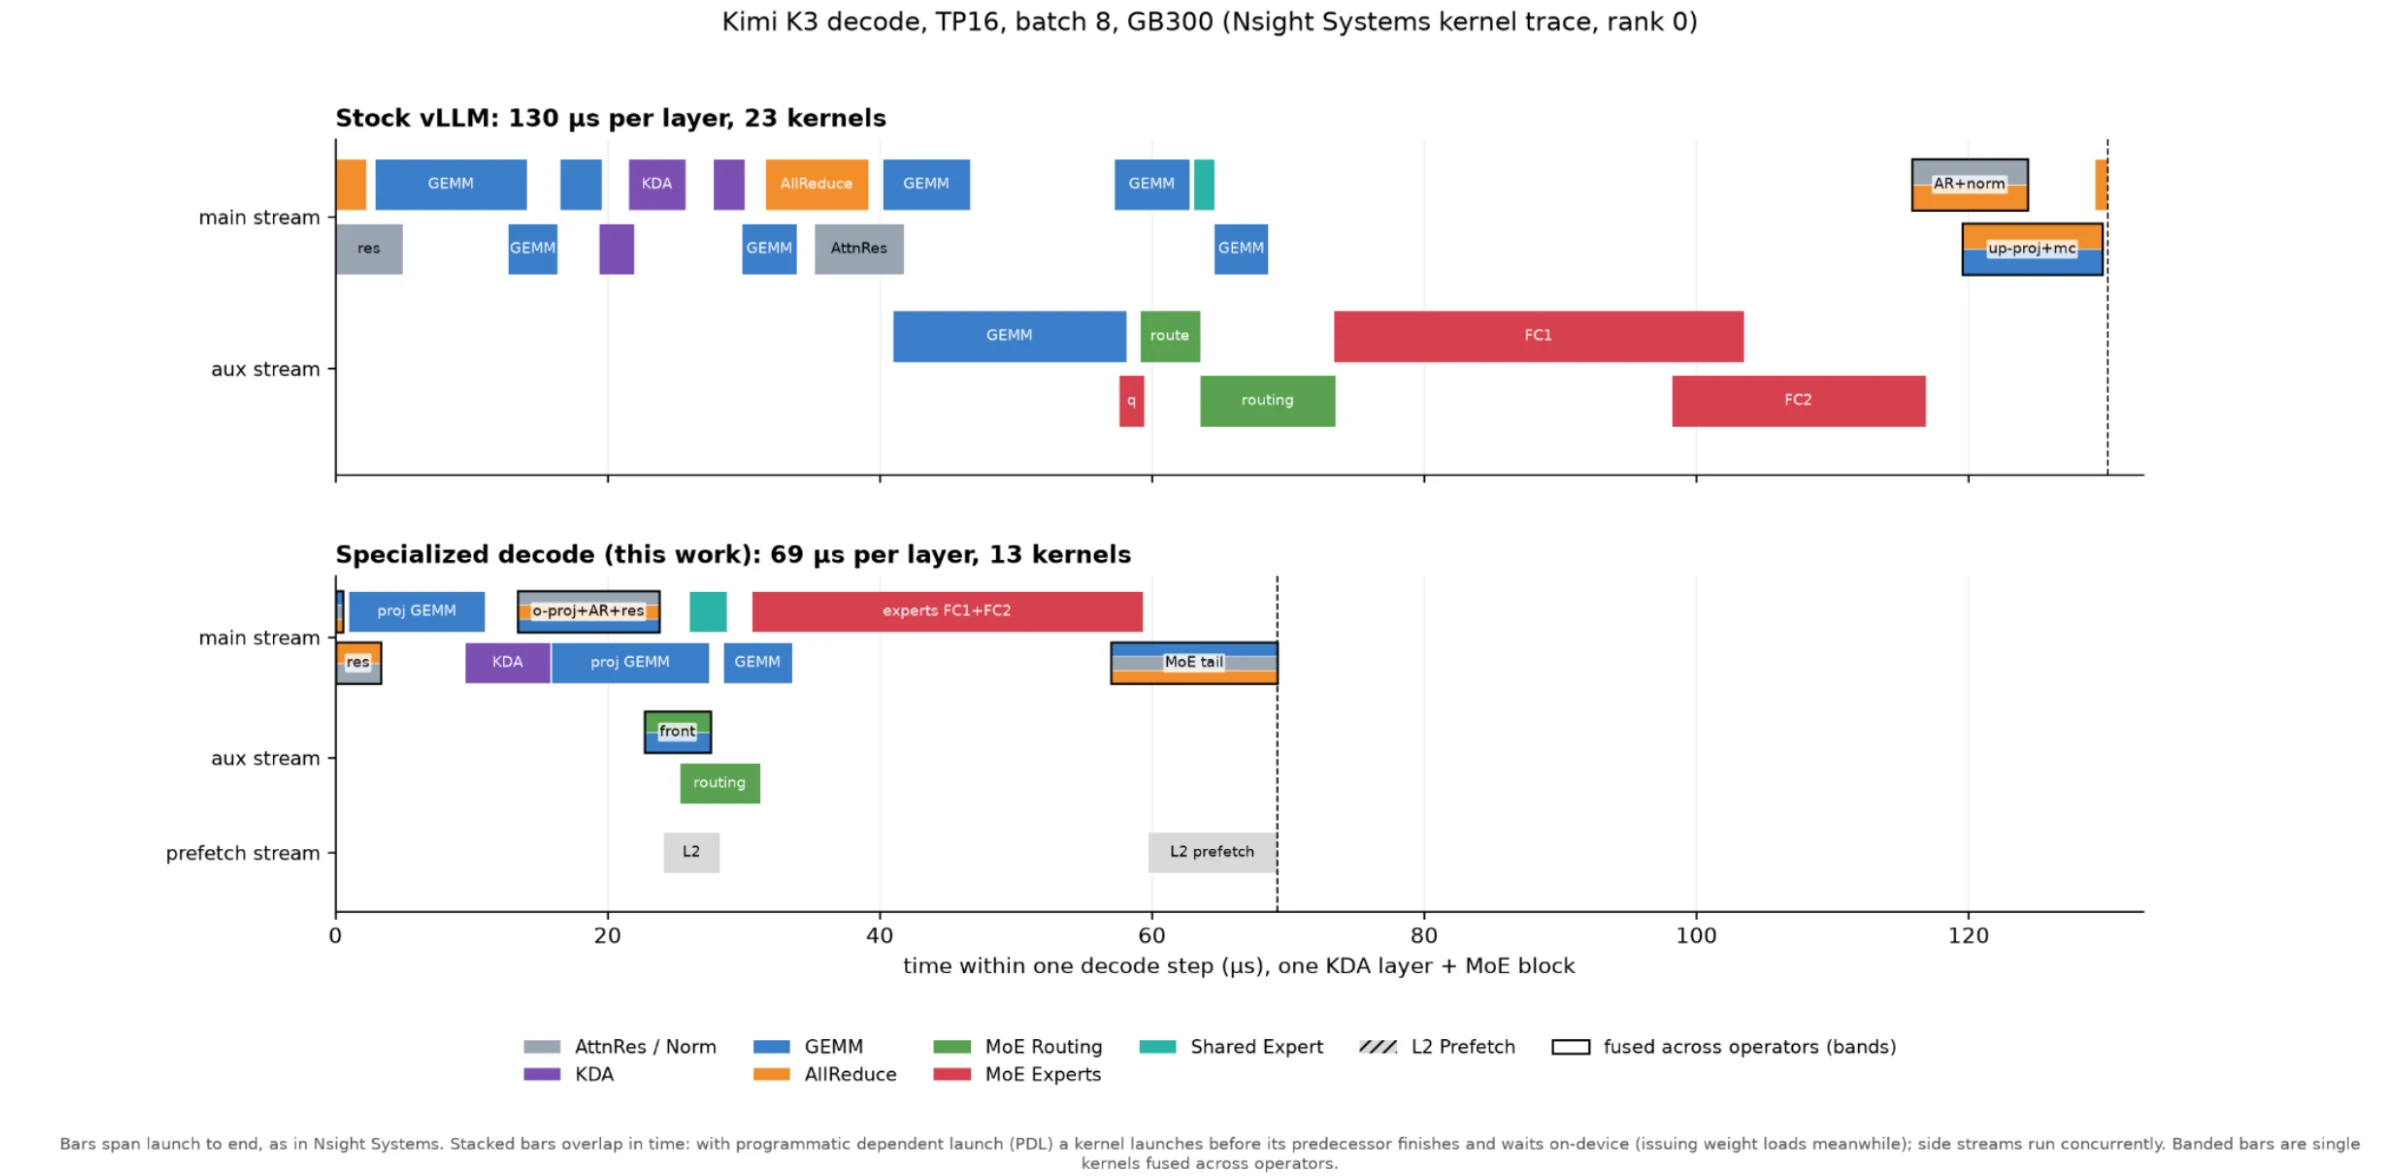
不同的批次大小需要不同的内核选择。对于注意力输入投影,我们在批次大小 1–2 时使用专用的小矩阵内核,在更大批次时使用 split-K 内核,后者将矩阵乘法分配到更多 GPU 工作节点上。所有这些投影都经过精细调优,以启动尺寸合适的内核,充分 利用 GPU 资源,并尽可能多地重叠内存读取/通信与计算工作。
KDA 也使用了优化的 CuTe DSL 解码内核,其调度针对每块 GPU 上的批次大小和注意力头数量进行了调优。
对于长上下文,解码上下文并行(DCP)将 KV 缓存拆分到多块 GPU 上。每块 GPU 对其本地部分计算注意力,一个调优过的融合内核将部分结果与 v-proj 和门控结合起来。
2. 重叠计算与通信
我们将注意力输出投影直接融合到其 all-reduce 以及随后的注意力残差计算中。GPU 内核将部分结果发布到 NVLink 可访问的缓冲区中,接收内核将其合并并继续计算。一些小批次配置将生产者和消费者融合到一个内核中。数据交换采用无栅栏(fence-less)的方式完成,开销极小。
在更大的批次下,该实现会切换到一个 两级减速: GPU 首先合并各自被分配的输出部分,然后分发结果。这减少了 GPU 之间的数据传输。
3. 改进 MoE 调度与重叠
虽然专家们已经在使用张量并行,但基线方案会在每个GPU上计算完整的路由器得分和潜在输入投影。我们将这些计算拆分到各个TP ranks上,并把每个rank的份额合并为一次矩阵乘法。GPU通过NVLink交换结果。这减少了在专家执行开始之前的重复计算、权重读取和内核启动。
共享专家在单独的流上运行。其工作与路由或路由专家计算重叠,具体取决于配置。该调度控制每个操作使用多少 GPU 资源,并经过仔细调优,以确保均衡的并行性而不产生争用。详情见 experts_runtime.
4. 将即将使用的权重预取到缓存中
在小批量推理中,我们常常受内存限制:受到从内存加载权重速度的制约。某些阶段无法充分利用可用的内存带宽,例如通信:在这些工作进行期间,我们可以在一个辅助流上运行专用内核,以确保一旦通信完成,下一个操作的权重将具有更高的缓存命中率。
第2部分:快速而负责任地行动
Kimi K3只是最初的例子之一。我们相信社区可以共同努力,将更多模型、GPU和工作负载推向光速。
不同的贡献者/智能体会发现不同的机会:更完善的沟通计划,或是对某个特定部署有帮助的融合方案。但如果每一份贡献都带着不同的假设、不完整的测试,以及难以复现的基准测试,那么验证和维护工作很快就会成为瓶颈,否则我们就有发布损坏代码的风险。我们需要一种共同的方式,把这些想法转化为用户在其长期生产用例中可以信赖的改进。
这改变了我们对智能体交付成果的要求。我们应该对代码智能体产出的测试、验证和需求设定明确的期望。智能体将构建测试、运行全面的评估和基准测试、调查失败原因,并记录优化生效的条件。人类评审者仍然需要判断设计和证据,但他们可以从高层次抽象入手,而不必进行逐行代码审查。
基于拟议的 快速通道 RFC我们将这项工作围绕四个原则来组织。
1. 隔离变更
将模型特定的优化保留在模型的代码之内。这样可以使受影响的代码路径更容易被识别,并减少审查者需要考虑的影响范围。
隔离还必须在运行时保持。审查者应能够追踪优化路径何时被选中、它改变了哪些状态,以及执行如何返回到标准路径。
这一约束 做 排除了一些优化:输入准备、采样和KV cache管理可能带来开销,而这种隔离方法将这些开销排除在外。这是设计使然,且在很大程度上是有意为之:这些组件在大多数vLLM部署中都是共享的,为特定工作负载而改动它们可能会破坏数十个其他稳定的vLLM配置。对这些组件的改进工作很重要,应当比快速通道所允许的程度更紧密地让核心维护者参与其中。
2. 限定范围,但保留用户功能
一项优化并不需要改善每一个部署环境才有用。它可以针对特定的GPU、并行设置或某个批大小范围。清晰的边界使工作更容易调优,并为我们提供一组明确的配置来验证。
对于K3,初始硬件验证涵盖GB300的TP8和TP16、最高64的decode批、采用各种draft长度的投机解码,以及单个NVLink域内的decode上下文并行配置。
这些边界描述了优化适用的范围,但并不意味着削减“功能覆盖”。生产部署需要使端点真正可用的基础功能。诸如完整上下文服务、温度采样和结构化输出等功能不能被“优化掉”或“可选关闭”,它们是一等的服务功能,应与kernel形状和数值检查一起纳入验证计划。
3. 验证正确性
内核测试和模型评估回答的是不同的问题。内核测试检查各种形状和输入值下的数值结果。模型评估检查完整的执行路径是否保持了模型的回答。两者我们都需要。
测试必须真正执行被修改的代码。一个小批量的优化需要在小批量下进行评估。一个attention内核的修改需要长上下文的覆盖。悄悄使用标准路径的测试几乎无法为优化提供证据,这是一个常见的陷阱。
K3的开发说明了这一点为何重要。我们的审计发现编译器将激活值的读取移动到了同步等待之前。修复方法是将该类加载限制为只用于静态权重。这类错误可以通过简单的功能检查而存活下来,因此需要有针对性的调查。
此外,诸如 MRCR 和 AIME25 之类的长上下文和长生成评测,暴露出了注意力与通信内核中对数值敏感的问题,而在使用模拟输入和/或一致的启动时机的独立内核测试中,这些问题无法复现。
4. 广泛地检查性能
一个亮眼的加速只是起点。我们还需要了解这一变更在其影响的所有工作负载中的表现。这意味着要扫描批量大小、上下文长度以及支持的并行配置。MoE 测量应包含真实提示,因为专家选择会影响读取哪些权重以及可以复用多少工作。纯解码结果也应与混合预填充和解码的工作负载区分开。
可靠的验证同样需要 GPU 时间。相关的 Bring-Your-Own-GPU evaluation RFC 提出了标准评估镜像,贡献者可以在自己的硬件上运行。可复现的结果包以及与 GitHub PR 关联的提交将使证据更易于获取。分级评估和共享社区算力将有助于扩大覆盖范围,同时管理 GPU 需求并减轻项目资助的 CI 的压力。
第 3 部分:性能深度剖析
使用 DSpark 的解码性能
在 DSpark 下,Kimi K3 在受控的 AL=6 基准测试中,于 16 块 NVIDIA GB300 GPU 上达到 842 tokens per second on 16 NVIDIA GB300 GPUs 在受控的 AL=6 基准测试中。也就是说 1.73× 。 完整结果表请参阅 PR。
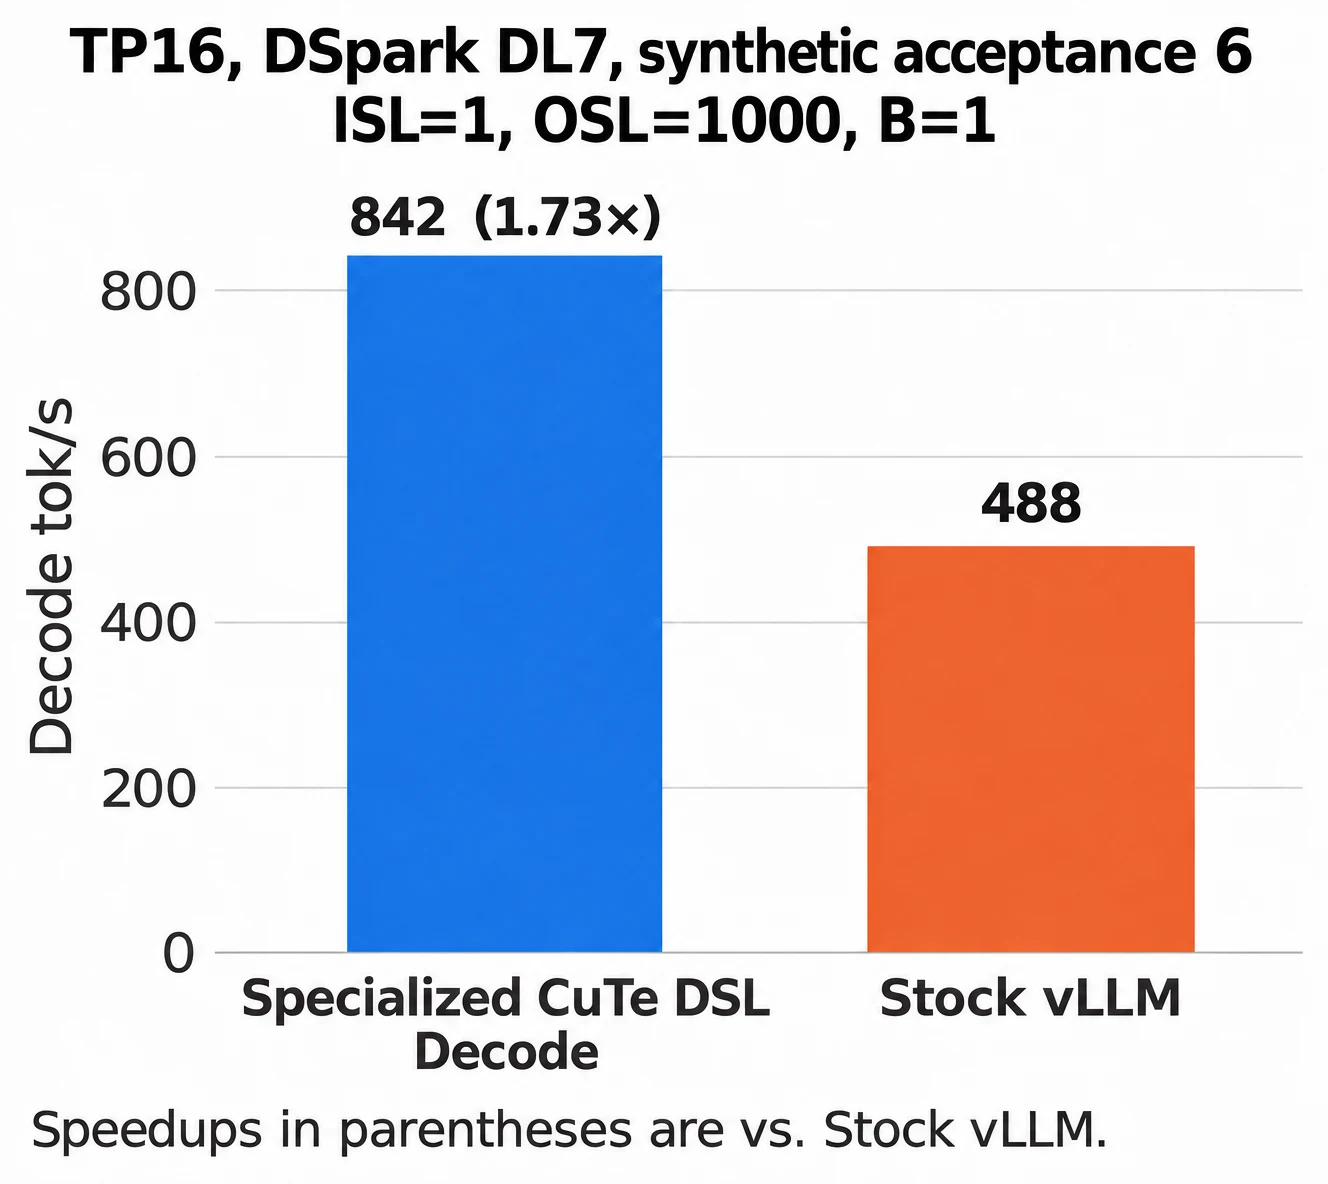
配置:TP16,DSpark 使用 7 个草稿 token,合成接受长度为 6,DL=7,ISL=1,OSL=1k,批量大小为 1。TPS 衡量的是聚合解码吞吐量,不包括预填充。
不使用投机解码的解码性能
改进覆盖了整个测试批量范围。TP16 在批量 16–64 下保持 在批次 16–64 时获得 1.62–1.71× 的增益,而 TP8 在相同范围内提供 1.31–1.43× 。
| 批量大小 | TP8 tokens/s | TP8 加速比 | TP16 tokens/s | TP16 加速比 |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
无投机解码。吞吐量针对整个 TP 组。
在 AgentX 上的改进
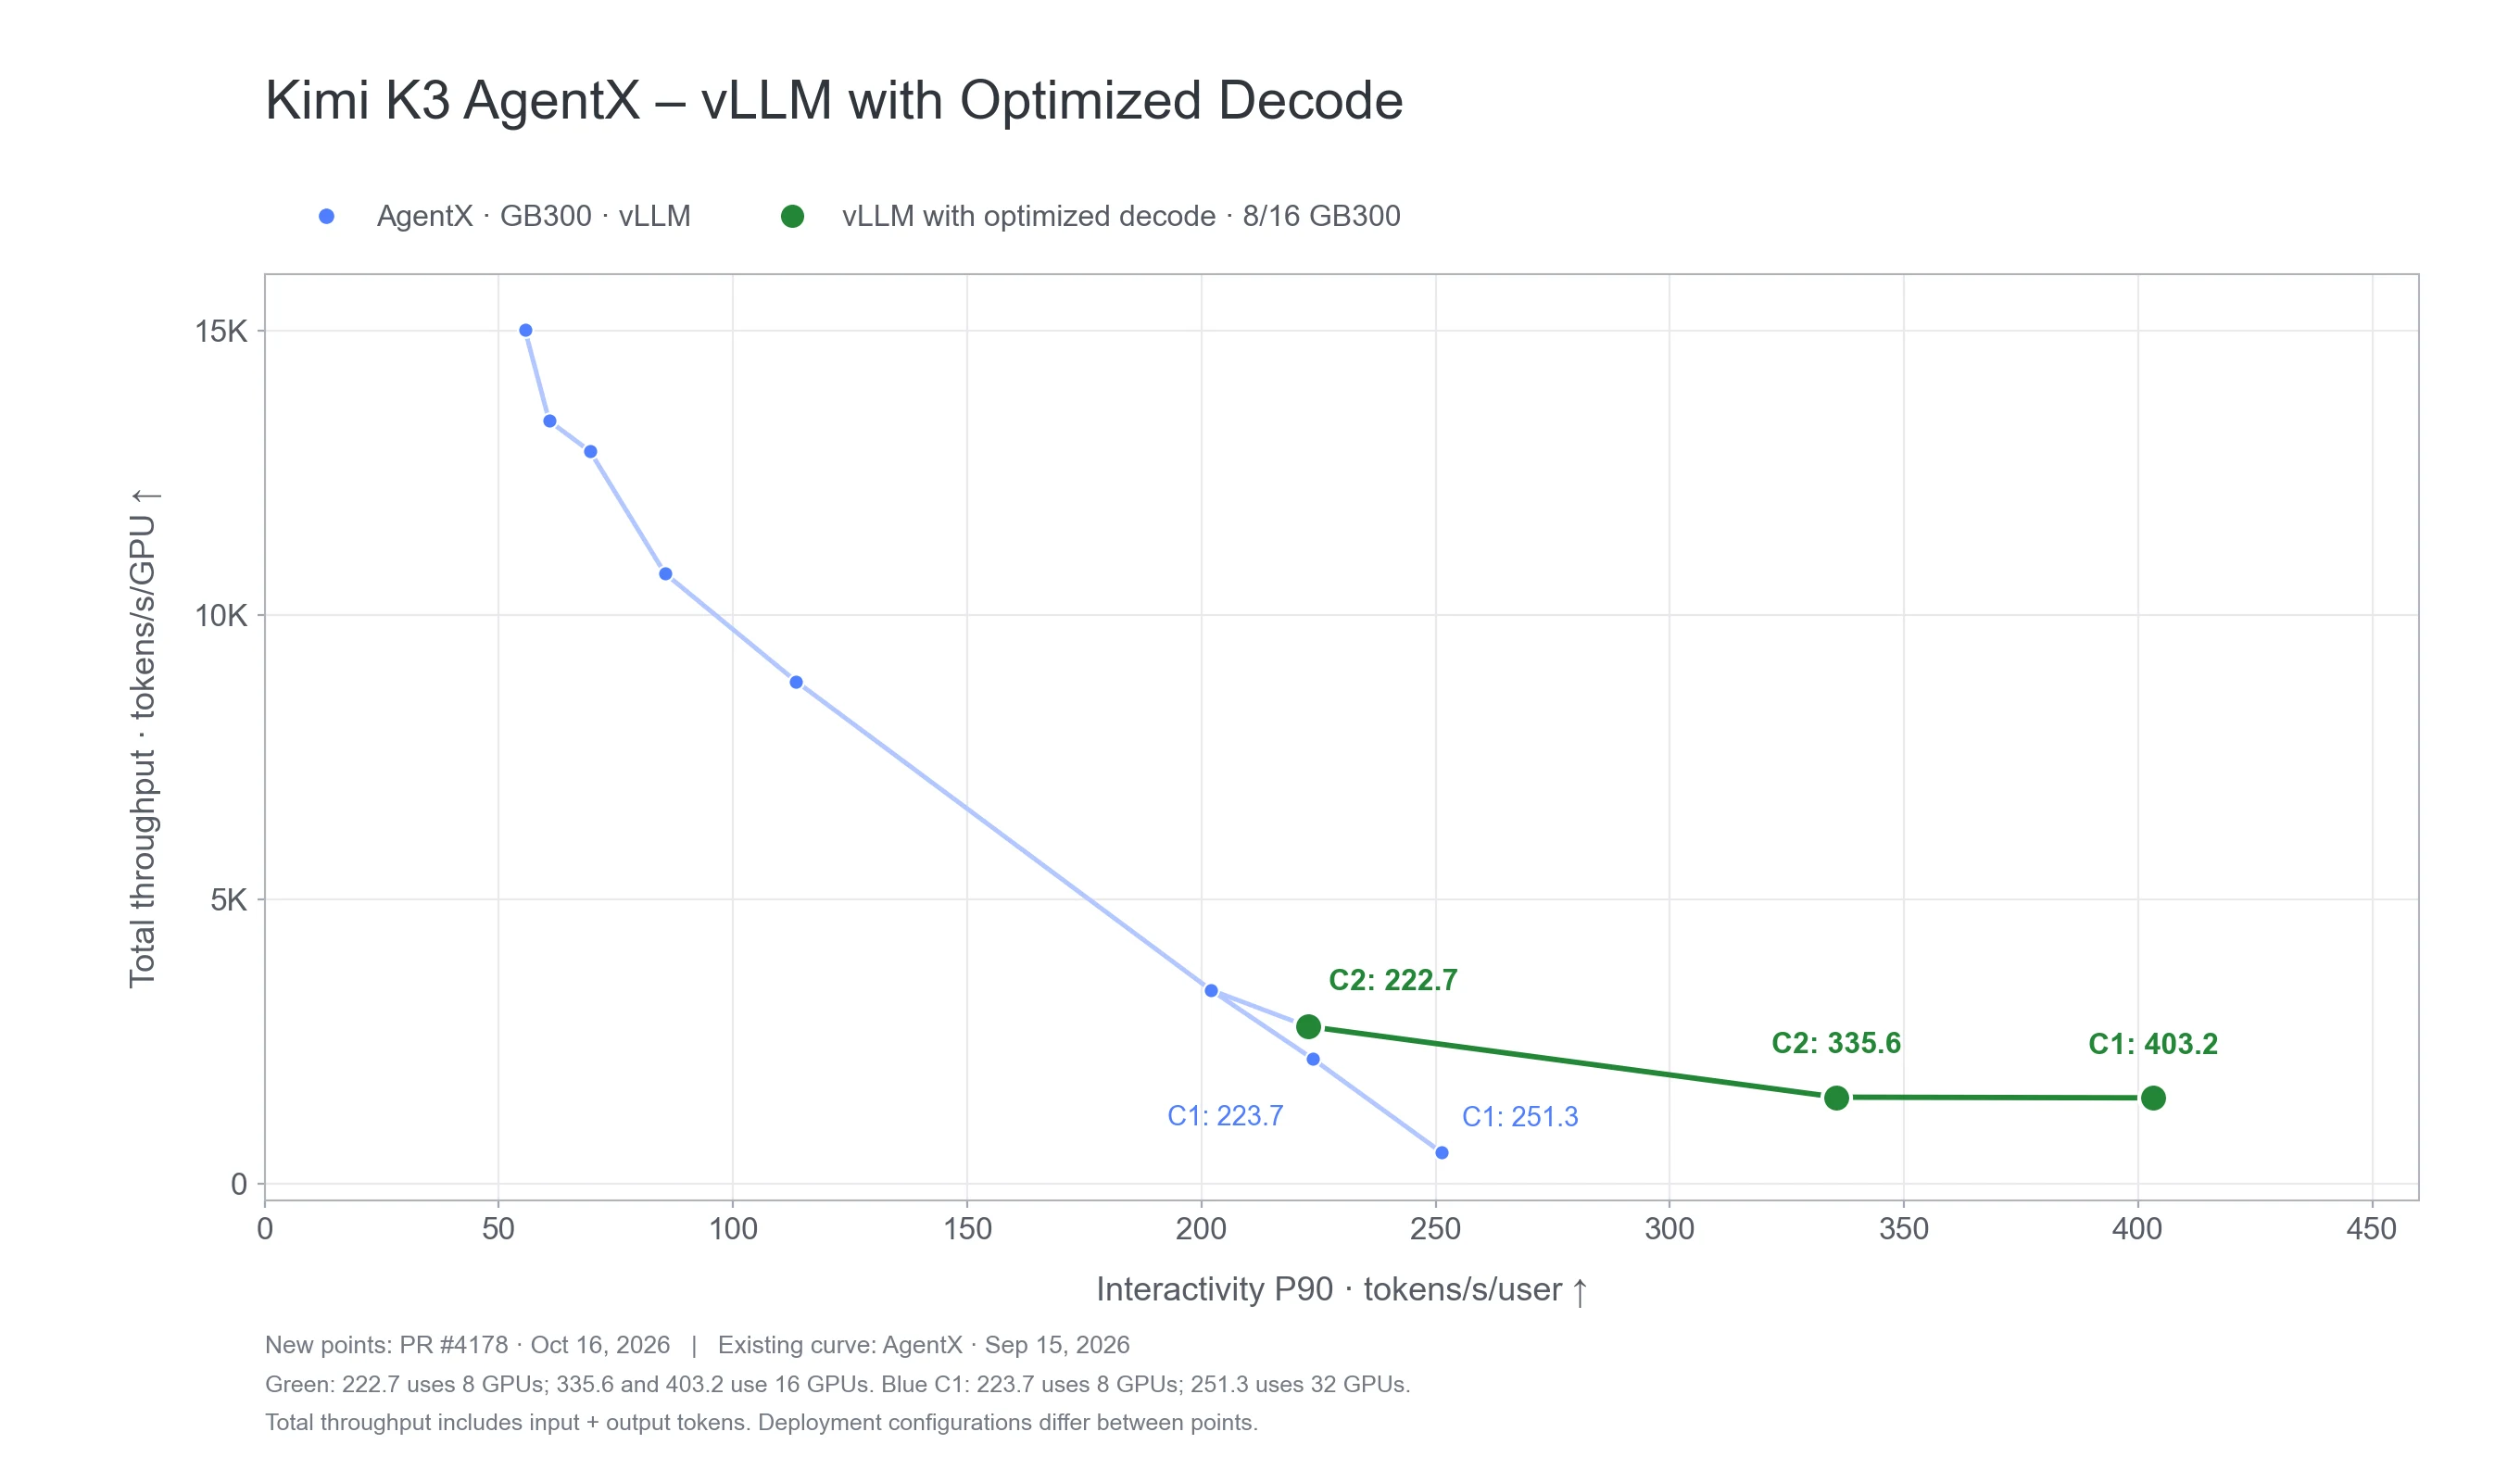
我们优化后的 Kimi K3 实现在 AgentX 上并发为 1 时还提供了 1.8× 更高的 P90 交互性 在 AgentX 上并发为 1 时: 403.2 对比 223.7 tokens/s/user。这将16块GB300 GPU上的优化运行结果与早前在8块GB300 GPU上的vLLM结果进行了比较。
AgentX 重放来自真实编码智能体会话的流量模式,包括长上下文、多轮对话、工具暂停、并行子智能体以及KV缓存复用。它在保留这些工作负载模式的同时,用合成文本替换私有内容,从而在真实智能体流量下测试服务系统。 AgentX 方法论.
下一步
对于 DeepSeek-V4.1-Flash, #61868 遵循了 K3 的设计模式:在同一个可选开启的 decode_backend: latency_specialized 开关之后,该实现还支持最多64个并发请求、针对prefill和混合批次的无缝回退,以及投机解码。该执行器不是去追逐单一热点,而是削减内核和主机侧工作:它在每个子层边界融合 all-reduce + mHC,用为低延迟构建的 CuTe DSL 内核替代大批次 MoE 和 GEMM,对索引器的工作进行去重和分片,并将原版 vLLM 在 CPU 上急切执行的每步工作改为以 CUDA graph 方式重放。
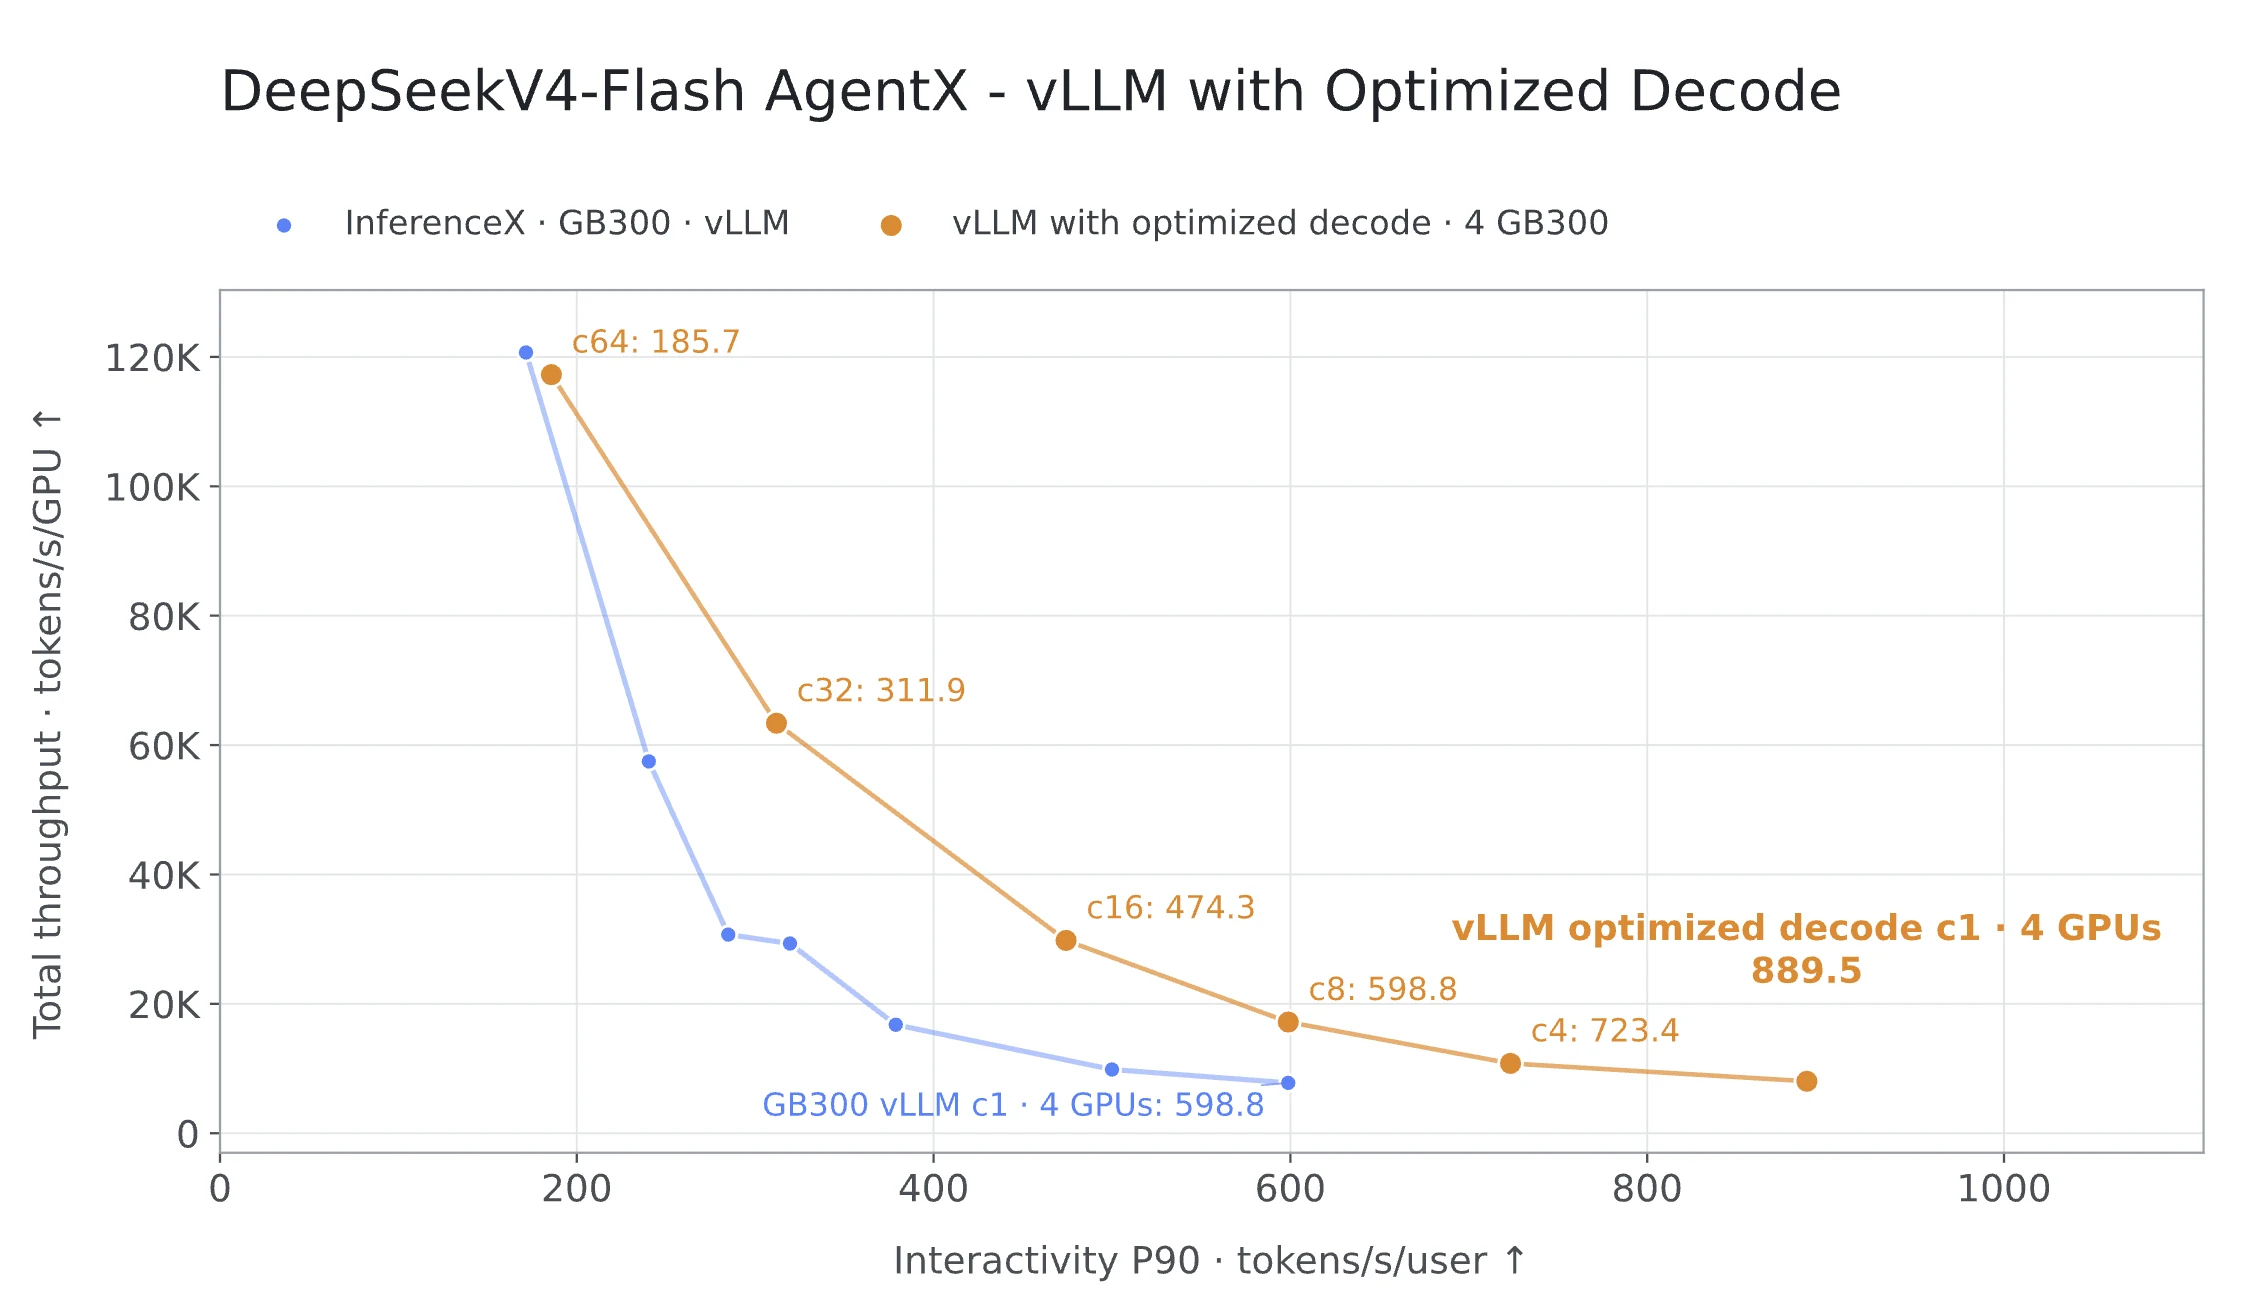
在 Meta 的 Muse Spark Open 发布后的两天内,我们的早期结果已超过 每用户每秒950个token,使用七个草稿token(K=7),接受长度为六(AL=6)。更多优化正在进行中。
我们也在发布一个类似的机制,用于在低并发场景下优化 GLM5.3 的解码延迟。我们将在后续文章中分享其优化细节和性能结果。
对于每一项贡献,我们将继续专注于具体的性能提升、生产特性支持,以及可复现的正确性和性能检查。
致谢
我们要感谢 Rohan Varma(NVIDIA)和 Alex Steiner(NVIDIA)对本工作的贡献。
我们还要感谢 Woosuk Kwon(Inferact),以及 Michael Goin 和 Lucas Wilkinson(Red Hat),感谢他们的模型重构工作以及宝贵的反馈和支持。