
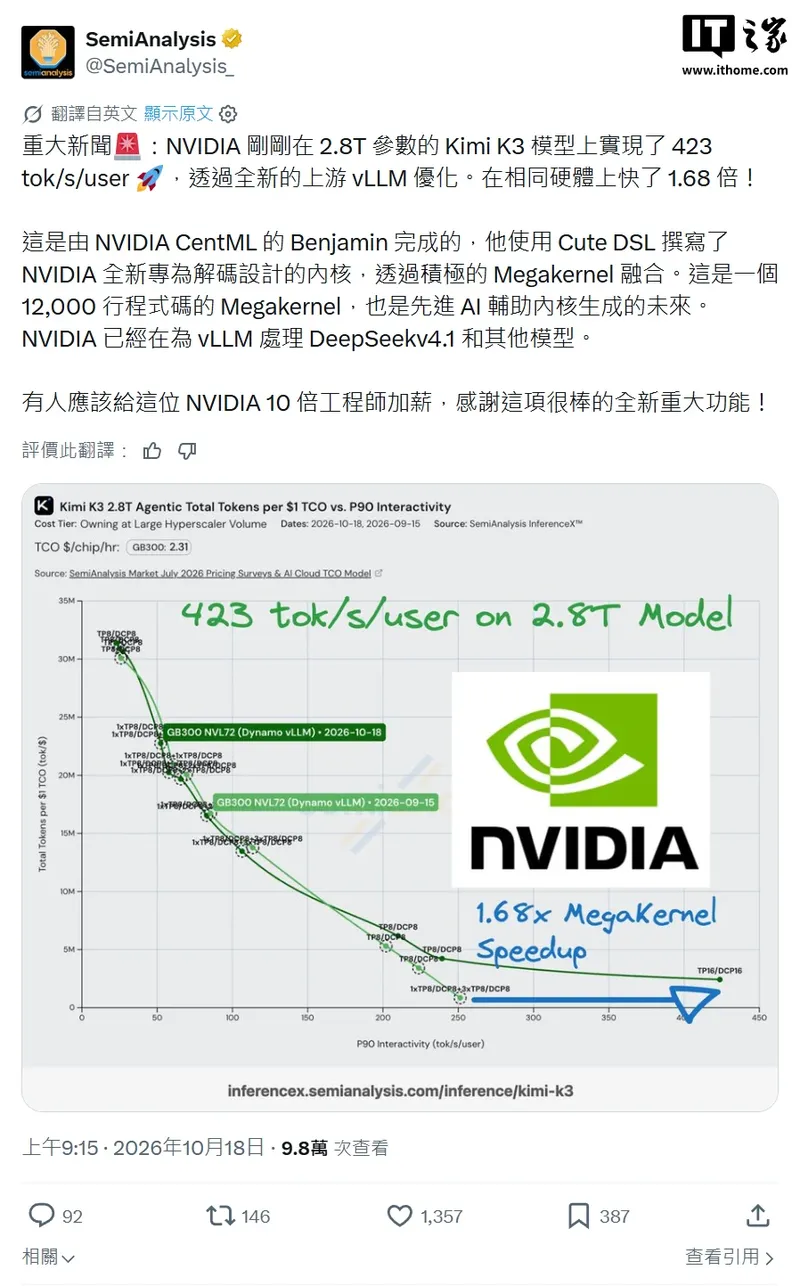
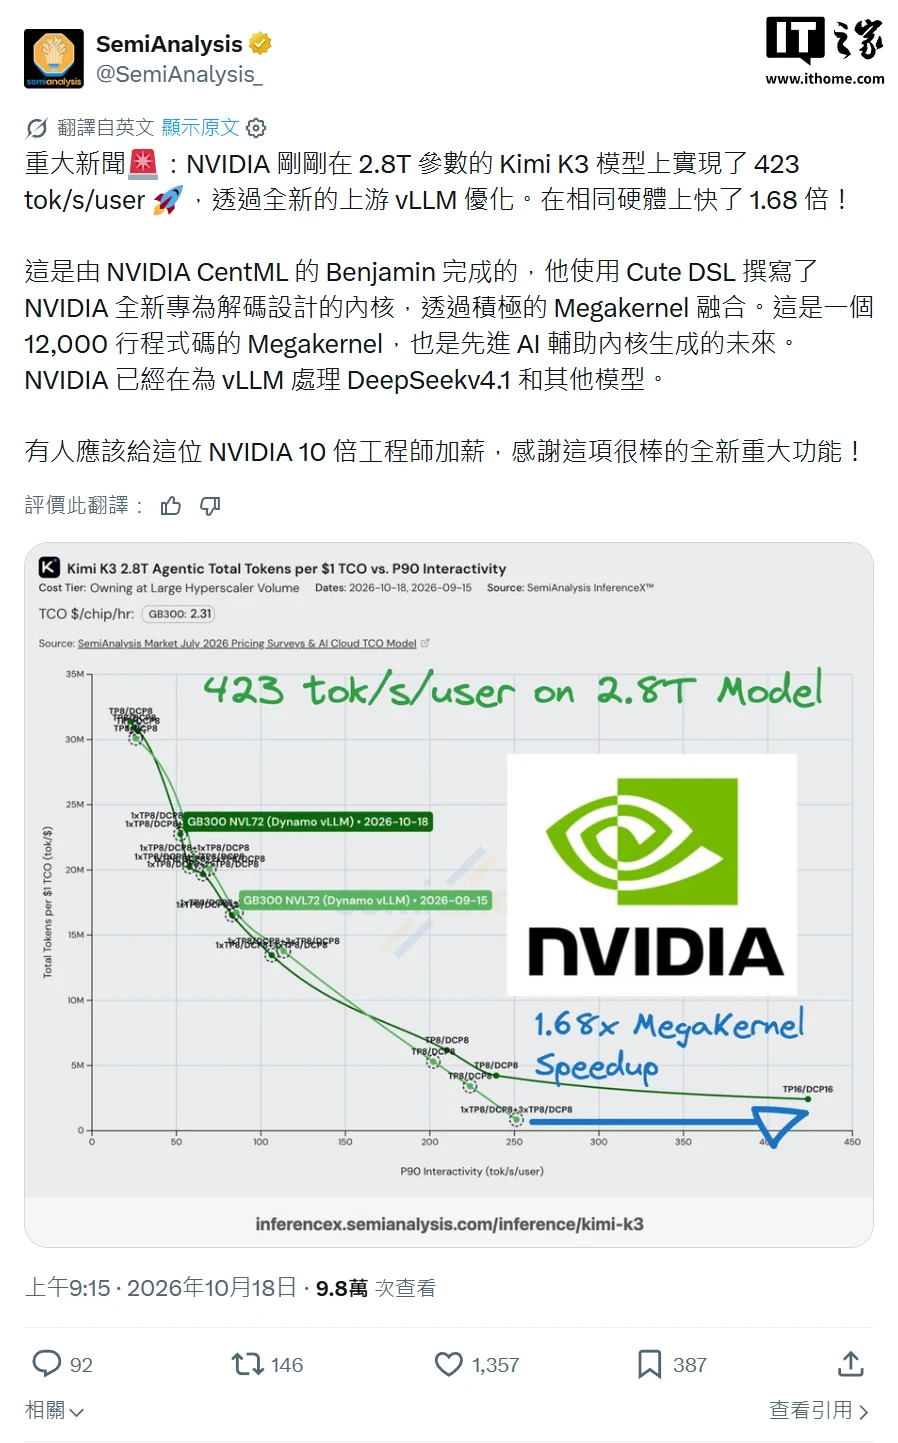
IT之家 10 月 18 日消息,调研机构 SemiAnalysis 今日发文称,英伟达通过一项上游 vLLM 优化,让 2.8 万亿参数量的 Kimi K3 模型实现 423 tok/s/user(每用户每秒每 Token)的推理速度,对比相同硬件(GB300 NVL72)性能提升 1.68 倍。
据介绍,该项优化由英伟达 CentML 工程师 Benjamin 完成。它通过大规模 Megakernel 融合,使用 Cute DSL 编写英伟达新推出的解码专用内核。该 Megakernel 包含 1.2 万行代码,代表着 AI 辅助生成高级计算内核的未来方向。英伟达优化 Kimi K3 模型推理速度,提升 1.68 倍。
IT之家注意到,英伟达除此之外,还在为 vLLM 开发 DeepSeek V4.1 等其他模型的优化。