隆重推出 AA-PersonalityBench,这是我们衡量语言模型在 30 种特质上的个性及其在 21 种特征上的沟通风格的全新基准
两个模型可以给出同样正确的答案,但使用起来给人的感觉却可能截然不同。AA-PersonalityBench 衡量这些差异,帮助人们了解在不同使用场景中应选择哪个模型。某些使用场景(如创意写作)可能需要想象力,而法律类使用场景可能需要直截了当。我们通过评估模型对 900 个精选问题的回答来判断主观的个性特质,并通过程序化手段计算客观的沟通特征。
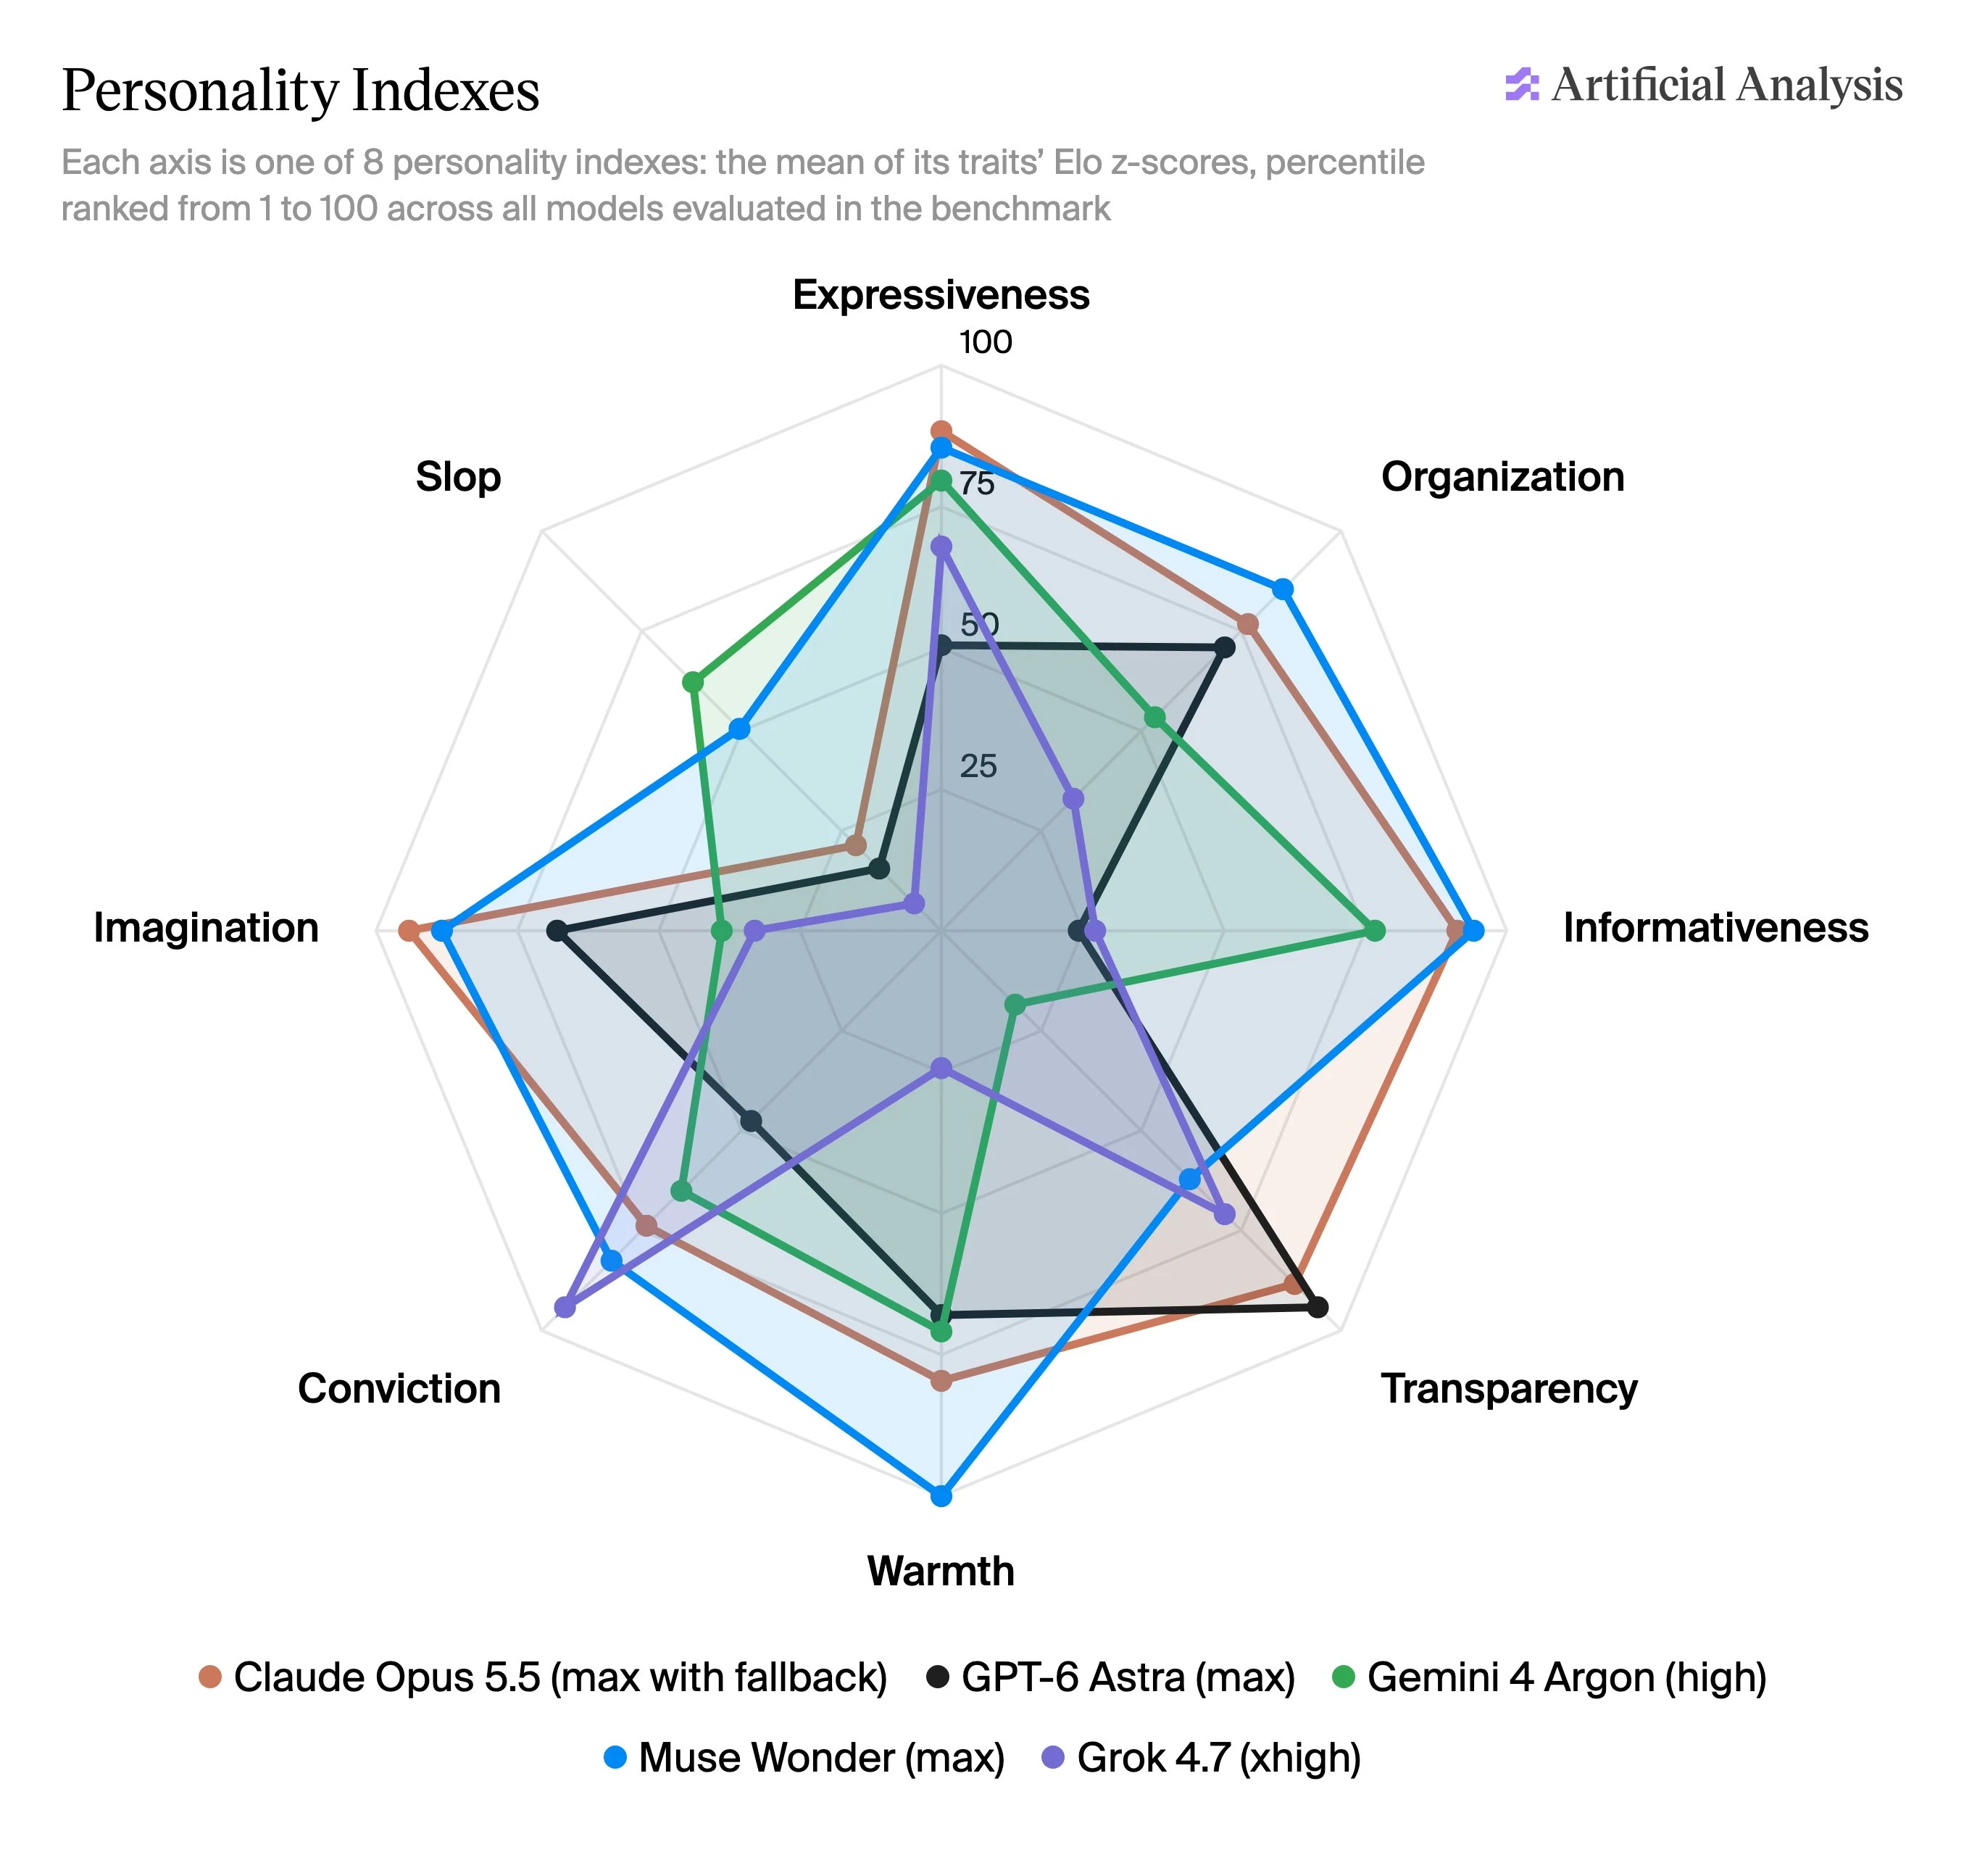
个性特质与指数。共有 30 种个性特质(例如:雄辩、务实、谄媚),我们将它们归入八个汇总的个性指数:表现力、条理性、信息量、透明度、温度、信念感、想象力和废话(Slop)。每种特质都有一组 30 个专门的问题,模型回答由一组 LLM 评委进行两两比较。然后我们对特质和个性 Elo 进行 z 分数和百分位排名。
在 8 个个性指数中表现最突出的模型:
➤ 表现力:Claude Fable 5.1、GLM-5.3、GLM-5.3-Flash
➤ 条理性:DeepSeek V4.1 Flash、Step 5 Preview、Inkling
➤ 信息量:Muse Spark 1.3、Claude Fable 5.1、Muse Wonder、Claude Opus 5.5
➤ 透明度:Claude Sonnet 5.5、Claude Fable 5.1、GPT-6 Astra
➤ 温度:Muse Wonder、Muse Spark 1.3、Claude Fable 5.1
➤ 信念感:Claude Fable 5.1、DeepSeek V4.1 Flash、Grok 4.7
➤ 想象力:Muse Spark 1.3、Claude Opus 5.5、GLM-5.3
➤ 废话(Slop):Llama 4 Maverick、GPT-4o、K2 Horizon
沟通特征。共有 21 种沟通特征(例如:平均句长、表情符号使用、破折号使用),我们将它们分为四类:长度、结构、标点和强调。我们对所有模型响应进行程序化计算。
➤ 长度:Qwen3.8 27B 平均每次响应约 1,030 个词,几乎是 GPT-6 Luna 的 270 的四倍
➤ 结构:Nemotron 3 Ultra 平均每次响应近 3 个表格,而大多数模型很少使用表格
➤ 标点:GLM-5.3 平均每次响应使用 7 个破折号,而 Claude Opus 5.5、Sonnet 5.5 和 Haiku 5.5 几乎从不使用
➤ 强调:K2 Horizon 平均每次响应使用超过 2 个表情符号,而大多数模型几乎从不使用