
TorchNeuron 为 AWS Trainium 上的 PyTorch 提供了新的原生后端。Transformers、Diffusers 和 Kernels 都能原生支持该后端,使得在 Trainium 上运行模型以及在 HF 中心分享模型变得比以往更加容易。
TorchNeuron
TorchNeuron 是一个 PyTorch 插件,它为 Trainium 提供了新的后端支持,能够支持 eager 模式、torch.compile 以及 FSDP 和 TP 等原生分布式 API。
请阅读 Pytorch 的博客,以了解更多关于 TorchNeuron 的信息。
从 2026 年 10 月 20 日开始,TorchNeuron 将作为公共测试版上线。研究人员和开发者可以通过 pip install torch-neuronx 来安装它。
新的后端,HF 库中的原生接口
迄今为止,Hugging Face在AWS Trainium和Inferentia上的体验——这些AI芯片分别旨在实现高效的成本效益型训练和大规模推理——是通过optimum-neuron提供的。该库依赖于torch-neuronx包,该包基于PyTorch XLA。当时这是最自然的选择,但这意味着需要像编译器一样工作:使用惰性张量而非立即执行,仅支持静态形状,并且每次图结构改变都需要重新编译。Optimum Neuron的存在就是为了隐藏这种复杂性,并通过维护自定义代码(如建模类、训练器等)来实现这一点。
TorchNeuron 会改变这一点。它直接集成到 PyTorch 中,将 neuron 作为原生设备使用,并支持即时执行、PyTorch 自带的分布式基础架构(DTensor、FSDP2)以及 torch.compile。
对于 Hugging Face 库,Trainium 就像其他设备一样:Transformers、Diffusers、Accelerate、PEFT 和 TRL 都可以直接在其上运行,使用的类 và 脚本与在其他加速器上使用的一样。从现在开始,我们建议 Neuron 用户直接使用这些库,而不通过 Optimum Neuron 进行操作。
Transformers
推理
现在,Transformers 能够原生支持多种模型的中文生成功能。使用 TorchNeuron 时,前 100 种最常用的文本生成模型架构中有 89% 可以直接使用,而 Optimum Neuron v0.4.5 则只有 46% 可以正常使用。您只需在代码中添加 device_map=neuron 参数,您的模型就会被迁移到 Neuron 设备上。
以下是使用张量并行化进行文本生成的示例,这能够让您充分利用 Neuron 实例的优势。请注意,此过程使用静态缓存进行生成,因为根据 Neuron 的推荐,采用这种方式可避免频繁重新编译。
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
培训
现在,Neuron 是 PyTorch 原生设备,因此在 Trainium 上训练时,使用与任何其他加速器相同的 Hugging Face 库:Transformers、Accelerate、PEFT 和 TRL。您不再需要专门的训练器或针对 Neuron 的模型代码分支。标准的 TRL 微调脚本可以在 Trainium 实例上运行,只需设置少量针对 Neuron 的特殊参数即可。
这是一个基于 TRL 的 SFTTrainer 构建的监督微调脚本。如果您之前曾在 GPU 上使用 TRL 对模型进行微调,就会感到很熟悉。
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
Transformers 能够原生地处理并行性。您只需进行配置即可 DistributedConfig 使用张量并行(TP)和 FSDP 的大小 model_init_kwargs, SFTTrainer 把它传给他 from_pretrained,并且在加载权重时模型会被分片处理。训练器会看到模型已经分布完毕,因此不会再次包装它。您不需要 --fsdp 标志或加速 FSDP 配置。
脚本中的任何内容都与 Trainium 无关:相同的代码可以在任何硬件上运行。当你在 Trainium 上运行它时,有一些事项值得注意:
- 静态形状。 该脚本在
torch.compile中禁用自动动态形状,并使用包装打包技术来生成最多 2048 个令牌的序列。当 TRL ≥ 1.16 时,Neuron 上的批次会被填充为 128 个令牌的倍数,从而限制输入形状的数量。编译后的图会在后续步骤中重复使用相同的形状。 torch.compile开启。 传递--torch_compile true就只需要这样:在 Trainium 实例上,torch.compile检测到设备后,自动选择 Neuron 后端,无需进行其他配置。- 异步重量加载已禁用。 Transformers 中的内置异步重量加载功能在 Neuron 上不受支持,因此目前我们通过
HF_DEACTIVATE_ASYNC_LOAD=1将其禁用。
以下命令通过 torchrun 启动训练过程,每个 NeuronCore 对应一个进程。TP_SIZE 和 FSDP_SIZE 分别指定了并行布局,它们的乘积即为进程数:此处为 4 x 8 = 32,与 --nproc_per_node 一致。这 32 个进程构成一个 4 x 8 的网格结构。张量并行性将每层任务分配到 TP 组的 4 个核心上,而 FSDP 则把参数、梯度和优化器状态分配到 8 个 TP 组中。
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
我们在 8 块 Trainium2 芯片(32 个 NeuronCores)上运行了它,这相当于使用半个 trn2.48xlarge 实例。
训练任务已完成,且 trainer.save_model 会生成一个标准的 Transformers 检查点文件。其中没有任何内容与 Neuron 相关:你可以直接将其上传到 Hugging Face Hub,也可以在其他硬件上加载使用。
Diffusers
推理
Diffusers 库中的许多管道在 eager 和编译模式下都能与 TorchNeuron 兼容。FLUX.1-dev、FLUX.2、Qwen-Image、Qwen-Image-2.1 以及 H3 也能利用 tensor 并行性,从而充分利用您的 Neuron 设备。以下示例展示了如何使用 TP:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
您可以使用以下命令运行此代码:NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py。
越来越多的管道将与 TP 兼容。如果您喜欢的管道不兼容,也可以按照 此指南来添加对其的支持。
内核
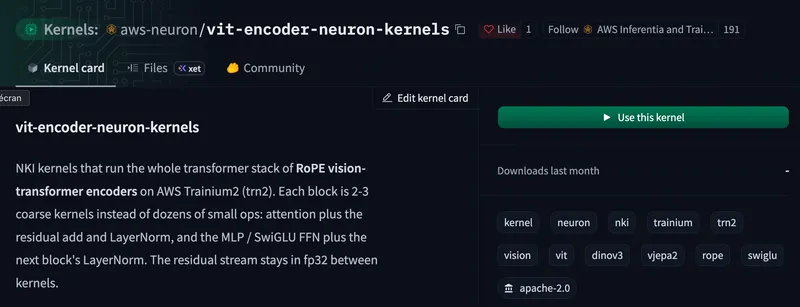
请务必查看 Neuron 团队的 kernels,因为越来越多的 Neuron kernels 将在 Hub 上上线,从而加速您的模型训练。 使用 Neuron Kernel Interface (NKI) 可以编写 Neuron kernels,这种方式能更灵活地优化操作。通过这种方式,用户可以运行自己的自定义操作,并在 Hub 上分享这些操作。
例如,您可以使用 这个内核 来加速您的视觉变换器,在 Trainium 上可实现高达 2.4 倍的加速效果!

致谢
特别感谢 AWS 团队在 TorchNeuron 项目上的付出,以及他们对我们反馈的积极回应,这些努力使得 HF 集成更加完善。