
传统上,更改 vLLM 服务中的 GPU 数量需要添加或移除完整的模型副本,或使用不同的 GPU 数量重启引擎。随着模型越来越大,每个副本需要更多 GPU,因此按副本扩缩会以越来越大的增量添加或移除 GPU。将 vLLM 重启以把 DeepSeek V4 Pro 从 16 个 GB200 GPU 扩展到 20 个 GB200 GPU 时,服务中断了 197秒 (详见 性能部分 ),这些昂贵的 GPU 在此期间被占用却未生成任何 token。
在我们的 第一篇弹性 EP 文章中,我们展示了 vLLM 如何在不重启的情况下向运行中的 DEP 部署(数据并行注意力与专家并行 MoE)添加或移除 GPU。虽然我们避免了重启,但在整个重新配置期间服务仍然停止,因为我们要初始化新的 worker、准备扩展后的通信组、加载模型权重,并重复内核预热和 CUDA 图捕获。在我们的 DeepSeek V4 Pro 基准测试中,这一停顿持续了 从 16 个 GPU 扩展到 20 个 GPU 时为 100 秒 ,而 缩回 16 个 GPU 时为 56 秒 (完整细节见 性能部分).
。在本文中,我们描述了异步准备和 NIXL EP 如何实现近零停机时间的弹性 EP 重新配置。在同样的基准测试中,我们将停机时间降低到 从 16 个 GPU 扩展到 20 个 GPU 时为 0.82 秒 ,以及 缩回 16 个 GPU 时为 1.96 秒,使我们能够在几乎不影响服务性能的情况下进行扩容和缩容。
将拓扑准备与服务重叠
我们将 vLLM 的重新配置流程重组为两个阶段:后台准备和短暂的提交。现有 worker 使用独立的后台线程来准备并预热目标通信、传输模型权重,并与加入的 worker 同步执行相关信息(例如自动调优结果),同时继续使用其当前的通信组和 CUDA 图处理请求。与此同时,加入的 worker 进行初始化、接收模型权重,并准备其通信和 GPU 执行。在提交阶段,vLLM 短暂停止其调度器,激活准备好的拓扑,然后恢复服务。这些改动是在 异步准备 和 准备/提交优化.
中引入的。准备工作涵盖四项主要任务:
- 初始化加入的 worker。 启动它们的进程,并为模型和执行分配存储空间。
- 准备通信。 设置目标通信组并扩展EP通信器。
- 传输模型权重。 通过NVLink或RDMA将所需权重从现有worker传输到新加入的worker。
- 准备执行。 在新加入的worker上完成所需的编译、kernel预热、调优设置以及CUDA图构建。
在提交阶段之后,异步Expert Parallel Load Balancing(EPLB)允许新worker开始处理注意力计算,而现有worker处理专家计算。随后EPLB在后台将专家重新分布到扩展后的组中。
主要的挑战是在不涉及或干扰正在服务请求的worker的情况下,完成通信和GPU执行的准备工作。
原地扩展EP通信
在NIXL EP之前,vLLM中可用的EP通信后端采用固定成员制:每个实例都是为特定的rank集合创建的。添加或移除rank需要创建新实例。即使该实例可以在后台创建,仍然存在两个问题。
首先,旧实例和新实例需要各自独立的通信缓冲区及其他资源,包括内存注册、IPC句柄和RDMA Queue Pairs(QP)。同时保持两个实例存活会增加通信内存占用,并且需要重复设置而不是复用现有资源。
其次,切换EP通信器会改变EP通信kernel所使用的缓冲区和通信状态。这会使之前捕获的CUDA图失效,必须在恢复服务之前重新捕获。这需要在所有保留的worker上针对多种batch形状重复预热和图构建。在我们的DeepSeek V4 Pro基准测试中,即使采用异步准备,在提交阶段执行预热和图重新捕获仍导致服务暂停达 58秒(扩容期间) 和 44秒(缩容期间).
为了解决这些问题,我们设计了 NIXL EP,一个专为Elastic EP量身定制的EP通信库。它可以原地添加或移除rank,复用相同的NIXL agent、缓冲区和连接。新peer可以在现有worker继续服务的同时完成连接,且只有新加入的peer需要新建连接和注册。NIXL EP还能使已捕获的EP dispatch和combine条目在重新配置后保持有效,使保留的worker能够复用其现有的CUDA图。
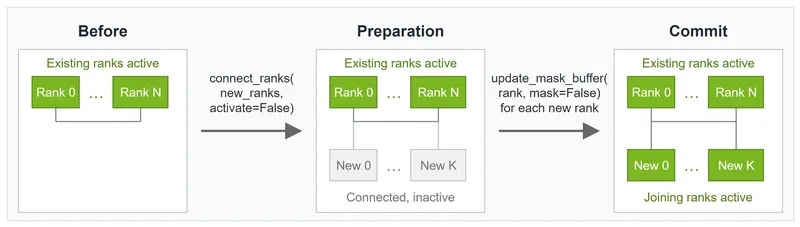
在准备阶段,vLLM 的后台线程会连接加入的对等节点,但不激活它们。随后在提交阶段,激活已准备好的对等节点,而不会替换通信器。
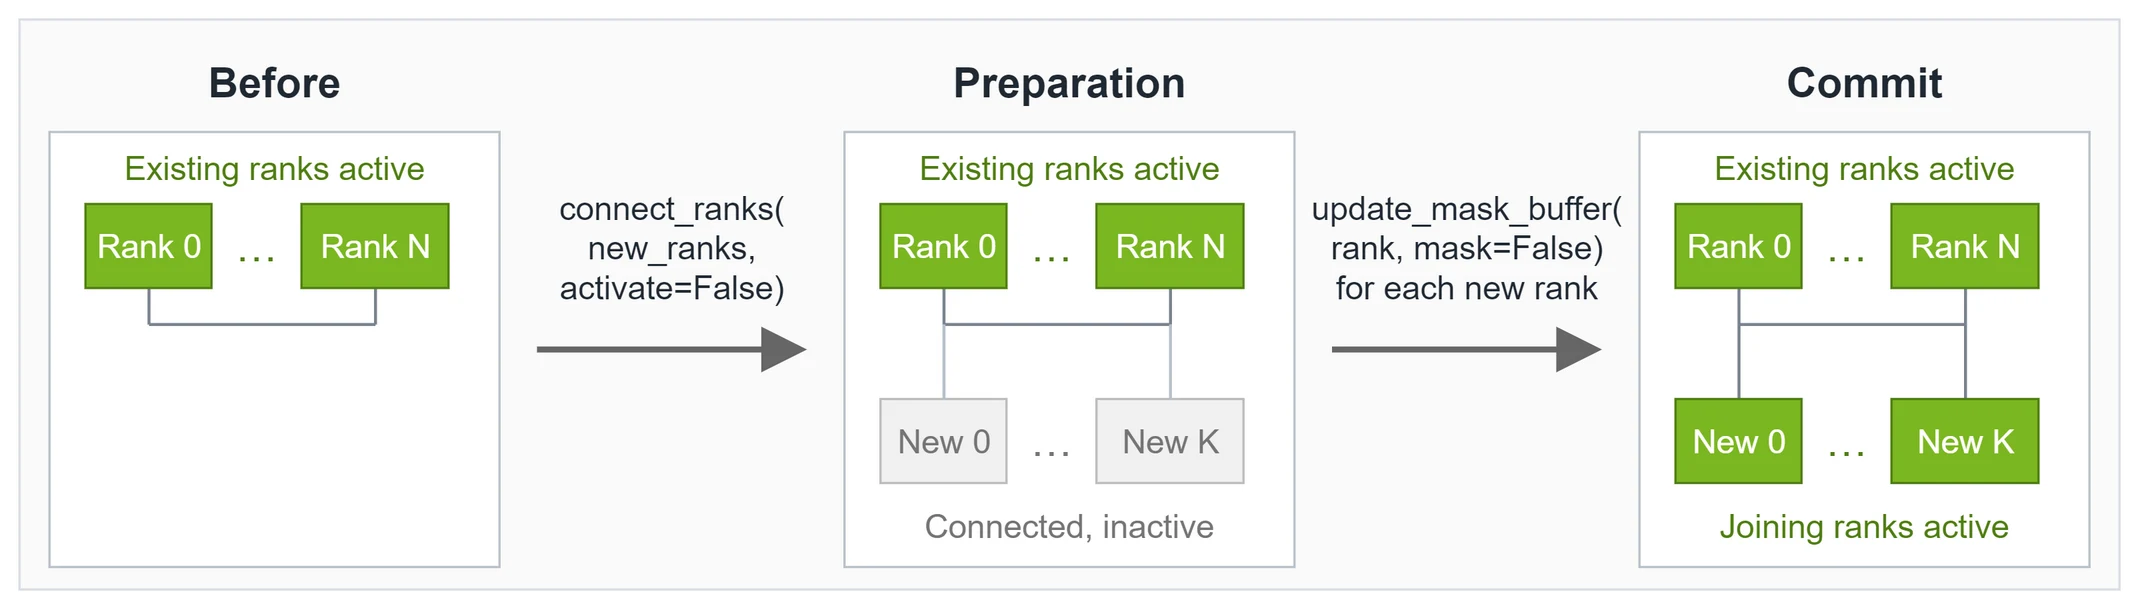
图1. 连接并激活新的EP peers。绿色rank处于活跃状态;灰色rank已连接但被屏蔽。在提交阶段,新的peer被激活,而无需替换agent或缓冲区。
vLLM 仍会为目标拓扑创建新的 DP 协调组和 EPLB 组, 但它们的通信在捕获的模型前向传递之外进行,因此切换到它们不会使 CUDA 图失效。
在现有 worker 上保留 CUDA 图
CUDA 图会记录 GPU 操作,使 vLLM 能够重放一次前向传播,而无需从 CPU 反复启动每个操作。一个被捕获的内核节点包含其启动配置和参数值,包括指向输入和输出张量的指针。内存内容在重放之间可以变化,但记录的指针必须保持有效。这些要求是 CUDA 图执行契约.
vLLM 的一部分,它针对不同的批处理形状和执行模式捕获单独的图 并在每次捕获前运行预热前向传播。
保留已捕获的 CUDA 图不仅仅需要让通信器对象保持存活。NIXL EP 还在重新配置过程中保持内核启动配置、图可见的通信参数以及输入输出张量地址的稳定。其内核从可以在原位更新的设备状态中读取活跃组成员信息。
我们还修改了 vLLM,使其在重新配置过程中保持周围计算内核的已捕获参数、启动配置以及输入输出张量地址的稳定:
- 我们复用保留 worker 的融合 MoE 执行对象,而不是为不同的活跃 EP 大小重建它们。
- 我们在重新配置过程中保持图可见的工作区和 dispatch 输出的地址与布局稳定,使已捕获的专家内核能够继续使用它们。Dispatch 输出同时也作为专家计算的输入。如果它们的地址或布局随 EP 大小改变,已捕获的专家内核仍会使用旧的指针和偏移量。
- 我们保留专家路由张量的底层存储并原位更新映射。这使 EPLB 能够在不移动已捕获内核所用张量的情况下更改映射内容。
这些更改合在一起,使保留 worker 能够在扩容和缩容之后 复用其现有的 CUDA 图 。
让加入的 worker 独立进行准备
现有 worker 有图需要保留。加入的 worker 则没有。
加入的 worker 通常通过运行带 EP dispatch 和 combine 的模型前向传播,以及与其他 worker 交换批处理信息来进行准备。这些步骤需要其他 worker 参与,但现有 worker 已经在当前拓扑上服务真实请求。
NIXL EP 允许每个加入的 worker 在预热和图准备期间临时屏蔽所有远程 EP 对端。只有该 worker 的本地 rank 对 EP 通信处于活跃状态。我们还修改了 vLLM,使这些准备过程不再等待其他 worker 的 DP 批处理信息。这让加入的 worker 能够运行其虚拟批处理并捕获 CUDA 图,而无需现有 worker 参与。
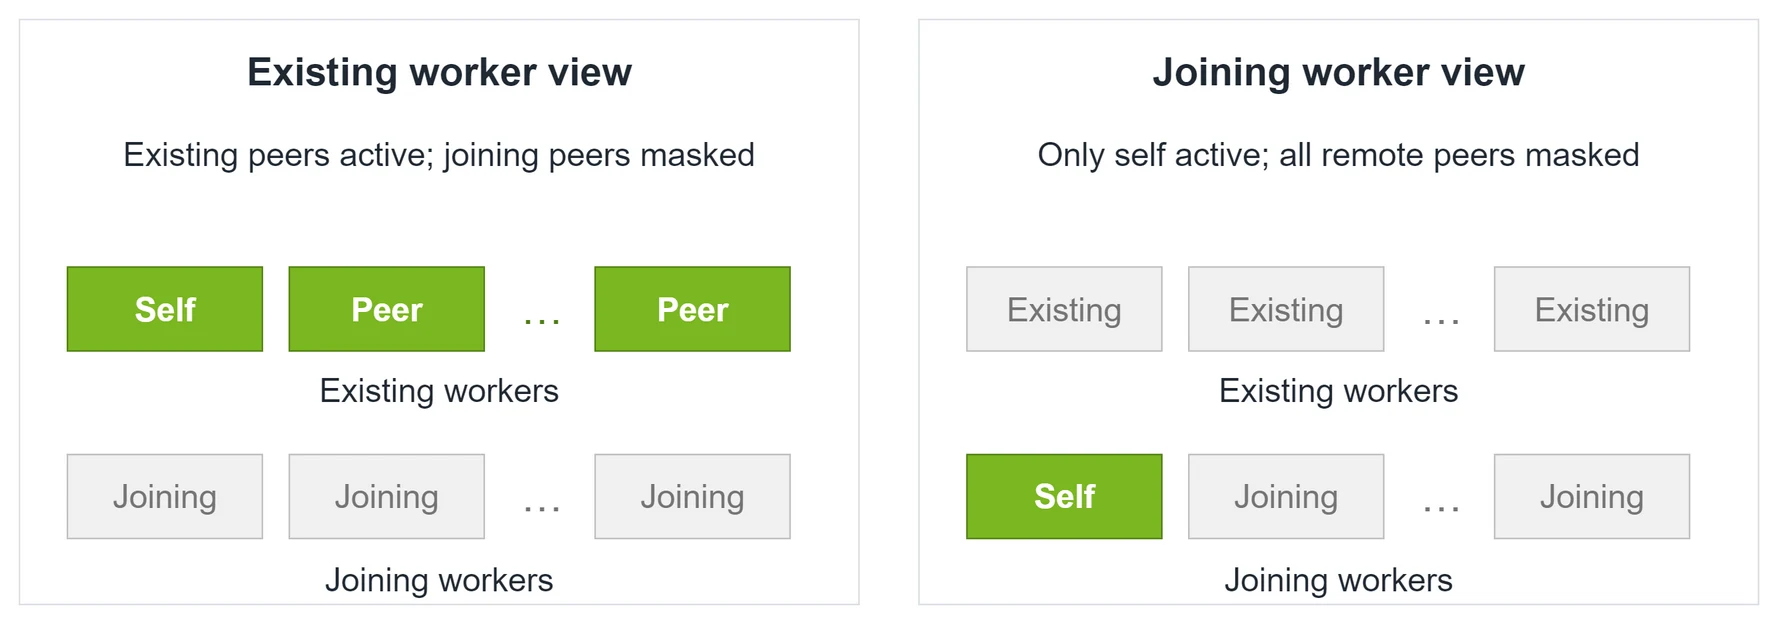
图 2。绿色 rank 对 EP 通信活跃;灰色 rank 被屏蔽。现有 worker 一起服务,而每个加入的 worker 为准备工作屏蔽所有远程 EP 对端。
捕获完成后,NIXL EP 可以在不使图失效的情况下重新激活对端。加入的 worker 在作为扩展组的一部分开始服务时,复用其本地捕获的图。
在 DeepSeek V4 Pro 上的性能
本节中的所有实验均在 GB200 GPU 上使用 DeepSeek V4 Pro 在 GB200 GPU 上,TP=1,DP/EP 大小分别为 16 和 20。模型权重以 safetensors 格式预先下载到共享的 Lustre 存储上,并使用默认方式加载 --load-format auto加载。测量使用了已预热的内核编译缓存(Triton、TileLang 和 FlashInfer)。
扩容与缩容耗时
该表显示了在服务暂停时哪些阶段会运行,以及哪些阶段在现有 worker 继续提供服务的同时于后台运行。
| 阶段 | A:阻塞式 | B:异步准备 | C:异步准备 + 图复用 |
|---|---|---|---|
| 初始化加入的 worker | 服务暂停 | 后台 | 后台 |
| 准备目标通信 | 服务暂停 | 后台 | 后台 |
| 传输模型权重 | 服务暂停 | 后台 | 后台 |
| 在加入的工作节点上进行预热和图捕获 | 服务暂停 | 服务暂停 | 后台 |
| 在现有工作节点上进行预热和图捕获 | 服务暂停 | 服务暂停 | 不需要(现有图保持有效) |
| 激活目标拓扑 | 服务暂停 | 服务暂停 | 服务暂停 |
配置C受支持 仅由NIXL EP支持.
- 停机时间: 所观察到的服务中断,即进行中的请求停止推进且新请求不被接纳的时段。
- 总时间: 完整扩缩容操作(包括准备阶段)的持续时长。
这两个时长是分别测量的。
| 指标 | A: 阻塞式 | B: 异步准备 | C: 异步准备 + 图复用 |
|---|---|---|---|
| 16 到 20 GPU:停机时间 | 99.62 秒 | 58.04 秒 | 0.82 秒 |
| 20 到 16 块 GPU:停机时间 | 56.25 秒 | 44.07秒 | 1.96 秒 |
| 16到20个GPU:总时间 | 99.72 秒 | 97.27 秒 | 92.34 秒 |
| 20到16个GPU:总时间 | 56.21 秒 | 51.46 秒 | 9.32 秒 |
所有配置都通过了数值正确性检查,包括对每个加入的 worker 的检查。
在添加GPU的同时维持SLO
我们在 16 个 GPU 上部署了 DeepSeek V4 Pro,然后将传入请求速率从每秒约 8 个请求逐渐增加到 16 个请求。我们对三种部署重放了相同的 11,391 个请求场景:一种保持在 16 个 GPU,一种用 20 个 GPU 重启,另一种使用 Elastic EP 和 NIXL EP 扩展到 20 个 GPU。服务级别目标(SLO)是滚动 p95 首 token 时间低于 5 秒。
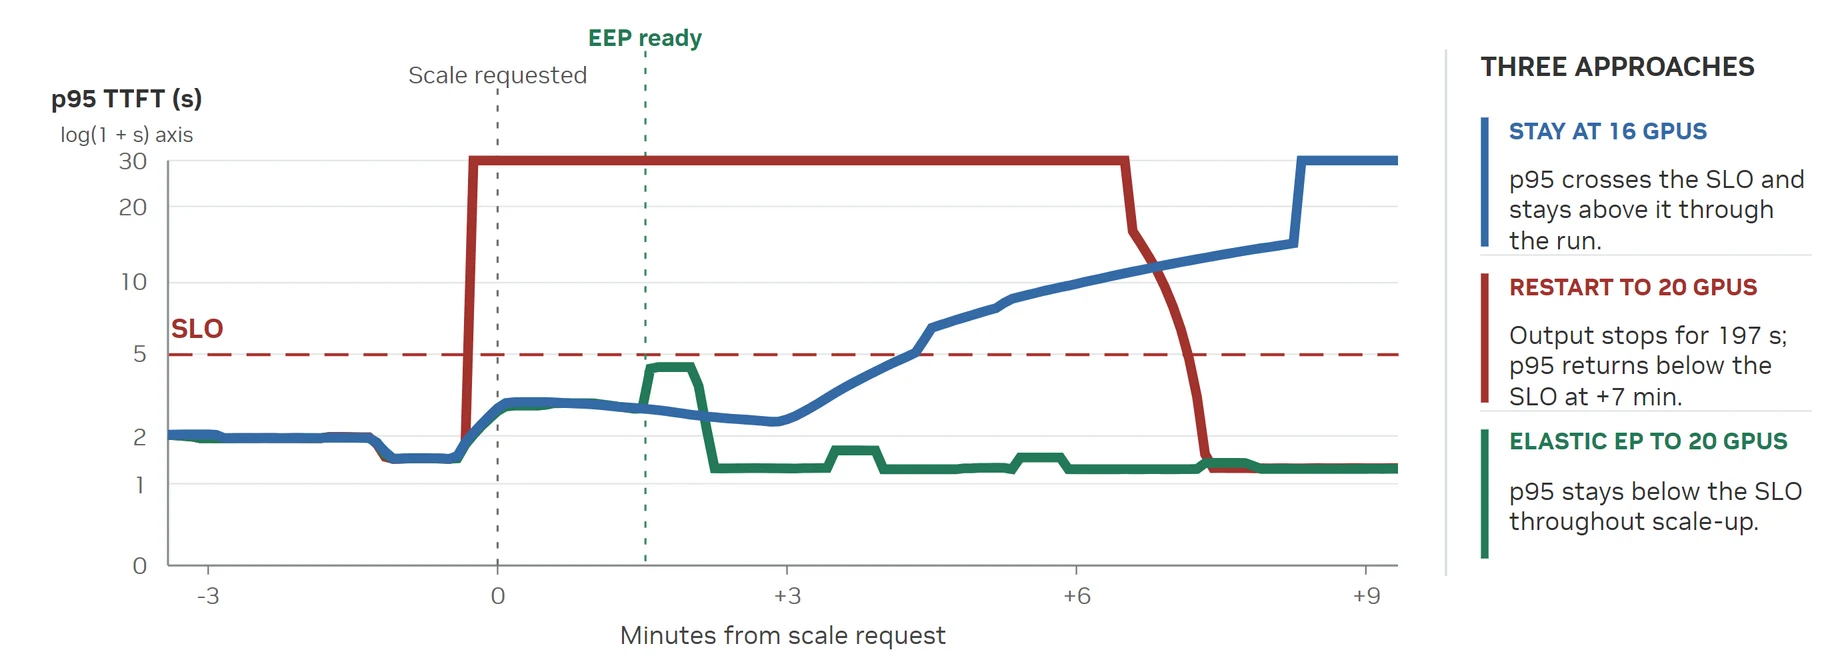
图3:请求负载上升下的端到端服务。曲线显示30秒滚动p95结果,失败请求被赋以30秒的惩罚值,而非实测的TTFT。
- Elastic EP 完成了全部 11,391 个请求,并在整个场景中始终低于 SLO。
- 在准备期间,Elastic EP 的服务性能与静态 16-GPU 部署相当,后台准备未造成可见的性能下降。
- 扩展之后,Elastic EP 的性能与恢复后的 20 GPU 部署相当,且扩展后没有明显的性能下降。
试用 Elastic EP
背景准备、CUDA 图重用以及在加入的工作线程上进行独立图捕获,如今均已在最新版本中可用 vLLM 和 NIXL 版本发布。使用 pip 安装并开始使用 Elastic EP。
有关完整的使用示例,请参阅 cuda_graphs_heavy_nixl_ep vLLM 的 Elastic EP 测试中的用例。该示例包括服务器配置和扩缩容 API 调用。它在发送请求的过程中从 2 个 GPU 扩展到 4 个再缩回,并在每次调整前后检查服务状态和模型准确率。
接下来会是什么
使用 Dynamo Snapshot 恢复 Warm workers
我们已经有效解决了长期存在的中断问题。下一个挑战是让新产能更快就绪。我们计划整合 Dynamo 快照 这样加入的工作进程可以恢复已初始化的进程和 CUDA 状态,而不必重复编译、内核预热、图构建以及其他启动工作。
目标拓扑的通信必须单独准备,因为它不会从快照中恢复。从检查点存储恢复大模型权重可能占用大部分恢复时间,因此我们计划保留 Elastic EP 从现有工作进程进行的 GPU 到 GPU 权重传输方式。
通过 NIXL EP 实现最先进的 EP 通信
我们的目标是通过 NIXL EP 实现最先进的 dispatch 和 combine 性能,同时保持对 Elastic EP 和容错能力的完整支持。即将推出的 NIXL EP 性能更新是实现这一目标的下一步(参见 NIXL EP 路线图 RFC).
将 Elastic EP 连接到 Dynamo 和 llm-d 编排
在引擎级能力就绪之后,下一步是让编排器自动伸缩器使用 Elastic EP。相关工作已经在 vLLM、Dynamo 和 llm-d 社区中展开。
这些工作包括 vLLM 的外部负载均衡器工作 以及 Dynamo 的 Elastic EP 提案.
如果您大规模运行推理,我们鼓励您尝试 Elastic EP,并分享您的工作负载和运行需求。如果您构建推理基础设施,我们欢迎您为 vLLM Elastic EP 和 NIXL EP 做出贡献。让我们让 Elastic EP 在生产环境中运行起来。
致谢
- 感谢 Red Hat 的 Tyler Michael Smith 和 Sage Moore,他们在整个工作过程中提供了宝贵的反馈和细致的审查。
- 感谢 Linoy Geva(NVIDIA)在准备期间在服务性能方面的工作。
- 感谢整个 NIXL 团队在 NIXL EP 上的努力。
- 感谢 Tzu-Ling Kan、Julien Mancuso 以及整个 Dynamo 团队在 Dynamo 中支持 Elastic EP 所付出的努力。