
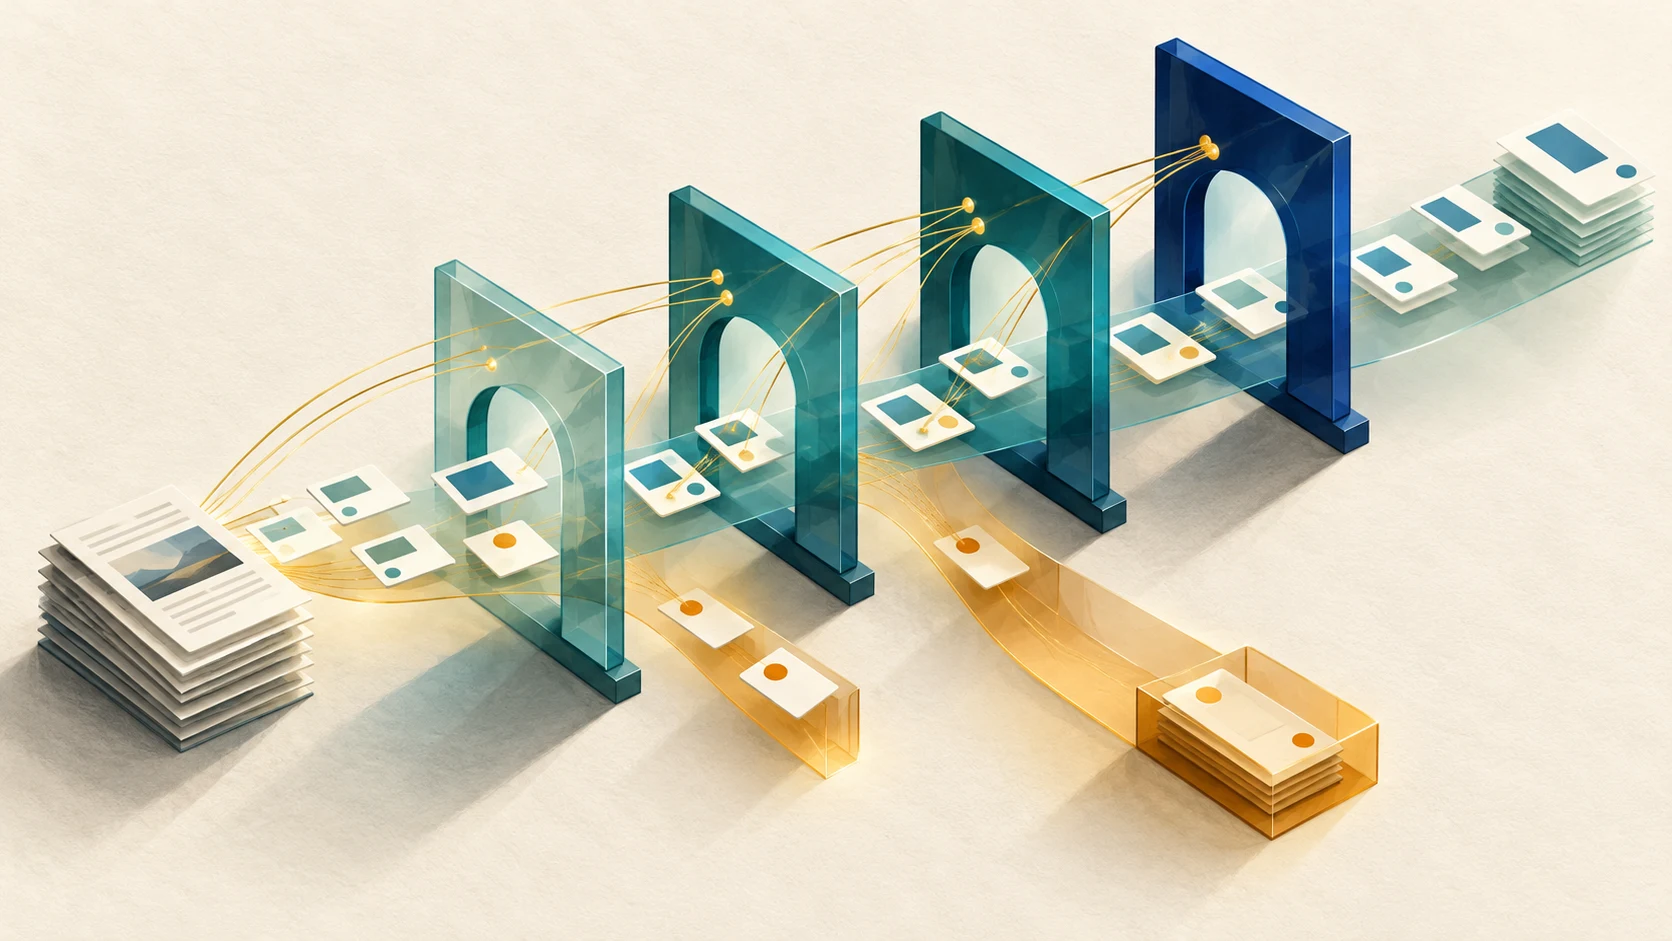
为 SPKE 创作的原创编辑插画。画面表达概念流程,并非实测基准。
危险的绿色对勾
设想一次商品资料导入:任务顺利完成,返回内容能解析为 JSON,所有类型检查也通过了。系统把 1.25 写入“商品重量”。原文其实是“包装重量:1250 g”。换算没错,字段却错了。
这是一个假设案例,不是某次模型实测结果。它揭示的是流程问题:模式可以要求填入数字,却未必知道这个数字描述的是商品、包装,还是另一款产品。
结构化输出很有价值,因为它缩小了一类故障的发生空间。接下来的工程问题是:什么样的数据才够资格被应用接收为“有证据支持的事实”?我们的建议是建立四道独立验收关口,并让“尚未证实”成为一种正式结果。
厂商的接口契约究竟承诺什么
OpenAI 的文档说明,Structured Outputs 支持按模式输出,但结果仍可能包含错误;拒绝响应也需要单独处理。OpenAI 指南
DeepSeek 的 Responses API 文档包含 json_schema 输出。它另外提供的 Chat Completions JSON Output 指南描述了合法 JSON 模式,并提醒可能出现空内容或截断。Responses API · JSON Output
这些是截至 2026 年 10 月 23 日核对的文档事实,不是新一轮基准测试结果。上述页面也不能证明任何厂商能够正确抽取你的业务字段。
对于在美国和中国厂商之间选型的团队,真正值得比较的是具体模型、接口、配置的输出模式,以及支持的模式约束。不要拿一家厂商的严格模式,与另一家只靠提示词要求 JSON 的方式比较,再把差异解释为国家层面的能力差距。请求格式看起来熟悉,也不等于行为完全相同。每次更换适配器或模型,都应重新运行同一套验收测试。
在记录里给“不确定”留位置
来看一段虚构的源文本:
“包装重量:1250 g。价格:49.00。商品重量:未注明。优惠截止:04/05/26。”
假设导入目标需要商品重量、价格币种,以及没有歧义的优惠截止日期。这段文字没有证实其中任何一项。填入 1.25 kg、美元和 4 月 5 日,只是靠编造信息换来了一条整齐的记录。
可以改用一套小而明确的记录约定:
- value:抽取值,或 null。
- status:supported(有据支持)、missing(缺失)、ambiguous(有歧义)或 conflict(冲突)。
- evidence:来源标识、来源位置和相关原文。
- transformation:抽取后进行的确定性转换,或无转换。
在这个例子中,商品重量应为 null,状态为 missing;币种同样缺失;日期应为 null,状态为 ambiguous。包装重量可以另存为 1.25 kg,同时保留原始值 1250 g 并记录换算过程,但不能移入商品重量字段。
必填字段不应逼出一个猜测。可以要求键存在,同时允许明确的未知状态。“缺失”与“有歧义”也应区分:前者需要更多来源材料,后者需要澄清已经存在的材料。来源之间互相冲突,则是第三种问题。
不要让模型自己的置信分数覆盖这些状态。没有证据的值,即便被打上 0.99,也依然没有证据。若要让置信分数参与业务决策,应先在有代表性的留出测试集上,验证它与实际正确率之间的关系。
写入之前,过四道关
-
完成状态。确认响应已经进入可用的终态。空输出、截断、拒绝和服务错误是不同结果,不要把它们统统“修复”为一条看似成功的空记录。应记录原因,并进入对应处理流程。
-
结构。解析响应,再用应用自己管理版本的模式验证。检查类型、必需键、允许的状态,以及厂商没有执行的约束。集成阶段就应识别并拒绝不支持的模式特性,而不是默认为它们有效。若回退到较弱的输出模式,应在监测中明确显示,并单独评估。
-
证据。核实引用的来源真实存在,引用片段确实出现在留存的来源版本中。随后还要判断:它是否支持这个值,以及这个字段?真实引文也可能答非所问。“包装重量:1250 g”不能证明商品重量。对于扫描件,只检查 OCR 文字可能遗漏识别错误;关键情形应核对原始页面。来源支持只能说明抽取结果忠实于来源,不能证明来源本身准确或仍然有效。
-
业务含义。能用确定性规则检查的,就不要只靠模型判断,例如单位、币种是否注明、日期解释、产品变体或规格是否一致、允许的分类和字段间一致性。需要人工判断的情形,应进入复核队列,而不是被包装成已经验证的记录。
四道关口回答不同的问题。证据检查失败,不是格式问题。来源从来没有提供某个值时,反复抽取直到模型给出一个值,也不能解决问题。
在前面的虚构案例里,可以用一条规则阻止“没有证据却标为 supported”的值,再用另一条规则阻止有歧义的日期被自动导入。这些规则是有用的防护,不是真实性的证明。最终验收决策应与模型生成的状态字段分开。
测试模式校验看不见的失败
扩大使用范围前,在普通业务样本之外,再建立一个紧凑的挑战集,至少覆盖以下情形:
- 必需事实不存在,期望结果应保留缺失状态。
- 数字确实存在,但属于另一个标签,例如包装重量而非商品重量。
- 两个来源版本互相矛盾,记录应显式暴露冲突。
- 日期有歧义,或缺少目标系统需要的信息。
- 单位换算允许执行,但原始值必须可追溯。
- 来源文本含有要求编造数值的指令,应把它当作待分析内容,而非抽取规则。
- 响应为空、中断、拒绝或结构无效,应分别进入正确的失败处理流程。
- 引用片段确实存在,却不能支持提出的值。
在比较模型前,先写清预期结果。如果来源无法回答,主动保留未知也应算作正确结果。对已接收与暂缓处理的记录都抽样进行独立复核。否则,系统可能仅靠避开难题显得更安全,也可能靠偷偷猜测显得更高效。
结果还应按来源语言和文档类型分组。中文供应商表格、德文小数写法和英文叙述材料,是不同的测试切片,不应全被一个总平均数淹没。
衡量真正的验收结果
至少报告三项指标,并写清分母。这里,每个逻辑任务请求一条记录;重试不算新任务:
- 模式通过率:通过模式校验的记录数,除以已完成的候选记录数。未完成、拒绝和错误任务另行报告。
- 自动接收覆盖率:自动接收的记录数,除以全部提交任务数。
- 已接收记录错误率:经审计发现至少有一项实质性事实错误或字段归属错误的已接收记录数,除以接受审计的已接收记录数。
下面是假设比较,不是实验。两个系统分别接收同一组 1000 个单记录任务,且所有任务都完成并生成候选记录。在这个示例中,所有未被自动接收的记录都进入人工复核。系统 A 有 980 条通过模式校验,自动接收 800 条;全量审计发现其中 20 条存在实质性错误。系统 B 有 970 条通过模式校验,自动接收 600 条;全量审计发现其中 3 条有误。
A 的模式通过率更高,为 98% 对 97%;自动接收覆盖率也更高,为 80% 对 60%。B 的已接收记录错误率更低,为 0.5% 对 2.5%。哪一个更合适,取决于错误记录的后果,以及额外复核 200 条暂缓记录的成本,并不存在通用赢家。
如果采用抽样审计,应报告样本量、抽样方法和不确定性,不能把一个点估计当成保证。还应跟踪人工复核时间和可恢复故障。几乎把所有内容都交给人工处理,确实可能适合后果严重的任务,但这并没有证明系统实现了广泛自动化。
下一步可以很小,但要具体
选一个经常导致昂贵返工的字段,明确它需要什么来源证据,什么情况应算未知,允许哪些转换,以及何时必须由人判断。在换模型之前,先写好挑战案例。
随后运行“影子导入”:生成拟写入记录,但先不写入实际业务系统。把被自动接收的错误与暂缓记录带来的工作量一起检查。只有两者都满足事先约定的风险阈值,才扩大自动写入范围。
这里的目标不是禁止 AI 推断,而是避免推断出来的答案悄悄变成“从原文抽取的事实”。整齐的 JSON 让软件更容易处理响应;设计良好的验收约定,帮助人们判断这个响应何时值得使用。
证据与边界
本文结合了文中链接的官方接口文档与 SPKE 的原创流程分析。商品片段、系统比较和测试设计均为说明性示例。我们没有运行厂商基准测试,没有测量生产环境错误率,也没有证明这些检查可以消除幻觉。接口能力会变化,部署前应核实所选模型和端点。