
这个世界,果然是个草台班子。
平时看 AI 行业,总觉得我们已经站在未来的门口:模型能写代码、解难题,智能体要接管工作流,关于人类还有多少工作可做的讨论一天比一天热闹。结果真到需要它干活的时候,屏幕上迟迟没有答案。
连被许多人视为 AI 行业标杆的 DeepSeek,也会掉链子。
2026 年 10 月 15 日,DeepSeek 发布的通知显示,北京时间 8:11 至 13:04,服务系统出现故障,导致该时段内 API 无法正常使用。按通知的起止时间计算,整整 4 小时 53 分钟,接近五个小时。说“宕了半天”是句气话,耽误大半个上午却是实实在在的。[1][2]
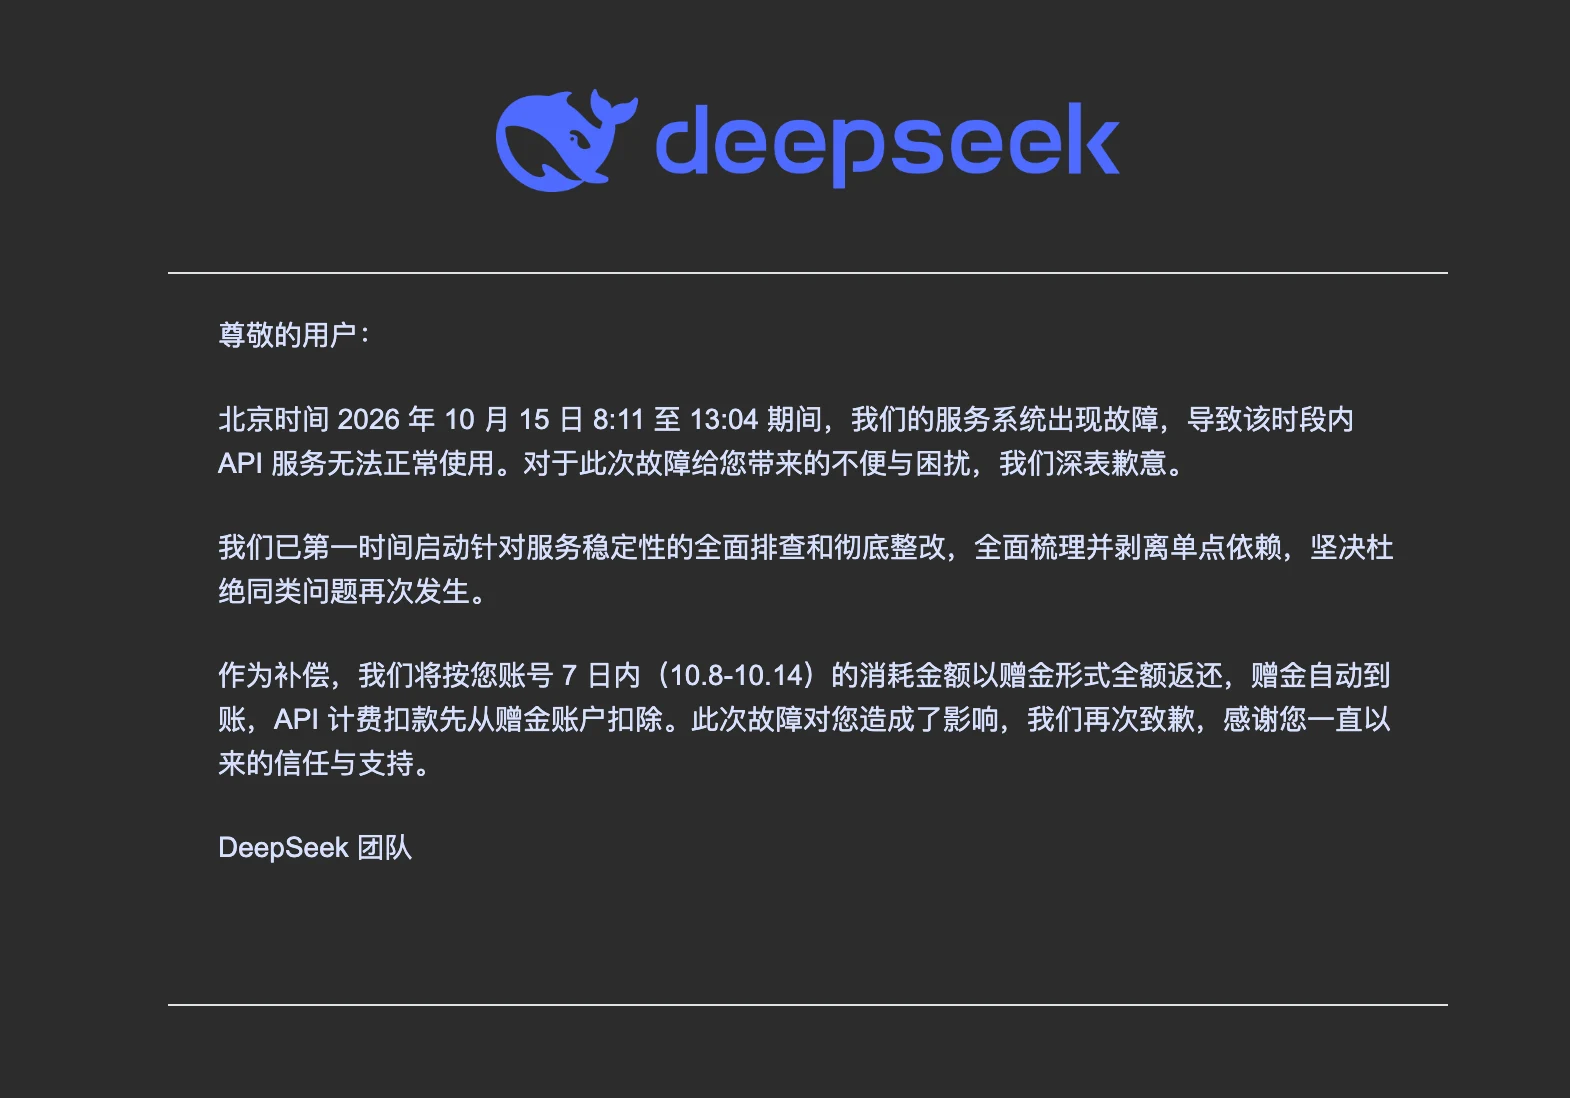
DeepSeek 服务恢复及补偿通知。图片由读者提供,通知中的时间和补偿口径与同日报道一致。
如果只是闲聊,少聊几句也就过去了。可一旦 API 接进产品,接进客服、内容处理或企业内部流程,上游停了,下游就可能跟着等。用户催的是你的交付,客户找的是你的团队,没人会因为模型平时答题厉害,就自动接受这几个小时的空白。
这也是这次故障最让人清醒的地方:模型能力与服务可靠性,必须分别交卷。
模型能不能把问题答对,是一回事;业务需要的时候,它能不能及时给出答案,是另一回事。前者容易出现在排行榜和发布会上,后者往往要等到出事才会被认真讨论。对真正依赖 AI 做事的人来说,两件事都不能缺。
“草台班子”的感叹就来自这种反差。我们看见的是能谈宇宙、写程序的智能,支撑它的却仍然是会出故障的机器、软件和人。再大的技术光环,也绕不开监控、冗余和故障恢复这些具体的活。
不过,吐槽归吐槽,这次 DeepSeek 的补偿,确实值得说句公道话。
根据通知,DeepSeek 将按账号此前七天,也就是 10 月 8 日至 10 月 14 日的实际消耗金额,以赠金形式全额返还,自动到账,后续 API 计费优先从赠金账户扣除。[1][2]
这意味着,如果一个账号在这七天消耗了 100 元,按通知的口径就会获得 100 元赠金。它没有把补偿仅仅限定在故障那几个小时对应的费用,而是拿出了此前一整周的消耗金额作为补偿基准。这个处理,有诚意。
当然,赠金和现金退款有区别,也不能理解成接下来七天随便用、无限用。额度取决于此前那七天的实际消耗,使用方式是抵扣后续 API 费用。把这层意思说清楚,丝毫不影响对这次补偿的肯定。
让人觉得有担当的,是它愿意为故障承担一笔明确的成本,也省去了用户逐个举证、反复申请的麻烦。对于会继续使用这项服务的开发者,这种自动到账、直接抵扣的安排有实际价值。
补偿的分量,也不在于替公司贴上“不差钱”的标签。愿意把歉意变成用户能实际用到的额度,才是这次处理值得肯定的地方。
但夸补偿,也不能把宕机夸成好事。
API 账单之外,还有业务中断、交付延期和用户流失的风险。一笔赠金,未必能覆盖每个团队的损失。钱可以补,错过的时间和受损的信任却需要更长时间修复。DeepSeek 值得因这次处理获得好评,也应该继续接受对稳定性的追问。
通知还提到,要梳理并剥离单点依赖。[1] 这么强大的模型,可能被什么东西卡住了?故障开始于北京时间 8:11,这个时间点,让人想到一种值得查证的可能:夜里上的变更,在早晨的流量面前露了馅。
先把话说在前面:DeepSeek 没有在这份通知里披露技术根因。夜里是否上线、早间流量是否明显抬升,都还需要日志和监控确认。下面只沿着这一个可能,推演它怎么发生。
假设夜里更新了一个公共服务。它负责在请求进入模型之前,核验密钥和可用额度。新版本能跑,检查也能通过,却把一项原本能从缓存读取的检查,变成了每次都去查数据库。这里的服务和改动是举例,不是已经查明的 DeepSeek 内部实现。
夜里请求少,多查一次,好像也没什么。接口还能返回,测试也没有报错,监控甚至可能还绿着。可系统已经悄悄丢掉了一部分处理能力。
早晨大家开始上班,产品里的调用、后台的任务陆续涌进来。请求进来的速度,终于超过了这个公共服务处理的速度。请求开始排队等待数据库连接,等待中的请求占住更多资源,后来的请求只能等得更久。
就像早餐店只剩一个收银窗口。厨房还能做饭,厨师也都在,可所有人都得先过收银这一关。门口堵住了,后面有再大的厨房也使不上劲。
接下来,麻烦会自己长大。调用方迟迟等不到结果,超时了,于是重试;有些下游产品也在替用户重试。如果上一次请求没有及时取消,旧活还没做完,新活又挤进来了。真正新增的业务未必暴涨,系统承受的请求却可能越滚越多。
这时就算把版本回滚,也未必能立刻恢复。堵着的请求还在,连接池还没缓过来,外面的重试还在敲门。服务刚喘口气,又被压回去。恢复可能得同时限流、截断无效重试、清掉过期任务,再一点点放开流量。改错代码和让系统重新站稳,有时是两场仗。
这条链路里,变更埋下问题,流量把问题顶出来,积压和重试再把它放大。昂贵的推理集群可能并没有一起坏掉,只是请求被堵在它们前面的窄门里。所谓单点,也未必是一台孤零零的服务器,而可能是多个副本都绕不过去的同一项依赖。
类似的放大机制有公开先例。Google Cloud 在 2025 年 6 月的事故复盘里写到,配额策略触发 Service Control 崩溃后,恢复过程中的集中重启又压到了底层数据库,拖慢了部分区域的恢复。[3] 这能说明“修掉起因,系统仍可能继续拥堵”在工程上说得通,不能拿来认定 DeepSeek 发生了同一件事。
要验证这个剧本,得把几条时间线叠起来看:故障前改过什么,流量何时上升,公共服务的延迟、排队和连接占用从何时开始异常,重试是否随之增加,回滚或限流后又发生了什么。若这些环节能前后对上,这个推测才有分量。8:11 这个时间点,只够提出问题,还不够宣布破案。
“杜绝同类问题”是一份承诺。承诺是否兑现,要靠往后的服务记录来回答。
这件事也给所有把 AI 接进业务的人提了个醒:该准备退路了。
重要流程要想好,上游模型短暂不可用时,能否先排队,能否切换到经过验证的替代服务,或者交回人工处理。需要重试,也得限制次数、逐渐拉长间隔,并把重试时间错开,别替上游再添一把火。尤其是会付款、发消息、改数据的流程,恢复服务后还得防止重复执行。
这些准备没什么未来感,却能在下一次故障时保护今天的生意。越是认真使用 AI,越不能把所有希望都寄托在“这么强的公司,应该不会出事”上。
DeepSeek 宕机近五个小时,确实该吐槽。一个被高度期待的 AI 服务,也必须把可靠性这门课做好。按此前七天消耗返还赠金,也确实值得肯定。出了问题,认账、补偿,再用持续稳定的服务把信任挣回来,这样的态度应该得到鼓励。
世界可能真有点草台。我们有理由要求它少出点错,也有理由在有人愿意承担责任时,说一句:这次处理得厚道。