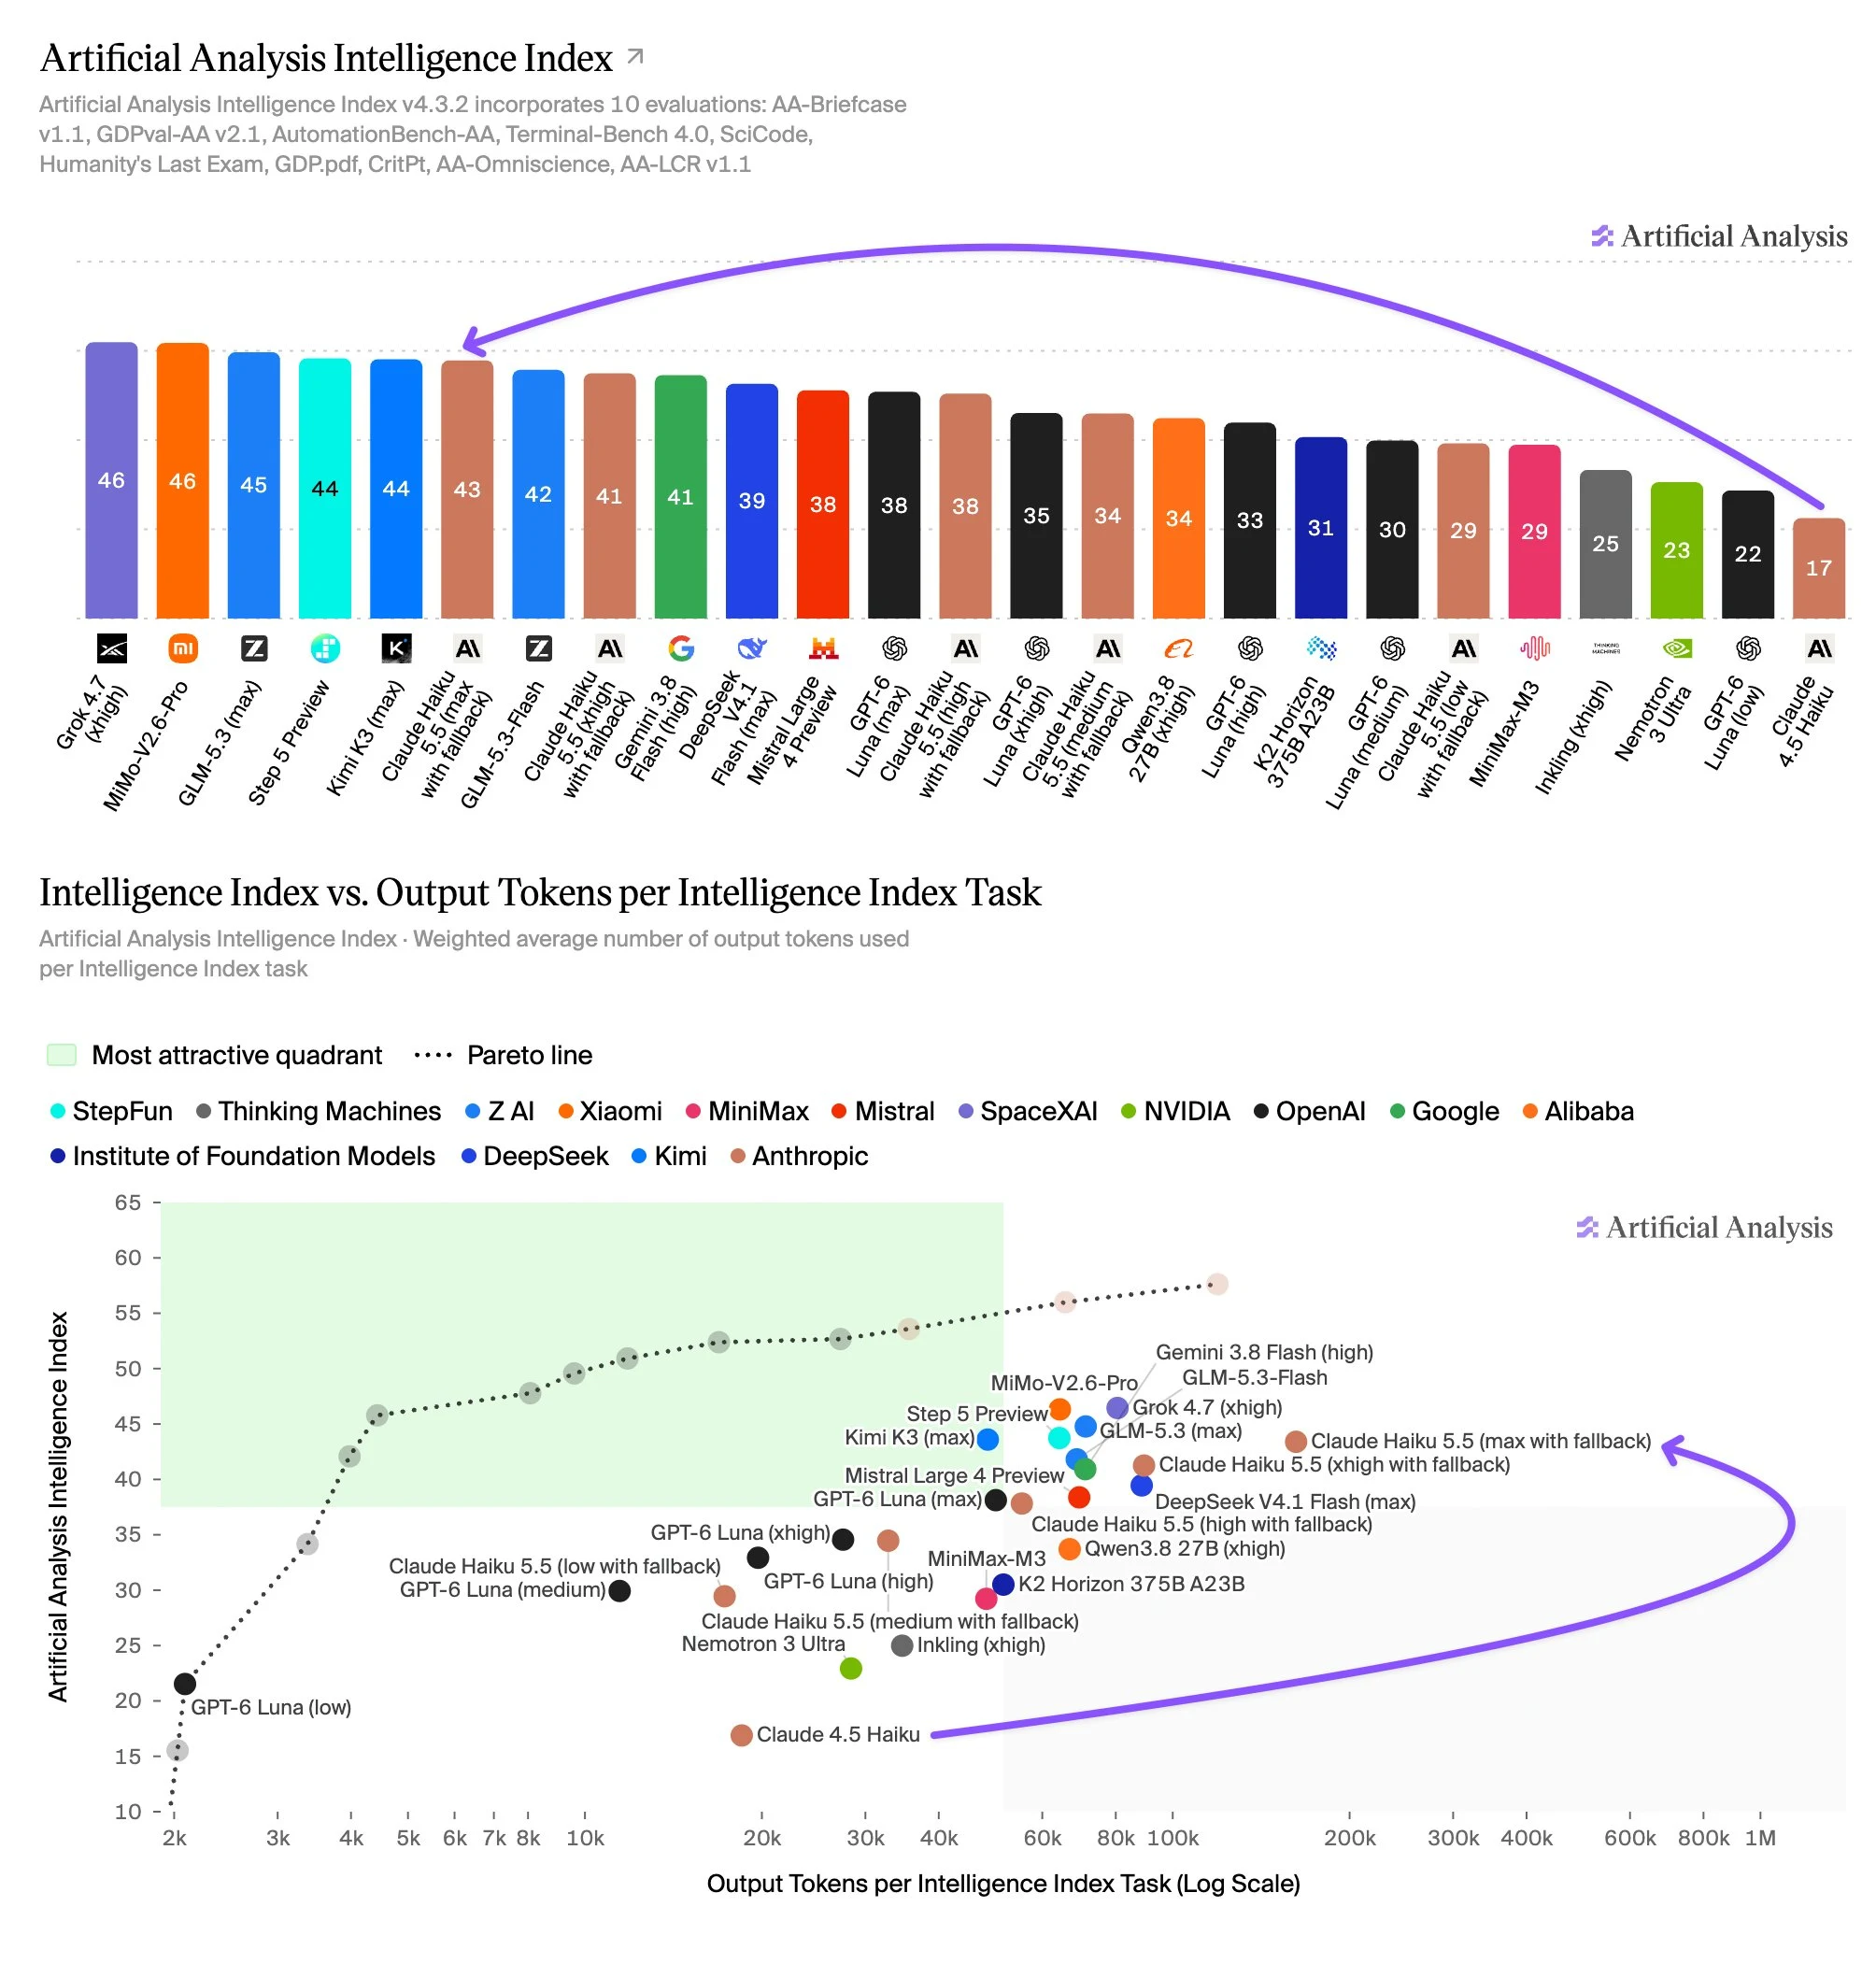
أصدرت Anthropic إصدار Claude Haiku 5.5، محققةً درجة 43 على مؤشر الذكاء من Artificial Analysis - بزيادة 26 نقطة بعد عام واحد من آخر إصدار Haiku
Haiku 5.5 هو أول نموذج Haiku يتضمن إعدادات الجهد والتفكير التكيفي من Anthropic، كما أدخلت Anthropic تسعيرًا متدرجًا.
Haiku 5.5 أرخص من سابقه - إذ يكلف $0.10/$0.50 لكل 1M رمز إدخال/إخراج للمطالبات التي تصل إلى 100k رمز (نفس سعر GPT-6 Luna و10% من سعر نموذج Haiku السابق). لكن يرتفع هذا التسعير بمقدار 5x ليصبح $0.50/$2.50 فوق 100k. الموقع لا يعكس بعد التسعير المتدرج، لذا فإن أرقام التكلفة المؤقتة لـ Haiku 5.5 لا تشمل هذه الزيادة في التكلفة. نحن نعمل على الدعم وسنتبع ذلك قريبًا بتغطية التكلفة لكل مهمة.
النقاط الرئيسية:
➤ أداء رائد في فئة النماذج الصغيرة: عند أقصى جهد، يتقدم Haiku 5.5 بفارق طفيف على نماذج مثل GLM-5.3 Flash (42) وGemini 3.8 Flash (41) وGPT-6 Luna (38). درجته مقارلة بـ Kimi K3 (44)، وهو نموذج مفتوح الأوزان بمعامل 2.8T، ويتأخر عن Claude Sonnet 5.5 (الحد الأقصى، 56) بـ 13 نقطة
➤ استهلاك كبير للرموز مقارنة بـ GPT-6 Luna: يستخدم Haiku 5.5 (أقصى جهد) نحو 162k رمز إخراج لكل مهمة في مؤشر الذكاء، أي نحو 3 أضعاف GPT-6 Luna (أقصى جهد، نحو 50k). الانتقال من xhigh إلى max يضيف 2 نقطة مقابل نحو 1.8 ضعفًا من الرموز. وعند مستوى ذكاء مماثل، يستخدم أيضًا رموزًا أكثر من GPT-6 Luna: يحقق Haiku 5.5 (مرتفع) درجة 38 بنحو 55k رمز لكل مهمة مقابل 38 بنحو 50k لـ Luna (أقصى جهد)، وتتسع الفجوة عند إعدادات الجهد الأدنى
➤ قدرات عالية في العمل المعرفي الوكيل: على AA-Briefcase، تقييمنا الخاص لمهام العمل المعرفي الواقعية، يصل Haiku 5.5 (أقصى جهد) إلى 1578 إيلو، متفوقًا على نماذج تشمل Kimi K3 وGLM-5.3، ومقارنًا بـ Muse Spark 1.3 (أقصى جهد)
➤ تحسينات في استخدام الطرفية: على Terminal-Bench 4.0 حقق 33%، ارتفاعًا من 0% لـ Haiku 4.5. هذا يعادل GLM-5.3 Flash، ويتقدم على Gemini 3.8 Flash (20%) وGPT-6 Luna (13%)
➤ معرفة واقعية أقل، لكن هلوسات منخفضة نسبيًا: كما هو متوقع من نموذج أصغر حجمًا، تمتلك Haiku 5.5 معرفة واقعية أقل من نماذجه الشقيقة. دقة AA-Omniscience تبلغ 36%، مقابل 55% لـ Gemini 3.8 Flash و44% لـ GPT-6 Luna، لكن ذلك يرجع جزئيًا إلى استعداده أكبر للاعتراف عندما لا يعرف - إذ معدل هلوساته أقل، عند 40% مقابل 55% و77%
➤ نتيجة AutomationBench-AA من المرجح أنها أقل من الحقيقة: يحصل Haiku 5.5 على 35%، مقابل 53–60% لـ GPT-6 Luna وGemini 3.8 Flash وGLM-5.3 Flash. أثناء الاختبار قبل الإطلاق، تسببت مشكلة في الرفض لأسباب السلامة في جعل النموذج يرفض بشكل مفرط. تعمل Anthropic على حل هذه المشكلة - وسنعيد تشغيل هذا التقييم مع الإصلاح، ونتوقع أن ترتفع هذه النتيجة
تفاصيل أخرى عن النموذج:
➤ نافذة السياق: 1 مليون رمز، ارتفاعًا من 200k لـ Claude 4.5 Haiku
➤ التسعير: $0.10/$0.50 لكل 1M رمز إدخال/إخراج حتى 100k رمز، و$0.50/$2.50 فوق ذلك. قراءة ذاكرة التخزين المؤقت $0.01 ($0.05 فوق 100k)، كتابة ذاكرة التخزين المؤقت لمدة 5 دقائق $0.125 ($0.625 فوق 100k)
➤ تعدد الوسائط: إدخال نصي وصوري، مع إخراج نصي