
ييون تشونغ، من قوانغ في سي
الكمية الكوانتية | الحساب الرسمي QbitAI
تدفع لوحًا مانعًا فيُغلق الممر؛ وتجلب منحدرًا فيصبح تجاوز الجدار العالي ممكنًا.
كل فعل يغيّر العالم، والعالم المتغيّر يصبح بدوره نقطة الانطلاق لقرار الوكيل التالي.
حين يمكن بناء عالم من هذا النوع بالشيفرة ورسمه لحظيًا بنماذج النشر، يمتلك الذكاء الاصطناعي «ساحة تجارب» يمكنه استكشافها مرارًا: يتصرّف بنفسه، يراقب النتائج، يختبر فرضياته، ثم ينقل خبرته إلى الجولة التالية.
هذا هو AgentGarten الذي أطلقته فريق MirroS حديثًا. يربط بيئة برمجية قابلة للتنفيذ بمُصيّر عصبي فوري: الشيفرة تحدد القواعد الفيزيائية، والنموذج يولّد التغذية البصرية، بمعدل إنتاجية يتجاوز 30 إطارًا في الثانية، ليتمكن الوكيل من التفاعل المستمر مع العالم.
في تجربة الغميضة الكلاسيكية، حدثت التغييرات سريعًا. تعلّم المختبئ في الجولة 4 تحريك اللوح المانع لبناء مخبأ، وأتقن الباحث في الجولة 10 استخدام المنحدر لتجاوز الجدار. وبعد فشل قفزة، حرّك الباحث المنحدر عمدًا ليقرّبه، عدّل موضعه، وحاول مجددًا.
ما يدفع تطوّر هذه الاستراتيجيات هو «دفتر التجارب» الذي يكتبه الوكلاء بأنفسهم.
في نهاية كل جولة، يستعرضون محاولاتهم ويسجّلون ما وجدوه ويدوّنون الأسئلة؛ وفي الجولة التالية يواصلون الاستكشاف حاملين معهم هذه الخبرات.
الشيفرة تجعل العالم قادرًا على العمل، والتصيير الفوري يجعل العالم مرئيًا، والتدريب المستمر يجعل الخبرات تتراكم.
يربط AgentGarten هذه العناصر الثلاثة في حلقة مغلقة، لاستكشاف سؤال أكبر:
حين يمتلك الوكيل عالمًا يمكنه فيه التصرّف وتجربة الأخطاء وتراكم الخبرات، كيف ستتطور الذكاء باستمرار داخله؟
المدونة الكاملة: https://mirros.ai/blog/worlds-for-evolving-agents
التقرير التقني: https://mirros.ai/report/agent-garten.pdf
الشيفرة: https://github.com/MirroS-Lab/AgentGarten
صفحة المشروع: https://mirros-lab.github.io/agent-garten
ما ينقص الوكلاء هو عالم يمكنهم التدرب فيه مرارًا
لجعل الذكاء الاصطناعي يفهم العالم الفيزيائي حقًا، لا تكفي إطلاقًا مجرد عرض مقاطع فيديو ضخمة عليه. فكما لا يمكن تعلّم السباحة بمشاهدة التسجيلات فقط، يجب على الوكيل أن «ينزل إلى الملعب» بنفسه، أي أن يتخذ إجراءات ويراقب النتائج الفعلية ثم يقرر الخطوة التالية.
وهذا يتطلب بيئة ذات حتمية سببية فيزيائية: الصندوق الذي دُفع يجب أن يبقى في مكانه، والممر المسدود يجب أن يظل غير سالك، وكل الأفعال اللاحقة يجب أن تظل مقيّدة بهذه التغيرات الفيزيائية.
لكل من المسارين التقنيين السائدين حاليًا قيوده:
بيئات محركات الألعاب/الشيفرة التقليديةدقيقة الحالة وشفافة القواعد، فكل تصادم فيزيائي واضح تمامًا.
لكن نقطة ضعفها في الصورة: المشاهد المبنية برمجيًا غالبًا ما تكون مجرد مجسمات هندسية بيضاء خام وخرائط نسيج مكررة. ولمنح مئات المشاهد المفتوحة مظهرًا واقعيًا من حيث الإضاءة والملمس، تكون تكلفة النمذجة الفنية والاستثمار الهندسي رقمًا فلكيًا.
نماذج العالم القائمة على توليد الفيديو(مثل مختلف النماذج الكبيرة للفيديو)، قادرة بالتأكيد على توليد صور عالية الدقة مذهلة، وتوليد الإطارات اللاحقة تبعًا للحركة.
لكن المشكلة أن المعلومات الفيزيائية مدفونة بالكامل ضمنيًا في ذاكرة الشبكة العصبية، فلا يمكن توفير حالة صريحة قابلة للاستعلام والتدخل. إذا أردت معرفة كم بقي من الماء في الكوب، أو أردت أن تربط الذراع الآلية اللولب بإحكام، أو أن تضع قواعد تحكيم صارمة للمهام، فستعجز في هذا الصندوق الأسود البحت للفيديو.
يظهر حل MirroS في:جعل كل منهما يؤدي دوره: الفيزياء للشيفرة، والضوء والظل للنموذج العصبي.
الشيفرة البرمجية تحرّك العالم، والنماذج مسؤولة عن «كيف تبدو الأشياء»
في AgentGarten، تسير حلقة التفاعل القياسية على النحو التالي:
يُصدر الوكيل تعليمات الحركة؛ ثم تحسب البيئة البرمجية فورًا التصادمات الفيزيائية وتحديثات الحالة، وتستخرج من منظور الكاميرا بمنظور الوكيل الأول (الرؤية من منظور الشخص الأول) «رسمًا هندسيًا» خفيفًا (أي عمق الفضاء أو نورمالات الأسطح)؛
بعد ذلك، يقرأ المُصيّر العصبي هذا الرسم الهندسي، ويجمعه مع الذاكرة البصرية السابقة، فيُصيّر على الفور إطارًا تاليًا واقعي المظهر ويسلّمه إلى الوكيل.
△ الشكل 2|التدفق في حلقة مغلقة بين البيئة البرمجية والمُصيّر العصبي. يُصدر الوكيل تعليمات الحركة، ويحدّث العالم البرمجي الحالة ويستخرج الشروط الهندسية، ويُنشئ المُصيّر العصبي الملاحظة البصرية التالية في الوقت الفعلي.
يحقق هذا التقسيم للأدوار قفزتين نوعيتين كبريين:
أولًا، القواعد الفيزيائية تبقى دائمًا "حتمية وقابلة للتحكم".
تخطيط المشاهد، واكتشاف التصادم، وحسم فوز أو خسارة اللعبة، كلها يقررها الكود، فلا ينشأ أي "فيزياء هلوسية".
ثانيًا، بناء عوالم جديدة تمامًا أصبح سريعًا للغاية.
في الماضي، كان بناء 100 بيئة محاكاة واقعية يتطلب فريق فنانين محترفين للنمذجة والتركيب والإضاءة، بتكلفة يصعب تحمّلها. أما في AgentGarten، فما دام باستطاعة المشهد إخراج مخطط عمق وخطوط عمود بسيطة ثلاثية الأبعاد، فإن أي مشهد برمجي بسيط يمكنه مباشرة تطبيق هذا العرض العصبي عليه، ليحصل في لحظة على إضاءة وخامات واقعية. الطيران ببدلة الأجنحة، وتشغيل الذراع الآلية، والطبخ في المطبخ، وسباق السيارات المتعدد، كلها تشترك في واجهة بصرية واحدة في الأساس — وهكذا تحولت تكلفة توسيع البيئات الافتراضية، للمرة الأولى، من "كثافة عمل فني" إلى "توسيع برمجي إجرائي".
△ الشكل 3|عوالم فيزيائية متنوعة عبر المهام المختلفة. تشمل الملاحة الفضائية، ومناولة الأجسام، وإعادة التصوير بحركات الكاميرا، والتفاعل بين سيارات متعددة. على اليسار نموذج أبيض مبسّط مُصدَّر من الكود، وعلى اليمين المناظر شبه الواقعية المولّدة آنيًا بواسطة العارض.
والأهم من ذلك أن هذا العارض يعملبالتوليد التدفقي: تتحرك الحركة خطوة، فتُرسم الصورة مقطعًا، ويرى الوكيل النتيجة بوضوح قبل اتخاذ القرار التالي، فيصبح التفاعل متسلسلًا بتواصل حقيقي كالعالم الواقعي.
إعادة زيارة لعبة التخفي: 25 مليون جولة و4 جولات
بعد بناء العالم، يأتي دور النظر إلى الوكيل: في عالم كهذا، هل يستطيع، من خلال الفعل والتقييم المتكررين، أن يتحسن من تلقاء نفسه؟
المَرجع الكلاسيكي هو تجربة الغميضة التي أجرتها OpenAI عام 2019: يتصارع المختبئون والباحثون في ملعب يحتوي حواجز ومنحدرات، وبعد معارك ذاتية واسعة النطاق تعلموا تباعًا بناء المخابئ وتسلق الجدران بالاستعانة بالمنحدرات.
أعاد فريق MirroS إجراء هذه التجربة في AgentGarten بإعداد فردي واحد مقابل فرد: يجهّز المختبئ المشهد أولًا، ثم يدخل الباحث.
قواعد المواجهة واضحة ونقية: يجهّز المختبئ المشهد أولًا بسد المداخل، ثم يدخل الباحث للبحث. يتحكم الوكيلان في الحركة والإمساك عبر كتابة كود بايثون Python، ويتخذان قراراتهما اعتمادًا كليًا على الصور المولّدة أمامهما، دون أي معرفة بالإحداثيات المكانية أو مواقع الخصم.
يبدأ الطرفان من دليل فارغ تمامًا، ويحتفظ كل منهما بمكتبة استراتيجيات مكونة من مهارات مفردة. تُلعب في كل جولة عشر مباريات، وبعدها يتم المراجعة والترسيب، ثم يُختار عشوائيًا جزء من مكتبة المهارات لتطبيقه في الجولة التالية.
وسرعان ما برزت تلك الاستراتيجيات الكلاسيكية خلال بضع جولات: تحريك الحواجز لإغلاق الأبواب، ونقل المنحدرات لبناء الجسور، واقتراب المنحدر لإعادة المحاولة بعد الفشل في تسلق الجدار.
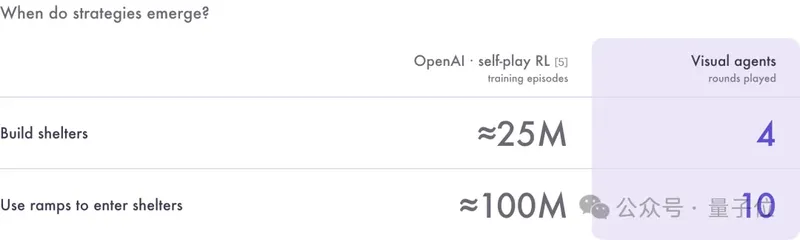
اشتهر بحث عام 2019 بظهور هذه السلوكيات الكلاسيكية، ويوفر أيضاً مقارنة بديهية (انظر الشكل 4): في تلك الدراسة، اعتمد الذكاء الاصطناعي على التعلم المعزز من الصفر، وتوصل إلى بناء المخابئ بعد نحو 25 مليون جولة؛ وتعلم تسلق الجدران بمساعدة المنحدرات بعد نحو 100 مليون جولة.
أما في AgentGarten، فيواجه الوكيلان صورًا بصرية بمنظور الشخص الأول، ويراجعان بين الأدوار ويعدّلان الدليل النصي، فتعلّم المختبئ بناء المخابئ في الدور 4، وأتقن الباحث تسلق الجدار بالمنحدر في الدور 10.
△ الشكل 4|مقارنة حجم المباريات المطلوبة قبل ظهور الاستراتيجيات الممثلة. دُرّب التعلم المعزز باللعب الذاتي من الصفر على حالات فيزيائية ممتازة عبر عشرات الملايين إلى مئات الملايين من الجولات؛ بينما يتصرف وكيل MirroS بناءً على مناظر مُصيَّرة بمنظور الشخص الأول، ويستوعب الاستراتيجيات بسرعة خلال بضع جولات عبر المراجعة الدورانية للدليل.
يلاعب ويدوّن في آن، محوّلًا الخبرة إلى كتابة
يعتمد التقدم السريع في Hide-and-seek على منظومة تدريب عامة.
منهج MirroS هو:جعل الوكيل نفسه "يدوّن الملاحظات بنفسه". فكل ما يتعلمه من معارف يكتبه في أدلة ومطبوعات.
تنقسم عملية التدريب إلى أربع مراحل متدرجة صارمة:
- استلام المهمة: يحصل الوكيل على ملف مهمة يحدد هدف العمل والخطوط الحمراء للقواعد، لكن دون أي إجابة نموذجية.
- التجربة والخطأ بالصندوق الأعمى: يتصرف الوكيل باستقلالية في ظل قيود صارمة على عدد الخطوات والوقت. لا توجد سوى صور الكاميرا، دون إحداثيات من علٍ، ولا خريطة مصغرة، ولا يمكن رؤية النقاط قبل نهاية المباراة.
- كتابة الدليل: بعد انتهاء كل جولة يجري الوكيل مراجعة ذاتية ويسجّل بصدق: ما جرّبه، وما الظواهر التي رآها، وأي الأحكام مشكوك فيها، وما الفرضيات الجديدة التي ينبغي التحقق منها في المرة القادمة.
- الأرشفة والتوريث: يُؤرشف الدليل ويُجمّد، ليُسلَّم مباشرة كإرث قبلي للوكيل في الجولة التالية.
بتصفّح هذه الدلائل التي كتبها الوكلاء، ستجدها غنية بطابع البحث العلمي. يفرّق النموذج بدقة بين "الوقائع المرصودة" و"التخمينات المتخيَّلة"، بل ويحرص على ترك إرشادات للقادمين لتجنب المخاطر:
- لخّص المختبئون حقيقة عملية تجريبية: "جوهر الدفاع في سدّ الممرات، وليس مجرد حجب خط الرؤية"، محذِّرين القادمين من الاستعانة بالزوايا الميتة لتقليل الثغرات، وباستخدام تحريكات طفيفة لاختبار مدى فعالية الحجب؛
- اكتشف الباحثون قاعدة في التحكم: "اسحب الشيء قليلاً للتجربة قبل نقله، ولا تخلط بين الالتصاق والإمساك المحكم"، إذ يضغطون مفتاح الشد الطفيف بعد الاقتراب، ويراقبون ما إذا كان الجسم يتحرك نسبةً إلى معالم الغرفة للتحقق من نجاح الإمساك الحقيقي به؛
- أما تحذير سائق يعبر الجسر فهو أكثر إثارة للتفكير: "انزلاق القرص المستهدف إلى النقطة العمياء أمام مقدمة السيارة لا يعني أن السيارة وصلت بأمان”。
الخبرات التي اجتازت الاختبار تبنّاها الخلف مواصلةً، أما الدروس الفاشلة فدفعتهم إلى تجربة فروع استراتيجية جديدة.
الحلقة نفسها، تُعاد بأربعة عوالم مختلفة
لخوض لعبة Hide-and-seek مجرد بداية. فبما أن عالم الشيفرة هو في جوهره بيئة برمجية قابلة للبرمجة، يمكن بسهولة تكرار حلقة "الاستكشاف—المراجعة—الترسيخ" نفسها في مزيد من السيناريوهات الأكثر تعقيداً.
جرّب الفريق أربع جولات من التدريبات في أربعة عوالم مختلفة تمامًا:
- مرافقة الجرويحتاج الوكيل إلى الحفاظ خلال 60 ثانية على رضا الجرو عبر مدّ يده لملاطفته ولعب الكرة في التوقيت المناسب. ارتفعت النتيجة من 13 نقطة في الجولة الأولى إلى 19 نقطة في الجولة 4.
- التقاطع على جسر ضيقتتفاوض مركبتان بناءً على منظور القيادة من منظور السائق الأول، وتتبادلان الطرفين عبر تقاطعهما على حارة واحدة ضيقة في أقصر وقت ممكن. انخفض الوقت الإجمالي لعبور المركبتين بشكل كبير من 71 ثانية إلى 41 ثانية.
- رعي الجراء التعاونييتعاون كلبان راعيان بتناغم تام بالاعتماد على رؤية كل منهما فقط، لدفع أربعة أغنام إلى الحظيرة والحفاظ عليها فيها لمدة 5 ثوانٍ. من تجاوز الوقت في الجولة 1 مع إدخال ثلاثة أغنام فقط، إلى تحقيق إدخال جميع الأغنام بثبات في الجولات الثلاث الأخيرة "دون أن تفوت أي واحدة".
- محمّلة المحاجريحتاج المحمّل الثقيل إلى دفع الحجارة وتغذية المواد وإدخالها إلى المستودع. في الجولة 1 نجح فقط بصعوبة في دفع الحجارة، بينما بحلول الجولة 4 أصبح قادرًا على إكمال المسار الكامل بسلاسة وبدون عناء ضمن حد 360 ثانية، قبل الموعد بـ31 ثانية.
توضح هذه المهام شديدة التنوع حقيقة واحدة: حلقة تراكم الخبرة هذه تنجح بالمثل في عوالم مختلفة تمامًا.
كيف تواكب الصورة الأداء: كيف تحقق 30 إطارًا في الثانية على بطاقة واحدة
لتمكين الوكيل من "الرؤية والعمل في آن واحد" في العالم الافتراضي، يجب على عارض الرسوم العصبي التغلب على ثلاث جبال ظلّت تُرهاق الفيديو التوليدي منذ فترة طويلة:مواكبة الأفعال المفاجئة، والحفاظ على الاستقرار في التفاعلات فائقة الطول، والعمل بسرعة كافية。
انطلق فريق MirroS من نموذج أساسي شامل الوسائط، وطرح طريقة تدريبAdversarial Forcingثم مع تحسينات الاستدلال، فتح هذا القناة البصرية:
1. من التوليد الكامل دون اتصال إلى التصيير المتدفق قطعةً بقطعة
اعتادت نماذج الفيديو سابقًا توليد المقطع بأكمله دفعة واحدة، لكن AgentGarten حوّلها إلى توليد متدفق قطعةً بقطعة. عند تنفيذ الوكيل لحركة ما، ينتج النموذج فورًا مقطع الصورة المقابل القصير، ليرى النتيجة بوضوح قبل اتخاذ القرار التالي.
2. عدم الانحراف في التفاعلات الطويلة (إعادة التشغيل الدقيقة)
كلما طال التوليد المتسلسل، زاد تراكم الأخطاء الدقيقة وتحوّلها إلى انحراف في المظهر. تقطع كثير من النماذج الرسم البياني الحسابي التاريخي لتوفير ذاكرة الفيديو، فلا يمكن للانحدار العودة إلى الذاكرة التاريخية؛ وإذا أُعيد حساب التسلسل بالكامل دفعة ثانية، فإن الاختلافات الدقيقة في ترتيب التنفيذ الأساسي تُحدث أخطاء بنسب عدة نقاط مئوية.
صمّم الفريق آلية إعادة تشغيل دقيقة: تمريرة أولى بتوسيع أمامي بدون انحدار، وتمريرة ثانية بتنفيذ جديد مع الانحدار وفق إيقاع قطع مطابق تمامًا، مما يعيد إنتاج مسار المحاكاة بدقة ويحافظ على الاتساق الزمني للتفاعلات طويلة التسلسل.
3. إدخال مواجهة بالفيديو الحقيقي: تجنب تدهور الصورة والشوائب
الاعتماد فقط على عينات يولّدها النموذج نفسه في تقطير الدرجات يجعل المحاكاة الطويلة عرضة للتشوه وظهور شوائب شبكية.
أدخل الفريق في التدريب مميّزًا للفيديو الحقيقي لبناء إشارة تنافسية، متخذًا الجودة البصرية الفيزيائية الحقيقية مرساةً، فيقيّد ملمس الصورة ويجعل نتائج التوليد تلتزم بدقة بالمعالم الهندسية التي يحددها الكود.
4. الحفاظ على تفاعل فوري يتجاوز 30 إطارًا في الثانية
كتب الفريق عمليات دمج مخصصة بلغة Triton يدويًا، فألغى التنقلات ذهابًا وإيابًا إلى ذاكرة الفيديو، وتجنّب انتظار الإقلاع البارد الذي يستغرق دقائق في تجميع الصور الكاملة التقليدي؛ ومع استخدام CUDA Graph لإلغاء عبء جدولة المعالج المركزي، وتبني وحدة فك ترميز فائقة الخفة تقل زمن استجابتها عن 10 ميلي ثانية، دعم في النهاية التفاعل الحلقي باستقرار بدقة 480p وإنتاجية تتجاوز 30 إطارًا في الثانية.
عوالم قابلة للعيش لخدمة وكلاء يتطورون باستمرار
الكود القابل للتنفيذ يجعل عوالم التدريب قابلة للتوليد البرمجي بلا نهاية؛ والمُصيّر المُتعلَّم يمنح هذه العوالم تغذية راجعة فيزيائية واقعية قابلة للإدراك؛ ودليل التجارب المتراكم يجعل كل محاولة استكشاف درجةً للجولة الاستكشافية التالية.
بدمج هذه الثلاثة، يحصل الوكيل على مساحة يمكنه فيها الاستكشاف والخطأ والتطور حقًا.
هذه هي بالضبط الفكرة الجوهرية التي يستكشفها MirroS في Physical RSI (التحسين الذاتي التكراري في العالم الفيزيائي).
وبينما يتسارع التوسع (Scaling) في النماذج اللغوية بمشاعل مضاءة، فإن التوسع في الذكاء داخل العالم الفيزيائي لا يزال في مطلع افتتاحه للتو.
الذكاء المتجسد العام الحقيقي يحتاج إلى النمو المستمر من خلال التفاعل الحقيقي المتكرر مع العالم المادي:
اجعل كل مجهول نقطة انطلاق للجولة التالية من التطور.
المدونة الكاملة: https://mirros.ai/blog/worlds-for-evolving-agents
*نُشرت هذه المقالة بموجب ترخيص من 量子位، والآراء مملوكة للمؤلف الأصلي فقط.