
ون لو بالتقاط من أو في سي
量子位 | حساب QbitAI على WeChat
فريق Seed في بايت ألقت القبض على الثنائية الإلهية-الشيطانية لـ DeepSeek.
السؤال نفسه، دون أي تغيير، فقط بإضافة بعض الرموز غير المهمة قبله، وفجأة يصبح النموذج عاجزًا عن حله؟؟؟
والأمر ليس مجرد تعثر عابر.
باحثو Seed وجدوا أن أداء DeepSeek-V4 يتغير مع موضع إدخال المعلوماتبشكل دوري كل 4 Tokens。
ماذا يعني هذا؟ قدرة النموذج على تذكر شيء ما تتوقف على موضع هذا الشيء في الإدخال؟؟
Token إضافيان في المقدمة قد يحولان الإجابة من خاطئة إلى صحيحة، وToken إضافيان آخران يعيدانها إلى الخاطئة.
رائع، أصبح النموذج يهتم بالموضع عند الإجابة.
في اختبار الاسترجاع بسياق طويل 128K، وجد الباحثون أن مجرد تغيير موضع معلومة واحدة يغير دقة استرجاع نماذج سلسلة DeepSeek-V4بفارق يصل إلى 40.2 نقطة مئوية。
ووجد الفريق أن هذه المشكلة مرتبطة بتقنية تحسين السياق الطويل المعتمدة في DeepSeek-V4 وهي
ضغط KV Cache المجزأ。
كانت هذه التقنية مصممة أصلاً لتمكين النموذج من معالجة النصوص الطويلة بنسيج أكبر وكفاءة أعلى.
لكن بعد الضغط، جعلت النموذج يتأرجح بين الإلهية والشيطانية (doge).
Token إضافيان، وفجأة يجيب DeepSeek إجابة صحيحة
بدأ باحثو Seed في بايت بتجربة تستخدم كود DeepSeek نفسه.
جسم الاختبار هوDeepSeek-V4-Flash-Base。
استخرجوا من كود الاستدلال الرسمي لـ DeepSeek-V4 مقطعًا من دالة تكميم FP8 وطلبوا من النموذج إكمال الـ Token الأخير.
الإجابة الصحيحة للمهمة يجب أن تكون 8، لأن هذا الكود يحتاج إلى إتمام تحويل من النوع المرتبط بـ FP8.
لكن النموذج كان يرى أحيانًا أن الإكمال يجب أن يكون 32.
للتحقق من سبب الأمر، أضاف الباحثون قبل الكود سلسلة توثيقية (docstring) زخرفية بحتة تحتوي على بعض علامات التساوي المتكررة.
ثم بدأوا في تعديل عدد علامات التساوي.
الكود نفسه لم يتغير، وموضع الإكمال لم يتغير، والإجابة الصحيحة بالطبع لم تتغير…… التغيير الوحيد هو أن هذه الرموز غير ذات المعنى الفعلي أصبحت في المقدمة.
وبالتالي بدأت إجابات DeepSeek تتأرجح ذهابًا وإيابًا.
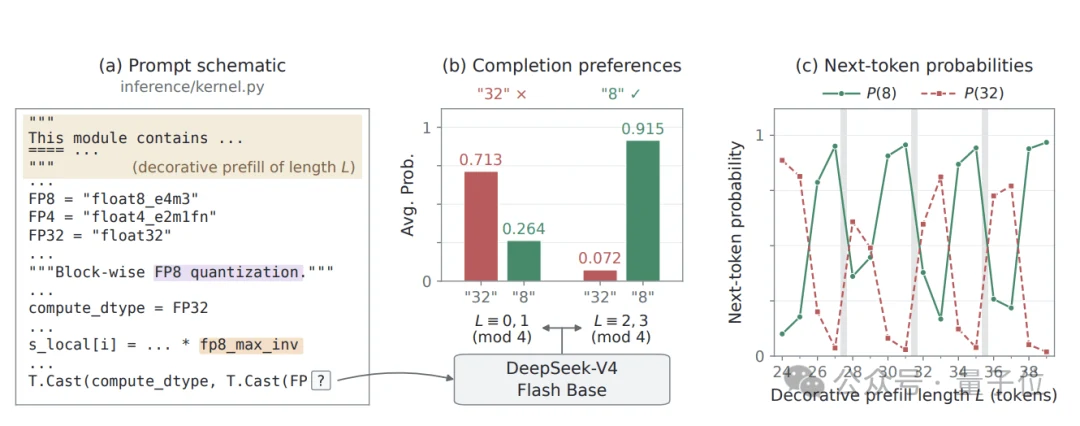
عندما يقع طول الحشو في مواضع معينة، يميل النموذج إلى الإجابة بالرقم الخاطئ 32.
وبتحريك Token أو اثنين إلى الأمام، يميل مجددًا إلى الرقم الصحيح 8.
وعند مواصلة الإزاحة يعود الجواب الخاطئ من جديد —
تتكرر العملية بأكملها بدورة من 4 رموز (Token)。
وبشكل أدق، من بين أطوال الحشو الـ16 التي اختبرتها الورقة، عندما يكون باقي قسمة الطول على 4 يساوي 0 أو 1، يميل النموذج إلى الجواب الخاطئ 32؛ وعندما يكون الباقي 2 أو 3، فإنه يميل إلى الجواب الصحيح 8.
كما قام الباحثون بإحصاء الاحتمالات التي خصصها النموذج لإجابتين مرشحتين.
في مجموعة من المواضع، وصل متوسط احتمال الإجابة الخاطئة 32 إلى 71.3%، بينما الإجابة الصحيحة 8 لم تتجاوز 26.4%.
وعند الانتقال إلى مجموعة أخرى من المواضع، انعكست الحالة تمامًا:
ارتفع متوسط احتمال الإجابة الصحيحة 8 إلى 91.5%، ولم يتبقَّ للإجابة الخاطئة 32 سوى 7.2%.
أي أنّ تغيّر طول بضعة أحرف غير ذات صلة في المقدمة يكفي لجعل النموذج يصدر حكمًا مختلفًا تمامًا عن المسألة نفسها.
وهذا أمر صعب التقييم بعض الشيء.
فعند تصحيح أخطاء الشيفرة، يفحص المبرمجون عادةً المنطق والمتغيرات والاعتماديات أولًا.
يبدو الآن أنه قد يلزم أيضًا فحص ما إذا كانت هناك علامتا تساوي زائدتان في المقدمة بالمناسبة.
لكن حالة واحدة لاستكمال الشيفرة لا تكفي لبيان مدى شيوع المشكلة.
ولذلك واصل فريق Seed توسيع نطاق الاختبارات.
وحوّلوا أنظارهم إلى مهمة كلاسيكية جدًا ضمن قدرات السياق الطويل للنماذج اللغوية الكبيرة،وهي البحث عن إبرة في كومة قش。
قام الباحثون ببناء سياق طوله 128K توكن يحتوي على نحو16 ألف زوج مفتاح-قيمة。
مثل K1 يقابل V1، وK2 يقابل V2... وهكذا
ثم طلبوا من النموذج أن يجد القيمة المقابلة لمفتاح محدد.
وأثناء الاختبار، ظلت علاقات المفاتيح والقيم ثابتة، والسؤال ثابتًا، و الطول الإجمالي للسياق متسقًا أيضًا.
ركز الباحثون على تعديلموضع المعلومات المستهدفة بالنسبة إلى حدود نافذة الضغط。
فوجدوا أن منحنى دقة سلسلة DeepSeek-V4 يُظهر تذبذبًا دوريًا واضحًا للغاية.
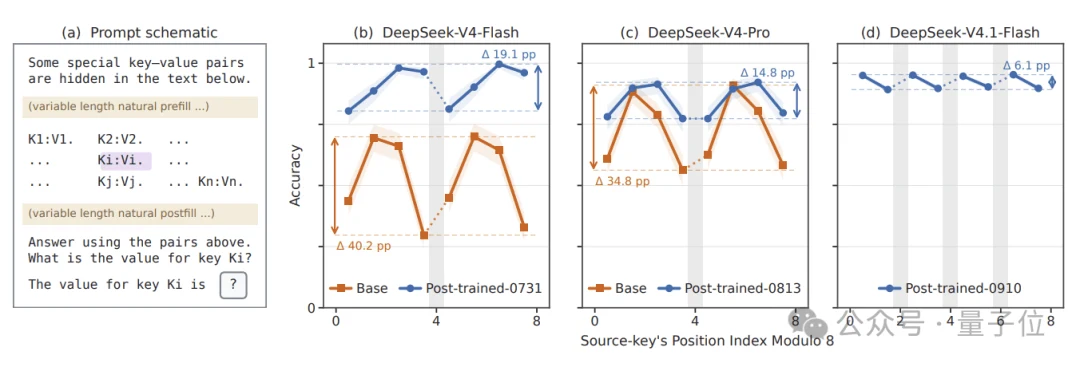
حيث بلغت الفجوة القصوى في الدقة بين المواضع المختلفة في DeepSeek-V4-Flash-Base 40.2 نقطة مئوية
وفي DeepSeek-V4-Pro-Base بلغت 34.8 نقطة مئوية.
وبعدالتدريب اللاحقتحسن الوضع بعض الشيء.
تقلصت الفجوة في DeepSeek-V4-Flash-0731 إلى 19.1 نقطة مئوية، وفي DeepSeek-V4-Pro-0813 إلى 14.8 نقطة مئوية.
أما DeepSeek-V4.1-Flash-0910 الأحدث، فانخفضت الفجوة فيه أكثر إلى 6.1 نقطة مئوية.
لكن الفروق الدورية لا تزال قائمة.
فمن أين يأتي هذا التباين؟
وبالنظر عن قرب، فإن دورة التذبذب في DeepSeek-V4 هي 4 توكنات، بينما أصبحت في DeepSeek-V4.1 تبلغ 2 توكن.
ووجد الباحثون أن هذايقابل تمامًا خطوة ضغط KV Cache التي تعتمدها كل جيل من النموذجين。
حسنًا، حتى دورات تذبذب الأداء في الإجابة عن الأسئلة تتطابق مع إعدادات الضغط في الطبقة السفلية.
هل المشكلة في ضغط KV Cache؟
حسنًا، فلنتحدث عن ضغط KV Cache.
عندما تعالج النماذج الكبيرة سياقات طويلة، تحتاج إلى حفظ كمية كبيرة من معلومات المفاتيح (Key) والقيم (Value) المقابلة للرموز (Token) التاريخية، لاستخدامها في حسابات الانتباه اللاحقة.
كلما طال السياق، زادت الذاكرة التي تشغلها هذه الكاش والتكلفة الحسابية المرتبطة بها.
خاصة في المهام الطويلة التي تصل رموزها إلى مئات الآلاف أو ملايين الرموز، يصبح KV Cache بسهولة عنق الزجاجة لكفاءة الاستدلال.
لذلك اعتمد DeepSeek-V4ضغط KV Cache بالتقسيم إلى كتل。
الفكرة هي تقسيم الرموز (Token) المتتالية إلى نوافذ، ثم ضغط المعلومات داخل كل نافذة إلى عدد أقل من مدخلات ذاكرة التخزين المؤقت.
بهذا لا يحتاج النموذج إلى الاحتفاظ بذاكرة تخزين مؤقت بنفس الحجم لكل رمز تاريخي.
وهذا يوفّر الذاكرة ويخفّض أيضًا تكلفة حساب الانتباه للسياق الطويل.
لكن فريق Seed اكتشف أن سبب ظهور الازدواجية «الإلهية والشيطانية» في DeepSeek قد يكون مخفيًا في عملية التقسيم هذه بالضبط.
لنفترض أن كل 4 رموز تشكّل خطوة ضغط واحدة.
إذن، عندما تظهر نفس المعلومة في الموضع رقم 1 أو 2 أو 3 أو 4 داخل النافذة، قد تختلف الظروف التي توجد فيها أثناء الضغط.
تسمّي الورقة هذا الموقع نسبةً إلى حدود نافذة الضغطPhase (الطور)。
وجد الباحثون أنقدرة النموذج على استرجاع المعلومات تختلف اختلافًا منهجيًا بحسب الطور الموجودة فيه。
وقد سمّوا هذه الظاهرةPhase Sensitivity، أي حساسية الطور。
ولتوضيح الأمر بمثال، لنفترض أننا نعطي النموذج المادة نفسها:
في التنسيق الأول، تقع الأرقام الأساسية تمامًا في المواقع التي يحتفظ بها النموذج بسهولة؛
أما في التنسيق الثاني، فلا يُضاف في البداية سوى بضعة أحرف، لكن موقع الأرقام الأساسية بالنسبة إلى نافذة الضغط يتغيّر.
المادة هي نفسها، غير أن قدرة النموذج لاحقًا على العثور على الأرقام قد تختلف اختلافًا واضحًا.
فضلاً عن ذلك، لا يمكن اختزال هذه المشكلة ببساطة في أن «المعلومة وقعت مصادفةً محصورة بين نافذتين».
وجد الباحثون أن دقة الاسترجاع قد تتفاوت كثيرًا بين المواقع المختلفة حتى عندما يقع كل من Key وValue داخل نافذة الضغط نفسها.
وهذا يعني أن المشكلة تتعلق أيضًا بكيفية كتابة النموذج للمعلومات في ذاكرة التخزين المؤقت المضغوطة، وكيفية قراءتها منها لاحقًا.
وللتأكيد بشكل أعمق، قام فريق Seed بتدريب مجموعة من النماذج بنفسه من الصفر.
وقد اعتمدوامعمارية Qwen3-0.6Bكأساس، وشكّلوا عدة مخططات لضغط KV Cache، مع إعداد نموذج انتباه كامل بدون ضغط بالتقسيم كعنصر مقارنة.
وكان التركيز على تغيير آلية الضغط فقط، لمعرفة ما إذا كانت التقلبات الدورية ستظهر تبعًا لذلك.
والنتيجة أنجميع نماذج الضغط بالتقسيم التي خضعت للاختبار أظهرت تغيرات دورية تتناسب مع خطوة الضغط。
في المقابل، لم يُظهر نموذج الانتباه الكامل المرجعي تقلبات دورية بالدرجة نفسها.
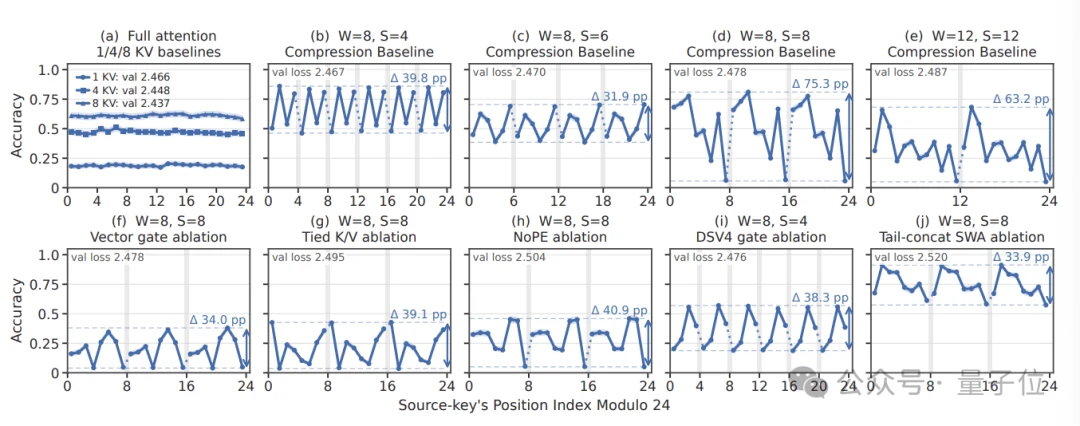
كما عدّل الباحثون حجم النافذة وخطوة الضغط كلًا منهما على حدة، فوجدوا أن الدورة تتبع أساسًا خطوة الضغط.
فعندما تكون خطوة الضغط 4، يتذبذب الأداء بدورة تقارب 4 رموز؛
وعندما تكون الخطوة 6، تصبح الدورة أيضًا حوالي 6 رموز؛
وطول الخطوة 8، الأمر نفسه ينطبق؛
……
حتى عند عدم استخدام ترميز المواقع RoPE، أو عند استبدال أوزان الضغط القابلة للتعلم بمتوسط بسيط، تظل هذه الظاهرة قائمة.
بعبارة أخرى، المشكلة ليست ناجمة عن ترميز موقع معين أو وحدة خاصة معينة على حدة.
فتصميم الضغط على شكل كتل في حد ذاته قد يُدخل نقاط ضعف دورية في الاسترجاع.
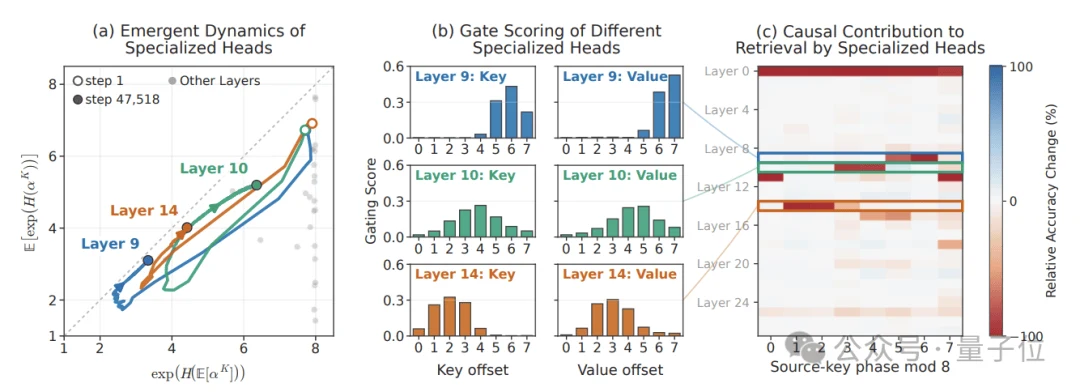
وقد أجرى فريق Seed تدخلاً إضافياً على رؤوس الانتباه لمراقبة كيفية تغير قدرة النموذج على الاسترجاع في كل طور بعد إزالة مكونات مختلفة.
وتوصلوا إلى أن مساهمة رؤوس الانتباه المختلفة تختلف باختلاف الأطوار.
فبعض الرؤوس أكثر مهارة في معالجة المعلومات في مواقع معينة، بينما تلعب رؤوس أخرى دوراً أكبر في مواقع أخرى.
أطلق الباحثون على هذه الظاهرة اسم Phase Specialization، أي التخصص الطوري.
أي أن النموذج يبدو أنه شكّل داخلياً نوعاً من تقسيم العمل: مكونات الانتباه المختلفة طوّرت تفضيلاً ل_positions_ مختلفة داخل نافذة الضغط.
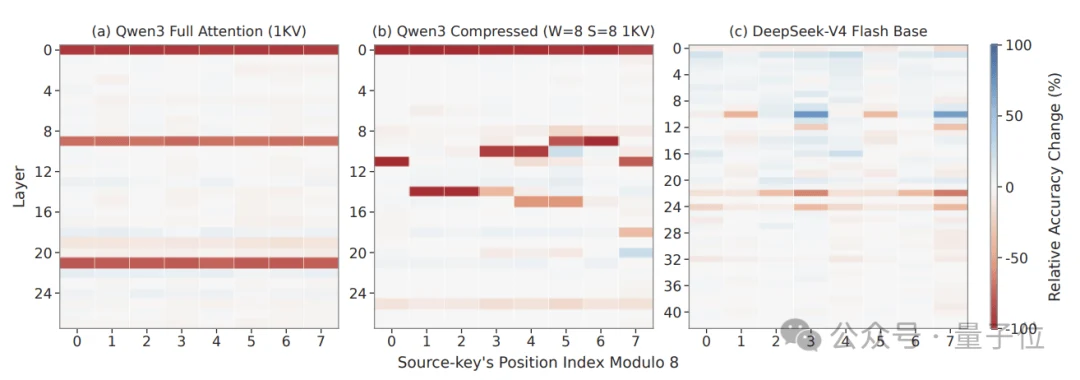
وقد يساعد هذا التقسيم للعمل النموذج على إنجاز استرجاع المعلومات، لكنه قد يجعل بعض المواقع حلقات ضعيفة نسبياً.
كما حلّلت الورقة عملية التدريب من خلال نموذج نظري مبسّط، ووجدت أن تدفق التدرجات قد يدفع وحدات الضغط إلى تكوين تفضيلات مستقرة للمواقع.
وهذا يفسّر لماذا هذا التذبذب الدوري ليس مجرد ضجيج عشوائي بسيط. فقد يكون نتيجة طبيعية لعملية تعلّم النموذج كيفية ضغط المعلومات.
لكن هذا النوع من المشاكل قد لا يظهر مباشرة في مقاييس Benchmark العادية، لأن التقييمات المعتادة عادةً تجمع عدداً كبيراً من نتائج الاختبار في درجة متوسطة واحدة.
لنفترض أن النموذج يحقق أداءً جيداً في بعض المواقع، وأداءً أضعف بوضوح في مواقع أخرى، فإن متوسط الدرجات النهائي قد يبقى جيداً على أي حال.
لذلك اقترح فريق Seed أن تقييم النماذج التي تعتمد تقسيم KV Cache إلى كتل لا يجب أن يقتصر على النظر إلى دقة الاسترجاع الإجمالية، بل يجب أيضاً وضع المعلومة نفسها في أطوار ضغط مختلفة واختبارها كل مرة على حدة.
ومع وجود هذا الانحراف في الأداء الناتج عن المواقع، فإن تكاليف الذاكرة والحوسبة للاستدلال بالسياق الطويل تظل قائمة، ولذلك يبقى للضغط قيمة واقعية كبيرة.
لكن بعد توفير ذاكرة التخزين المؤقت، قد لا يتعامل النموذج مع المعلومات في المواقع المختلفة بإنصاف كما كان.
وبالطبع، من نتائج التجارب هذه، يبدو أن التدريب اللاحق وتكرار تحسين البنية قادران فعلاً على تقليص هذه الفجوة بشكل ملحوظ.
رابط الورقة: https://arxiv.org/pdf/2609.36322