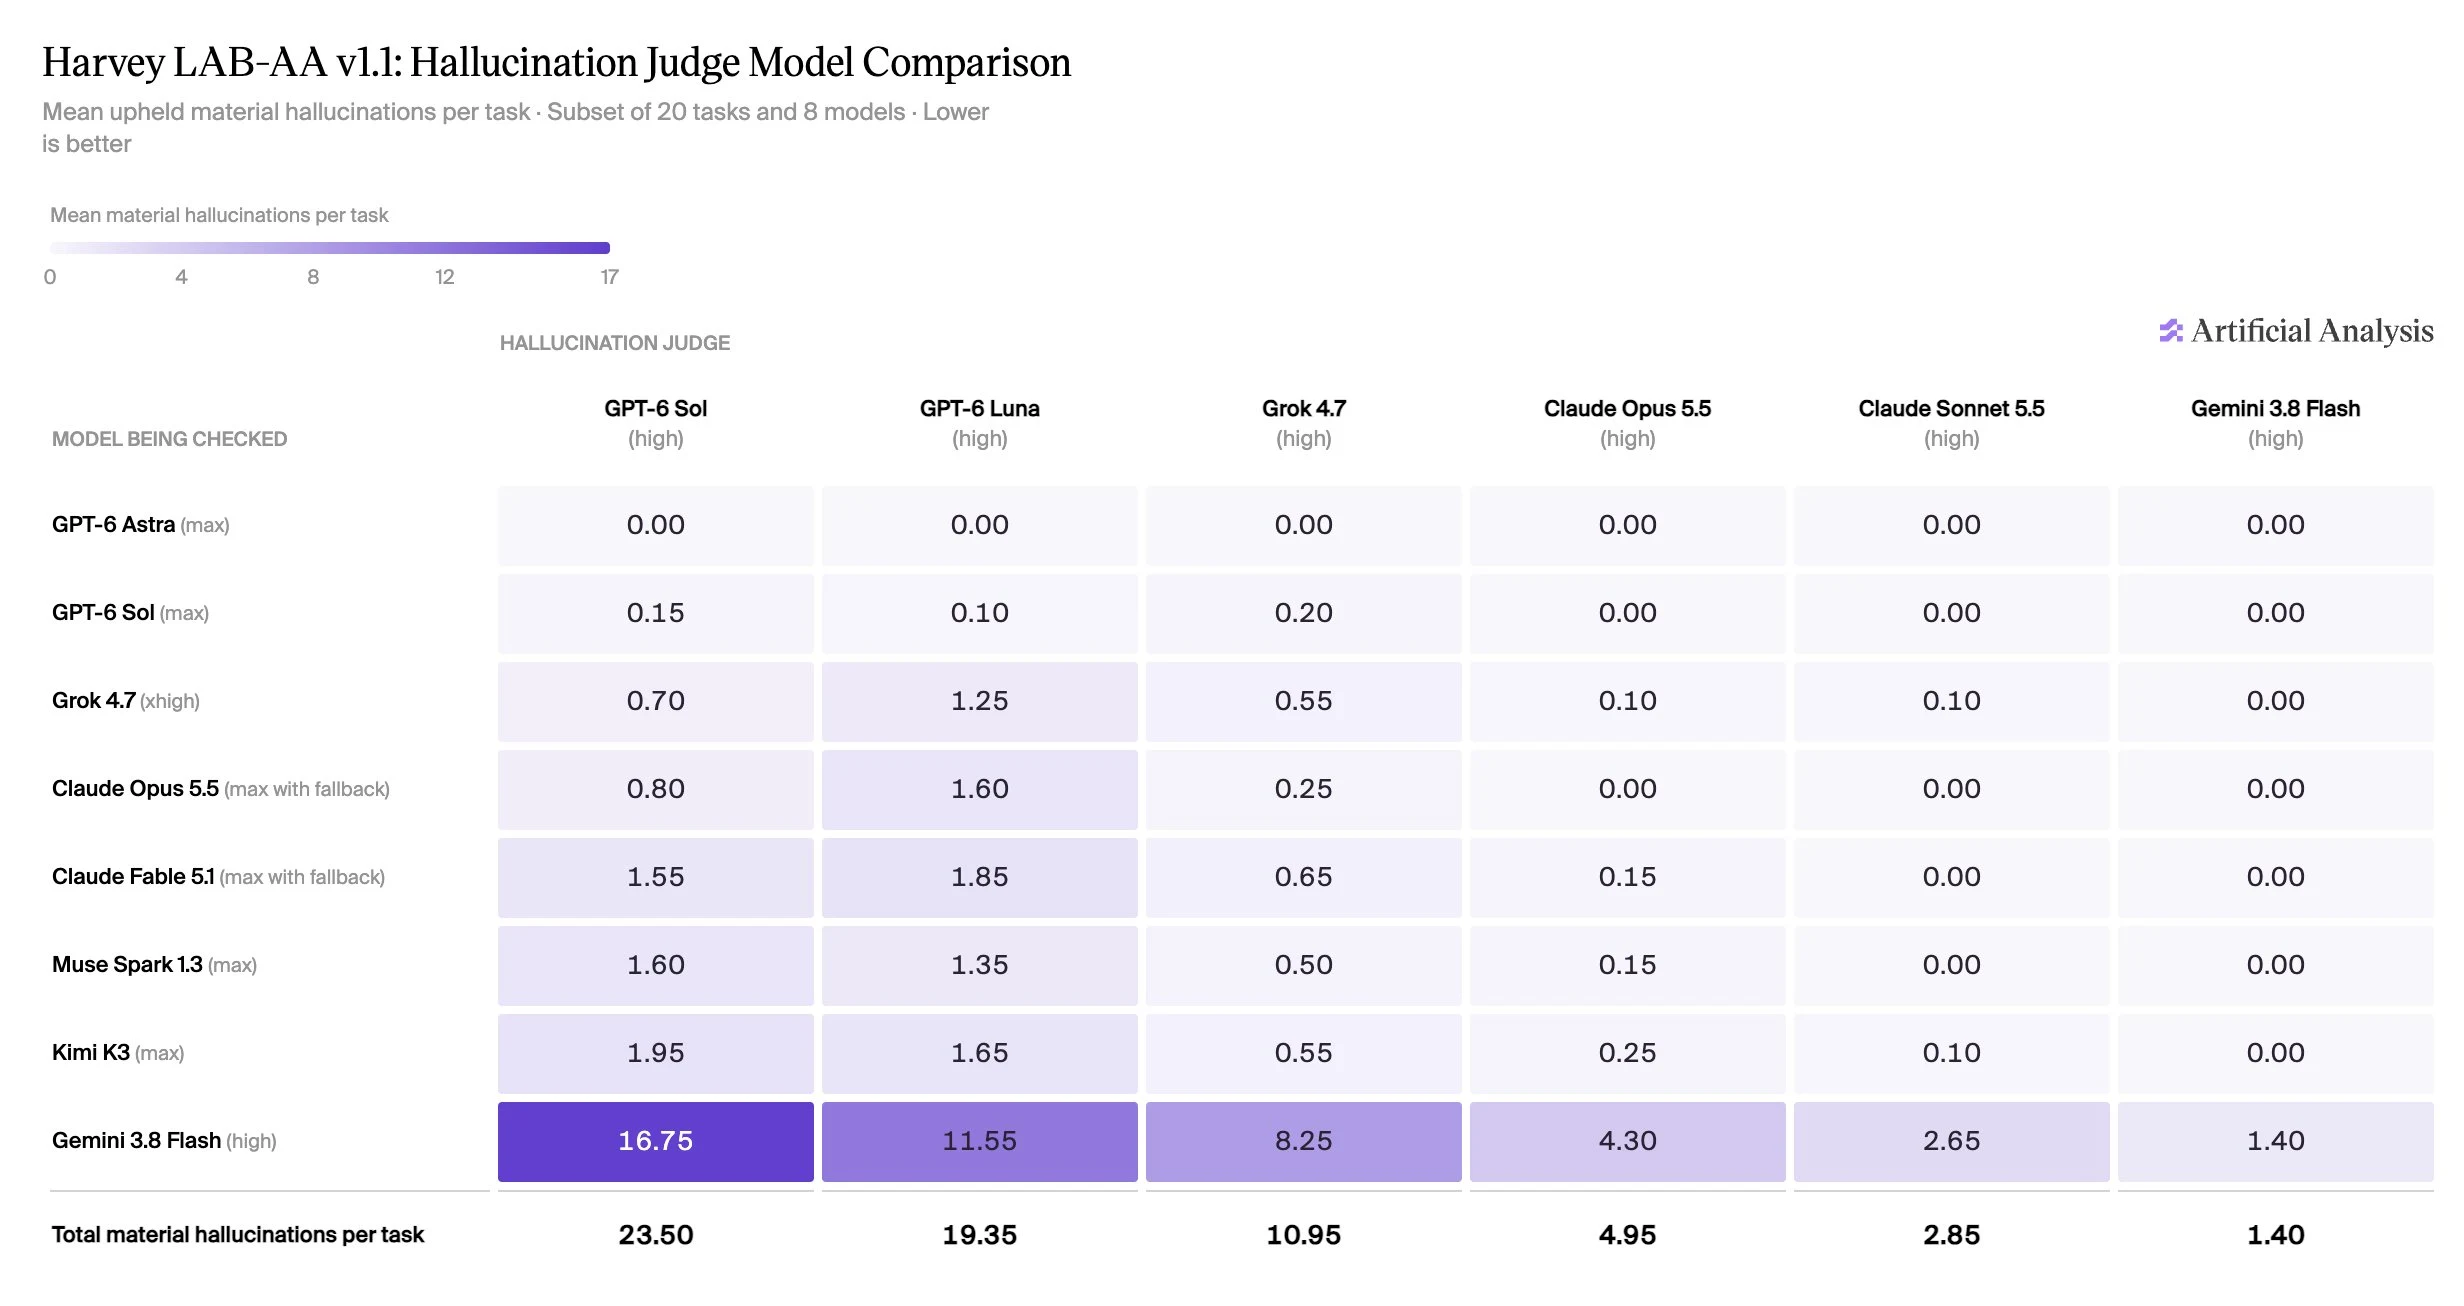
قارنّا ستة أدوات للتحقق من الخرافات على نفس المخرجات من مجموعة ثابتة تضم 20 مهمة وثمانية نماذج. قمنا بتشغيل فحصنا ذا المرحلتين باستخدام GPT-6 Sol (عالي)، وGPT-6 Luna (عالي)، وGrok 4.7 (عالي)، وClaude Opus 5.5 (عالي)، وClaude Sonnet 5.5 (عالي)، وGemini 3.8 Flash (عالي)، واخترنا GPT-6 Sol (عالي) للاستخدام في الإنتاج.
على مستوى هذا المجموعتين المكونتين من 20 مهمة، حدد GPT-6 Sol وGPT-6 Luna عددًا أكبر من الأوهام المادية، بينما حدد Claude Sonnet 5.5 وGemini 3.8 Flash عددًا أقل بكثير. كان Claude Opus 5.5 في نطاق بين Grok 4.7 وClaude Sonnet 5.5 في كل صف من النماذج. بشكل عام، حدد Opus 99 وهامة مادية، مقارنة بـ 219 لـ Grok، و57 لـ Sonnet، و470 لـ GPT-6 Sol. تم التعرف على المزيد من الوهمات المادية بواسطة GPT-6 Sol، رغم النهج المحافظ للتحقق من الأخطاء، والذي يستبعد المعرفة القانونية العامة التي لا توجد في وثائق المصدر.
لم يجد كل ستة مراقبين أي وهم مادي في نتائج GPT-6 Astra، بينما كان متوسط GPT-6 Sol بين 0 و0.20 لكل مهمة. كان كلا النموذجين من بين النماذج التي تحتوي على أقل عدد من الوهم المادي أمام كل مراقب. تُظهر هذه المقارنة اختلافات في سلوك المراقبين؛ فالأرقام وحدها لا تثبت الدقة أو تبطل التفضيل الذاتي.