
بقلم يي شوي من أو في سي
量子位 | الحساب الرسمي QbitAI
أن يلعب ألعاب الفيديو ويرفع مستواه في آنٍ واحد؟
يا للعجب، لقد جعلت هوا الذكاء الاصطناعي يتقن فكرة «التحسن أثناء اللعب»!
في أحدث دراسة، أخرجت مختبرات Noah's Ark التابعة لهوا، بالتعاون مع فرق منها UCL وغيرها، نظامًا للوكلاء الذكاء الاصطناعي اسمهMemento 3لنظام الوكلاء الذكي —
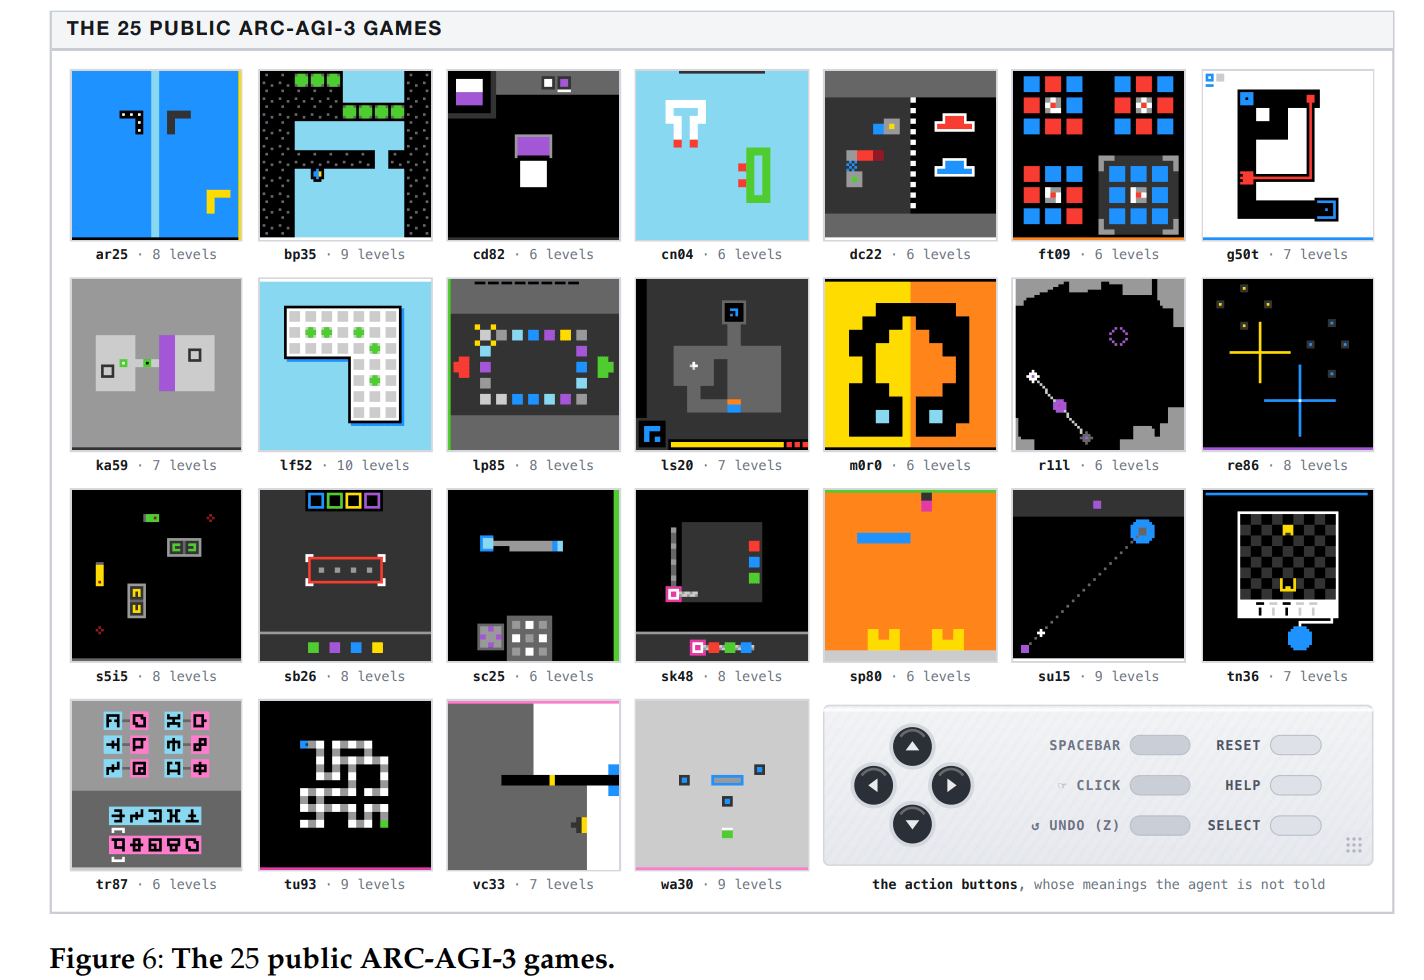
اجتاز جميع ألعاب مجموعة ARC-AGI-3 العامة البالغ عددها 25 لعبة و183 مستوى.
ولم ينجح ذلك عبر التجربة والخطأ الأعمى.
يحتاج البشر إلى 17135 عملية لإنجاز المجموعة نفسها من المستويات.
بينما استخدم Memento 3 فقط 7518 عملية،أي أقل من البشر بنحو 56%، ليحقق في النهاية نتيجة كاملة 100 في مؤشر RHAE(Relative Human Action Efficiency، كفاءة الفعل النسبية مقارنة بالبشر).
والأكثر إثارة للدهشة أنهذا النظام يعتمد على Claude Opus 5 كنموذج أساس، دون تحديث أوزان النموذج طوال الوقت ودون ضبط دقيق خاص بالألعاب。
لقد بدأ اللعب بنفسه، واستنتج القواعد بنفسه، وكتب الشيفرة بنفسه، وعندما يخطئ يفكّر ويراجع ويرمّم.
ثم... اجتاز كل شيء بالنقطة الكاملة.
للمقارنة، سجّل Claude Opus 5 ضمن إطار الاختبار الرسمي لمعيار ARC Prize متوسط RHAE يقارب 40.7 نقطة فقط.
النموذج الأساس نفسه، مع تغيير نظام الوكلاء فقط، فارتفعت النتيجة مباشرة بمقدار 59.3 نقطة.
والأمر لا يتوقف هنا.
هذه الطريقة لا تقتصر على ألعاب الألغاز؛ فقد جعل فريق البحث الوكيل يلعب أيضًا اللعبة الكلاسيكية من Atari وهي Pong (كرة الطاولة).
وكانت النتيجة أن الذكاء الاصطناعي اكتشف بنفسه استراتيجية التحكم، ثم دون الحاجة إلى طلب استدلال من النموذج الكبير، حقق ثلاث جولات متتالية بنتيجة 21:0 على الخصم.
لحظة، كيف يمكن أن تُلعب اللعبة بهذه البراعة دون مشاركة النموذج الكبير في العمليات اللاحقة؟!
المفتاح مخفي في عنوان هذه الدراسة:
Model-Based Recursive Self-Improvement، التحسّن الذاتي التكراري القائم على نموذج العالم。
ذكاء هوا الاصطناعي يجتاز 25 لعبة كاملة، بعدد عمليات أقل من البشر بنسبة 56%
لنتحدث أولًا عن خلفية هذه الألعاب الـ25.
إنها من ARC-AGI-3 الذي أطلقه ARC Prize، ومن يتابع تقييمات الذكاء الاصطناعي لا بد أن يكون على دراية بسلسلة ARC.
لكن هذه الجيل يأتي بتغيير واضح جدًا:
لم تعد مجرد مسألة طرح أسئلة وحلها؛ هذه المرة تم إلقاء الذكاء الاصطناعي مباشرة في عوالم ألعاب غريبة.。
القواعد، على الذكاء الاصطناعي نفسه أن يخمّنها؛ الأهداف، على الذكاء الاصطناعي نفسه أن يجدها؛ وما الذي ستنتجه العمليات من تأثيرات، على الذكاء الاصطناعي نفسه أن يجربها.
الذكاء الاصطناعي: إذن كله يعتمد عليّ أنا إذن~
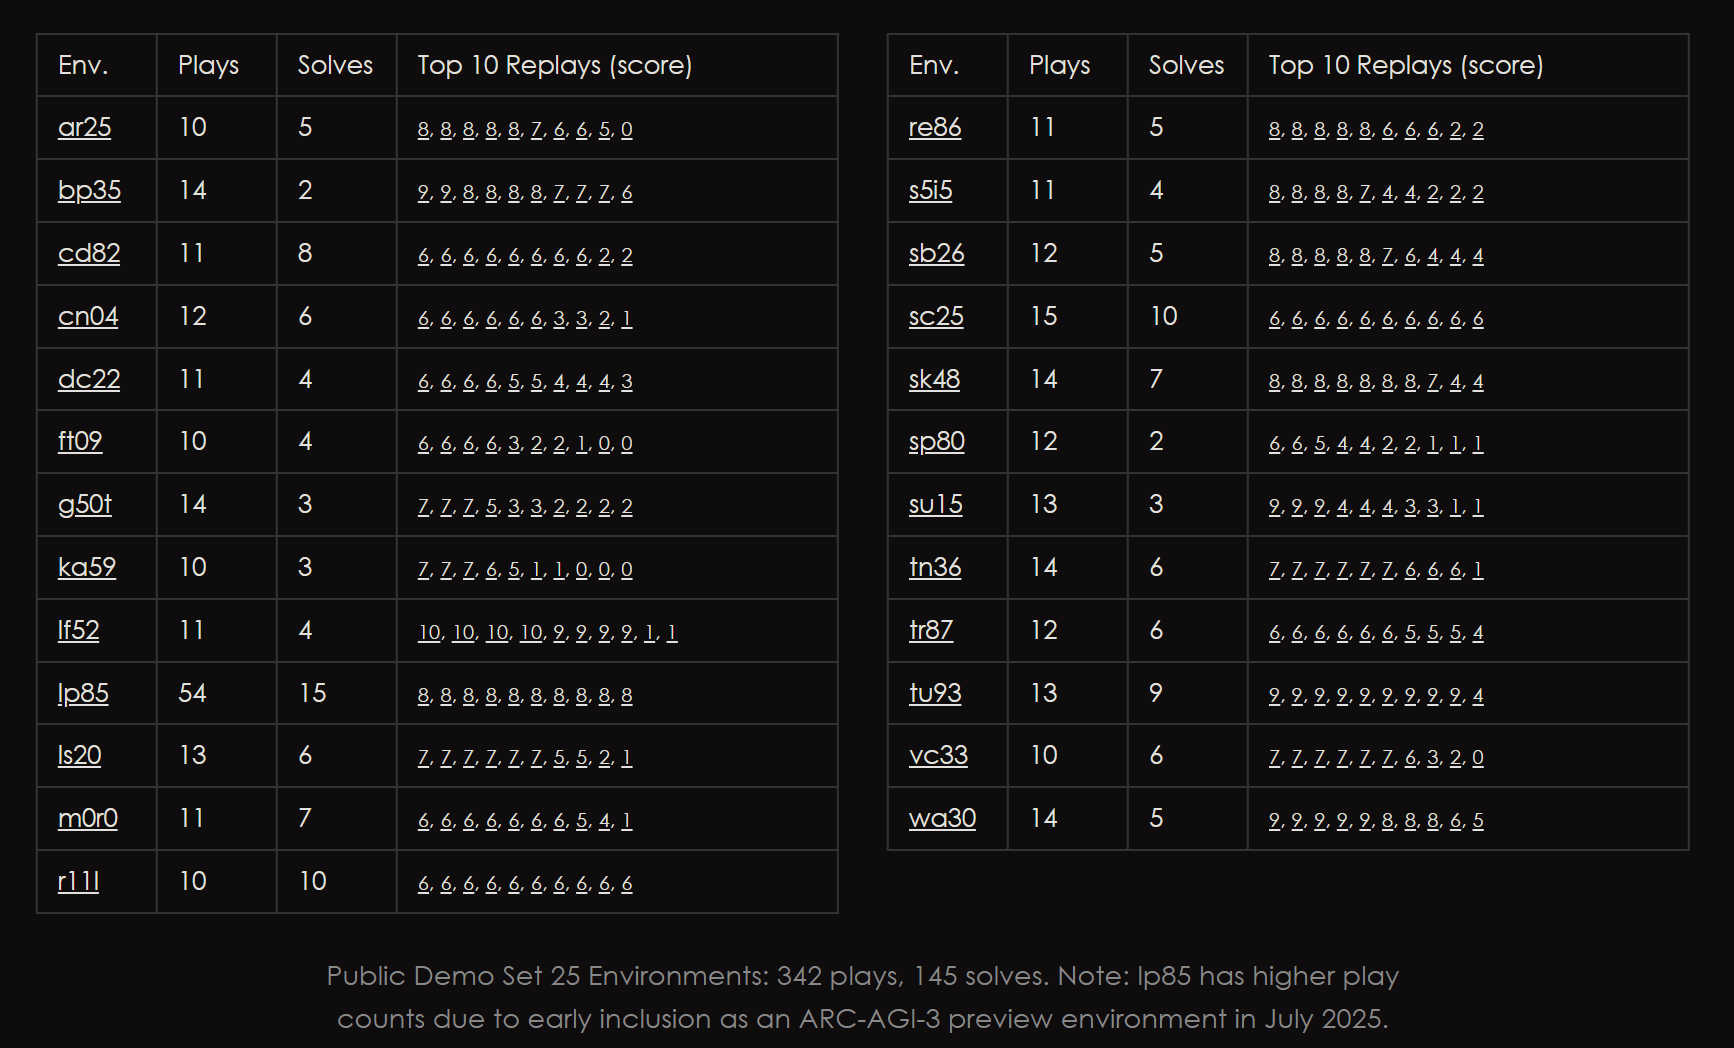
تضم هذه الألعاب الـ25 المعلنة إجمالاً 183 مرحلة، وتتكون معظم رسومها من بكسل بسيط ومكعبات وألوان وأشكال.
للوهلة الأولى، تبدو حتى وكأنها مجموعة ألعاب صغيرة من عقود مضت.
لكن لا تدع هذا الطراز الفني البسيط يخدعك.
بالنسبة للذكاء الاصطناعي، ليست طريقة التشغيل هي الأصعب، بل الأسوأ أنه لا يعرف على الإطلاق كيف يعمل هذا العالم.
ماذا سيحدث عند القدم على أرضية خاصة؟ باب لا يُفتح — هل المشكلة في عدم تطابق اللون أم في عدم تطابق الشكل؟
والأمر الأكثر تعقيدًا أن المراحل اللاحقة قد تتضمن قواعد جديدة تُسقط كل الخبرات التي تم التوصل إليها سابقًا.
بل إن اللاعبين من البشر أيضًا، وليس الذكاء الاصطناعي فقط، يعلقون أحيانًا.。
تُظهر بيانات اختبار ARC Prize أنه في لعبة الألغاز r11l التي تتطلب التحكم في أميبة تتحرك وتغيّر لونها، أكمل جميع المشاركين الـ10 اللعبة بنجاح؛ بينما في لعبة الألغاز الأخرى tr87 التي تختبر قدرة فك رموز الرموز، من بين 12 متحدّيًا لم ينجح سوى 6.
وقبل هواشي للذكاء الاصطناعي، كانت فرق البحث المختلفة تتنافس بشراسة بالفعل:
أطلقت جامعة برينستون نظام Continual Harness الذي أكمل 3 ألعاب فقط، محققًا 20.5 نقطة.
كان نظام DreamTeam الذي شارك باحثو إنفيديا في تطويره أفضل قليلًا، إذ أكمل 6 ألعاب برصيد 38.1 نقطة.
وفوق ذلك، حصل نظام OPINE-World الذي طوّره الباحث المستقل David Courtis، ونظام NOOA من فريق إنفيديا، على 78.4 نقطة و85.1 نقطة على التوالي.
أما الأقوى فهو baseline1 من المطور المستقل Sergey Rodionov، الذي لم يكتفِ بإكمال جميع الألعاب الـ25، بل حصد أيضًا 99 نقطة، أي بفارق نقطة واحدة (1) فقط عن العلامة الكاملة.
لكن فريق هواشي هذه المرة سدّى تلك النقطة الأخيرة (1) مباشرةً.。
فنظام Memento 3 لم يكتفِ بإكمال جميع الألعاب الـ25 ومراحلها الـ183 بعلامة كاملة قدرها 100 نقطة، بل خفّض إجمالي عدد العمليات إلى 7518 عملية، أي أقل بمقدار 829 عملية من الـ8347 التي حققها baseline1.
لم يكتمل اللعب فحسب، بل اكتمل بخطوات أقل.
كيف تحقق ذلك؟؟
دون تدريب نموذج ضخم، يحقّق الذكاء الاصطناعي "الترقّي على الوحوش" من خلال كتابة دليل اللعب لنفسه.
بعد الاطلاع على الورقة البحثية، تبيّن أن الطريقة الجوهرية في Memento 3 تسمىCode as Model (الشيفرة كنموذج)。
قد يبدو الاسم غامضًا بعض الشيء، لكنه في جوهره يعني أن الذكاء الاصطناعي يجهّز لنفسه شيئين أثناء لعب اللعبة:
دليل لعب يتحدّث باستمرار، ومجموعة من الشيفرات قادرة على محاكاة تشغيل اللعبة.
- Rulebook (كتيّب القواعد): وثيقة بصيغة Markdown تسجّل القواعد التي اكتشفها الذكاء الاصطناعي في اللعبة، مثل العمليات التي تؤدي إلى أي تأثيرات، وكيفية إكمال المراحل، إضافة إلى القواعد التي لم يفهمها بعد.
- Executable World Model (نموذج العالم القابل للتنفيذ): يحوّل الذكاء الاصطناعي القواعد التي استخلصها مباشرةً إلى شيفرة Python قابلة للتشغيل، أي أنه بنا بنفسه محاكيًا مبسّطًا للعبة.
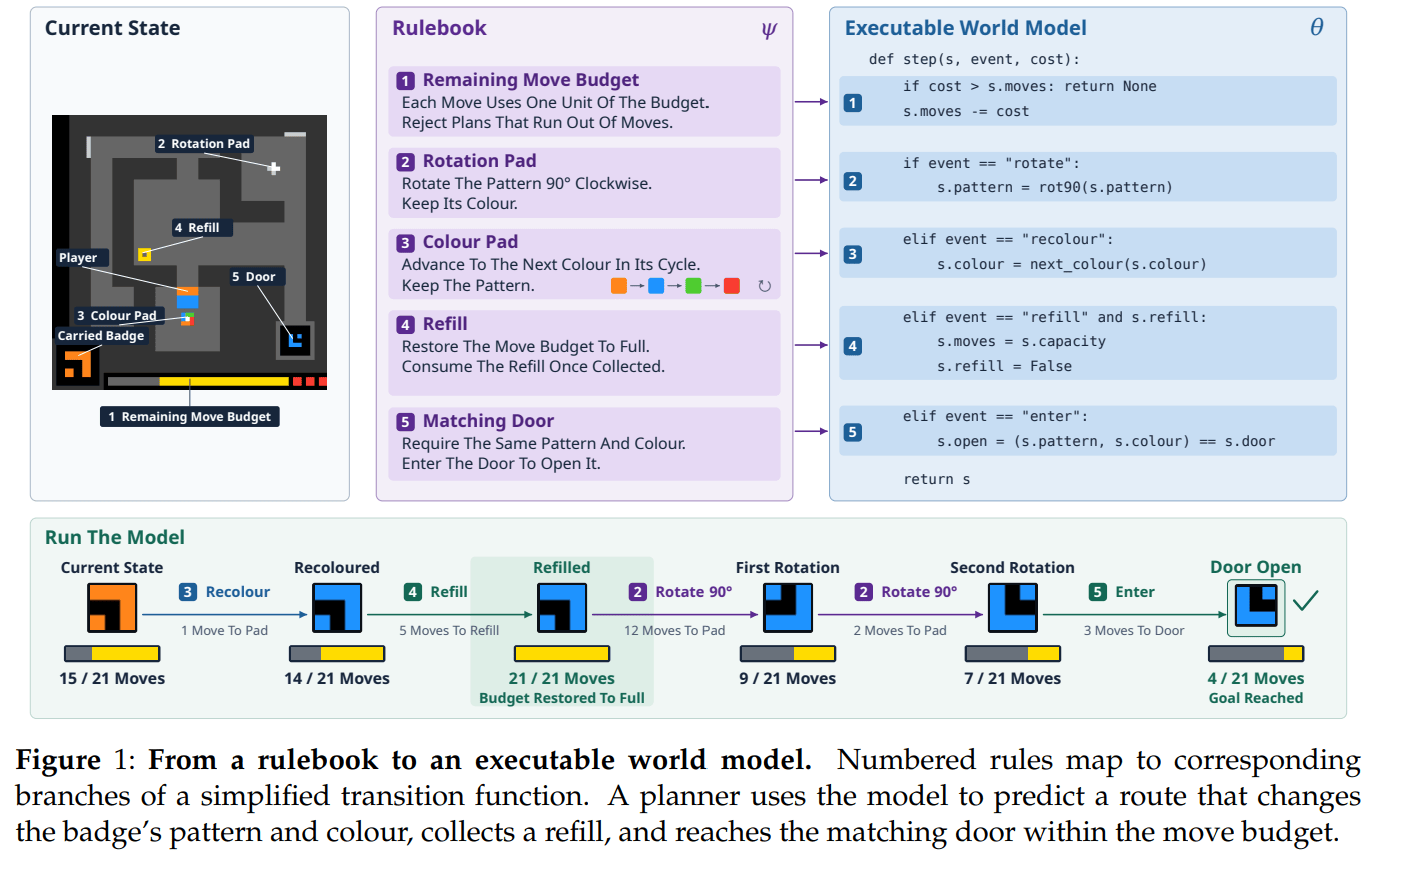
وبامتلاك هذين العنصرين، يستطيع الذكاء الاصطناعي أن يستعرض مسارات مختلفة في المحاكي الذي بناه بنفسه قبل أن يقرر خطوته التالية.
لكن تبرز مشكلة: ماذا لو كانت قواعد اللعبة المفهومة في البداية خاطئة أصلًا؟
لا تقلق،فنظام Memento 3 لا يكتب دليل اللعب بنفسه فحسب، بل إن اكتشف خطأً فيه يستطيع أيضًا نقضه وإعادة الكتابة من جديد.。
وتعرض الورقة البحثية مثالًا على ذلك.
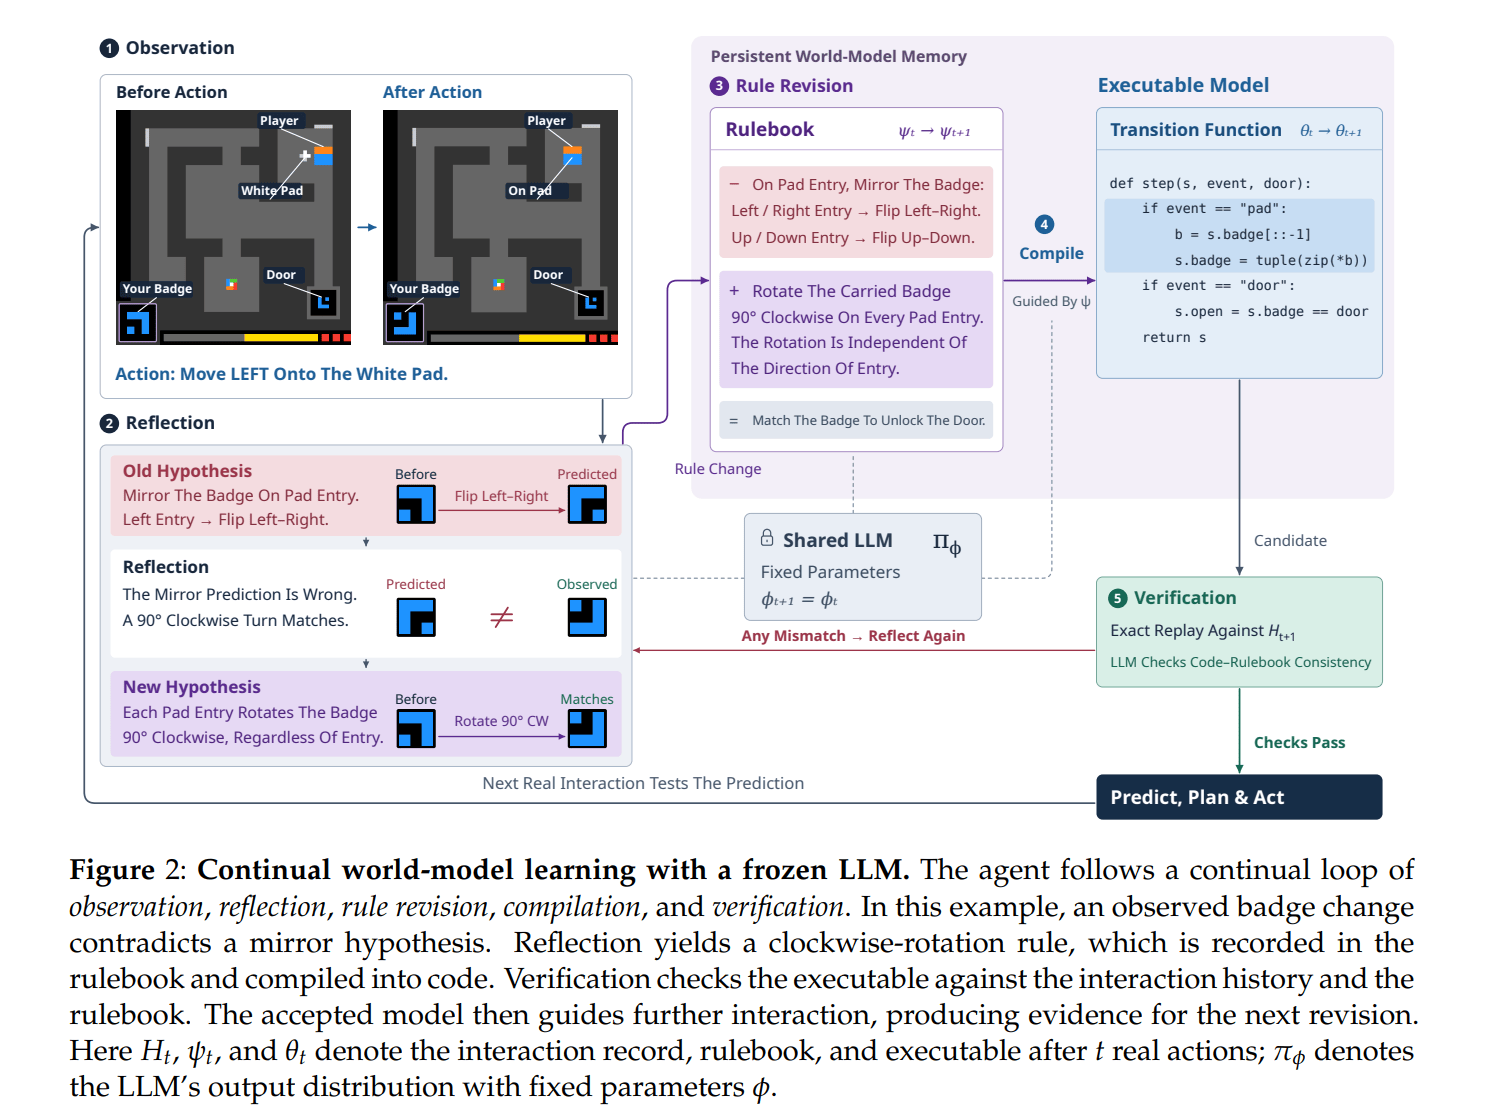
واجه الذكاء الاصطناعي في إحدى ألعاب الألغاز أرضية خاصة، وظنّ في البداية أن القدم عليها يجعل النمط الذي يحمله الشخصية ينقلب انعكاسًا مرآتيًا بحسب اتجاه الدخول.
لكن عند التجربة الفعلية تبيّن أن النمط لا ينقلب بل يدور 90 درجة باتجاه عقارب الساعة، وذلك بصرف النظر عن اتجاه الدخول.
فعدّل الذكاء الاصطناعي كتيّب القواعد، وتحدّثت شيفرة Python المقابلة تبعًا لذلك.
غير أن التعديل لا بد أن يتبعه تحقّق.
يعيد النظام محاكاة العمليات السابقة، ويقارن مشاهد اللعبة 64×64 خانةً بخانة، للتأكد من أن الشيفرة تعيد إنتاج النتائج الحقيقية بدقة.
وإن لم تتطابق، يستمر في التعديل.
وهكذا يستكشف الذكاء الاصطناعي ويصحح أخطاءه في آنٍ واحد، فتصبح القواعد أدق كلما عُدِّلت.
كما أن الخبرات المكتسبة سابقًا يمكن نقلها إلى المستويات اللاحقة。
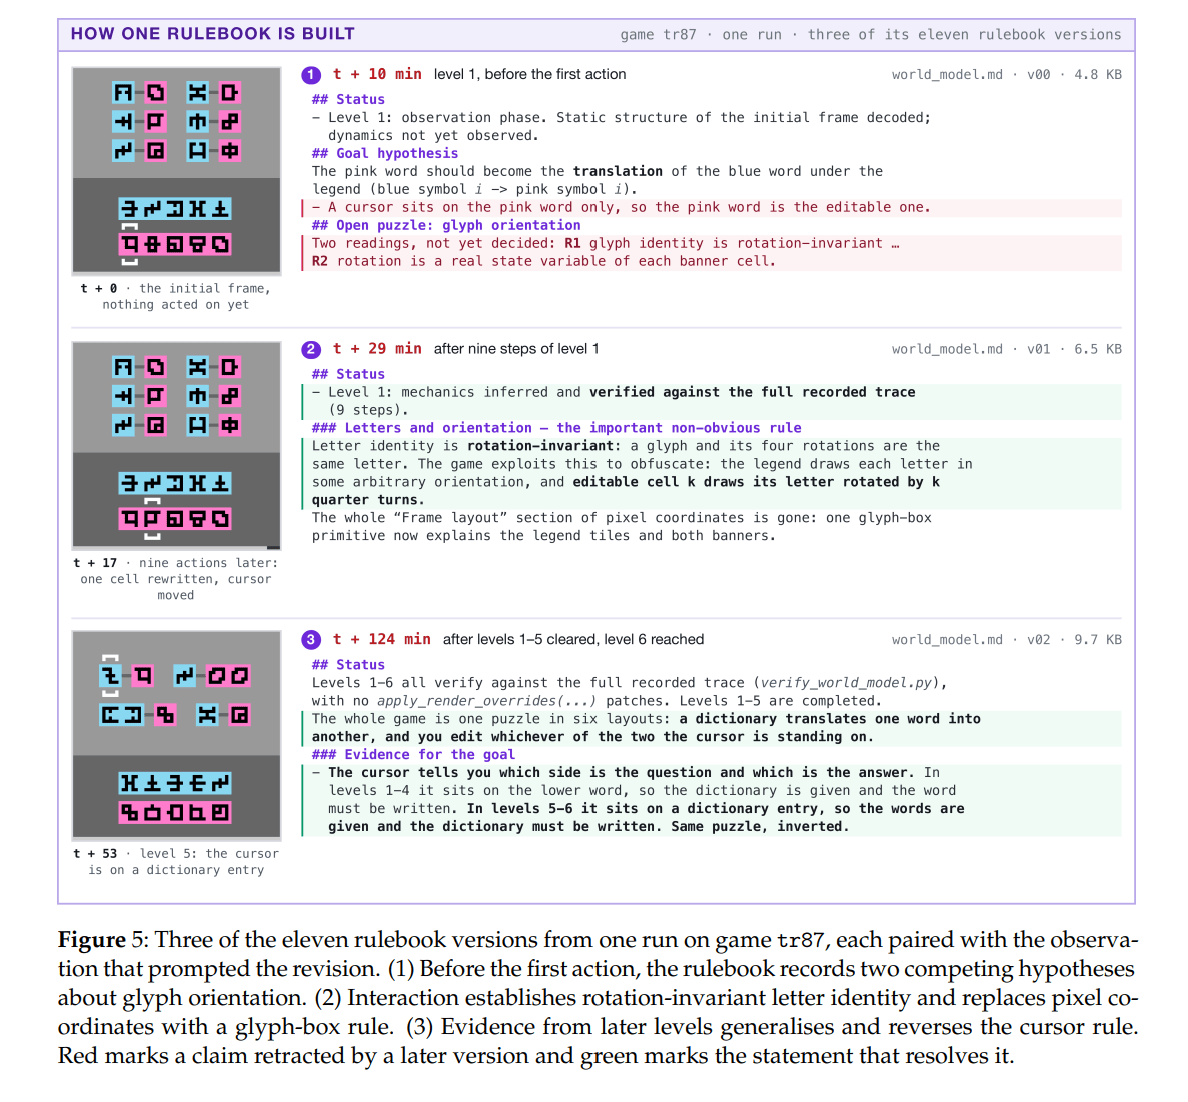
على سبيل المثال في لعبة فك رموز الرموز tr87، لم يكن الذكاء الاصطناعي في البداية قادراً على التمييز مما إذا كان اتجاه الرموز يؤثر في المعنى، ثم اكتشف لاحقاً أن الرموز ذات الاتجاهات المختلفة قد تمثل الحرف نفسه.
ومع ظهور مستويات جديدة، أسقط الذكاء الاصطناعي فهمه السابق لمواقع المؤشر.
وعلى مدار اللعبة بأكملها، خضعت كتيّب القواعد نفسه لـ11 نسخة متتالية.
لتسهيل التتبع الخلفي، أدخل فريق البحث حتى نظام إدارة الإصدارات Git.
كل تعديل على القواعد والشيفرة يترك سجلاً، وإذا اكتُشف أين وقع الخطأ في التعديل، يمكن الرجوع إلى النسخ السابقة، واستعادتها مباشرة عند الحاجة.
يا للعجب، اللعب بلعبة انتهى به الحال إلى صيانة مستودع شيفرة أيضاً.
وهذا بالضبط ما يسميه فريق البحث التحسين الذاتي التكراري (RSI).
دون الحاجة إلى تغيير معاملات النموذج اللغوي الكبير، يستطيع الذكاء الاصطناعي، من خلال التراكم المستمر للخبرة وتعديل القواعد والشيفرة، أن يجعل نفسه أكثر مهارة كلما لعب أكثر.
والأكثر من ذلك، أن هذه الطريقة مدعومة فعلاً بالبيانات.
أجرى فريق البحث تجارب مقارنة على ثلاث ألعاب:
عند الاحتفاظ بكتيّب القواعد، استخدم الذكاء الاصطناعي ما مجموعه 617 عملية؛ وعند إزالة كتيّب القواعد والاكتفاء بنموذج العالم المبني على الشيفرة، احتاج إلى 677 عملية.
أي أن وجود هذا الدليل الإرشادي قلّل عدد العمليات بنحو 9%، كما قلّل جولات تنفيذ الوكيل بنحو 18%。
لكن فريق البحث لم يقتصر على ذلك.
فإذا كان نموذج عالم واحد يساعد الذكاء الاصطناعي على تجنب الالتفاتات، فماذا لو استُخدم نموذجان في آن واحد؟
وهكذا، جعلوه يحتفظ بنموذجَي عالم في الوقت نفسه، يتقاسمان سجل عمليات اللعبة، لكن كل منهما يستنبط فرضيات قواعد مختلفة.
وكانت النتيجة أنه في اللعبة wa30، احتاج نموذج العالم الواحد إلى 899 عملية لإكمال اللعبة، أما مع نموذجَي العالم فانخفض العدد مباشرة إلى 597 عملية.
أي انخفاض إضافي في عدد العمليات بنحو 34%。
وبالطبع، هذا التحسين لم يُتحقق له سوى على wa30 حتى الآن، ولا يمكن تعميمه مباشرة على ألعاب أخرى.
لكن على الأقل في هذه التجارب، أثبت Memento 3 أمراً واحداً:
دون إعادة تدريب النموذج اللغوي الكبير، يستطيع الذكاء الاصطناعي أن يصبح أقوى كلما لعب، بمجرد تصحيح فهمه للعالم باستمرار.
عندما وصلت اللعبة إلى 21:0، لم يعد الذكاء الاصطناعي بحاجة حتى إلى استدعاء النموذج اللغوي الكبير.
فهل تصلح هذه الطريقة للعب ألعاب الألغاز فقط؟
قرر فريق البحث زيادة الصعوبة، وأرسل Memento 3 مباشرة لتحدي لعبة الصالات الكلاسيكية Atari Pong (كرة الطاولة).
وعلى خلاف ألعاب الألغاز السابقة، تتحرك الكرة هذه المرة وترتد باستمرار، فلم يكن على الذكاء الاصطناعي أن يستوعب قواعد اللعبة فحسب، بل كان عليه أيضاً أن يحكم على مسار حركة الكرة لحظياً ويتحكم في المضرب لاستقبالها.
وقد جاءت هذه المحاولة بفواكه جديدة فعلاً.。
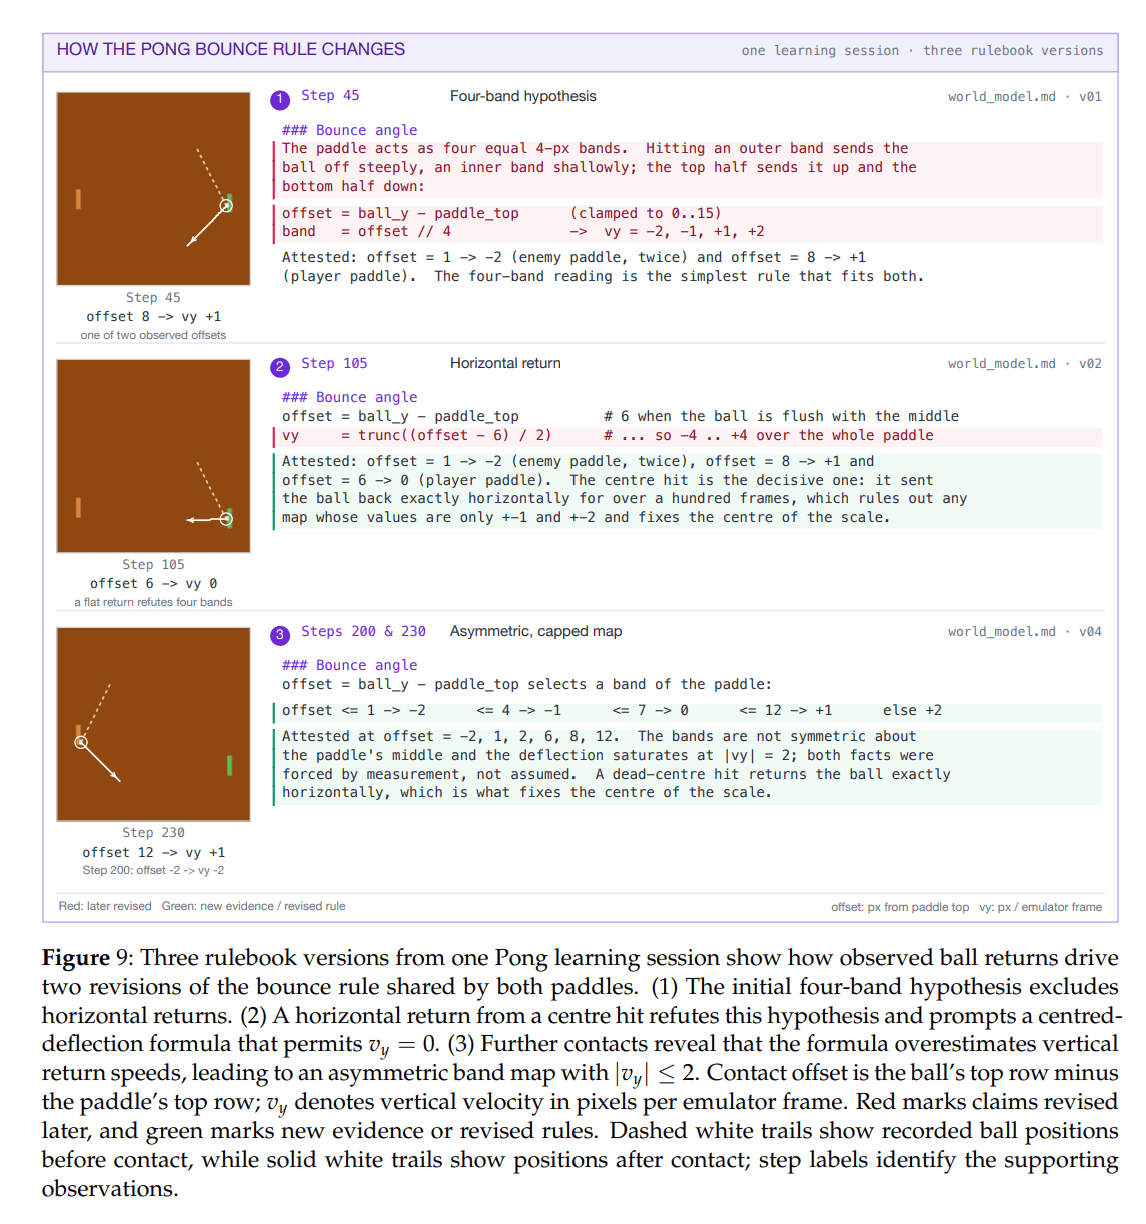
في البداية، لم يكن الذكاء الاصطناعي يعرف قوانين ارتداد الكرة كذلك، فاكتفى بالاستكشاف أثناء اللعب.
ظنّ في البداية أن المضرب ينقسم إلى أربع مناطق، وأن الكرة ترتد بالاتجاه المقابل تبعاً للموقع الذي تضربه فيه.
ثم وبعد فترة من اللعب، ظهرت فجأة ارتدة أفقية.
ماذا؟ هذا لا يتطابق مع القواعد التي لُخّصت سابقاً.
فأعاد الذكاء الاصطناعي تحليل مواقع التصادم وعدّل معادلة الارتداد، ولاحقاً واجه انحرافات مسار جديدة فواصل التعديل، حتى لخّص تدريجياً قوانين حركة أكثر انسجاماً مع الواقع.
وعندما نضجت استراتيجية التحكم، جعل فريق البحث هذا البرنامج يلعب مستقلاً على أرض الملعب تماماً.
دون استدعاء Claude Opus 5 إطلاقاً، ودون تحديث القواعد.
نتيجةً،ثلاث بدايات مختلفة، انتهت جميعها بنتيجة 21 مقابل 0。
يا للعجب، في البداية كان ما زال يستكشف كيفية استلام الكرة، ثم في النهاية سحق الخصم بفوز نظيف بدون نقاط؟؟؟
واللافت للانتباه أن النموذج اللغوي الضخم في هذه المرحلة لم يعد بحاجة إلى اللعب بنفسه.
فهو يتولى فقط استكشاف القواعد في المرحلة الأولى وتلخيص أسلوب اللعب، وبمجرد تعلم الاستراتيجية يُسلَّم الأمر مباشرة إلى الكود للتنفيذ.
وللمقارنة، إذا لم يُستخدم نموذج العالم، وترك النموذج اللغوي الضخم وحده يقرر الخطوة التالية بناءً على الصورة المعروضة أمامه، فإن النتيجة النهائية كانت -19 فقط، وهو ما لا يختلف كثيرًا عن نتيجة -20.7 الناتجة عن الضغط العشوائي.
وبهذه المقارنة يتضح مدى الفارق.
بدلاً من جعل النموذج اللغوي الضخم يعيد التفكير في كل خطوة، من الأفضل أن يتعلم أولاً كيفية اللعب، ثم يُسلِّم أسلوب اللعب إلى البرنامج。
والكفاءة أيضًا مذهلة.
تُظهر بيانات الورقة البحثية أن Memento 3 استخدم فقط حوالي9500 إطار من صور اللعبةلتطوير هذه الاستراتيجية التحكمية.
وفي المقابل، تحتاج بعض طرق التعلم المعزز التقليدية غالبًا إلى مئات الآلاف بل مليارات الأطراف من بيانات التدريب.
وبالطبع، هذا لا يعني أن Memento 3 بلا تكلفة.
فهو يعتمد في الخلفية على Claude Opus 5 بتفعيل شدة الاستدلال Extra-High، وعمليات الاستكشاف وتوليد الكود والتحقق تستهلك جميعها قدرًا كبيرًا من الرموز (Token) والقدرة الحاسوبية.
كما أن التجارب الحالية تستهدف بشكل رئيسي بيئات ألعاب ذات قواعد واضحة نسبيًا، وإذا انتقلنا إلى عالم الواقع الأكثر تعقيدًا وتغيرًا، فإن ما إذا كانت هذه الطريقة ستظل فعالة يبقى أمرًا يحتاج إلى التحقق.
ومع ذلك، تشير هذه الدراسة إلى اتجاه جدير بالاهتمام:
التحسين الذاتي العودي (RSI) لا يشترط بالضرورة تعديل الأوزان الأساسية للنموذج. فمن خلال بناء نموذج عالم خارجي قابل للفحص والتنفيذ والتراجع، يستطيع النموذج اللغوي الضخم العام ذو المعلمات المجمدة أن يُكرِّر نفسه ذاتيًا ويتطور بسرعة في مجالات غير مألوفة.
رابط الورقة البحثية:
https://arxiv.org/abs/2610.11794
روابط مرجعية:
https://x.com/ScarletKc/status/2109169173540884935