
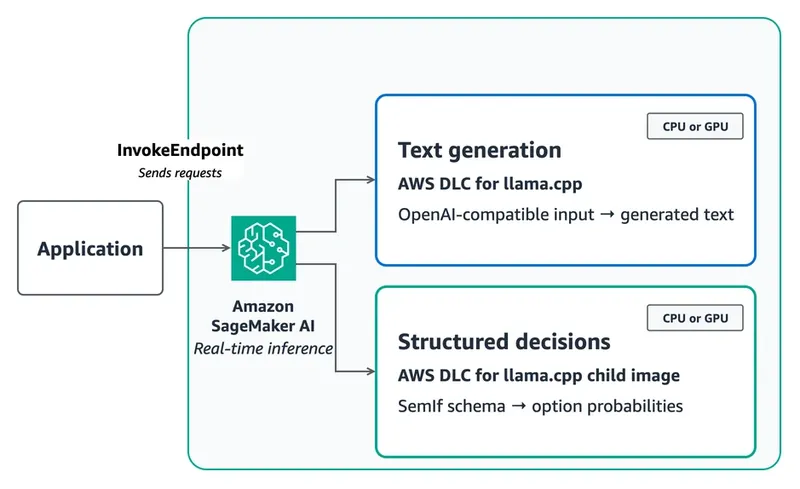
غالبًا ما تحتاج التطبيقات التي توجّه الطلبات أو تختار إجراءات الوكلاء أو تُسند نتائج السياسات إلى درجات فوق مجموعة ثابتة من الخيارات بدلًا من نص حر. إن نشر هذه النماذج القرارية باستخدام llama.cpp على Amazon SageMaker AI يوفر لك مسارًا مُدارًا لتقديم النماذج المكمّمة على بنية تحتية من نوع CPU أو GPU.
يستكمل هذا المنشور سلسلة حول حاويات AWS Deep Learning Containers (DLCs) المتخصصة للاستدلال في الذكاء الاصطناعي التوليدي. تغطي المنشورات السابقة WhisperX, وvLLM-Omni – Part 1و vLLM-Omni – Part 2.
في هذا المنشور، تستخدم أولًا AWS DLC لـ llama.cpp لتقديم عمليات إكمال المحادثة المتوافقة مع OpenAI عبر SageMaker AI InvokeEndpoint. ثم تُوسّع نفس بيئة التشغيل بـ SemIf، المعروف سابقًا باسم OpenJev، والذي يُرجع احتمالات فوق الخيارات المعلنة دون فك ترميز رمز إجابة. يتضمن نموذج الشيفرة المرافق خيارات نشر على CPU وGPU.
نظرة عامة على الحل
تعرض الصورة 1 مسارين للنشر من نفس النموذج المُغلّف. يستخدم مسار توليد النص حاوية AWS DLC لـ llama.cpp ويُرجع الاستجابات المولَّدة عبر واجهة برمجة التطبيقات المتوافقة مع OpenAI. أما مسار القرار المنظّم فيبني صورة فرعية تستبدل الخادم الافتراضي بمحوّل SemIf ويُرجع الاحتمالات للخيارات المعلنة.
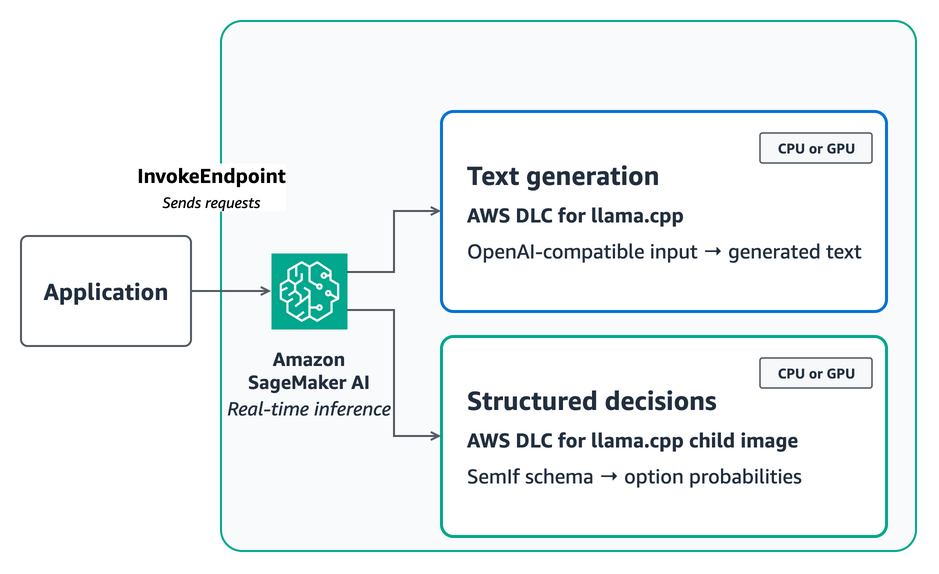
الشكل 1: شغّل حاوية AWS DLC لـ llama.cpp أو الصورة الفرعية SemIf على CPU أو GPU، حسب متطلبات واجهة برمجة التطبيقات وزمن الاستجابة لأعباء العمل لديك
بالنسبة للمسار القياسي، غلّف النموذج كما في model.tar.gz in في Amazon Simple Storage Service (Amazon S3) وأشر إلى صورة DLC المنشورة مباشرة. يعثر الحاوية على أول .gguf ملف ضمن /opt/ml/model، ويحوّل POST /invocations إلى llama-server عند /v1/chat/completions، ويمر SM_LLAMA_CPP_* متغيرات البيئة إلى وسائط llama.cpp.
ال llama-server لا تكشف واجهة HTTP API عمليات logits الموضع النهائي وعمليات الحالة التي يستخدمها SemIf. لذلك يستخدم مسار القرار المهيكل AWS CodeBuild لبناء صورة فرعية وتخزينها في Amazon Elastic Container Registry (Amazon ECR). تحتفظ الصورة الفرعية بمكتبات CPU أو CUDA المُصرَّفة الخاصة بـ DLC مع استبدال نقطة الدخول الخاصة بها بمُهايئ متوافق مع SageMaker.
افهم مخططات الإدخال والإخراج
تقبل حزمة AWS DLC الخاصة بـ llama.cpp مخطط OpenAI Chat Completions. أرسل messages مصفوفة مع role و content، بالإضافة إلى عناصر التحكم في التوليد مثل max_tokens و stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
تستخدم الاستجابة الواجهة المتوافقة مع OpenAI choices المصفوفة. اقرأ النص المولَّد من choices[0].message.content.
يستخدم SemIf مخطط قرار مقيّدًا بدلاً من رسائل الدردشة. يحتوي الطلب على معرّف يحدده المستدعي، وحالة غير مهيكلة، وسؤال، وقائمة مرتبة من الخيارات المسموح بها:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
تُرجع الاستجابة option_ids, probabilities، و option_logits بنفس الترتيب، إلى جانب بيانات وصفية للتوجيه والتوقيت والنموذج المثبّت. من خلال معرّفات خيارات مستقرة، يمكن لتطبيقك تطبيق الحدود الدنيا والبدائل وفحوصات السياسة دون الحاجة إلى تحليل النص المُنشأ.
ينتمي SemIf إلى فئة أوسع من نماذج القرار التي تقيّم نتائج يحددها التطبيق انطلاقاً من حالة غير مهيكلة. تشمل التطبيقات الأخرى Jev، ونموذج القرار الخاص بـ TypeSafe و /v1/systemone API؛ وKev، وهو خادم نماذج مصمم للتوافق مع TypeSafe API؛ و Strands Decider 2B، وهو نموذج مخصص لسير عمل الوكلاء بمخرجات معايَرة.
اختيار سير عمل القرار المناسب
استخدم هذا النمط عندما يحدد تطبيقك الخيارات المسموح بها وقت الطلب ويحتاج إلى نموذج لتفسير سياق غير مهيكل. تشمل الأمثلة توجيه حالة إلى قائمة انتظار، أو استخراج قيمة واحدة من مجموعة معروفة، أو تعيين أولوية لحادث، أو التحقق من نتيجة سياسة، أو اختيار إجراء لوكيل. حافظ على الصلاحيات وقواعد العمل الحتمية خارج النموذج، وتحقق من صحة احتمالات النموذج قبل التعامل معها كثقة تشغيلية.
استخدم مسار توليد النصوص القياسي في SageMaker AI عندما تحتاج إلى استجابات دردشة متوافقة مع OpenAI من خلال InvokeEndpoint. تحوّل صورة SageMaker AI المسار POST /invocations إلى نقطة النهاية llama-server /v1/chat/completions ابنِ صورة فرعية فقط عندما يحتاج تطبيقك إلى سلوك لا توفره هذه الواجهة، مثل الوصول المباشر إلى logits والحالة في SemIf.
إزالة توليد رموز الإجابة لا تزيل استدلال النموذج. لا يزال النموذج يعالج الحالة الكاملة والسؤال وأوصاف الخيارات قبل أن يقرأ SemIf الـ logits النهائية. حافظ على تركيز المطالبات، وقيّم النموذج المختار باستخدام قرارات موسومة من تطبيقك قبل الاستخدام في الإنتاج.
اضبط الإعدادات لأهداف زمن الاستجابة والجودة لديك
ينطبق الاختبار المرجعي التالي على امتداد SemIf، وليس على نقطة نهاية توليد النصوص. يؤثر حجم النموذج والتكميم وطول المقدمة وبيئة التشغيل وعدد خيوط المعالج على كل قرار. لقياس هذه المقايضات، أرسلنا نفس المهام العامة البالغ عددها 231 من JevBench تسلسليًا إلى نقطة نهاية واحدة على وحدة المعالجة المركزية ونقطة نهاية واحدة على وحدة معالجة الرسومات.
| التكوين | AWS DLC لـ llama.cpp | الاستجابات الصالحة | الدقة | Client p50 | Client p95 |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge، 32 خيطًا |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715 ثانية | 19.291 ثانية |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge، تفريغ كامل إلى وحدة معالجة الرسومات |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352 ثانية | 0.599 ثانية |
بالمقارنة مع تكوين وحدة المعالجة المركزية، كانت نقطة نهاية وحدة معالجة الرسومات أسرع بمقدار 4.9 مرة عند p50 وأسرع بمقدار 32.2 مرة عند p95. يستخدم المثال ميزة مجموعات مثيلات SageMaker AI لعرض أنواع مثيلات GPU المتوافقة بترتيب الأولوية، بحيث يمكن لـ SageMaker اختيار بديل عندما لا يكون الخيار الأول متاحًا. رتّبت المجموعة g6e, g6, g5ثم g4dn. اختار SageMaker ml.g6e.xlarge، وأكدت سجلات بدء التشغيل أن llama.cpp قام بتفريغ جميع طبقات النموذج البالغ عددها 34 طبقة إلى NVIDIA L40S. استخدمت صورا CPU وGPU إصدارات مختلفة من llama.cpp وأنتجتا تنبؤات مختلفة في ست مهام صعبة. اعتبر اختلاف الدقة في الإجابة الواحدة تباينًا في بيئة التشغيل، وليس دليلًا على أن التفريغ إلى وحدة معالجة الرسومات يحسّن جودة النموذج.
قلّلت النماذج الأصغر زمن الاستجابة الوسيط، لكن حقق المرشحان 2B و0.8B دقة بنسبة 66.7 بالمئة و58.4 بالمئة. لذلك يحتفظ المثال بنموذج 4B Q4_K_M كخلفية افتراضية ذات أولوية للجودة. تشمل هذه القياسات زمن استجابة الشبكة وليست ضمانات للخدمة.
قم باختبار تكوين النموذج والبنية التحتية الكامل مقابل قراراتك الخاصة. استخدم CPU لأحمال العمل الخلفية أو غير المتصلة أو منخفضة الإنتاجية غير الحساسة لزمن الاستجابة والتي يمكنها تحمل ثوانٍ من زمن الاستجابة. استخدم GPU للقرارات التفاعلية أو المطالبات الطويلة أو أحمال العمل ذات أهداف زمن استجابة الذيل الضيقة. حافظ على إيجاز الحالة وأوصاف الخيارات، واجمع القرارات التي تشترك في نفس الحالة في طلب واحد، ووسّع مثيلات نقطة النهاية للتزامن. يعيد تسجيل الحالة المشتركة استخدام بادئة المقدمة المشتركة، بينما يعيد المحول استجابة HTTP قابلة لإعادة المحاولة 503 الاستجابات بدلاً من السماح بقائمة انتظار غير محدودة حول سياق llama.cpp الخاص بالحالة.
المتطلبات الأساسية
تحتاج إلى:
- حساب AWS ودلو S3 في منطقة نشر AWS الخاصة بك.
- Python 3.10 أو أحدث، وGit، وواجهة سطر أوامر AWS (AWS CLI).
- دور خدمة CodeBuild مخصص لغرض محدد لتوسعة SemIf الاختيارية.
- دور AWS Identity and Access Management (IAM) يمكن لـ SageMaker AI توليه.
- الأذونات لـ SageMaker AI وAmazon ECR وAmazon S3 وCodeBuild وإجراءات تمرير الأدوار IAM و Amazon CloudWatch Logs.
- حصة لتوافق مع نقطة نهاية SageMaker في الوقت الفعلي بوحدة معالجة مركزية x86 أو وحدة معالجة رسومات NVIDIA.
يستخدم مثال توليد النصوص DLC الخاص بوحدة المعالجة المركزية ومثيلة CPU ثابتة. تحافظ توسعة SemIf على CPU كخيار افتراضي لأحمال العمل غير الحساسة لزمن الاستجابة وتوفر صورة CUDA اختيارية مع مجموعات مثيلات مرتبة. راجع أسعار SageMaker AI قبل إنشاء نقطة النهاية.
نشر نموذج قرار وتوسعته باستخدام SemIf
استخدم الإجراء التالي لنشر نقطة نهاية توليد النصوص القياسية، ثم بناء توسعة SemIf الاختيارية للقرارات المهيكلة على CPU أو GPU.
- انسخ نموذج الكود وثبّت تبعياته.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - اضبط قيم النشر لحسابك.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - احزم نموذج GGUF المثبّت الإصدار والمُرمِّز (tokenizer) باستخدام CodeBuild.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
انتظر حتى يصل معرّف البناء المُعاد إلى
SUCCEEDED. يسجّل البناء مراجعات المصدر ومجاميع الاختبار فيmodel-manifest.jsonويتوقف إذا اختلف مجموع اختبار GGUF عن القيمة المتحقَّق منها. - انشر نموذج GGUF باستخدام AWS DLC الخاص بـ llama.cpp.
اعرض (resolve) صورة
server-sagemaker-cpu-v1مثبّتة بالبصمة (digest-pinned) من وثائق AWS DLC لـ llama.cpp، ثم أنشئ نموذج SageMaker AI وإعدادات نقطة النهاية ونقطة النهاية:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"اختر صورة
server-sagemaker-cpu-v1أوserver-sagemaker-cuda-v1بدلاً من صورة EC2 المقابلة. صور SageMaker AI تنفّذ عقد الحاويات/pingو/invocationsوتحوّل حمولات الاستدعاء إلى إكمالات محادثة (chat completions).يوفر هذا الاستكشاف نموذج GGUF من خلال أداة نموذج SageMaker AI في Amazon S3. كبديل، يمكنك ضبط
SM_LLAMA_CPP_HF_REPOوSM_LLAMA_CPP_HF_FILEلتنزيل ملف GGUF من Hugging Face عندما تتوفر لدى نقطة النهاية منفذ شبكة صادر.لا تحتاج إلى Dockerfile أو مستودع ECR لهذا المسار. انتظر حتى تدخل نقطة النهاية حالة
InService، ثم أرسل طلب محادثة متوافقاً مع OpenAI:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - ابنِ صورة SemIf الفرعية الاختيارية واعرض بصمتها الثابتة (immutable digest).
للوحدة المعالجة المركزية:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
للوحدة المعالجة الرسومية، ابنِ صورة CUDA الفرعية بدلاً من ذلك:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
بعد نجاح البناء، شكّل URI الصورة الثابتة:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
سيناريو النشر يرفض وسوم الصور القابلة للتغيير.
- انشر نقطة نهاية SemIf.
إعدادات وحدة المعالجة المركزية تستخدم نوع مثيل ثابتاً:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
انتظر حتى يدخل اسم نقطة النهاية المُعاد إلى حالة
InService. يضبط هذا المسارn_gpu_layers=0. يقوم المُحوِّل (adapter) بتسلسل عمليات التقييم حول سياق llama.cpp واحد ذي حالة، لذا قم بالتوسع باستخدام مثيلات نقطة النهاية بعد قياس عبء عملك بدلاً من افتراض التقييم المتوازي داخل حاوية واحدة.بالنسبة لصورة وحدة المعالجة الرسومية، وفّر مجمعات مثيلات مرتبة واطلب التفريغ الكامل للنموذج:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
تجمعات المثيلات (Instance pools) هي بدائل احتياطية مرتبة لتحديد الموضع، وليست موازنة أحمال للاستدلال. يختار SageMaker نوعًا واحدًا متاحًا للمتغير (variant). يمكن أن يستغرق إنشاء نقطة النهاية وقتًا أطول بينما يعمل SageMaker AI عبر التجمع. تحقق من سجلات بدء التشغيل للتأكد من وحدة GPU المحددة ومن رسالة تؤكد أنه تم تفريغ جميع طبقات النموذج (offloaded).
- استدعِ نقطة نهاية SemIf مع مثال القرار.
يعلن الطلب معرّفات ثابتة (stable IDs) لكل خيار مسموح به:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"يحافظ الرد على ترتيب الخيارات ويتضمن الاحتمالات الشرطية، والقيم الأولية (raw logits)، وبيانات وصفية للرموز (tokens) والطلب (prompt)، وهوية النموذج المثبت:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
طبّق عتبات وبدائل احتياطية على مستوى التطبيق. لا تستخدم قرار النموذج كبديل عن التخويل (authorization).
التنظيف
احذف نقطة نهاية SageMaker AI وإعدادات نقطة النهاية والنموذج:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
يحذف السكربت موارد SageMaker AI المسماة صراحةً فقط. احذف مشاريع CodeBuild ومستودع ECR وكائنات النموذج والمصدر في Amazon S3 والسجلات وأدوار IAM الخاصة بأغراض محددة عندما لا تحتاج إليها بعد الآن.
الخاتمة
توفر حاوية AWS DLC الخاصة بـ llama.cpp أساسًا مُدارًا لتقديم نماذج القرار على SageMaker AI عبر مثيلات CPU و GPU. يمكنها تحميل نماذج GGUF من عناصر نماذج SageMaker AI أو من مستودع Hugging Face مُهيأ، ثم تقديم إكمالات محادثة متوافقة مع OpenAI عبر InvokeEndpoint دون الحاجة إلى حاوية مخصصة. عندما يحتاج تطبيقك إلى عمليات مباشرة على القيم الأولية (logits) وحالة النموذج، يمكنك توسيع DLC بمحوّل SemIf. اختر CPU لأحمال العمل غير الحساسة لزمن الاستجابة، واختر GPU عندما يؤثر التعبئة المسبقة للطلب (prompt prefill) وزمن الاستجابة النهائي (tail latency) على تجربة التطبيق.
راجع عينة الكود, وثائق AWS DLC لـ llama.cppو عقد حاوية الاستدلال المخصص في SageMaker AI لتكييف النشر مع عبء العمل الخاص بك.