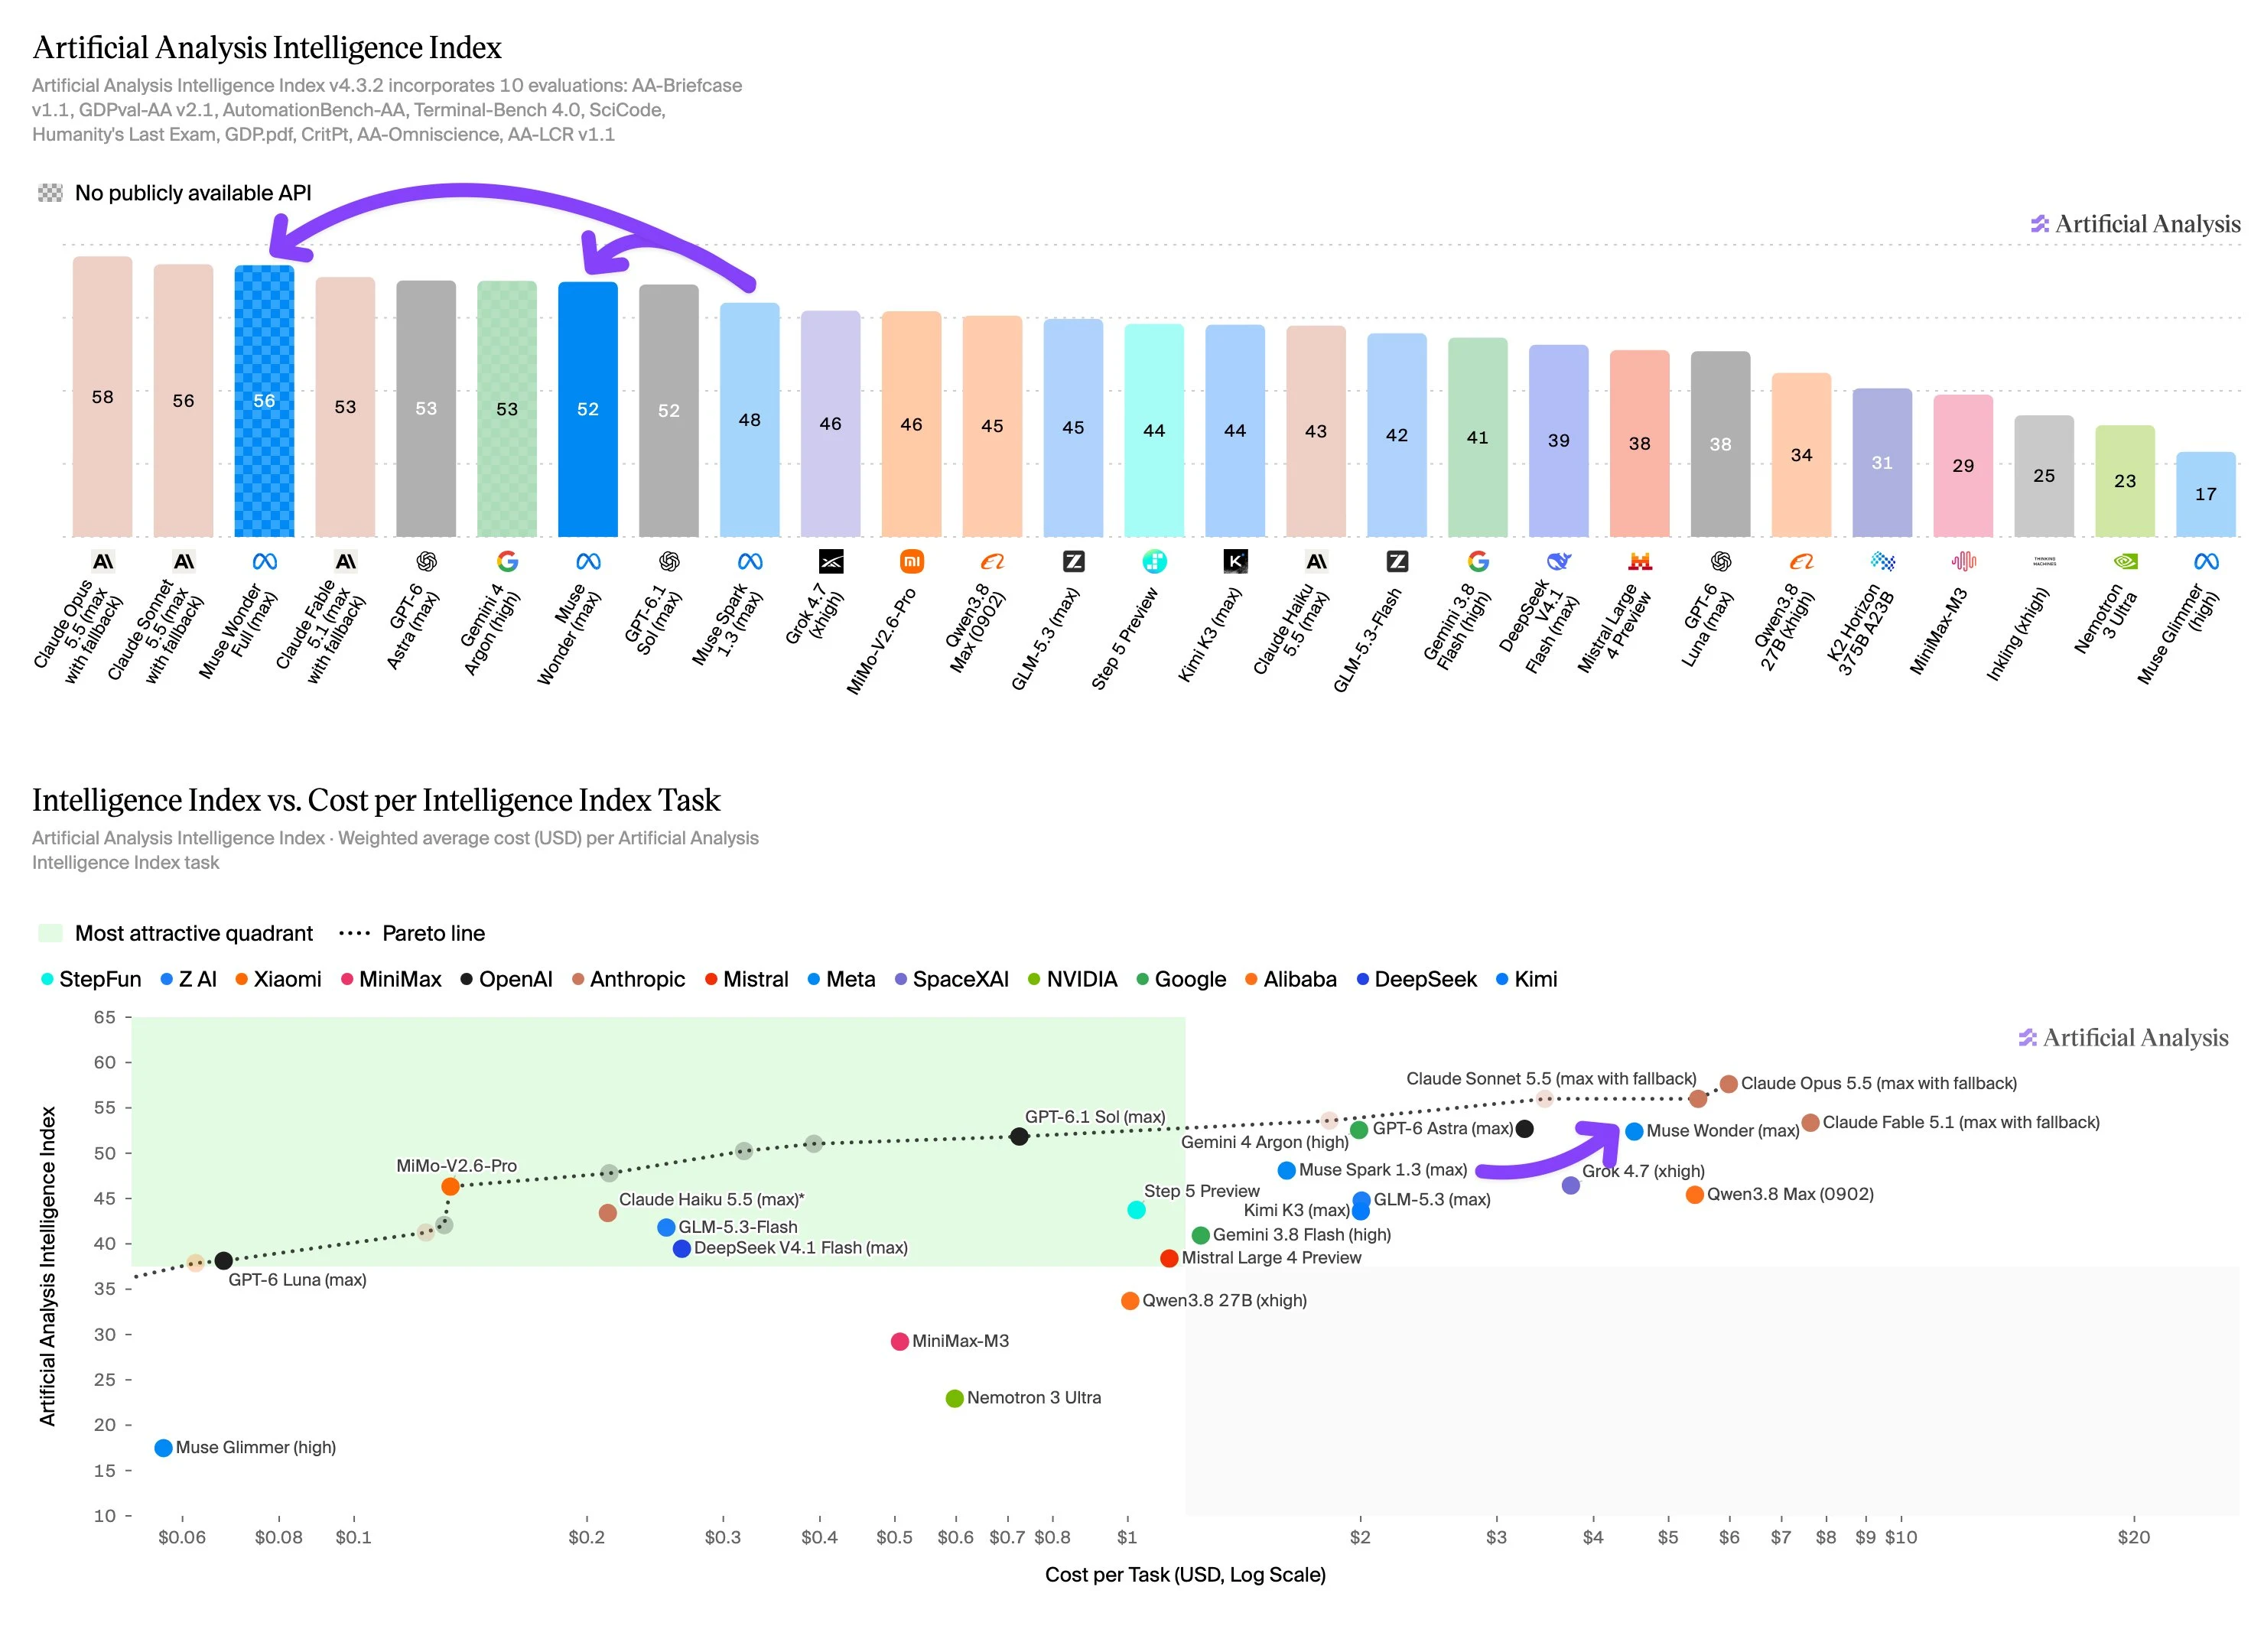
أصدرت Meta نموذجي Muse Wonder وMuse Wonder Full، محققة درجات 52 و56 على Artificial Analysis Intelligence Index v4.3 عند أقصى جهد استدلال - كل منها مكسب جوهري مقارنة بـ Muse Spark 1.3 (max) البالغة درجته 48، وبفارق إصدار لا يتجاوز 6 أسابيع
Muse Wonder متاح للمستخدمين عبر واجهة Meta البرمجية الأولى، بينما Muse Wonder Full متاح حاليًا لمستخدمي Muse Code فقط. تشير Meta إلى أن كل نموذج مصمم للاستخدام الوكيل الشخصي والمهني
مبروك لـ @AIatMeta و@finkd و@alexandr_wang على الإطلاق!
أبرز النقاط:
➤ يُظهر كلا النموذجين قفزة جوهرية في درجة Intelligence Index الإجمالية. يحسّن Muse Wonder Full (max) أداء Muse Spark 1.3 (max) في جميع تقييمات Intelligence Index العشرة، مكسبًا 8 نقاط ليصل إلى 56. كانت أكبر المكاسب في التقييمات الوكيلة: Terminal-Bench 4.0 (+24 نقطة، من 33% إلى 57%)، وGDPval-AA v2.1 (+176 Elo، من 1681 إلى 1857)، وAA-Briefcase (+148 Elo، من 1581 إلى 1729). يحقق Muse Wonder (max) مكسبًا بـ 4 نقاط على Intelligence Index ليصل إلى 52، مع تحسينات ملحوظة مقارنة بـ Muse Spark 1.3 (max) في Terminal-Bench 4.0 (من 33% إلى 52%) وAutomationBench-AA (من 58% إلى 68%)
➤ يحتل Muse Wonder Full (max) مركزًا ضمن الثلاثة الأوائل في ستة من تقييمات Intelligence Index العشرة، وهو قوي بشكل خاص في العمل المعرفي الوكيل والاستدلال العلمي. في العمل المعرفي الوكيل، يتصدر بفارق ضئيل على GDP.pdf (33%)، ويحتل المرتبة #2 على GDPval-AA v2.1 (بدرجة 1857 Elo)، والمرتبة #3 على كل من AA-Briefcase (1729 Elo) وAutomationBench-AA (71%). في الاستدلال العلمي، يتصدر قائمة CritPt بدرجة 33% ويحتل المرتبة #3 على SciCode بدرجة 63%. ويبني هذا على نقاط القوة النسبية لـ Muse Spark 1.3 (max)، الذي أظهر أيضًا قدرة خاصة في هذين المجالين
➤ يستخدم كلا النموذجين رموز إخراج أقل من Muse Spark 1.3 (max). يستخدم كل من Muse Wonder (max) وMuse Wonder Full (max) حوالي 54k رمز إخراج لكل مهمة Intelligence Index، بانخفاض ~10% مقارنة بـ Muse Spark 1.3 (max، 60k). هذا الاستخدام أقل من النماذج المماثلة في الذكاء Gemini 4 Argon (high، 62k) وClaude Fable 5.1 (max w/ fallback، 78k)، ولكنه أعلى من GPT-6.1 Sol (max، 38k) وGPT-6 Astra (max، 27k). يستخدم Muse Wonder Full (max) رموز إدخال أقل بنسبة 16% لكل مهمة Intelligence Index من Muse Wonder (max) (6.44M مقابل 7.69M)، ما يعني أنه أكثر ذكاءً وأكثر كفاءة في استهلاك الرموز
➤ تكلفة Muse Wonder (max) لكل مهمة أعلى من معظم النماذج المماثلة في الذكاء. رغم الاستخدام الفعال لرموز الإخراج، فإن أسعار الواجهة البرمجية المرتفعة (4 دولارات لكل مليون رمز إدخال، و20 دولارًا لكل مليون رمز إخراج) والاستخدام المرتفع لرموز الإدخال (7.69M لكل مهمة) يدفعان تكلفة Muse Wonder (max) إلى 4.52 دولارات لكل مهمة Intelligence Index. هذا أقل من Claude Fable 5.1 (max w/ fallback، 7.63 دولارات)، وClaude Opus 5.5 (max w/ fallback، 5.98 دولارات)، وClaude Sonnet 5.5 (max w/ fallback، 5.46 دولارات)، ولكنه أعلى من GPT-6 Astra (max، 3.26 دولارات)، وGemini 4 Argon (high، 1.99 دولار)، وGPT-6.1 Sol (max، 0.72 دولار)، وسابقه Muse Spark 1.3 (max، 1.60 دولار). تسعير الرمز الواحد غير متوفر حاليًا لـ Muse Wonder Full، لذا لا يمكن تقدير رقم التكلفة لكل مهمة في هذه المرحلة
➤ يحقق كلا النموذجين مكاسب كبيرة في أداء وكيل البرمجة. يحقق Muse Wonder Full درجة 68 على Artificial Analysis Coding Agents Index بأقصى جهد في Muse Code، إلى جانب Claude Code مع Sonnet 5.5 (max، 68) وOpus 5.5 (max، 66). يسجل Muse Wonder (max) درجة 63. وتمثل هذه مكاسب جوهرية مقارنة بـ Muse Code مع Muse Spark 1.3 (max)، الذي يسجل 54
تفاصيل أخرى عن النموذجين الجديدين:
➤ نافذات السياق: مليون (1M) توكن لكل منها، دون تغيير عن Muse Spark 1.3
➤ التسعير: لـ Muse Wonder، 4 دولارات للمدخلات / 0.20 دولار للمدخلات المخزنة مؤقتًا / 20 دولارًا للمخرجات لكل مليون (1M) توكن. لم يُعلن بعد عن السعر لكل توكن لـ Muse Wonder Full
➤ وسائط الإدخال: النص والصورة والفيديو والصوت
➤ وسائط الإخراج: النص
➤ التوفر: Muse Wonder متاح عبر واجهة Meta البرمجية الأولى وعلى Muse Code عند الإطلاق، بينما Muse Wonder Full متاح لمستخدمي Muse Code فقط