

نموذج Meta الجديد Frontier Model Muse Wonder Full ينضم إلى الطبقة العليا من الذكاء الاصطناعي
 ماتياس باستيان
عرض ملف ماتياس باستيان على لينكدإن
١٢ أكتوبر ٢٠٢٦
 Meta
نقاط رئيسية
- النموذجان الجديدان لشركة ميتا، Muse Wonder وMuse Wonder Full، يسدان الفجوة مع النماذج الرائدة.
- أكبر المكاسب تكون في البرمجة الذاتية والحل المستقل للمشكلات.
- كلتا النسختين تكلفان تقريبًا ثلاثة أضعاف تكلفة النسخة السابقة، Muse Spark 1.3، لكل استدعاء للواجهة API.
أصدرت Meta نموذجها المتقدم Muse Wonder بطرازين، وكلا النموذجين يُعتبران من أفضل نماذج الذكاء الاصطناعي المتاحة.
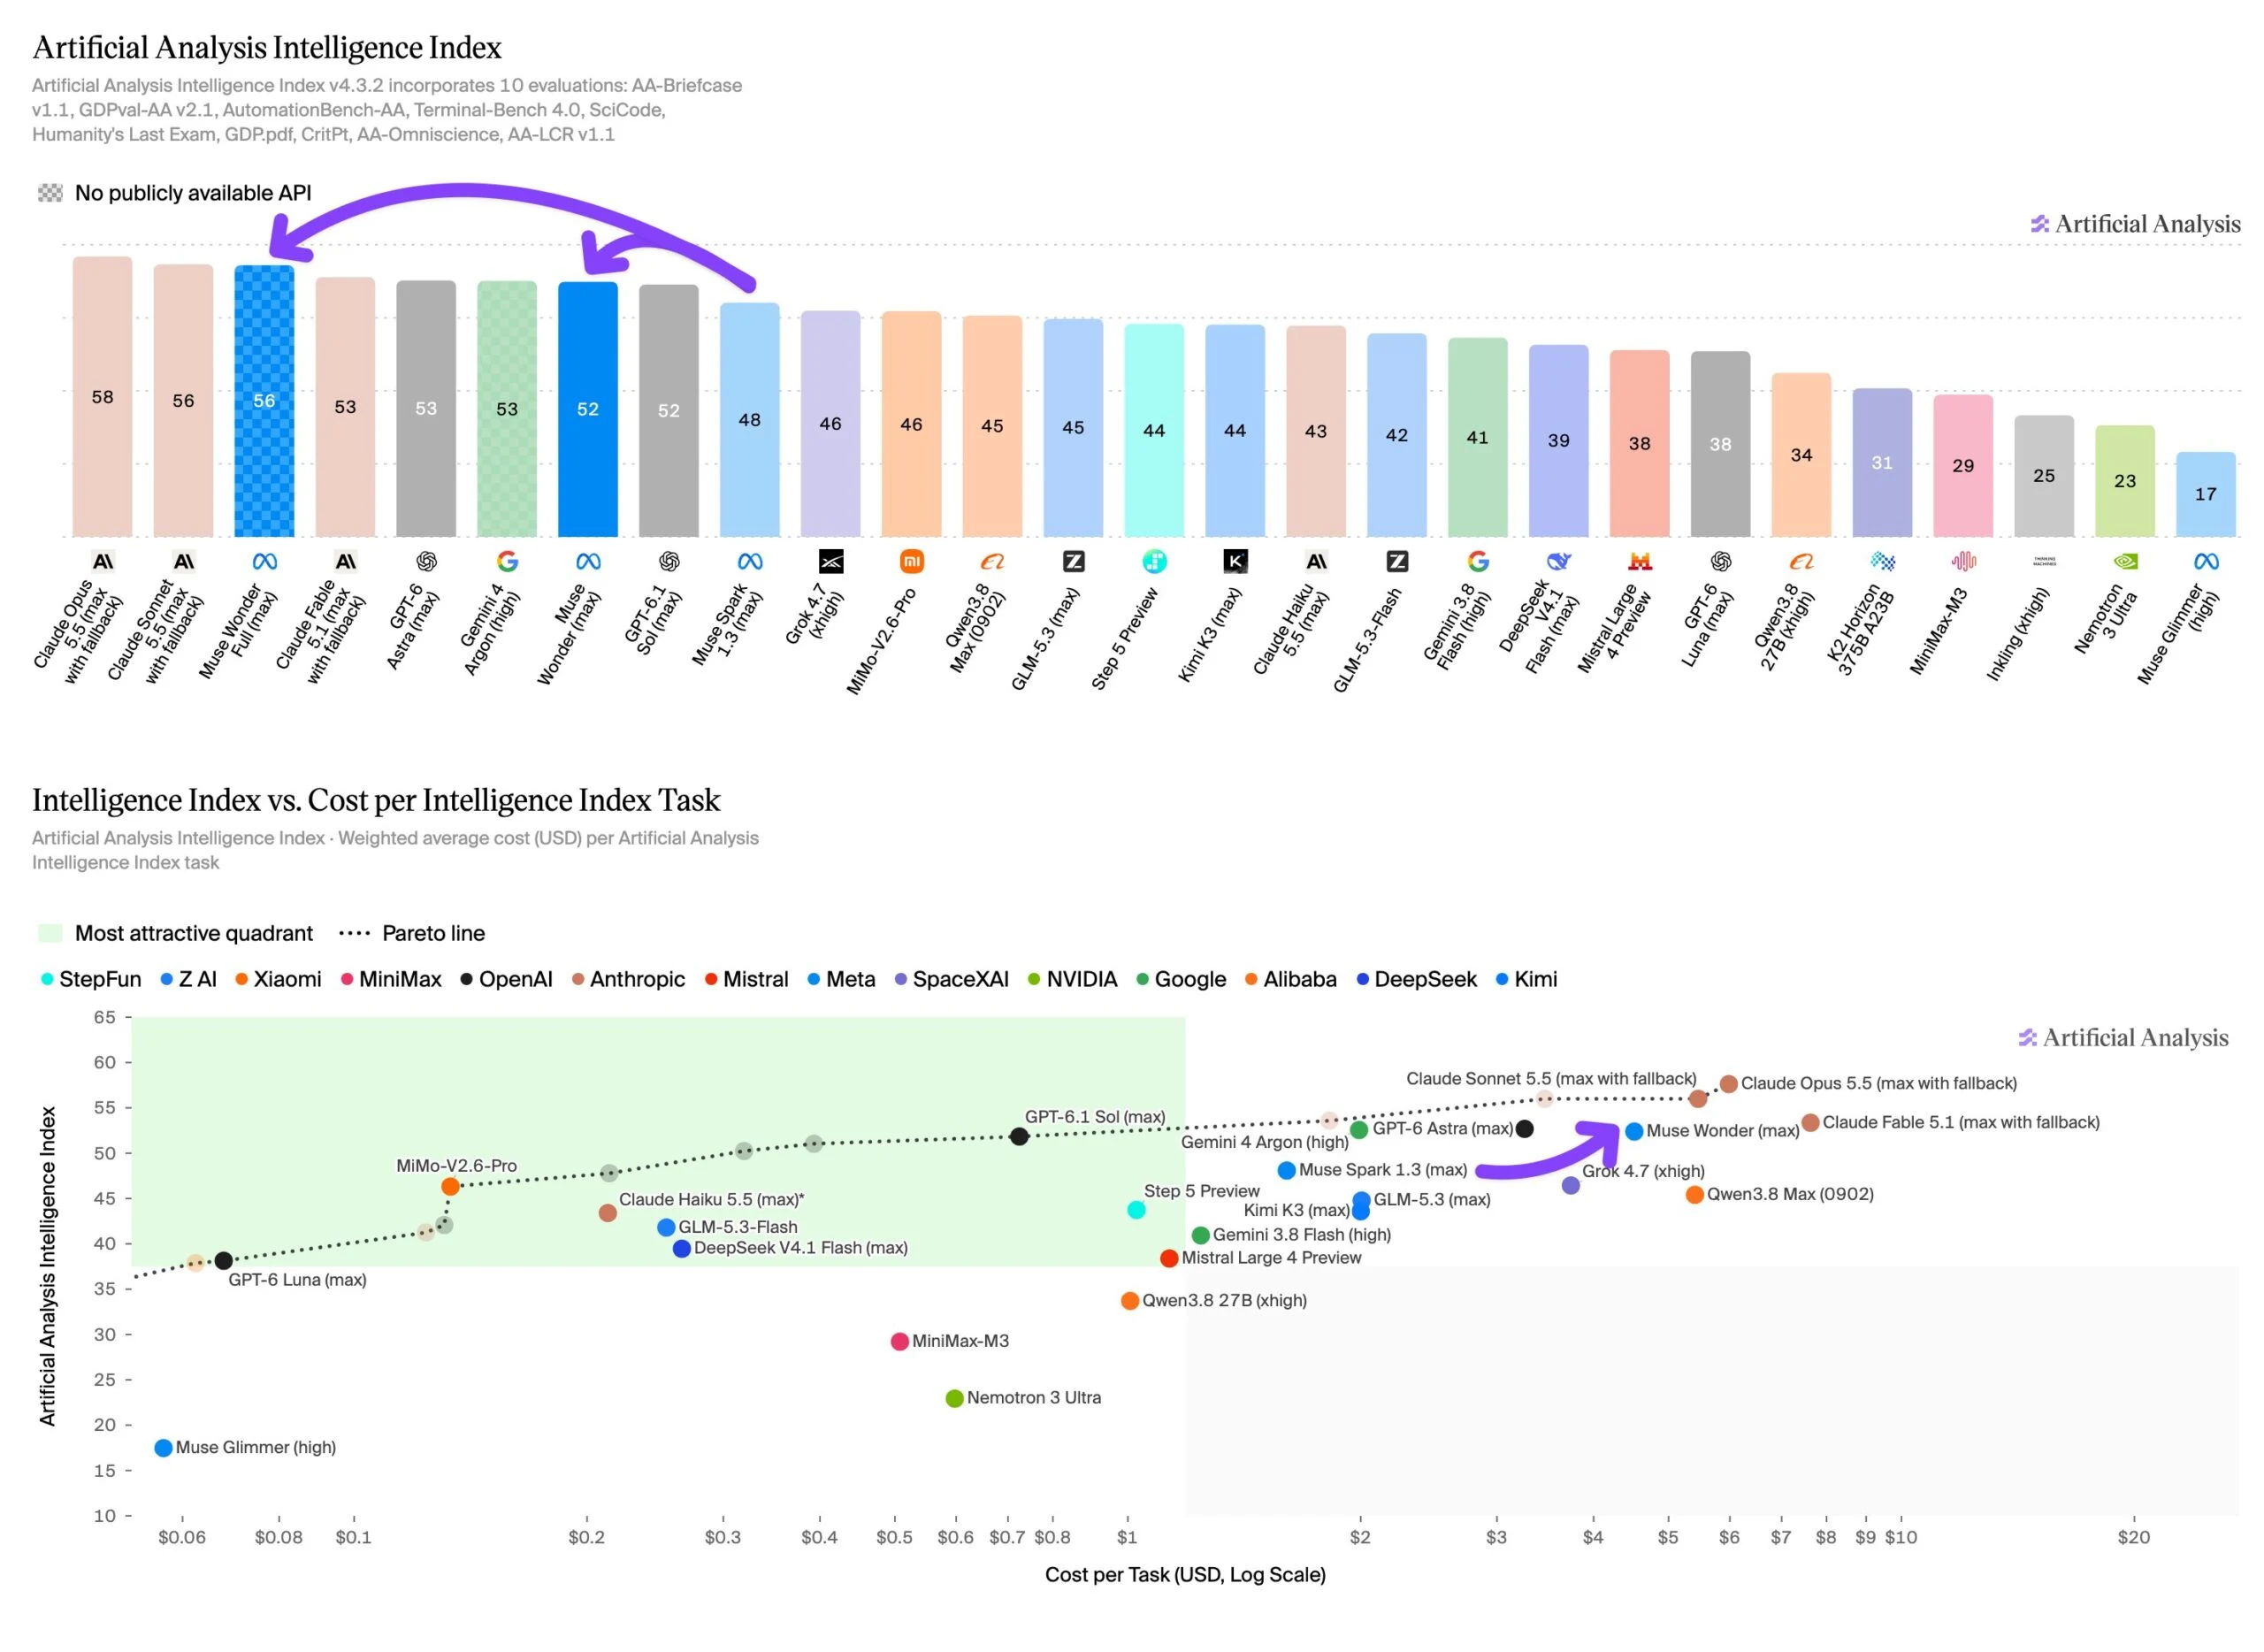
حصل Muse Wonder Full على 56 نقطة في مؤشر الذكاء الاصطناعي للتحليل v4.3، بينما حقق Muse Wonder 52 نقطة. أما سلفه، Muse Spark 1.3، فقد حقق 48 نقطة، مما يعتبر قفزة كبيرة مقارنة بالنموذج من الطبقة المتوسطة السابقة.
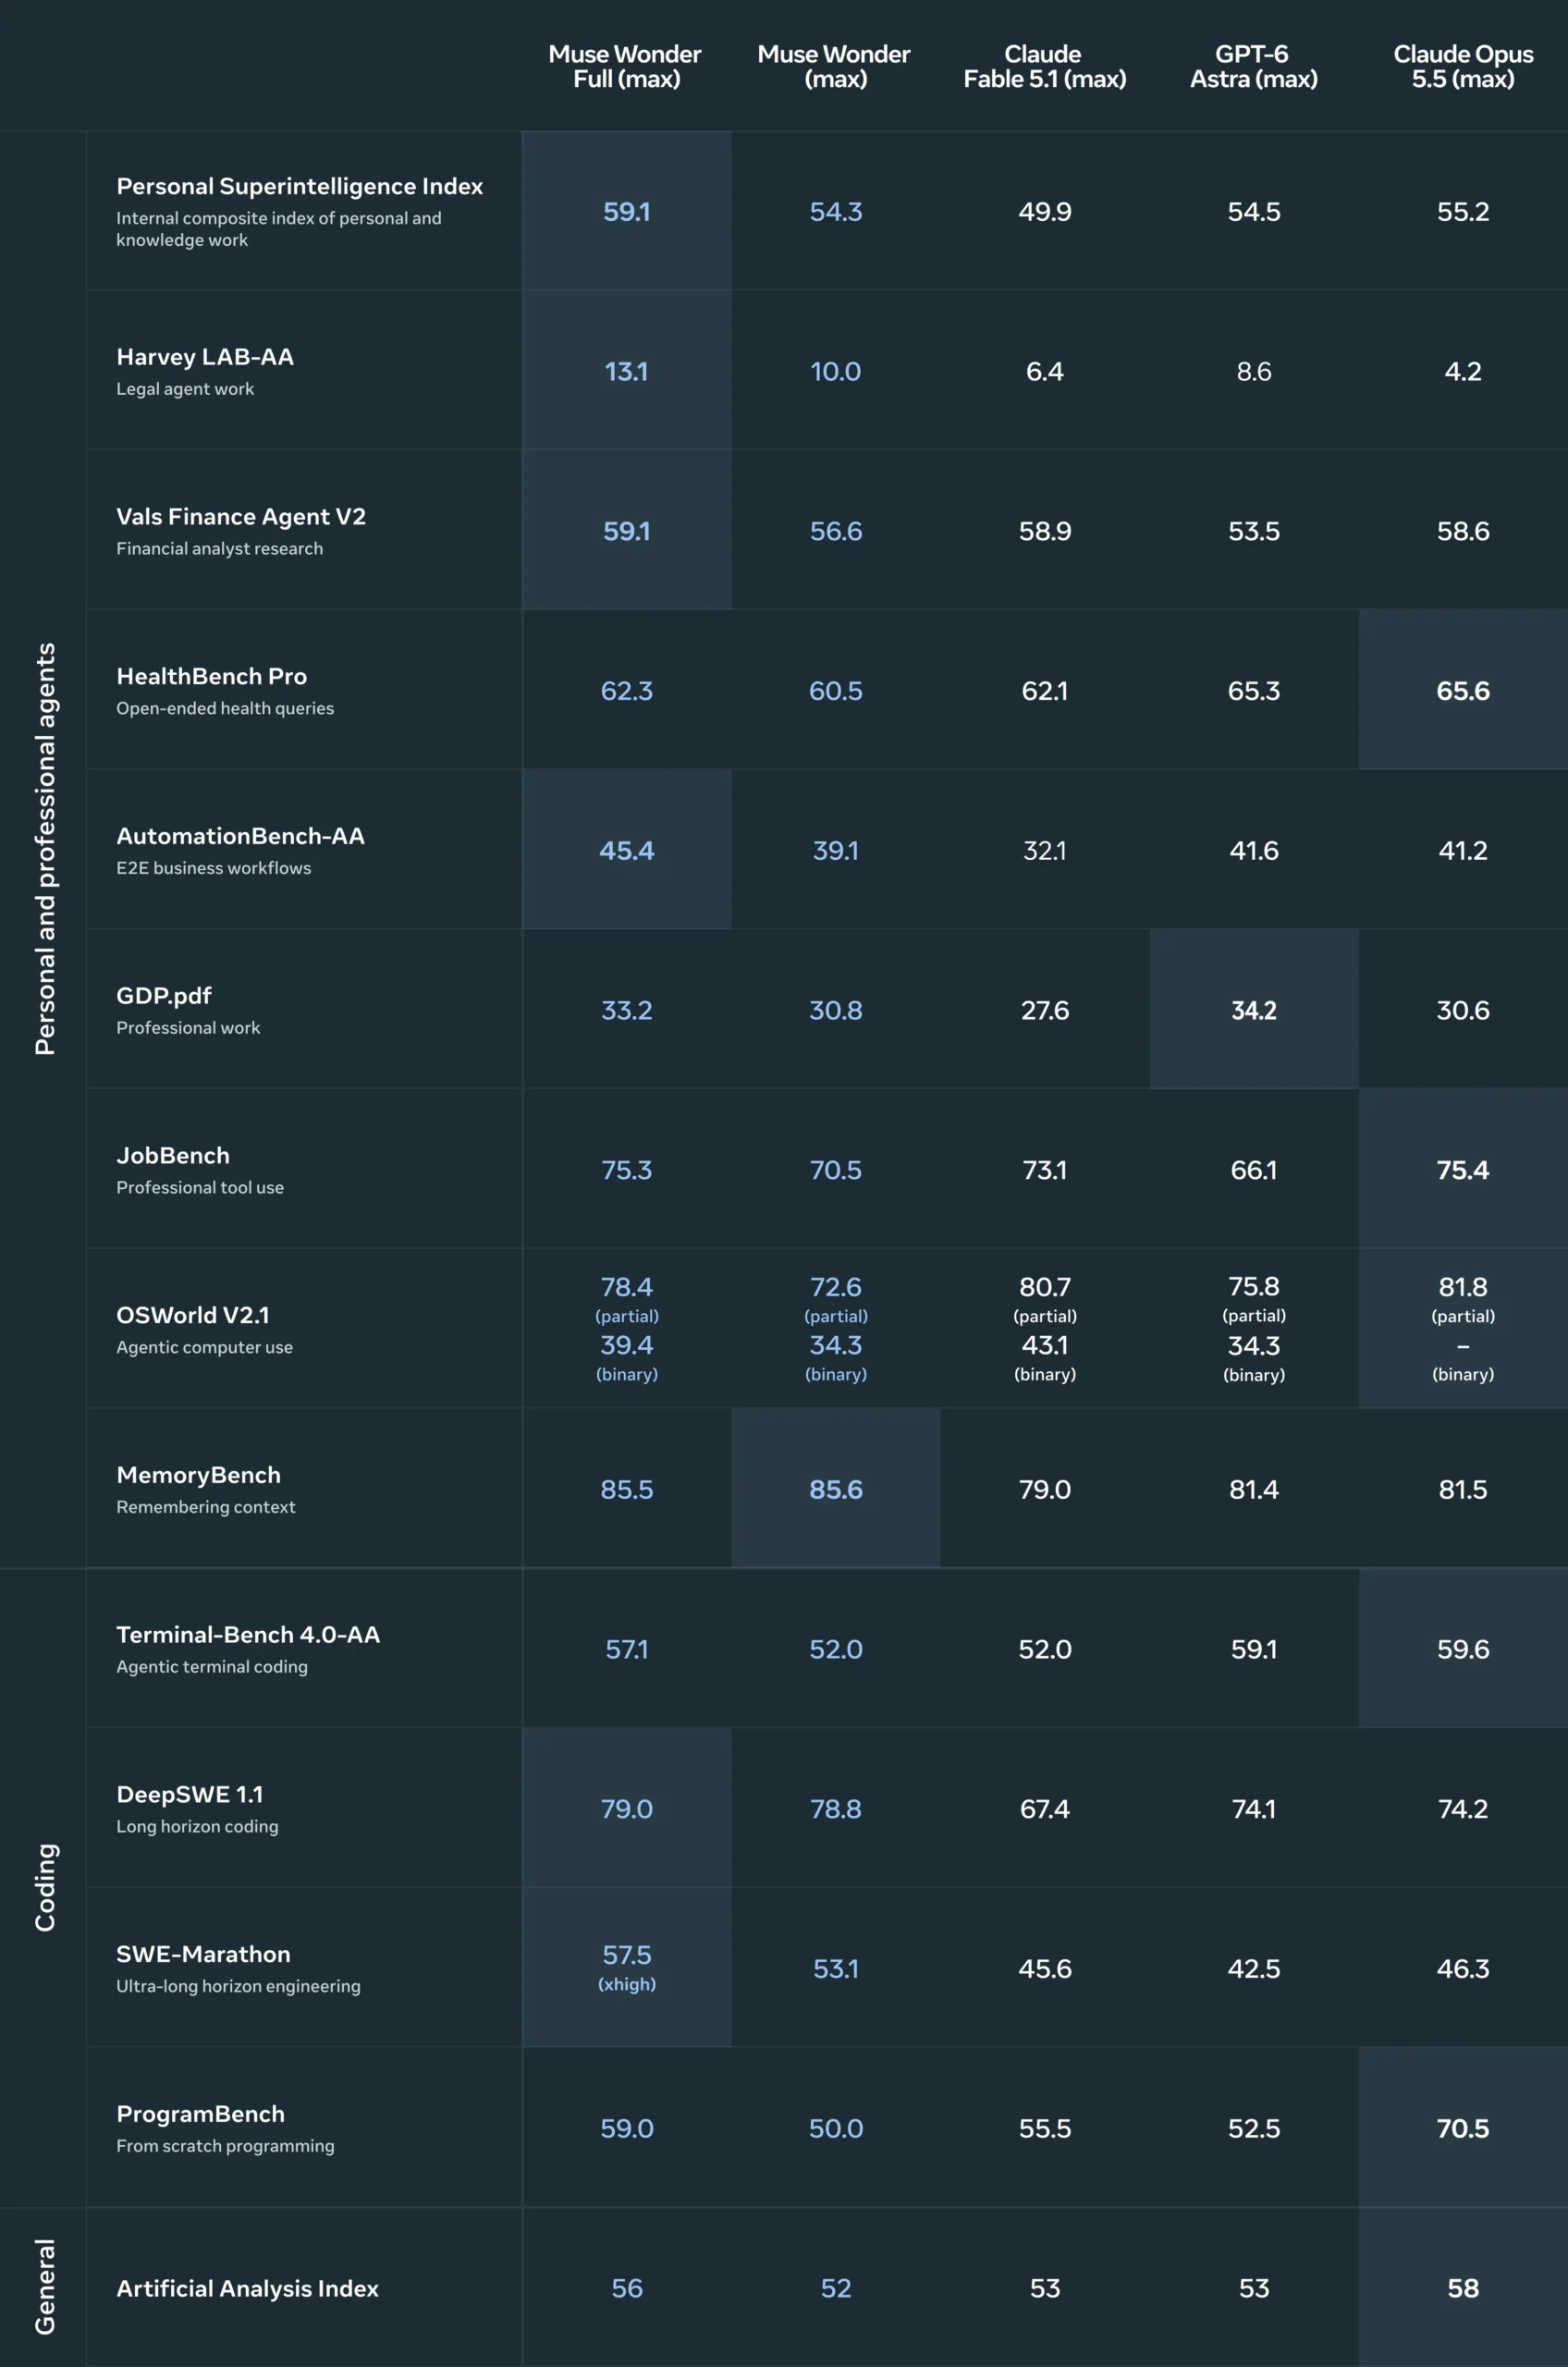
تظهر الفوائد الكبيرة في التقييمات القائمة على الوكيل، وهي اختبارات تُقيس مدى قدرة نموذج الذكاء الاصطناعي على التعامل مع المهام المعقدة بمفرده. على منصة Terminal-Bench 4.0، ارتفع الأداء من 33 إلى 57 بالمئة. تحتل "Muse Wonder Full" مركزًا ضمن الثلاثة الأوائل في ستة من عشرة معايير قياسية، وهو نتيجة قوية لشركة Meta، التي يبدو أنها تعافت بعد فترة ضعيفة في استخدام نماذج Llama المفتوحة.
تبرز الـ Meta ميزتين جديدتين. "الذاكرة النشطة" تسمح للنموذج بالتذكر للمعلومات الرئيسية خلال المحادثات وإعادتها عند الحاجة. "التركيز النشط" هو قدرة النموذج على التمسك بمهام صعبة، واستخدام أساليب بديلة، وطرح أسئلة تكميلية عندما يكون الأمر غير واضح. كلا الميزتين هما جوهر عرض Meta للخادم الذكي الشخصي الذي يمكنه الوصول إلى التقويمات والرسائل والمستندات.
يدعم كلا النموذجين نافذة سياق تتكون من مليون توكين، ويتقبلان النصوص والصور والفيديوهات والصوت كمدخلات. يتم توفير Muse Wonder من خلال واجهة برمجة التطبيقات الخاصة بـ Meta وMuse Code، بينما يقتصر Muse Wonder Full حاليًا على مستخدمي Muse Code. سيقوم Muse Wonder قريبًا بتشغيل تطبيق Muse أيضًا، بدءًا من المشتركين المدفوعين. ومن شأن ذلك أن تُبنى Meta نماذج متخصصة منه لجميع المستخدمين مع مرور الوقت.
تتحرك الترميز بشكل حاد، لكن المعرفة الواقعية تتخلف عنها
يظهر كلا النموذجين تحسنًا كبيرًا في البرمجة. يحقق Muse Wonder Full 68 نقطة في مؤشر Coding Agents، مما يضعه على قدم المساواة مع Claude Code وSonnet 5.5. أما Muse Wonder فتحصل على 63 نقطة، مقارنة بـ 54 نقطة في النسخة السابقة.
المعرفة الواقعية تظل نقطة ضعف. في اختبار المعرفة AA-Omniscience، يحصل Muse Wonder Full على 30 نقطة فقط، بينما يحصل Muse Wonder على 25 نقطة. هذا أقل بكثير من Claude Opus 5.5 (46)، وGPT-6 Astra (43)، وGemini 4 Argon (42)، مما يشير إلى أن سلسلة Wonder تستند إلى نموذج أساسي أصغر من منافسيها. انخفاض معدلات الخطأ يساعد على تعويض هذا الفارق. يقوم Muse Wonder Full بتقليل معدل الخطأ من 33 إلى 23 بالمئة مقارنة بنموذجه السابق، وهو أقل معدل بين جميع النماذج التي يحصلت على 45 نقطة مؤشر. Gemini 4 Argon (15 بالمئة) يخلط أقل في كثير.
يتناول Meta انتقادًا شائعًا في مقاله الإخباري، وهو أن نماذج Muse مُعدلة لاختبارات معيارية ولكنها تفشل في الاستخدام الواقعي. تقول الشركة إن Muse Wonder Full تتفوق على التوقعات في المهام غير المألوفة التي لم تكن جزءًا من تحسين التدريب، وتعزو ذلك إلى نموذج أساسي أقوى.
في فهرس Vals AI، يحتل Muse Wonder Full (Max) المركز الخامس ويتفوق على جميع نماذج OpenAI، وفقًا لـ Vals AI. فقط نماذج Anthropic الحالية تحصل على تقييمات أعلى. يحتل Muse Wonder المركز العاشر.
أكبر التحسينات تأتي من البرمجة والرياضيات. على منصة ProofBench، التي تُستخدم لأداء الاختبارات الرياضية الخاصة، حلت Muse Wonder Full 94 من أصل 100 مشكلة، مقارنة بـ 58 في النسخة السابقة. وهذا يعني أنها متأخرة خمسة إلى ستة نقاط عن النماذج المتفوقة (99 إلى 100). على منصة Terminal-Bench 4، ضاعفت Muse Wonder Full نتيجتها باستخدام 30% أقل من كلمات الإخراج. ظلت الأداء في المهام المالية والقانونية على مستوى النسخة السابقة، مع انخفاض بمقدار نقطتين.
الأداء الأفضل يجلب ثمنًا باهظًا
وفقًا للتحليل الاصطناعي، يبلغ سعر تنفيذ Muse Wonder $4.52 لكل مهمة على مؤشر الذكاء، وهو ما يعادل تقريبًا ثلاثة أضعاف سعر Muse Spark 1.3 ($1.60). كما ارتفعت أسعار التوكنات، حيث يبلغ سعر كل مليون توكن إدخال $4، وسعر الإخراج $20، مقارنة بـ $1.25 و$4.25 للإصدار السابق. كما يستخدم Muse Wonder 28% أكثر من توكنات الإدخال لكل مهمة، وهذه التوكنات تمثل 76% من التكاليف الإجمالية.
هذا يجعل Muse Wonder أقل من Claude Fable 5.1 بسعر $7.63، وClaude Opus 5.5 بسعر $5.98، لكنها أعلى من GPT-6 Astra بسعر $3.26، وGemini 4 Argon بسعر $1.99، وGPT-6.1 Sol بسعر $0.72. لا توجد أسعار للتوكنات المتاحة حتى الآن لـ Muse Wonder Full. كلا النموذجين يستخدمان حوالي 10 بالمئة أقل من عدد الكلمات الخارجة مقارنةً بالنسخة السابقة.
تقول Meta إنها قامت بتدريب النماذج في مركز البيانات Prometheus الخاص بها على مستوى الجيجاوات. وتوجد تفاصيل أكثر في بطاقة النموذج.
أخبار الذكاء الاصطناعي بدون الضجيج – مُختارة من قبل البشر
اشترك في THE DECODER للقراءة بدون إعلانات، إلى مجلة AI أسبوعية، تقرير حدودي حصري بعنوان “AI Radar” ست مرات في السنة، ووصول كامل إلى الأرشيف، بالإضافة إلى الوصول إلى قسم التعليقات.
المصدر: Meta | Artificial Analysis | Model Card