
توضح هذه التدوينة كيفية نشر نموذج لغوي كبير (LLM) عبر عقدتَي GPU على خدمة Amazon Elastic Kubernetes Service (Amazon EKS) باستخدام ميزة multi-node حاويات Ray للتعلم العميق في LLM. ويستخدم عقدتين منفصلتين للتعبئة المسبقة (prefill) وفك التشفير (decode) خلف نقطة نهاية واحدة متوافقة مع OpenAI. هذا النوع من الإعداد متعدد العقد شائع في حالات التوازي على مستوى الموتر والأنابيب والبيانات، وكذلك في أحمال عمل الاستدلال غير المجمّعة للتعبئة المسبقة وفك التشفير. في المنشور السابق، قدمنا Ray Serve DLC واستخدمها لإقامة نموذج صغير خلف نقطة نهاية HTTP على عقدة GPU واحدة. كانت لديك نقطة نهاية استدلال تعمل، وتحافظ الحاوية على توافق حزمة GPU، بما في ذلك مكتبات CUDA، فلم تكن بحاجة إلى كتابة كود نمطي متكرر.
راي هو إطار عمل حوسبة موزّع، لذا يمكن أن تمتد عمليات نشر Ray Serve عبر عدة عقد. يستخدم العملاء Ray Serve متعدد العقد لعدة أسباب. يريد البعض تشغيل نماذج أساسية أو نماذج ذات أوزان مفتوحة تكون أكبر من أن تتسع في وحدة معالجة رسومات واحدة. ويحتاج آخرون إلى إنتاجية أكبر مما يمكن أن يوفره نسخة احتياطية واحدة. ويريد آخرون فصل مرحلتي الاستدلال لتحسين الأداء. في كل حالة، يجب على العملاء بناء سلسلة التبعيات بأنفسهم: اختيار مكتبات متوافقة لحزمة GPU وتصحيح المشكلات عندما ينحرف أحد المكونات عن التوافق. هذا عمل غير متمايز يستهلك الوقت والجهد بعيدًا عن تقديم النماذج.
حاويات AWS للتعلم العميق (AWS Deep Learning Containers) حلّت حاويات التعلم العميق (DLCs) هذه المشكلة منذ فترة طويلة لأعباء عمل التدريب والاستدلال. إن حاويات التعلم العميق هي صور Docker جاهزة مسبقًا ومحسّنة الأداء تجمع إطار عمل معتبداته ومكدس GPU في مزيج مُختبَر ومُحدَّث بالترقيات يمكنك سحبه واستخدامه فورًا. مع إطلاق Ray LLM DLC بالنسبة لعمليات النشر متعددة العقد، تمتد تلك المنهجية نفسها الآن إلى الاستدلال متعدد العقد. تحصل على حاوية مصممة خصيصًا لتقديم النماذج خلف نقطة نهاية HTTP، تتم صيانتها واختبارها من قبل AWS، مع تجميع كومة الاستدلال الكاملة مسبقًا.
تستعرض هذه التدوينة كيفية تنفيذ الاستنتاج المفكّك متعدد العقد باستخدام Ray LLM DLC متعدد العقد: نشر نموذج لغوي واحد كبير عبر عقدتين مزوّدتين بوحدات معالجة الرسومات على Amazon EKS تتعاون خلف نقطة نهاية واحدة. بينما يتولى إحدى عقد GPU مع مرحلة prefill، يتولى عقد GPU الآخر مع مرحلة decode. إن فصل المراحل يمنع المطالبات الطويلة كثيفة الحوسبة من تعطيل توليد الرموز للطلبات الجارية بالفعل. هذا النهج مناسب جيداً لأحمال العمل مثل التوليد المعزز بالاسترجاع (RAG)، وتلخيص المستندات، والتطبيقات الوكيلة. نستخدم حزمة Ray LLM DLC متعددة العقد، والتي تأتي مع Ray Serve LLM, مكتبة نقل الاستدلال من NVIDIA (NIXL)و Elastic Fabric Adapter (EFA) المكدس، ويوفر واجهة برمجة تطبيقات متوافقة مع OpenAI دون أي كود تطبيقي. الكود الكامل متاح في المستودع المرفق.
لماذا فصلPrefill/Decode (PD)
للاستدلال في نماذج LLM مرحلتان متميزتان. الملء المسبق يعالج موجه الإدخال بالكامل بالتوازي ويبني ذاكرة التخزين المؤقت للمفتاح والقيمة (KV cache). فك الشفرة ثم يولّد الاستجابة رمزًا (token) في كل مرة، إذ يقرأ تلك الذاكرة المؤقتة ويوسّعها. تقتصر مرحلة ما قبل التعبئة (Prefill) على قدرة الحوسبة، بينما تقتصر مرحلة فك الترميز (Decode) على عرض نطاق الذاكرة. وعندما تتشارك المرحلتان وحدة معالجة رسومات واحدة، فإنهما تتنازعان على الموارد نفسها، ويتداخل عمل ما قبل التعبئة المتقطع والكثيف حسابيًا مع عمل فك الترميز المنتظم والحساس لزمن الاستجابة. إن فصل مرحلة ما قبل التعبئة عن مرحلة فك الترميز يعني أنه يمكنك اختيار العتاد وخصائص التقديم المناسبة لكل مرحلة، مما يحسّن الأداء العام على نطاق واسع.
يفصل تفكيك PD الطورين على عقدتين منفصلتين، بحيث يعمل كل طور دون أن يتداخل مع الآخر ويمكن توسيعه بشكل مستقل. المقايضة هنا هي أن ذاكرة التخزين المؤقت KV المبنية أثناء مرحلة prefill يجب أن تُسلَّم إلى عقدة decode، ويجب أن يكون هذا النقل سريعًا بما يكفي حتى لا يُلغي الفائدة. ولهذا بالضبط تُهمّ الوصلات البينية بين العقد.
ما يوفره ملحق DLC لنموذج Ray LLM
حزم AWS DLCs هي صور Docker مُنشأة مسبقًا ومحسّنة للأداء تجمع إطار عمل مع تبعياته ومجموعة GPU في تركيبة مُختبرة ومُصححة يمكنك سحبها واستخدامها فورًا. يتم التحقق من صحة جميع المكونات معًا قبل كل إصدار، بحيث لا يوجد انحراف في الإصدارات بين CUDA runtime والإطار وطبقة العرض. وتُطبَّق تصحيحات الأمان وقت البناء.
ال Ray LLM DLC يمدد هذا إلى خدمة نماذج LLM الموزعة، حيث يتضمن vLLM كمحرك الاستدلال (inference engine)، وHTTP في Ray Serve كطبقة التقديم، وNIXL لنقل ذاكرة التخزين المؤقت KV بين العقد، ومجموعة EFA (libfabric و aws-ofi-nccl) للاتصالات عالية النطاق الترددي بين العقد. نظرًا لأن مكتبة Ray Serve LLM تتضمن منشئ تطبيقات مدمجًا، فإن تطبيق التقديم بأكمله هو كتلة من YAML. لا توجد فئة معالج (handler)، ولا أرشيف نماذج (model archiver)، ولا صورة مخصصة تحتاج إلى بنائها. دالة مساعدة واحدة، build_pd_openai_app، تأخذ إعدادات ما قبل التعبئة (prefill) وإعدادات فك الترميز (decode) وتوصّل نقل ذاكرة التخزين المؤقت KV بينهما خلف نقطة نهاية واحدة متوافقة مع OpenAI.
بنية الحل
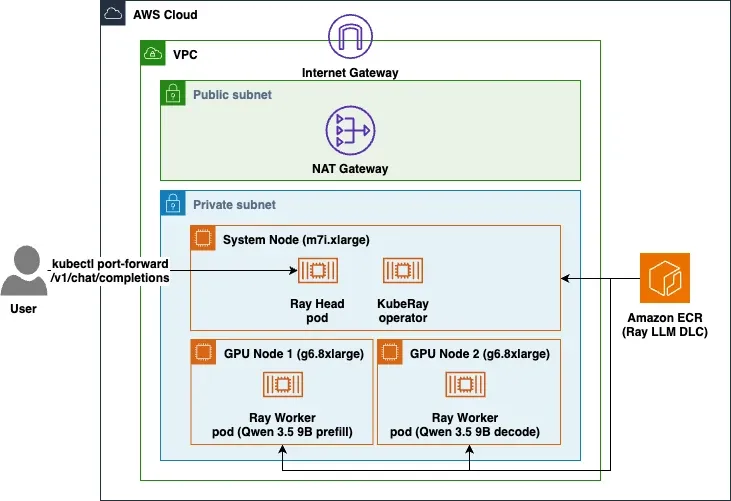
يوضح المخطط التالي كيفية توزيع النشر على Amazon EKS. يصل طلب المستخدم إلى رأس Ray على العقدة النظامية المزودة بوحدة المعالجة المركزية، بينما تعمل العقدتان العاملتان المزودتان بوحدات معالجة الرسوميات على مرحلتي ما قبل التعبئة وفك الترميز للنموذج.
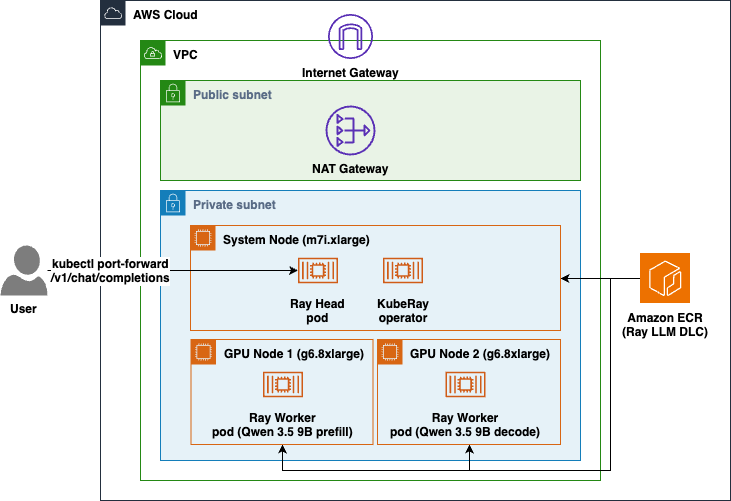
الشكل 1: بنية الاستدلال متعدد العقد على Amazon EKS، مع رأس Ray على عقدة نظامية بوحدة معالجة مركزية ومرحلتي ما قبل التعبئة وفك الترميز على عقدتين عاملتين بوحدات معالجة رسوميات
النشر عبارة عن عنقود EKS داخل شبكة افتراضية خاصة (VPC). تعمل العقد في شبكات فرعية خاصة مع وصول صادر عبر بوابة NAT. عقدة نظامية بوحدة معالجة مركزية عقدة النظام (m7i.xlarge) تستضيف أحمال العمل النظامية، ومشغل KubeRay وحجرة رأس Ray، التي تعتمد على وحدة المعالجة المركزية فقط. تعمل عقدتا عمل بوحدات معالجة رسوميات عقدتا العمل (g6.8xlarge) لتشغيل عمال Ray: إحداهما تقدّم مرحلة ما قبل التعبئة، والأخرى تقدّم مرحلة فك الترميز. تسحب كلتا العقدتين صورة Ray LLM DLC من Amazon Elastic Container Registry (Amazon ECR).
يراقب KubeRay خدمة RayService التي تطبقها ويوصّل انضمام الرأس إلى العامل تلقائيًا. يضع Ray Serve عمليات نشر ما قبل التعبئة وفك الترميز على عاملَي وحدات معالجة الرسوميات. تتدفق ذاكرة التخزين المؤقت KV من عامل ما قبل التعبئة إلى عامل فك الترميز عبر NIXL، مستخدمةً EFA من خلال خلفية libfabric في NIXL. مجموعة عقد وحدات معالجة الرسوميات مثبتة على منطقة توفر (AZ) واحدة لأن EFA لا يمكنها عبور مناطق التوفر.
المتطلبات الأساسية
لمتابعة هذا المنشور، تحتاج إلى:
- حساب AWS مع تمكين الفوترة.
- حصة خدمة كافية لتشغيل مثيلين من نوع g6.8xlarge (64 vCPU على الأقل) في المنطقة المستهدفة.
- واجهة AWS سطر الأوامر (AWS CLI) مع بيانات اعتماد مهيأة.
- kubectl CLI للتواصل مع مستوى التحكم في عنقود Kubernetes.
- eksctl CLI لإنشاء العناقيد وإدارتها على EKS.
- helm (مدير الحزم لـ Kubernetes) لتثبيت KubeRay operator.
- أداة envsubst (جزء من GNU gettext) لعرض الـ manifest.
تحقق من أن بيانات اعتماد AWS الخاصة بك نشطة باستخدام الأمر التالي:
aws sts get-caller-identityاستخدم التطبيق الجاهز مسبقًا لتقديم الاستدلال
التطبيق هو serveConfigV2 block في manifest/rayservice.yaml. يستخدم build_pd_openai_app، والتي تأخذ prefill_config و decode_config وتربط نقل الـ KV-cache بينهما:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
بضعة إعدادات تحمل معظم الأثر. max_model_len: 4096 يضبط حجم السياق ليتناسب مع الـ KV cache المقاس على الـ GPU. dtype: bfloat16 و gpu_memory_utilization: 0.90 يحددان الدقة ومقدار الـ VRAM الذي يمكن لـ vLLM المطالبة به. enforce_eager: true يتخطى التقاط CUDA graph لتقليل ذاكرة GPU القصوى (يعتمد على النموذج والمدخلات). الإعداد kv_transfer_config هو ما يجعل التفكيك (disaggregation) يعمل: تستخدم كلتا المرحلتين NixlConnector مع kv_role: kv_both و engine_id مميز (prefill على أحدهما و decode على الآخر). الإعداد الحاسم هو kv_connector_extra_config: { backends: ["LIBFABRIC"] }. بدون ذلك السطر، يعتمد NIXL افتراضيًا على UCX، الذي يعمل بسرعة TCP حتى على EFA.
يصف باقي الـ manifest، بتنسيق rayClusterConfig، الـ pods. الـ head pod يعتمد على CPU فقط (num-gpus: "0") ومثبت على node group الخاص بالنظام. كل worker pod يطلب GPU واحدًا وواجهة EFA واحدة (nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1") ويستهدف عقد الـ GPU عبر nodeSelector: { role: gpu-worker }. يعمل privileged: true لأن NIXL يسجّل CUDA VRAM مع بطاقة شبكة EFA. الخاصية IPC_LOCK وحدها ليست كافية. الـ workers يضبطون FI_PROVIDER=efa، ويقرأون VLLM_HOST_IP من عنوان IP الخاص بالـ pod، وي mount حجزًا للذاكرة المشتركة. حدود الذاكرة أعلى بكثير من نقطة الفحص البالغة تقريبًا 18 GiB حتى يتمكن page cache لنظام التشغيل من الاحتفاظ بها. لتحميل نموذج Qwen3.5-9B على g6.8xlarge مع إعدادات cache السابقة، ينخفض زمن تحميل أوزان النموذج من حوالي 145 ثانية إلى حوالي 2 ثانية عند إعادة التشغيل.
النشر على Amazon EKS
تشارك جميع السكربتات ملف تكوين واحدًا، scripts/env.sh. يحتوي السكربت على القيم الافتراضية لـ CLUSTER_NAME, REGION, K8S_VERSION، و NAMESPACE. تغطي القيم الافتراضية الأخرى مجموعات عقد النظام وGPU، وإصدار KubeRay، والنموذج. يمكنك تجاوز أي متغير عبر تصديره قبل تشغيل السكربت.
من الجذر الخاص بالمشروع، عيّن دليلًا أساسيًا، ثم حمّل المتغيرات:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
الخطوة 1: إنشاء عنقود EKS
./deploy_cluster.shيقوم هذا بتهيئة عنقود EKS (شبكة VPC، ومزود OIDC، والإضافات الأساسية) ومجموعة عقد نظام من نوع CPU لتشغيل أحمال النظام، ومشغّل KubeRay، ورأس Ray. تعمل العقد في شبكات فرعية خاصة مع مخرج عبر بوابة NAT، وتوضع الشبكات الفرعية للعنقود في مناطق التوافر التي توفر نوع مثيل GPU. السكربت قابل لإعادة التنفيذ (idempotent) ويستغرق من 15 إلى 20 دقيقة عند التشغيل الأول.
الخطوة 2: إضافة عقد عاملة من نوع GPU
./deploy_node_group.shينشئ هذا مجموعة عقد GPU: مثيلين من نوع g6.8xlarge مع تمكين EFA، ومثبّتَين في منطقة توافر واحدة وموسومَين بـ role=gpu-worker حتى يستهدفهما عمال Ray. كما أن تمكين EFA يثبّت إضافة جهاز EFA، التي تعلن عن vpc.amazonaws.com/efa على كل عقدة. تستغرق هذه الخطوة حوالي من 5 إلى 20 دقيقة، وعادة ما تكون أطول في التشغيل الأول.
الخطوة 3: تثبيت مشغّل KubeRay
./install_kuberay.shيقوم هذا بتثبيت مشغّل KubeRay باستخدام Helm، مثبّتًا على مجموعة عقد النظام للحفاظ على عقد GPU متاحة للاستدلال. يراقب KubeRay خدمة RayService التي ستطبقها لاحقًا ويربط عملية انضمام العامل بالرأس تلقائيًا. تستغرق هذه الخطوة حوالي من 1 إلى 2 دقيقة.
الخطوة 4: نشر RayService
./deploy_ray_service.shيقوم هذا بإنشاء manifest/rayservice.yaml بصورتك ونموذجك ومتغيرات التسمية الخاصة بك باستخدام envsubst ثم يطبّقه. ينشئ KubeRay بود الرأس وبودين للعمال، ويقوم Ray Serve LLM بتشغيل نشرَي prefill وdecode. ينتظر السكربت حتى يصبح الرأس Ready، وكلا العاملين Running، وأخيرًا حتى يبلّغ تطبيق Serve عن حالة RUNNING. ولأن كل عقدة تحمّل النموذج، توقّع أن تستغرق هذه الخطوة عدة دقائق.
تحقّق من الحالة في أي وقت، بما في ذلك العقدة التي استقر عليها كل بود وسعة GPU المتاحة:
./deploy_ray_service.sh statusاستدعاء النموذج
بعد أن يصبح تطبيق Serve سليمًا، ينشئ KubeRay خدمة <rayservice-name>-serve-svc مستقرة. قم بإعادة توجيه المنفذ إليها:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000ولأن DLC يوفّر واجهة API متوافقة مع OpenAI، يمكنك سرد النماذج وإرسال طلب إكمال محادثة قياسي دون مخطط مخصص:
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
التحقق من استخدام EFA
يرجع NIXL إلى نقل بسرعة TCP إذا لم يتمكن من استخدام libfabric، ويقوم بذلك دون إطلاق خطأ، لذا من المفيد تأكيد الواجهة الخلفية التي اختارها. ابحث في سجلات العامل:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh يطبع بالفعل عدد vpc.amazonaws.com/efa لكل عقدة عندما ينشئ المجموعة. للحصول على رقم لعرض النطاق الترددي بين العقد، يأتي DLC مع معيار أداء جاهز لمكتبة NVIDIA Collective Communications Library (NCCL) على العنوان /usr/local/bin/all_reduce_perf.
التنظيف
لتجنب الرسوم المستمرة، قم بهدم الموارد بترتيب عكسي:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
الخلاصة والخطوات التالية
لقد قدّمت نموذجًا واحدًا عبر عقدتي GPU مع فصل prefill/decode، وكان التطبيق بأكمله كتلة من YAML، دون كود معالج، ودون أرشيف نماذج، ودون حزمة GPU وEFA مجمّعة يدويًا. وفّرت حزمة Ray LLM DLC متعددة العقد حزمة الاستدلال المُختبَرة، وقام KubeRay بتنسيق عنقود Ray، وحمل NIXL عبر EFA ذاكرة KV cache بين العقد. كانت مهمتك هي تكوينه، لا بناؤه.
تشمل الأنماط الشائعة لتشغيل الاستدلال متعدد العقد توازي الموتر والتوازي التدفقي (تقسيم نموذج أكبر من أن يتسع لمثيل واحد)، والتوازي البياني (تكرار نموذج لزيادة الإنتاجية)، وفصل prefill/decode (فصل مرحلتَي الاستدلال إلى عقد مختلفة).
من هنا يمكنك توسيع نطاق نسخ decode لمزيد من الإنتاجية، أو الانتقال إلى نماذج أكبر باستخدام توازي الموتر أو التوازي التدفقي على مثيلات GPU أكبر، أو إضافة مكتبات إضافية فوق القاعدة المُختبَرة نفسها للنماذج التي تحتاجها. للحصول على الكود الكامل، والقائمة الحالية لوسوم الصور، والآليات الأساسية، راجع المستودع المرافق، صفحة Ray LLM DLC available images، ووثائق Ray Serve LLM prefill/decode، ووثائق EFA.