
النقاط الرئيسية
- يتيح AI Search الآن للمستخدمين العثور على المحادثات استنادًا إلى الفهم الدلالي للآثار، مثل: "هل شعر المستخدم بالإحباط؟" أو "هل تسربت بيانات شخصية (PII)؟"
- صِف سلوكًا بلغة عادية، ويقرأ نموذج قرار سريع الآثار ويعيد تلك التي حدث فيها ذلك السلوك.
- يستخدم LangSmith المسارات (trajectories) لتوحيد الآثار، وتقليل تضخم السياق، وتسليم نتائج الاستعلام بسرعة.
آثار الوكلاء كبيرة، ومتعددة الوسائط، وكثيفة المعلومات. وهي تلتقط تفاصيل رئيسية مثل مدخلات المستخدم، وكيفية استجابة الوكلاء، وحالات فشل المنطق. هذا يجعل الآثار ذات قيمة فريدة لفهم سلوك المستخدمين وتحسين أداء الوكلاء، لكن منصات البيانات التقليدية لم تُبنَ للتعامل مع حمولات كبيرة وغير مهيكلة كهذه.
لجعل بيانات الآثار مفيدة، تحتاج الفرق إلى بنية تحتية تدعم دورة الحياة الكاملة: استيعاب وتخزين كميات كبيرة من التشغيلات (runs)، والاستعلام عن الآثار بمرونة، وتحويلها إلى عروض للتصحيح وتحليل المنتج وسير العمل التشغيلي مثل التعليقات التوضيحية. لهذا السبب بنينا SmithDB، قاعدة البيانات المصممة خصيصًا لبيانات الآثار في LangSmith، ومؤخرًا Custom Apps، التي تتيح للفرق إنشاء عروض مخصصة فوق آثارها.
اليوم، نضيف AI Search، طريقة جديدة للاستعلام عن الآثار باستخدام اللغة الطبيعية.
لماذا بنينا AI Search
تحتوي كل أثر على مدخلات المستخدم، وتفكير الوكيل، واستدعاءات الأدوات، والاستجابات، أي كل المعلومات المطلوبة لفهم أين يحقق الوكلاء أداءً جيدًا وأين يفشلون. غالبًا ما تستخرج الفرق التي تستخدم LangSmith آثار وكلائها للعثور على أمثلة لمجموعة بيانات تقييم dataset أو محادثات لمراجع في annotation queue.
ومع ذلك، قد يكون اكتشاف الآثار الصحيحة أمرًا مرهقًا. فالأسئلة مثل "هل تسربت بيانات شخصية (PII)؟" أو "هل شعر المستخدم بالإحباط؟" لا ترتبط بشكل نظيف بخاصية واحدة من خصائص الأثر مثل الوسوم (tags) أو البيانات الوصفية (metadata)، ولا يمكن الإجابة عنها بالبحث النصي الكامل أيضًا. فهي تتطلب فهمًا لمحتويات الأثر. وحتى الآن، كان ذلك يعني إعداد مقيّم مسبقًا أو مراجعة الآثار يدويًا.
لهذا بنينا AI Search. أنت تصف السلوك الذي تبحث عنه، ويعيد لك LangSmith الآثار التي حدث فيه. هذا يمكّنك من العثور على آثار نادرة كالإبرة في كومة قش، والبحث عن الأنماط المزعجة بشكل مخصص عند الحاجة.
ما يمكنك البحث عنه
يمكنك البحث عن أي شيء يظهر في محتوى الأثر. قد تبحث عن وكيل قال إنه أكمل مهمة لكنه لم يكملها، أو مستخدم بدا محبطًا أو اعترض على إجابة، أو طلبًا إلى نموذج سرّب بيانات شخصية (PII)، أو شخصًا يحاول إلغاء اشتراكه. ويمكن لفرق المنتجات البحث عن "طلبات تكاملات لا ندعمها" أو "ذكر منافس" أو "مستخدمون مرتبكون بشأن الإعداد الأولي" ورؤية أين يقصر المنتج، بعبارات المستخدمين أنفسهم.
يعمل AI Search أيضًا جنبًا إلى جنب مع الفلاتر التي تستخدمها بالفعل، فيمكن إجراء بحث على الآثار التي أخطأت فقط، أو مع وسم محدد فقط.
كيف بنيناها
لماذا يقرأ نموذج كل أثر
البحث المتجهي (vector search) هو الطريقة المعتادة للبحث حسب المعنى بدلًا من الكلمات الحرفية. يحوّل استعلامك وكل أثر إلى تضمين (embedding)، أي قائمة قصيرة من الأرقام تلتقط موضوع النص. ثم يعيد الآثار التي تكون تضميناتها الأقرب إلى تضمين استعلامك. يعمل هذا جيدًا للبحث عن المواضيع، مثل العثور على محادثات تتعلق بالفواتير. لكن التضمين يضغط أثرًا كاملًا في متجه صغير واحد، وهذا الضغط يفقد معلومات. فقد تضيع تفاصيل مهمة متعلقة باستعلامك. يمكن لأثر نجح فيه الوكيل في إنجاز العمل فعليًا وآخر قال فيه فقط إنه أنجزه أن ينتهيا بتضمينين متطابقين تقريبًا. وتمييزهما يتطلب نموذجًا يقرأ الكلمات الفعلية للأثر مع سؤالك، ليتمكن من الاستدلال على ما حدث.
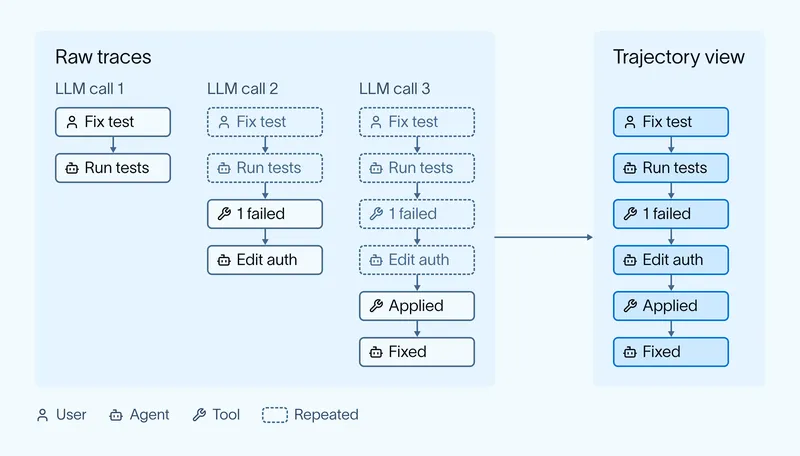
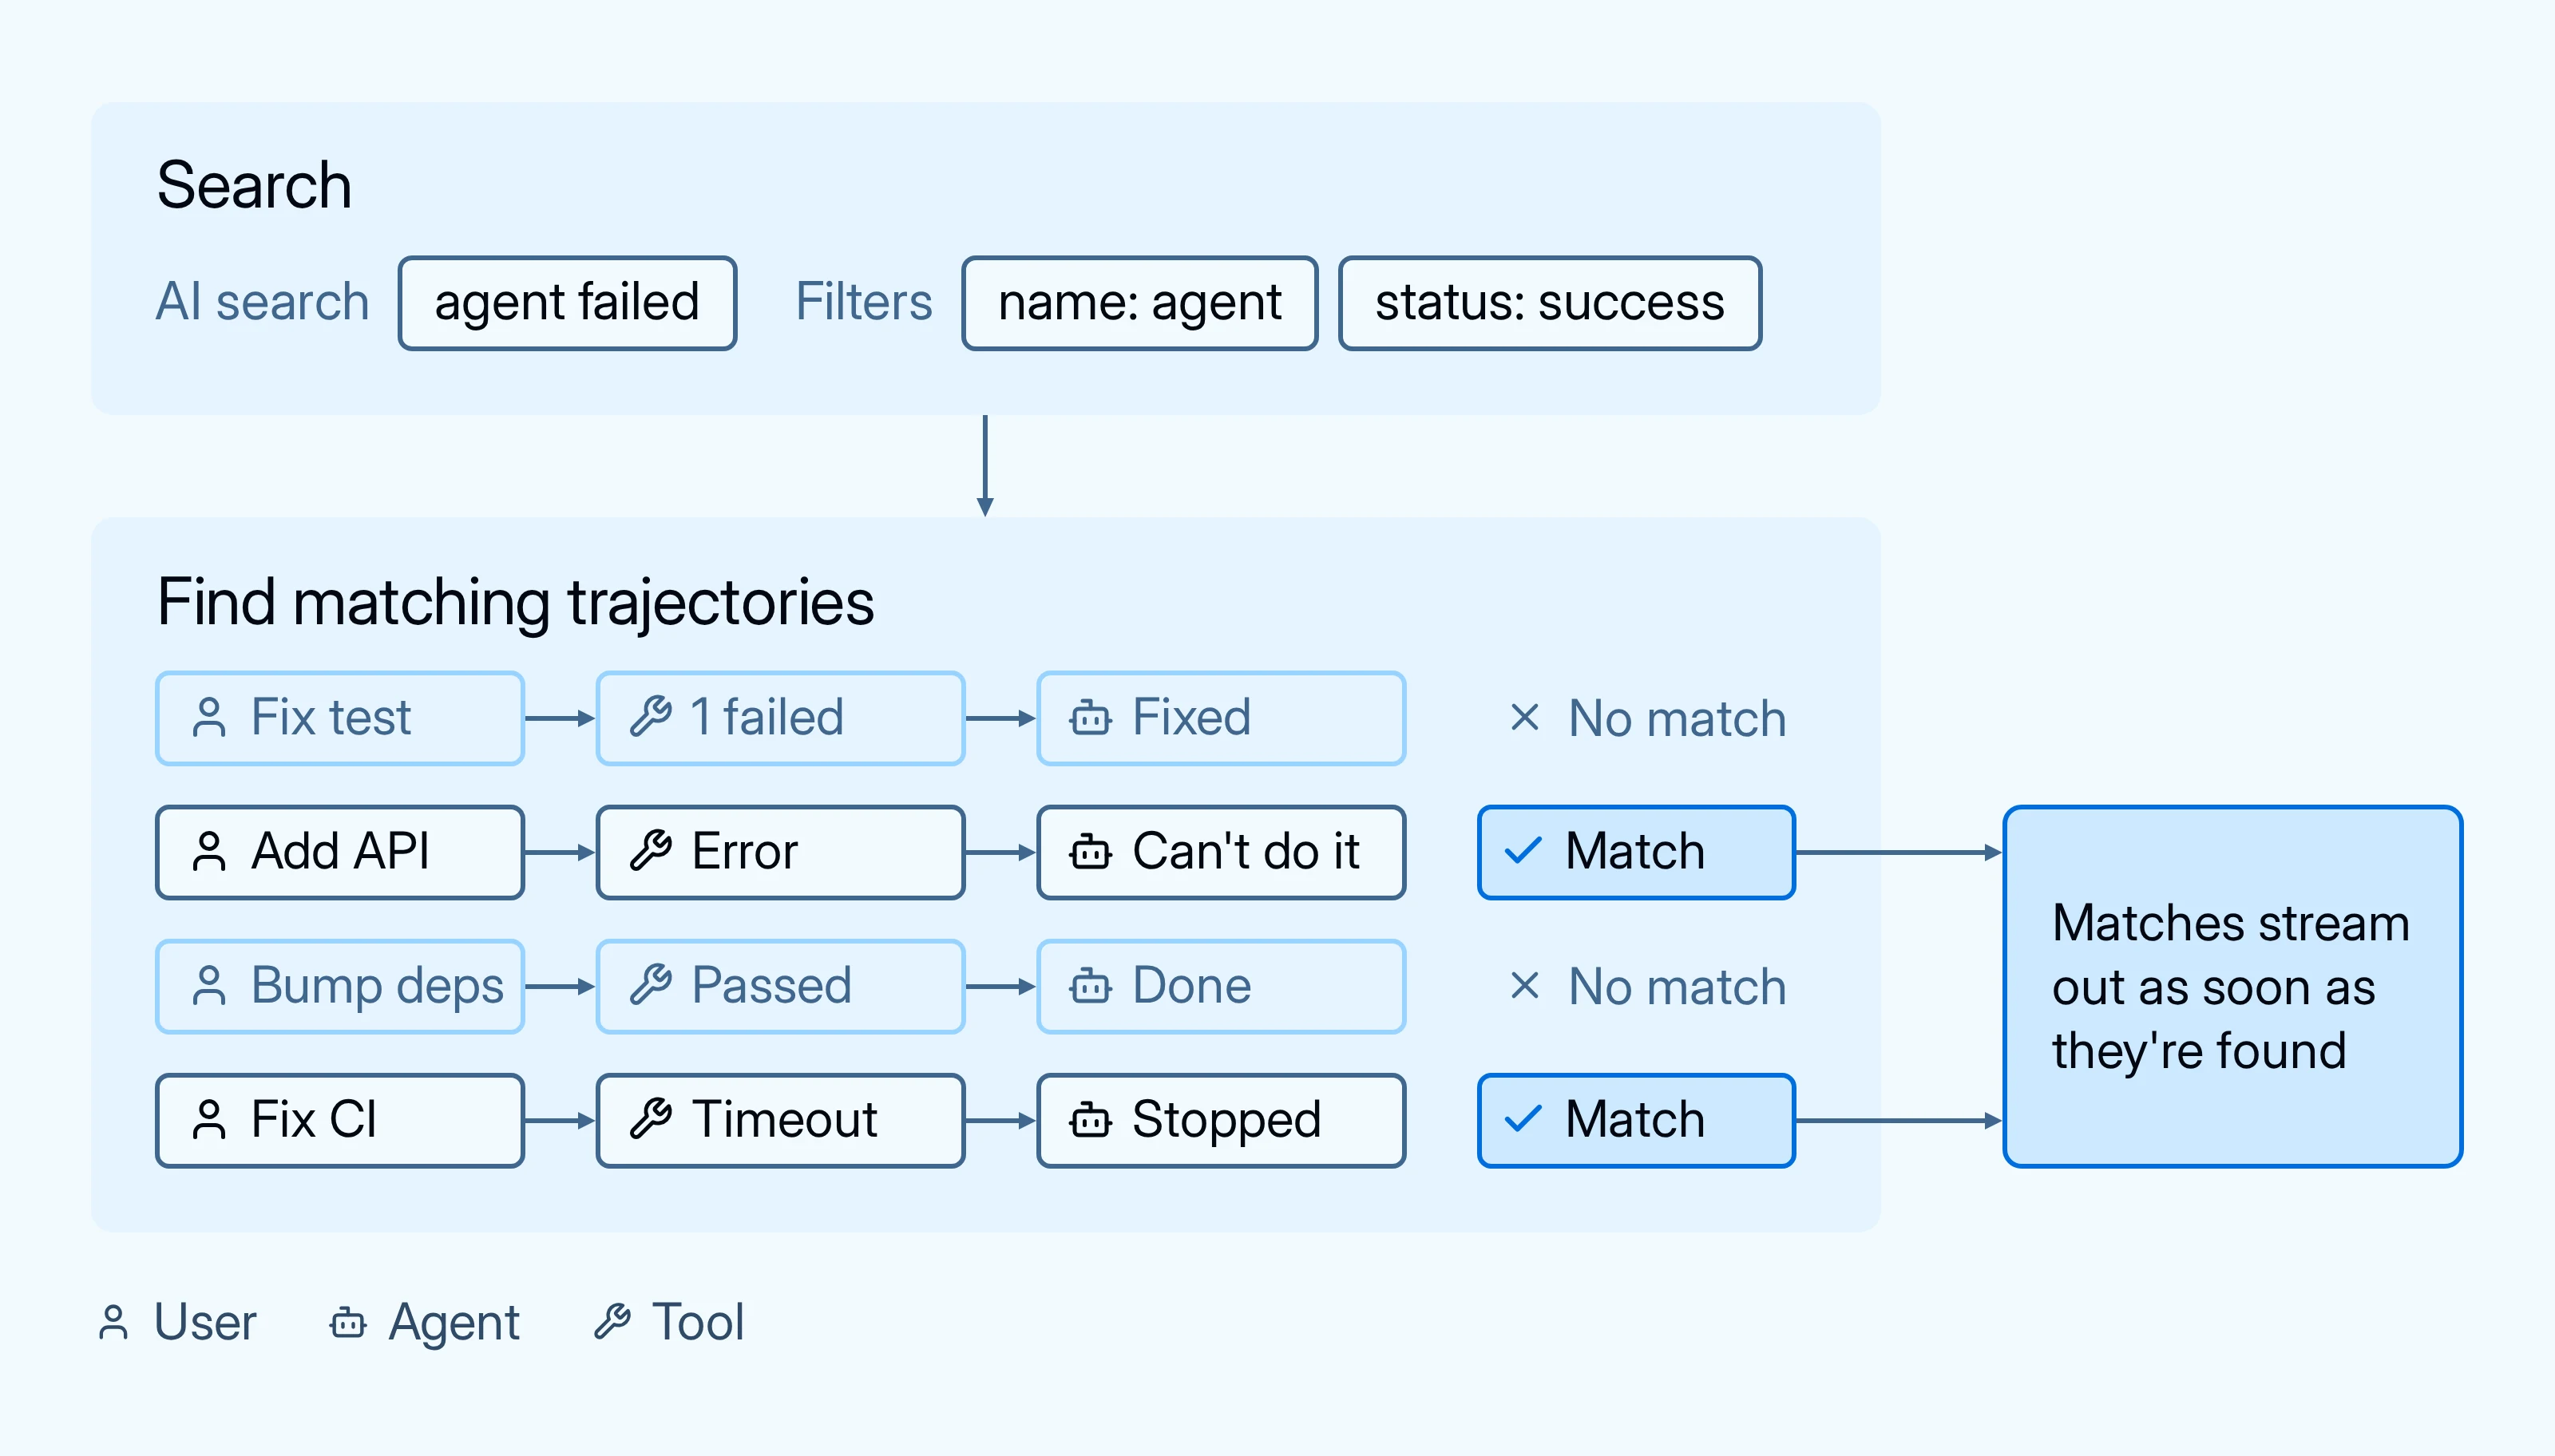
إلى وقت قريب، كان القيام بذلك وقت البحث بطيئًا جدًا ومكلفًا جدًا. غيّرت نماذج القرار السريعة ذلك. فهي تجيب عن سؤال ضيق واحد حول المدخل بسرعة وبكلفة منخفضة بما يكفي للتشغيل على نطاق واسع. يقرن AI Search استدلال نموذج القرار مع SmithDB، طبقة البيانات الخاصة بنا لمراقبة سلوك الوكلاء. فمع وصول الآثار (traces)، يحوّلها SmithDB إلى مسارات (trajectories). وعندما تجري بحثًا، تضيّق مرشحاتك المرشحين، ويتحقق نموذج القرار من كل مسار متبقٍ مقابل وصفك.
الآثار كبيرة الحجم وتأتي بصيغ متعددة
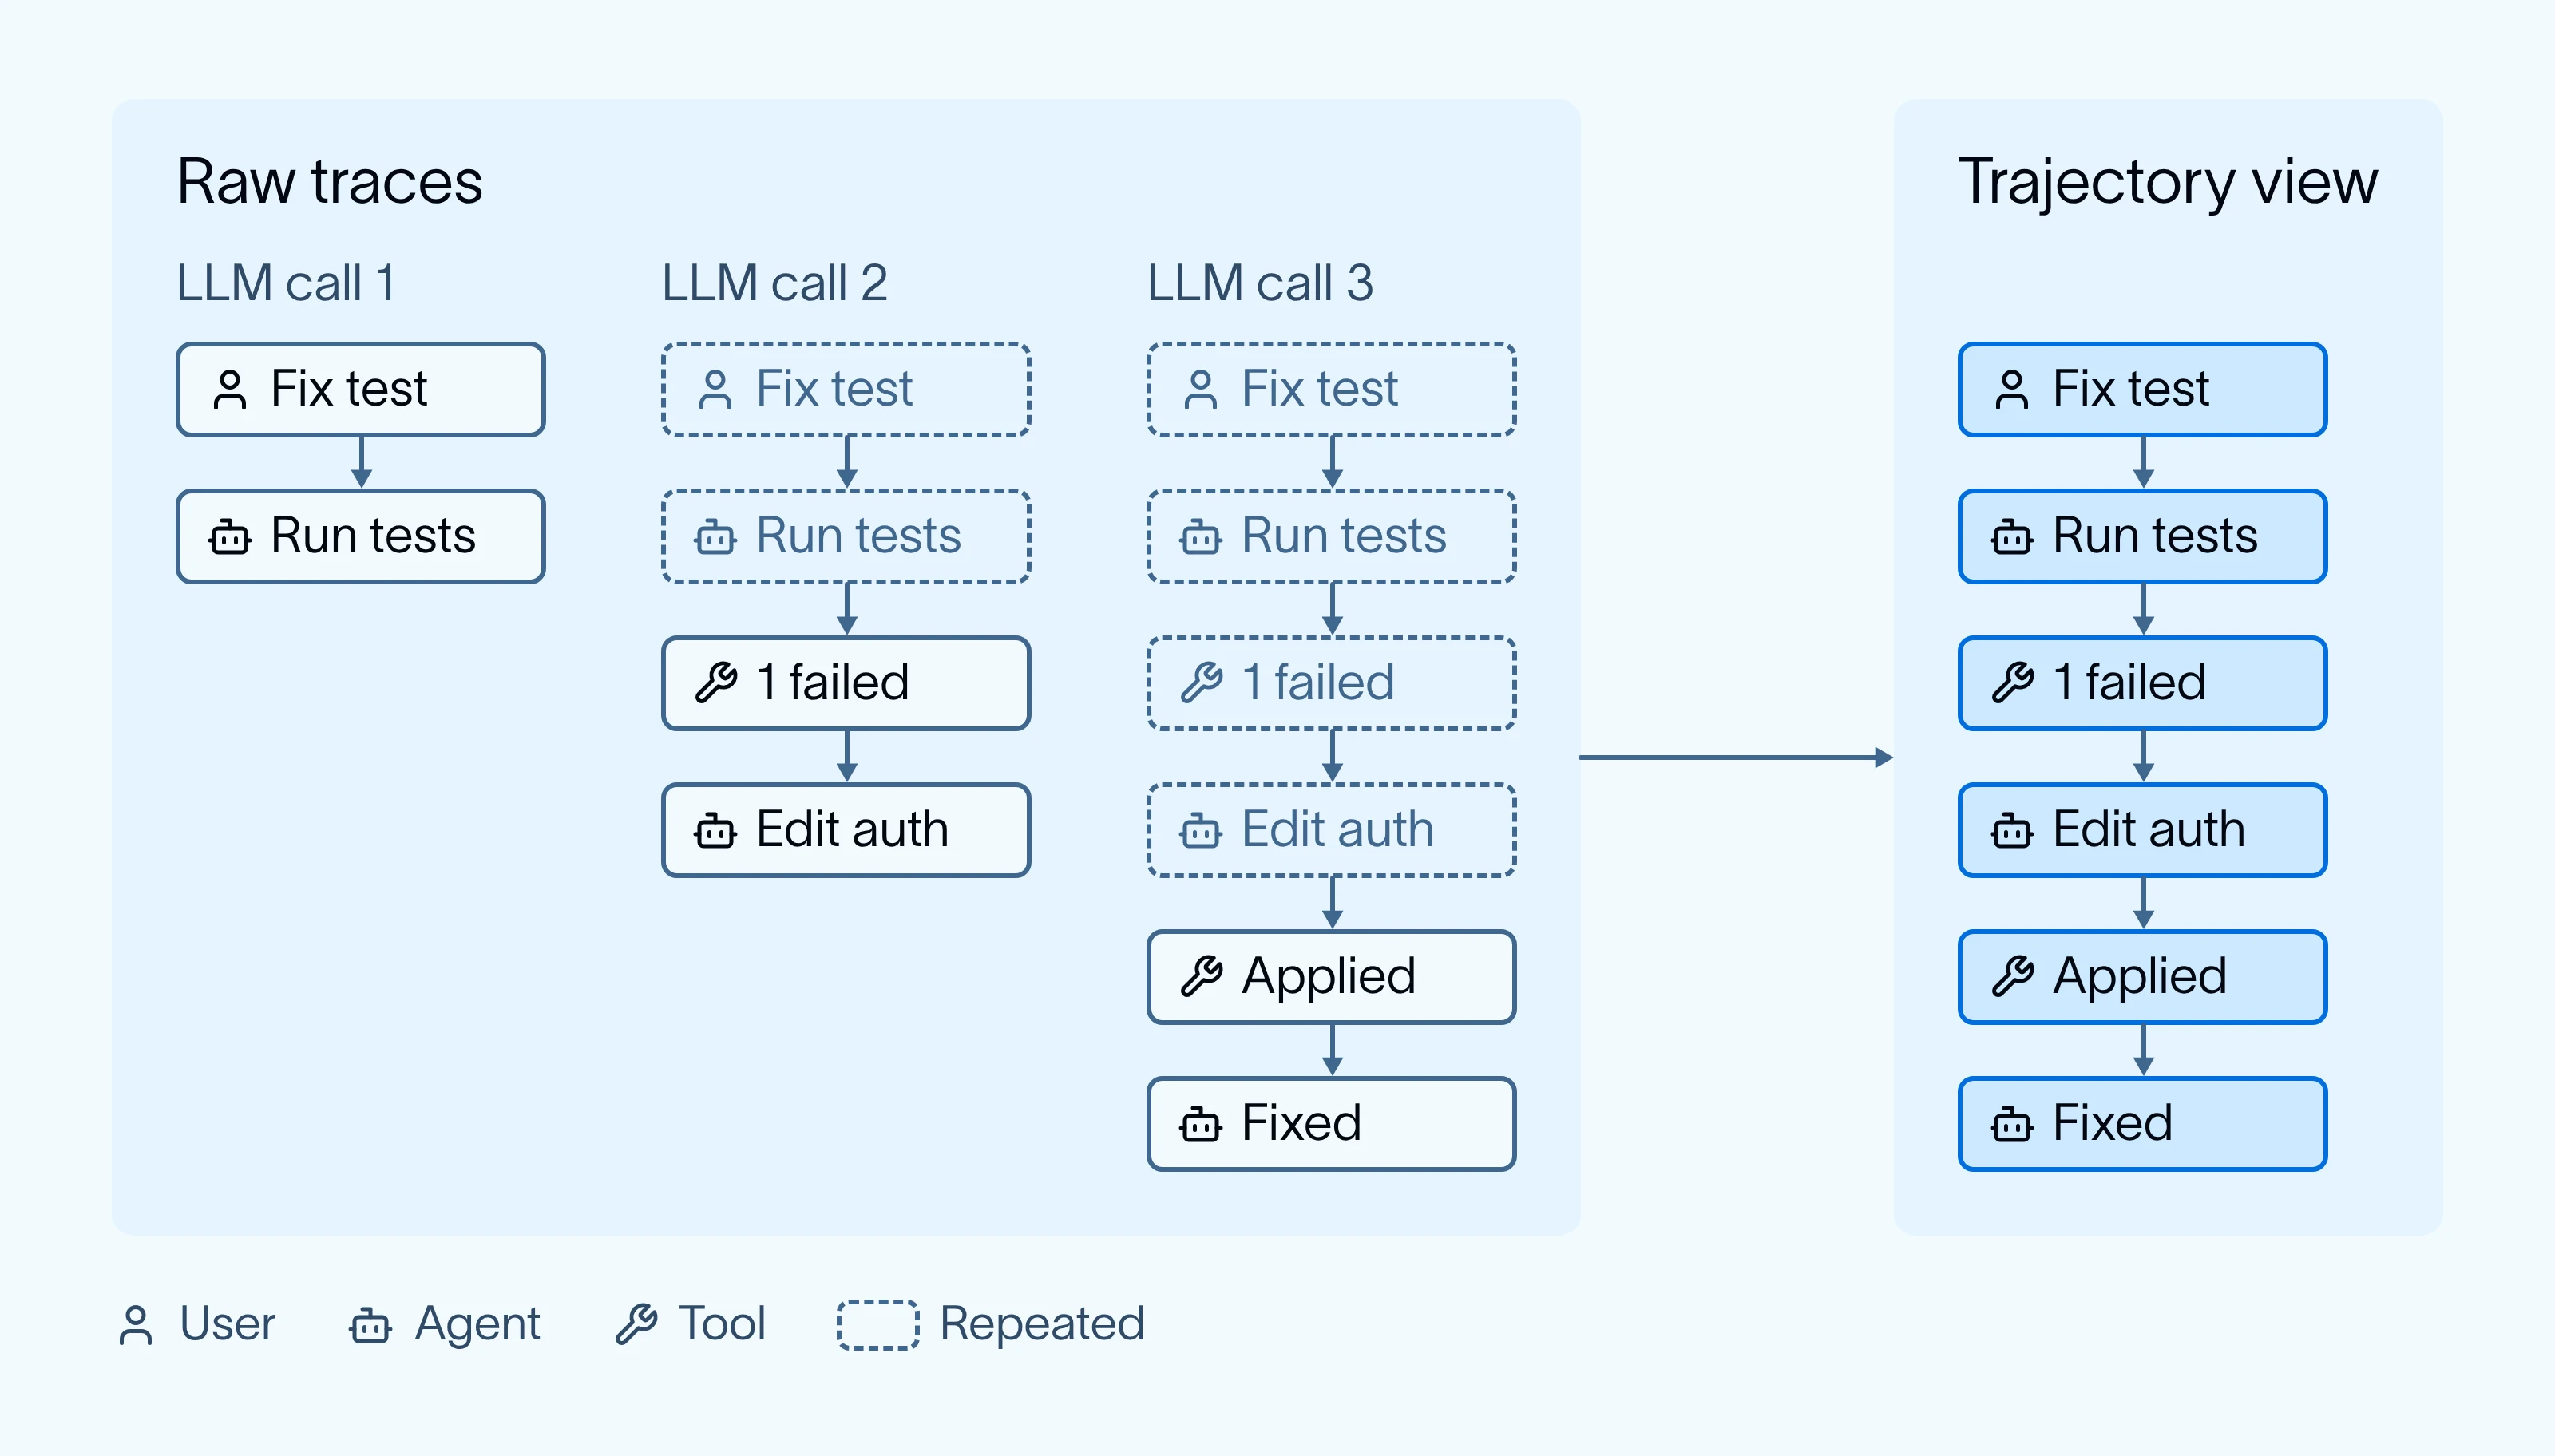
تأتي الآثار من مصادر عديدة: حزم OpenAI وAnthropic SDK وLangChain وLangGraph وVercel AI SDK وOpenTelemetry وغيرها. وتسجّل كل منها الرسائل بطريقة تختلف قليلًا. كما أن الآثار تكرر نفسها. فالوكلاء غالبًا ما يعيدون إرسال سجل المحادثة مع كل استدعاء LLM، فتظهر الرسالة الأولى مجددًا في كل استدعاء لاحق لها.
يحوّل SmithDB هذه الآثار إلى مسار (trajectory) لكل جلسة. والمسار هو عرض مكثّف لعمل الوكيل: كل رسالة وكل استدعاء أداة وكل نتيجة أداة، مدرجة مرة واحدة. يبنيه SmithDB مع وصول الآثار ويضع كل الصيغ المدعومة في الشكل نفسه.
يحلّل AI Search المسارات بدلاً من الآثار الخام. ولأن كل تنسيق له شكل مسار واحد نفسه، يعمل بحث واحد عبر الوكلاء المبنيين على SDK مختلفة. وإزالة الرسائل المتكررة تقلّل تضخّم السياق، فتصبح عمليات البحث أسرع. كما يغطّي المسار الجلسة بأكملها، لذا إذا بحثت عن "المستخدم حاول الإلغاء"، يرى النموذج ما طلبه المستخدم، وما فعله الوكيل، وكيف انتهت المحادثة.
المسارات لا تزال طويلة
إزالة التكرارات تساعد، لكن مسارات الوكلاء لا تزال طويلة. ولإدراك مدى طولها، أخذنا عينة من 150 محادثة عشوائية من Open SWE، وكيل البرمجة مفتوح المصدر الذي يستخدمه فريق LangChain كل يوم. تُنفّذ كل مهمة في بيئة معزولة خاصة بها مع وصول إلى الصدفة ويمكن أن تسلّم العمل إلى وكلاء فرعيين، لذا تصبح المحادثات ضخمة.
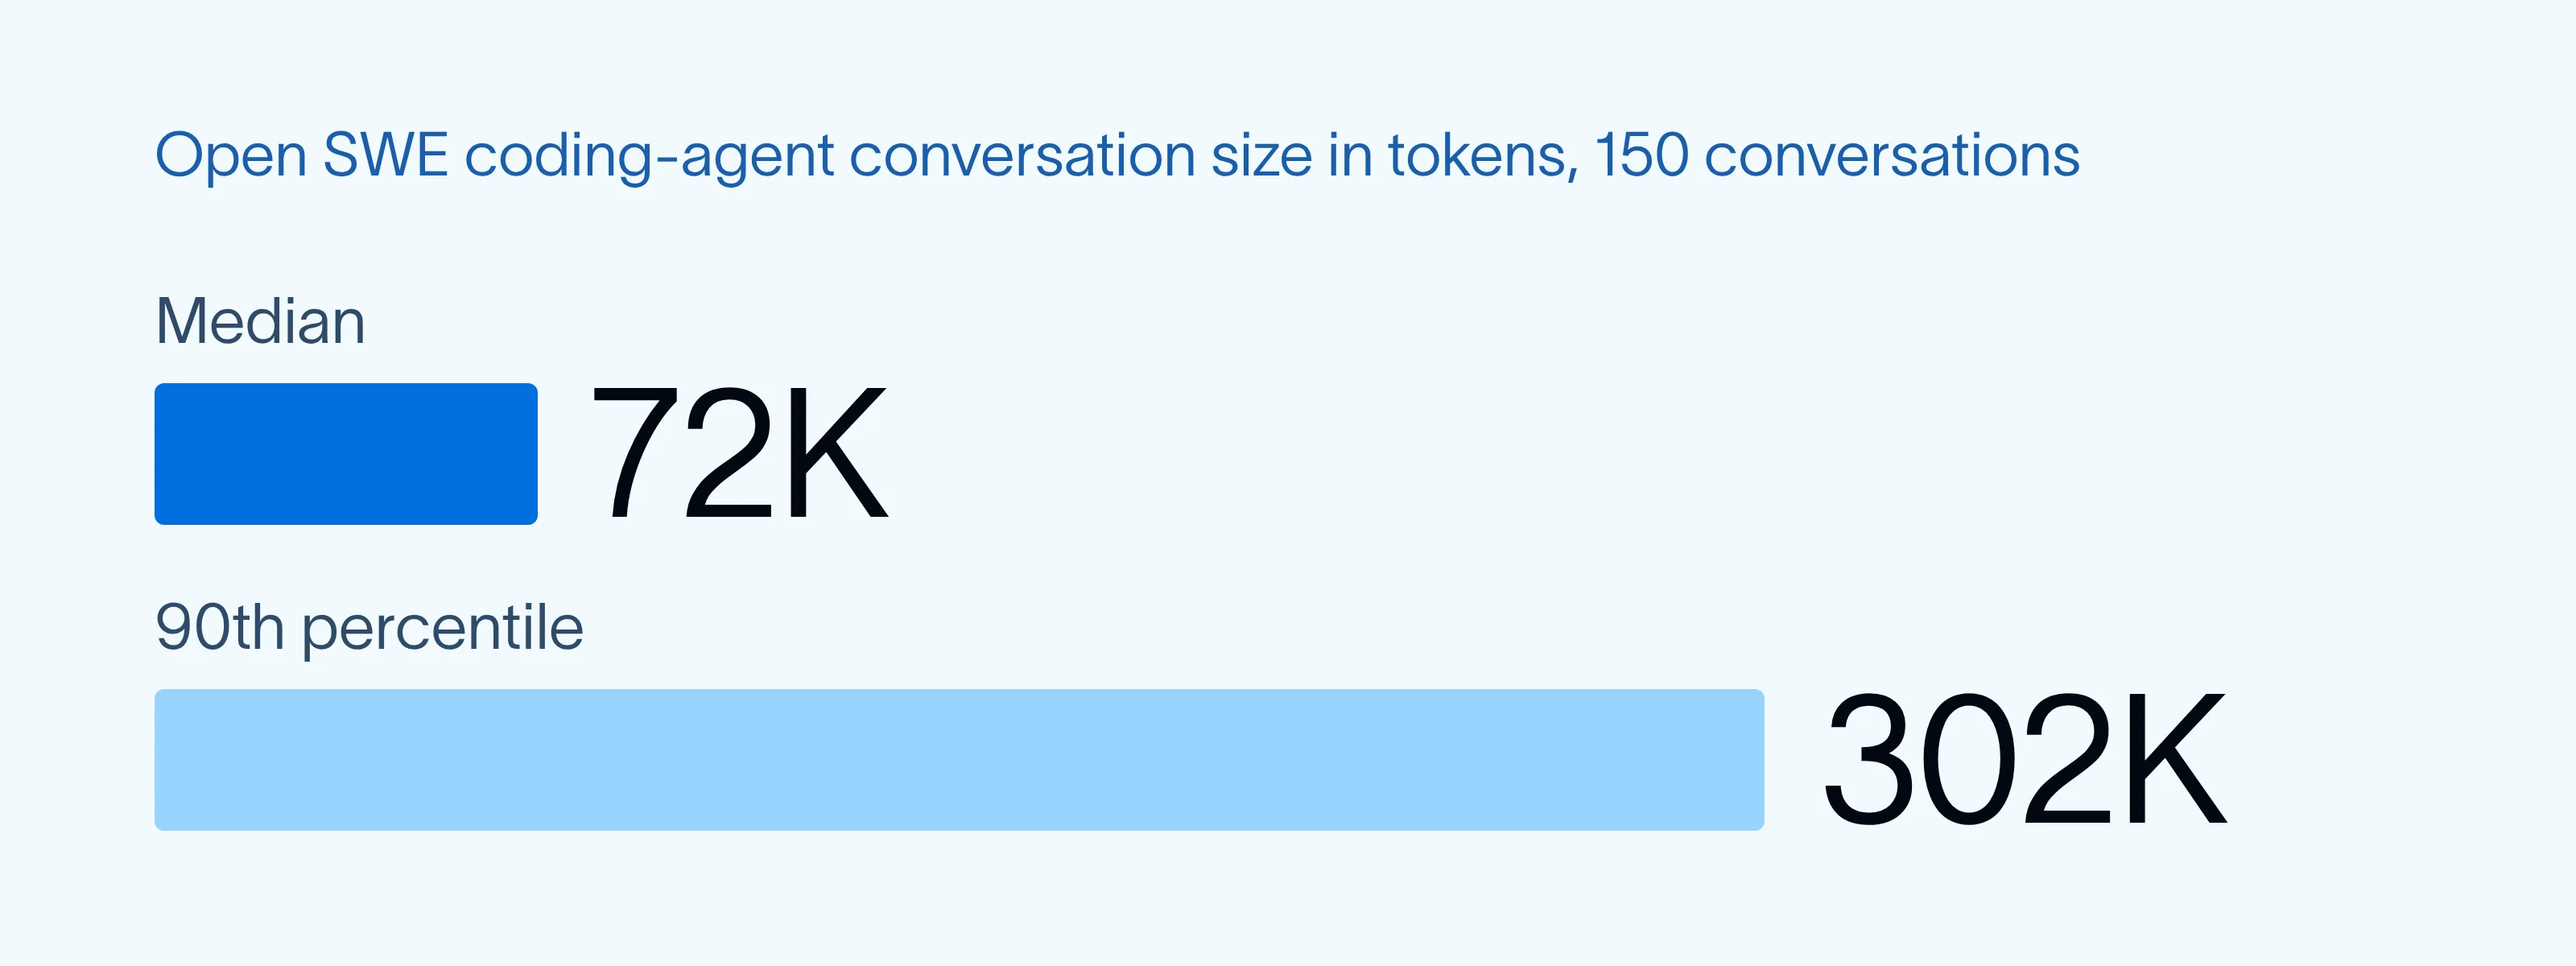
بعضها تجاوز مليون رمز (token)، حتى في عينة بهذا الحجم الصغير. والبحث عن سلوك نادر يعني قراءة العديد من المحادثات، لذا يصادف AI Search بانتظام محادثات بهذا الحجم ولا يمكنه قراءة كل رمز.
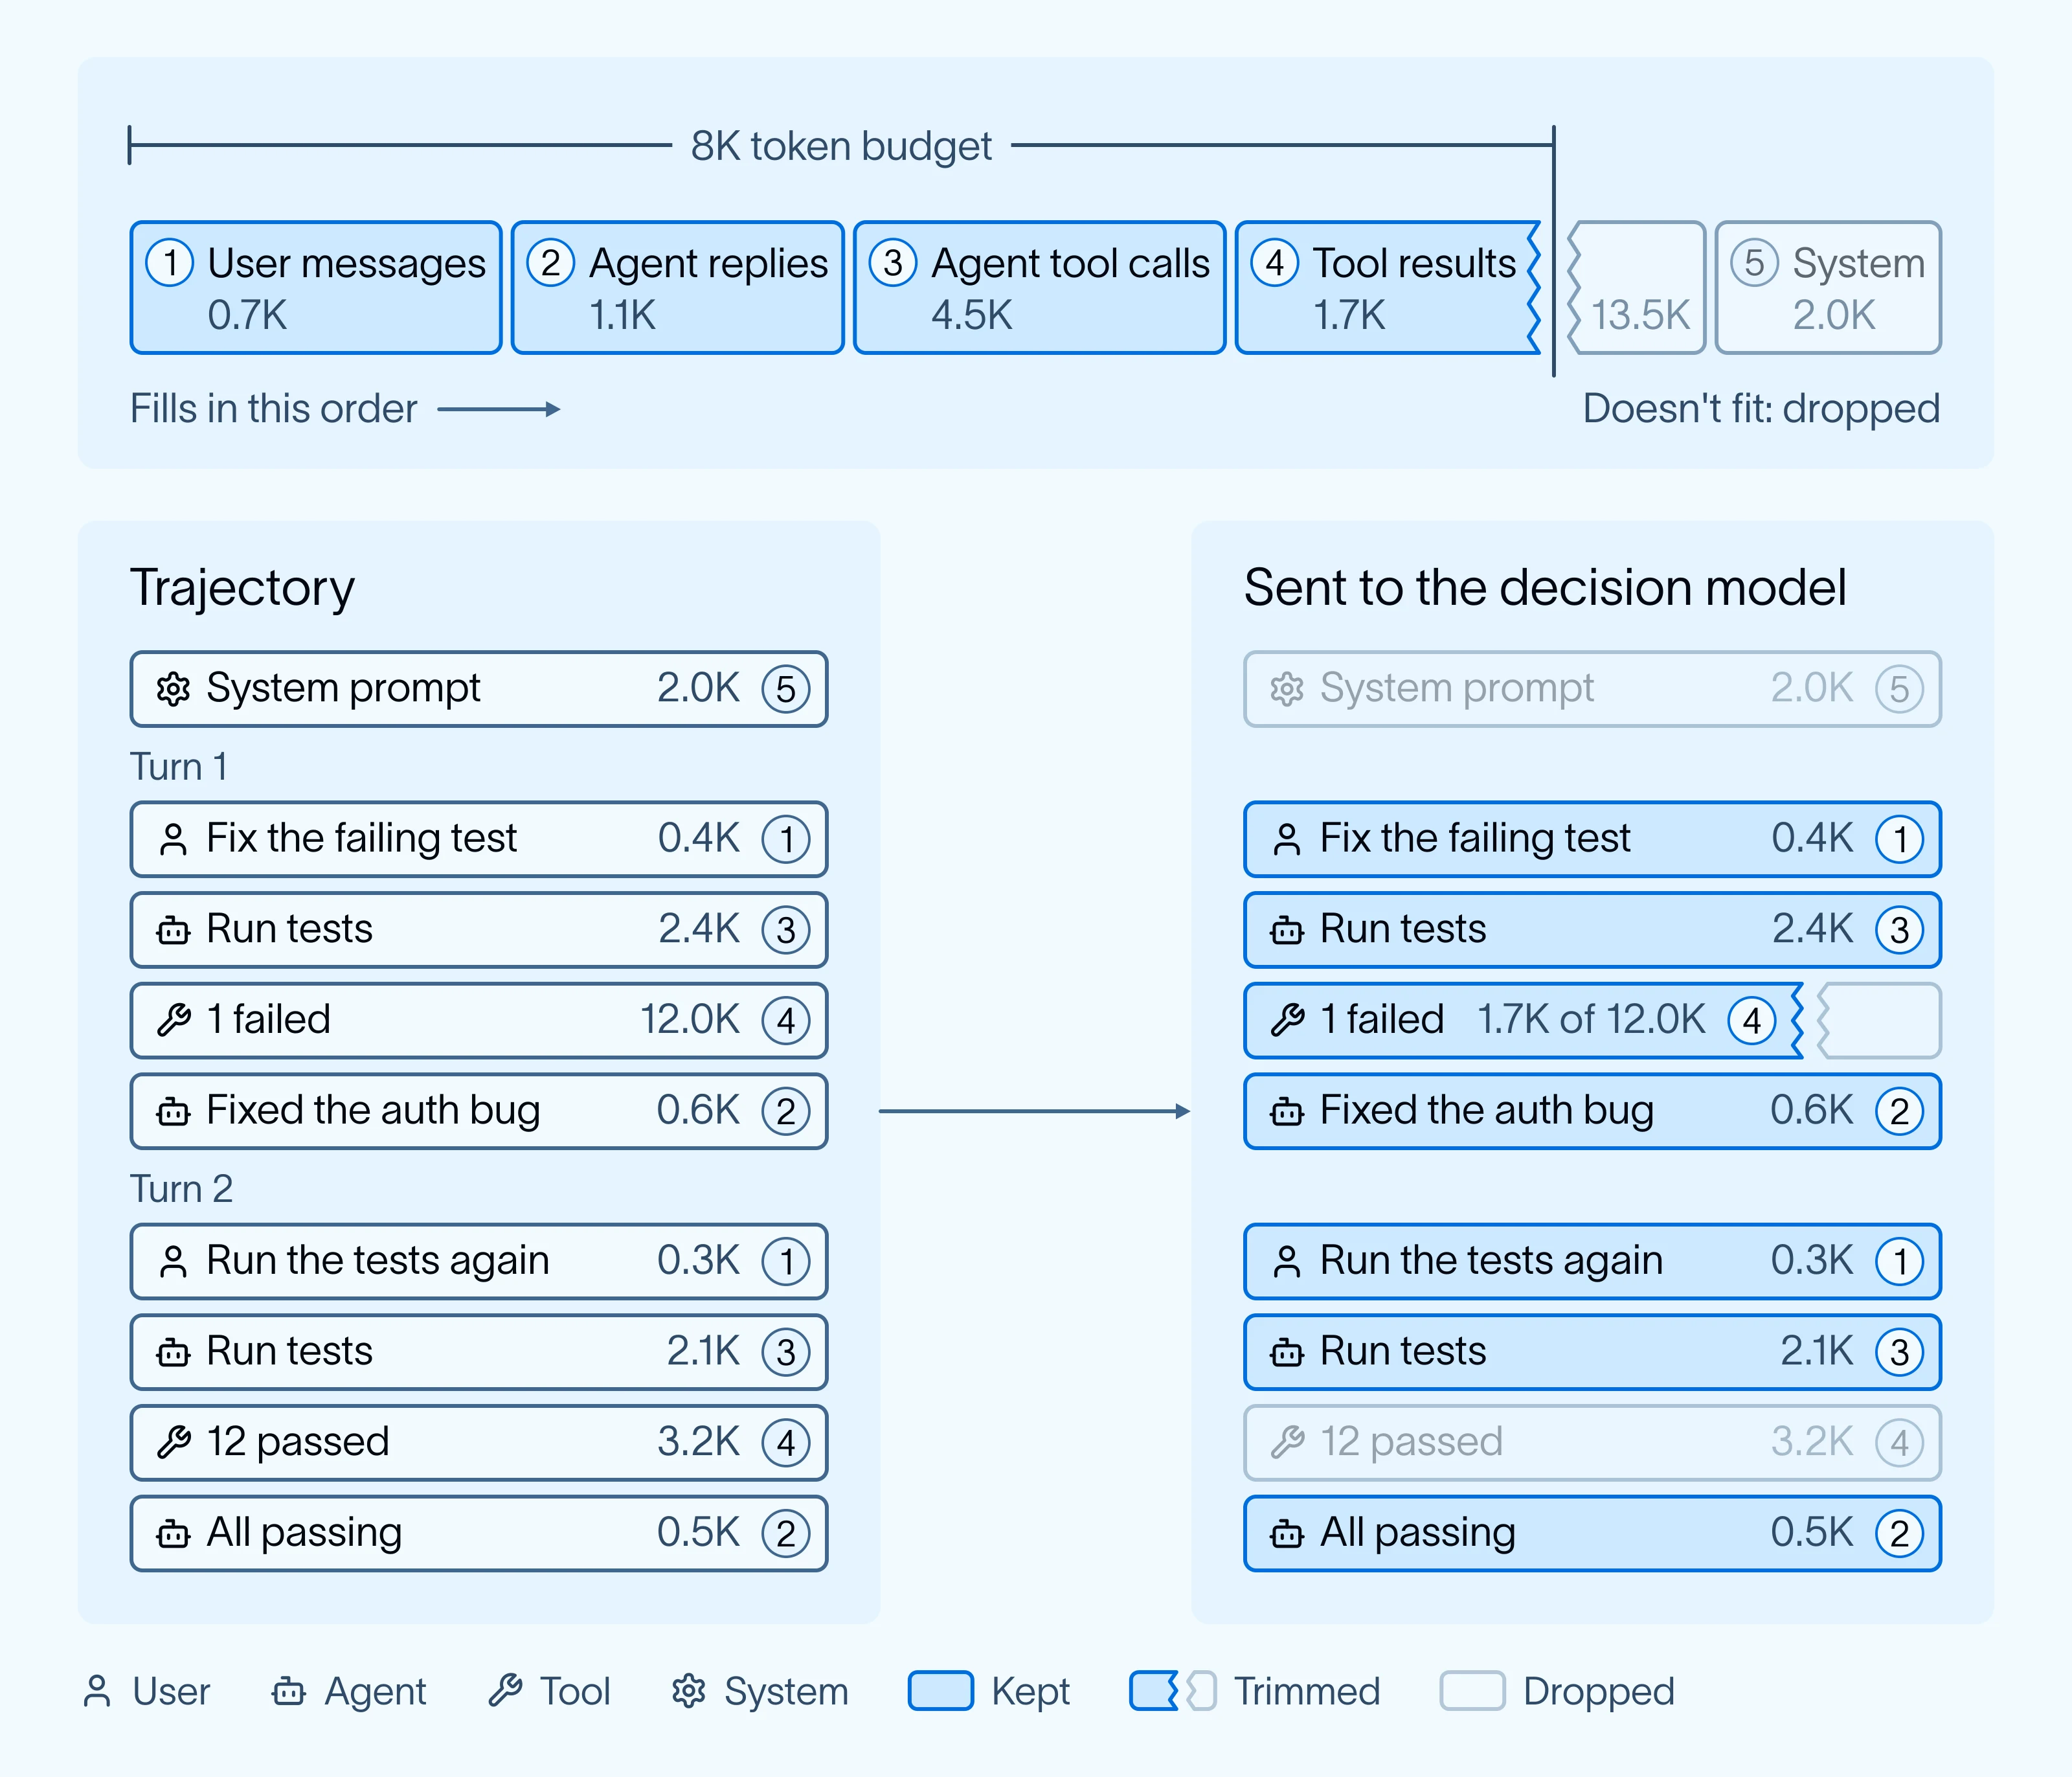
لكن معظم الأسئلة لا تحتاج كل تلك الرموز. فكثير من الأسئلة تدور حول ما طلبه المستخدم وكيف ردّ الوكيل. في المحادثة الوسيطة، جاء نحو 2K من إجمالي 72K رمزاً من رسائل المستخدم وردود الوكيل. وشكّل ناتج الأدوات نحو 85%، ومعظمه قراءات ملفات وأوامر صدفة.
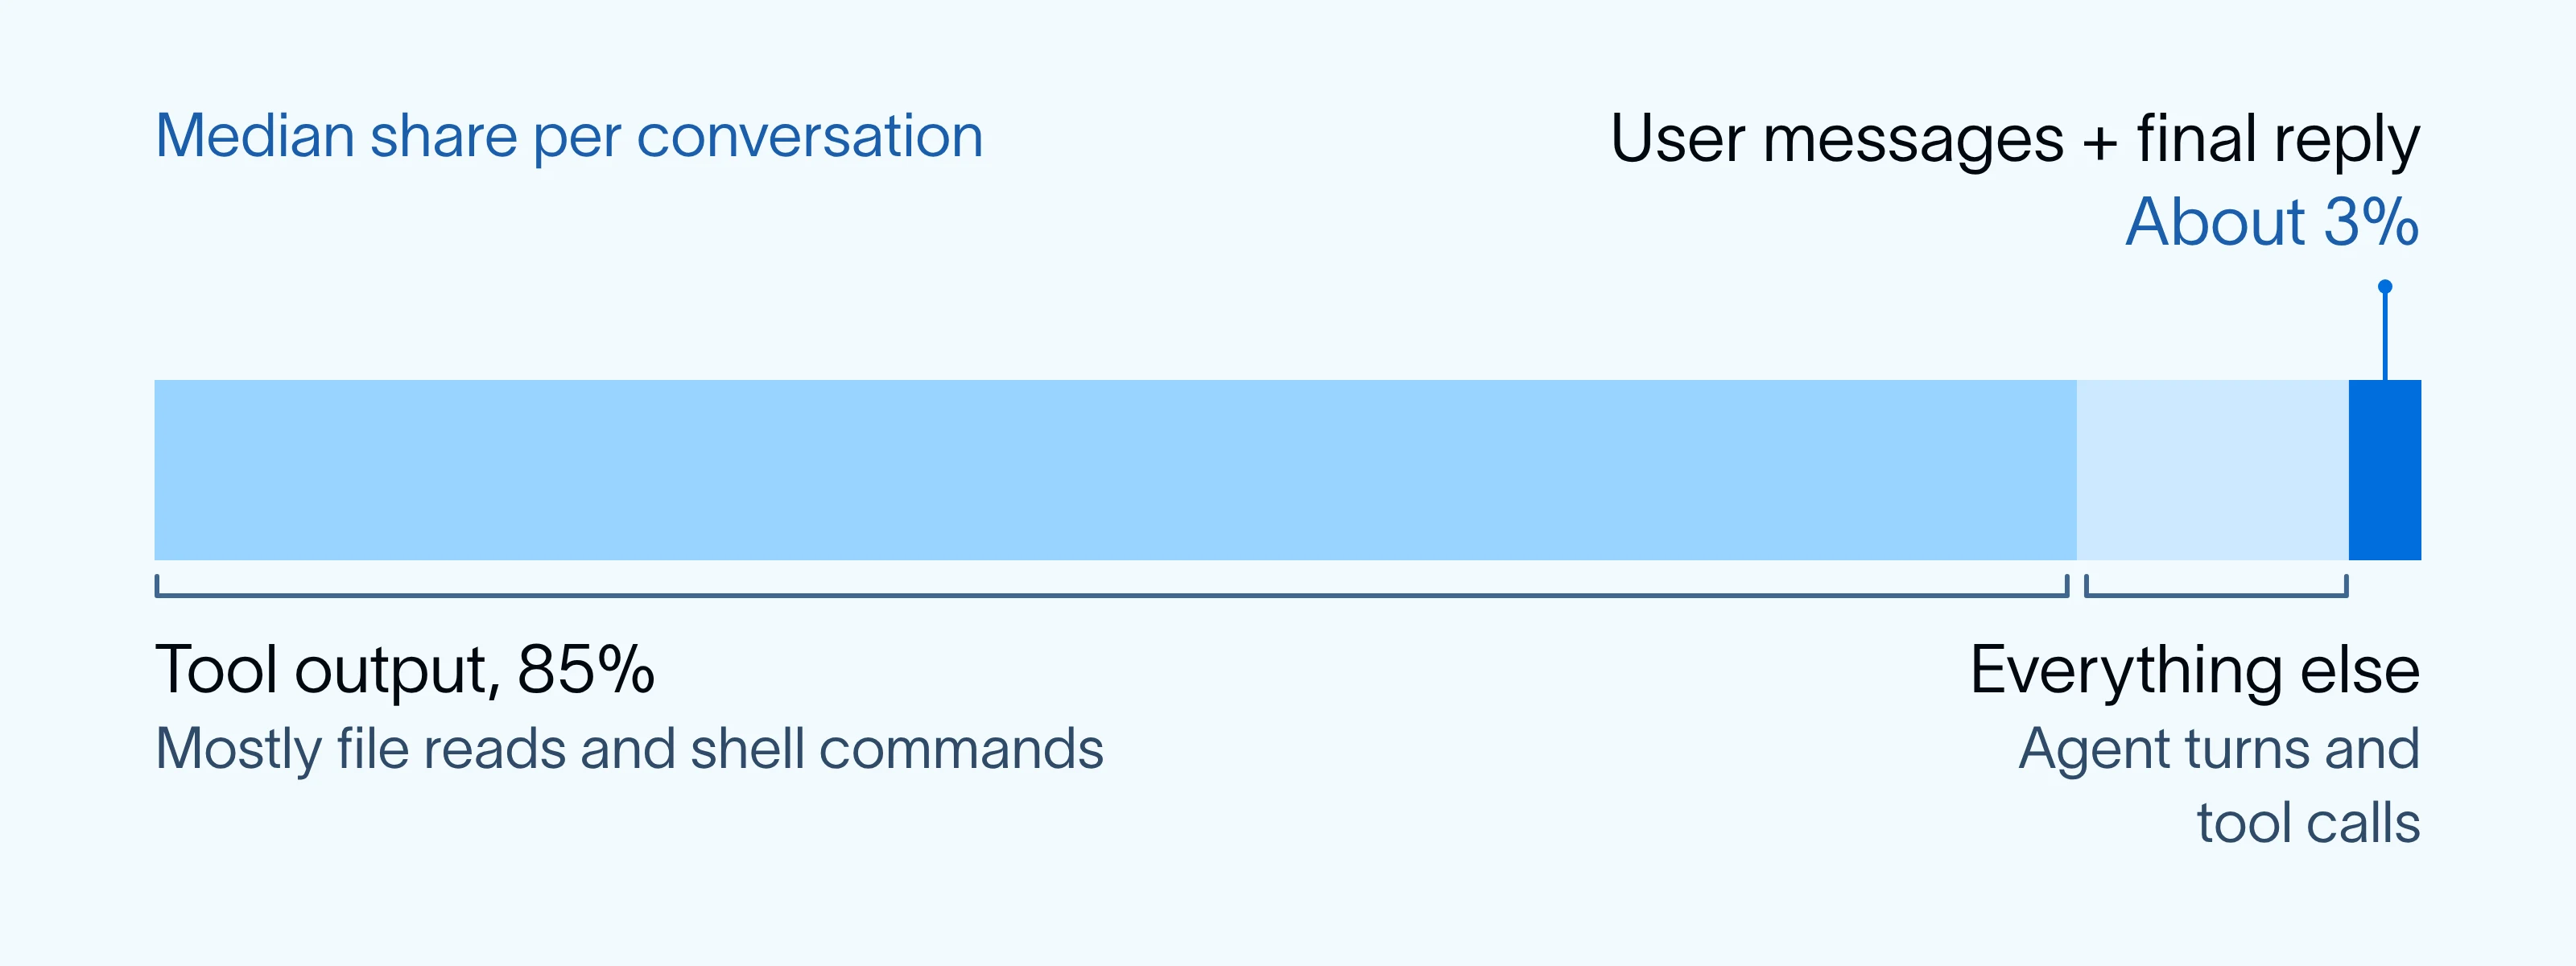
يحصل كل مسار على ميزانية رموز ثابتة تُملأ بترتيب الأولوية. تُدرج أولاً رسائل المستخدم وردود الوكيل عليها. ويذهب بقية الميزانية إلى كل ما عدا ذلك: رسائل الذكاء الاصطناعي الوسيطة (استدلال الوكيل واستدعاءاته للأدوات)، ونتائج الأدوات، ورسائل النظام. وإذا لم تتسع الرسالة التالية إلا جزئياً، تُقتطع لملء الميزانية، ويُهمَل كل ما يليها.
يجب أن تظل عمليات البحث سريعة على نطاق واسع
صُمّمت SmithDB لاستيعاب ومسح كميات كبيرة من بيانات آثار الوكلاء. عند تشغيل بحث، تُضيّق فلاترك المهيكلة المرشّحين أولاً. ثم يفحص نموذج القرار كل مسار متبقٍّ مقابل وصفك، وكل ذلك بالتوازي في الغالب. وبينما يفحص النموذج دفعة واحدة من المسارات، تكون SmithDB قد جلبت وأعدّت الدفعة التالية. وتُبَثّ المطابقات فور اكتشافها، فلا تنتظر اكتمال المسح الكامل.
ما التالي
لا نزال نتعلم أي الأسئلة يطرحها الناس أكثر. وأصعب المحادثات في التصنيف هي تلك التي تحمل فروقاً دقيقة. فالتمييز بين "المستخدم استسلم" و"المستخدم حصل على ما يريد وغادر" قد يعود إلى جولتين في مسار طويل. ونريد أن نرى ما إذا كان نموذج مضبوط على الآثار يميّز بينها بموثوقية أكبر.
تعمل ميزانية الرموز بشكل جيد عندما يُعثر على الإجابة في ما قاله المستخدم والوكيل. لكن أسئلة أخرى تحتاج أدلة مختلفة. فتجلّي وكيل يتجاهل خطأ أداة لا يظهر إلا في نتائج الأدوات. نستكشف طرقاً لاختيار السياق بناءً على السؤال، وإشارات تُظهر متى يكون النموذج غير متأكد، كي يتمكن من تمريرة ثانية بسياق أكبر.
ودودنا أيضاً تجاوز قائمة مطابقات بسيطة عبر تجميع النتائج المتشابهة أو تلخيص ما تشترك فيه.
ابدأ الآن
يتوفر AI Search في نسخة تجريبية عامة على LangSmith Cloud في مناطق GCP بالولايات المتحدة وأوروبا وآسيا والمحيط الهادئ، وبدون أي تكلفة إضافية. يمكن لمسؤولي المؤسسة تفعيله من الإعدادات، ثم يظهر في صفحة التتبع. وتتضمن وثائق AI Search التفاصيل. وأخبرنا بما تبحث عنه.