
مزيج من الخبراء (MoE) هو بنية تُنشط بشكل نادر، وتتمكن من توسيع قدرة النموذج اللغوي الكبير (LLM) مع الحفاظ على استهلاك الحساب المنخفض لكل كلمة. نظرًا لأن عملياتها تشكل جزءًا كبيرًا من الوقت الإجمالي للحساب، فإن عدم الكفاءة هنا تزيد مباشرة من تأخر الطلب وتكاليفه. لذلك، فإن تحسين عمليات MoE من خلال هندسة النواة يوفر أكبر فرصة لتحقيق تحسينات في الأداء.
الMoE المدمج هو تقنية تحسين رئيسية لمعمارية MoE. نظام MoE المدمج يدمج توجيه العلامات، وتبديل البيانات، وحسابات الشبكة المتخصصة في عملية واحدة متكاملة على GPU. وهذا يعوض عن تنفيذ تلك العمليات التوجيهية والحسابات الخبرية كعمليات متتالية منفصلة. بينما يوفر ذلك مزايا في التأخير، فإنه يجلب أيضًا تعقيدًا في تنفيذ النواة وقدرة على الإصلاح. يتطلب استخدام استغلال عالي للواجهة الرسومية (GPU) لهذا التصميم تحسينات خاصة بالأجهزة.
في هذه المقالة، نصف التحسينات المختلفة للنواة التي قمنا بتنفيذها للنماذج MoE المدمجة، ونوضح لكم كيف يمكنكم الاستفادة من هذا العمل. استخدمنا نموذج MoE نموذجي كمثال رئيسي.
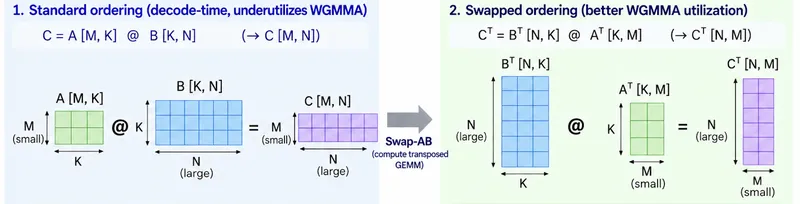
تبديل AB باستخدام استغلال WGMMA
لتحقيق أقصى استفادة من معالجة التينسور، تعتمد تصميم NVIDIA Hopper على بروتوكول تعليمات Warp Group Matrix Multiply Accumulate (WGMMA)، الذي يتم تنفيذه بشكل جماعي عبر مجموعة 128 خيوط تعاونية. هذه عدم التماثل في العملية هو خاصية على مستوى تركيبة التعليمات (ISA). في تعريف التجميع wgmma.mma_async، يقوم الأجهزة بتثبيت بُعد صف المصفوفة (M) عند مقياس ثابت قدره 64 لتحديد تخطيط الخيوط المتوازية. بينما يظل بُعد العمود (N) متغيرًا بشكل كبير. يعمل العملية A بشكل ثابت عبر هذا البُعد M الثابت (باستخدام المخازن المؤقتة أو الذاكرة المشتركة)، بينما تعمل العملية B عبر البُعد المتغير N (من خلال وصف الذاكرة المشتركة). لذلك، فإن هذه فتحات العملية غير قابلة للتبادل من الناحية الهيكلية. ونتيجة لذلك، يتم التحكم في استغلال القطعة الأجهزة الأقصى بواسطة هذه الترميزات الثابتة، مما يتطلب أن يكون البُعد M مساويًا أو أكبر من 64 لمنع توقف مسارات الحساب.
تنبع هذه التفضيلات الهيكلية من طريقة تقسيم وحدات الذاكرة بواسطة نوى تينسر هوبر. يفرض الأجهزة الهندسي حدًا دنياً ثابتاً على شكل التخطيط للميزة الأمامية لعامل التشغيل الأول، مما يجعل ارتفاع الوحدة يساوي بالضبط 64 (M=64). عندما تحتوي المصفوفة الرياضية على بُعد أمامي كبير ومتواصل في هذه الحجرة الرئيسية، يمكن لمنظمات الأجهزة الداخلية لدى هوبر أن توجه البيانات وتوزعها بشكل منظم عبر الشبكة الحاسوبية الفعلية.
تتحول هذه عدم التماثل الهيكلي إلى عائق أداء شديد خلال مرحلة فك التشفير في شبكات MoE. في طبقة MoE القياسية، يتم صياغة الجبر الخطي الذي يحكم الحسابات الخبيرة باستخدام التمثيل البارامتري التقليدي:
A[M,K] x B[K,N] —> C[M,N]
حيث يمثل (M) عدد صفوف الكلمات (أو حجم الدفعة)، و(K) يمثل البُعد الخفي للخصائص، و(N) يمثل بُعد إنتاج الخبير الموسع.
خلال مرحلة التشفير، يقوم النظام بتعريف كلمة واحدة فقط لكل تسلسل مستخدم في كل مرة. ونتيجة لذلك، يكون حجم مساحة الدفعة أو حجم صف الكلمات ضيقًا للغاية، وغالبًا ما ينخفض إلى حالة حيث (M < 64)، وأحيانًا يصل إلى صف واحد فقط (M = 1). تحت هذا التخطيط الهيكلي القياسي:
المصفوفة (أ) تتحول إلى متجه أفقي رقيق ومتجزع (مثلاً، 1 × 4096).
مصفوفة (ب) (أوزان الخبراء الأساسيين) تظل في كتلة عمودية كبيرة وكثيفة (على سبيل المثال، 4096 × 8192).
بسبب قلة عدد الصفوف (M)، فإن المصفوفة (A) غير قادرة فعليًا من حيث الطبيعة على ملء مساحة الترتيب الثابت الذي يحتوي على 64 صفًا للقيمة A. عند تنفيذ التعليمات WGMMA على هذا الترتيب، يترك ذلك جزءًا كبيرًا من قدرة نواة تنسنت الفيزيائية فارغًا تمامًا. يقضي السيليكون دورات الساعة في معالجة الفتحات المكانية الفارغة، مما يؤدي إلى استغلال ضعيف للمعدات.
في طبقة LLM الكثيفة القياسية، هيكليات الأوزان ثابتة وموحدة ومرتبة بشكل متصل تمامًا. أما في طبقة MoE، فإن العملية تتوزع على مجموعة من الشبكات الفرعية المستقلة (الخبراء). وهذا يخلق مشاكل في الذاكرة وتخطيط البيانات، مما يجعلها حساسة للغاية للقيود الخاصة بوحده GPU Hopper. في الطبقة الكثيفة القياسية، تُضرب متجه الكلمة بمضاعفة مصفوفة الأوزان لطبقة واحدة. البُعد الخارجي للإخراج (N) هو الحجم الخفي للموديل (على سبيل المثال، 4096).
في نواة MoE المدمجة، لا تقوم GPU بضرب واحد من الخبراء فقط، بل تجمع وتنفّذ الحسابات لجميع الخبراء النشطين في نفس الوقت لتجنب تشغيل نواة منفصلة لكل خبير. بالنسبة للطبقة الكثيفة العادية، يكون N هو الحجم المخفي (4,096). أما بالنسبة للطبقة MoE المدمجة، فإن N هو عدد الخبراء المختارين مضروبًا في الحجم الوسيط للخبراء. عند تشغيل النموذج بإجراءة topk=8، يتضاعف البعد N الفعلي داخل النواة المدمجة إلى عشرات أو مئات الآلاف من المعلمات. وبما أن البعد N كبير جدًا مقارنة بحجم كتلة التشفير الصغيرة (M=1)، فإن عدم تماثل الترتيب يصبح شديد. يقوم تبديل المصفوفات بتحويل هذا البعد الكبير للMoE المدمج إلى الحجز الرئيسي، مما يفتح إمكانية تحميل الأجهزة مسبقًا على مستوى لا يمكن لطبقات الكثيفة العادية مواكبته.
لحل مشكلة عدم تطابق الأجهزة دون تغيير النزاهة الرياضية الأساسية للنموذج، نستغل الخاصية الجبرية لترتيب المصفوفة:
BT[N,K] x AT[K,M] —> CT[N,M]
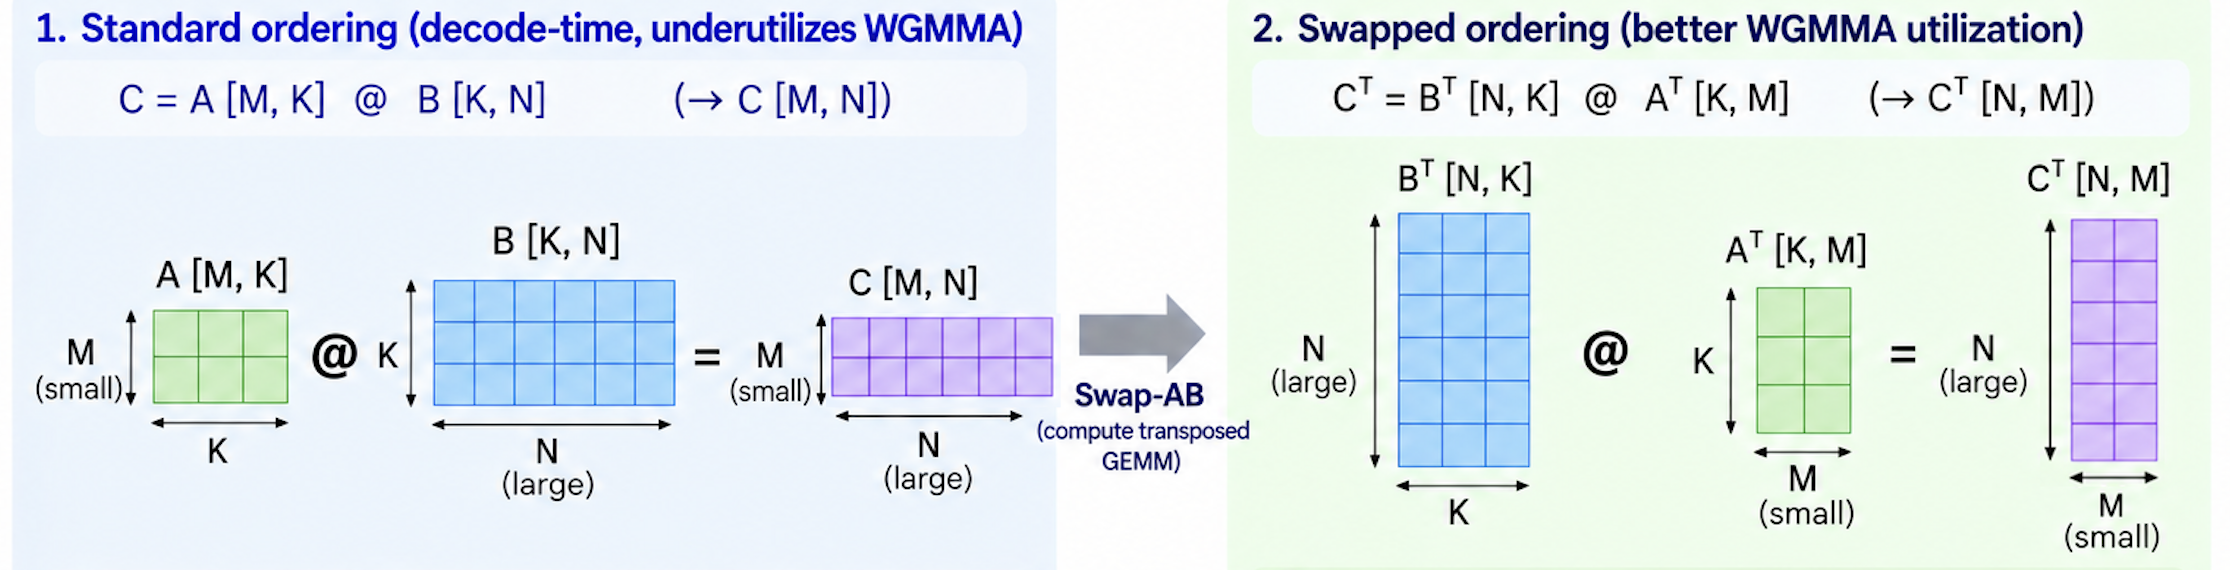
الشكل 1: استبدال Swap-AB باستخدام WGMMA
من خلال تغيير عملية ضرب المصفوفة برمجيًا قبل وصولها إلى طبقة تجميع PTX، تم إعادة ترتيب البرنامج بحيث يتوافق تمامًا مع الطبيعة الفيزيائية لشريحة Hopper السيلكوريوم. يؤدي هذا التحريك إلى فوائت بنيوية فورية على GPU: أولاً، يتم شغل الترتيب الفيزيائي بالكامل؛ حيث يتم تحويل البُعد الكبير (N = 8192) إلى موقع العمل الأول (BT)، وبما أن (N) كبير، فإنه يملأ بسهولة العتبة الضرورية للأجهزة (64) صفوف. ثم تعمل نوى Tensor بكثافة محلية قصوى دون أي دوران لدورات التنفيذ. ثانيًا، يتم تفعيل عملية الاستدعاء غير المتزامنة؛ حيث يمكن لخوارزميات النسخ المتخصصة في Hopper أن تستدعي عناوين الذاكرة بشكل غير متزامن من الذاكرة المشتركة مباشرة إلى السجلات قبل بدء تنفيذ الحسابات. وضع الكتل الضخمة المستمرة (BT) في المكان الأمامي يسمح لهذه الخوارزميات بتتبع تخطيط البيانات بشكل سلس، ويحافظ على كثافة التنفيذ بالكامل دون تدخل CPU. وقد أدى ذلك إلى تحسين في معدل الإخراج من 2-4٪ على نماذج MoE الكبيرة على H200. لقد قمنا بنقل هذا التحسين إلى vLLM، وهو متاح في الإصدار 0.24.0 أو الأحدث.
توجيه الخادم لتركيبات تنسور FP8
بالإضافة إلى التفاصيل الداخلية للنواة، فإن اختيار البيئة الخلفية التي تقوم بتنفيذ حساب MoE لها تأثير كبير على الأداء. يقوم أوكوري vLLM بتوجيه أنماط التجريد المختلفة إلى Triton، FlashInfer+CUTLASS، أو بيئات خلفية أخرى. كشف التحليل أن لبعض النماذج المُجريدة باستخدام FP8 والمُجريدة بالتجريد، على منصة Hopper، فإن بيئة Triton تتفوق بشكل مستمر على مسار FLASHINFER_CUTLASS الافتراضي.
يُظهر الطرفية Triton أداءً أفضل من CUTLASS في أعمال العملاء ذات الضغط المنخفض MoE، وذلك بشكل أساسي لأنها تحل التكوينات الرياضية للمصفوفات الصارمة على مستوى الإطار باستخدام تركيبات التسلسل على مستوى العمليات. تعتمد CUTLASS على هياكل القوالب القياسية للغة C++ التي تعتبر عملية تكبير التنسورات FP8 وضرب المصفوفات وتجميع الخبراء عمليات رياضية منفصلة. بينما تجمع الطرفية Triton كامل هذا المسار في مرور واحد على الأجهزة. يتم استخراج البيانات من الذاكرة عالية السعة العالمية مرة واحدة فقط، ويتم معالجتها بالكامل داخل سجلات SRAM المحلية السريعة جدًا للواجهة GPU وملفات تنفيذ الحسابات. ثم يتم إعادة تدفقها إلى الوجهة النهائية للمصفوفة. هذا يلغي الدورانات البطيئة لقراءة/كتابة الذاكرة العرضية العالمية التي تعيق CUTLASS عندما يضطر إلى تكرار خطوات تكبير المصفوفات الوسيطة باستمرار.
أيضًا، يتم تنسيق هذا الاندماج على مستوى السجل مع تخطيطات تنظيمية ديناميكية تتمحور حول تقسيم الرموز المتغيرة، مما يحل مشكلة هيكلية خطيرة في قوالب التجميع التقليدية. تم تحسين CUTLASS بشكل أصيل لاستخدامها مع أبعاد مصفوفة كثيفة وكبيرة وقابلة للتنبؤ. عندما يواجه حالة الخليط السائل الناعم للغاية، ذو الشدة النادرة (M < 64 أو M = 1)، التي تُعتبر طابع مرحلة التشفير الفعلي، تصبح هياكل تقسيم الكتل وتوزيع الخيوط الافتراضية للمعالج غير فعالة للغاية. والنتيجة هي استخدام غير كافٍ للخلايا أو أعباء إضافية باهظة على الذاكرة. بالمقابل، يتميز لوجو التحت Triton MoE في توزيع هذه المصفوفات الصغيرة المتفرقة بشكل ديناميكي عبر الحدود الفيزيائية لأوزان الخبراء النشطين. يحافظ هذا على تدفقات الاستدعاء الداخلية للمعدات والمسارات للنواة تينسورت مليئة تمامًا، حتى عند معالجة أعمال العمل الضعيفة للغاية بأحجام دفعات منخفضة جدًا.
تحديث سياسة التوجيه هو تغيير تشكيلة خالص دون تعديل أي كود للنواة. ومع ذلك، أدى ذلك إلى تحسين بنسبة 10 بالمئة في معدل الإنتاجية من البداية إلى النهاية لنماذج MoE المكثفة المقاسة ب FP8 على H200. هذا التحسين متاح في حاوية AWS Large Model Inference (LMI) v28.
إزالة إعادة تجميع JIT لترايتون
أحد أشد أمراض الأداء تأثيرًا في استدلال الرسومات الحاسوبية (GPU) هو أيضًا أقلها وضوحًا: تحميل المكدسات من جديد دون حاجة. يُخصص إعداد Triton، إطار المحرر الذي يقوم على العديد من المكدسات المخصصة لـ vLLM، المتغيرات الأعدادية بشكل افتراضي. في كل مرة يتم استدعاء المكدس مع قيمة غير مسبوقة لمعامل معين، يُطلق Triton تجميعًا جديدًا فورًا (JIT). في تقديم أعمال العمل التي تتغير فيها أطوال التسلسل وحجم الدفعات بشكل مستمر، يؤدي ذلك إلى تدفق مستمر من أعباء التجميع مما يزيد من التأخير، خاصةً زمن الوصول إلى الرمز الأول (TTFT).
في خدمة نموذج MoE، يتم إعادة تجميع النواة _fused_inv_rope_fp8_quant_per_head (التي تتحمل دور تضمين موضع الدوران المترابط وتقنين FP8) كل مرة عند قيامك بتغيير قيمة num_tokens الجديدة. إضافة التعليقات do_not_specialize إلى معاملات الطول المتغير أدت إلى إزالة هذه الإعادة التجميع تمامًا، مما حسّن TTFT بنسبة 9 بالمائة على نظام H200 بتوازي التنسوريات ذات 8 طرق (PR #42849).
في مجموعة GPU متعددة، يجب على جميع الـ 8 GPU تنفيذ خيوط الكيرلينات الخاصة بها بشكل متزامن على مستوى الثانية الصغرى. إذا اضطر أحد GPU إلى التوقف لإعادة تحميل كيرلينه المحلي _fused_inv_rope_fp8_quant_per_head لأن عدد دفعة العلامات المحلية قد تغير، فإن الـ 7 GPU الأخرى ستظل دون عمل وترقب ذلك. من خلال إزالة عمليات إعادة التحميل على المجموعة بأكملها، تم تخفيف تكلفة التنسيق بين GPU المتعددة، مما أدى إلى تحسين سرعة بنسبة 9 بالمائة في زمن الاستجابة الأولي للمستخدم. المبدأ هنا هو اعتبار المترجم كسطح لتحسينات من الدرجة الأولى. فهم كيف يعمل Triton في تحسين الدلاليات، وتعرفة الوقت الذي تكون فيه المعاملات ميتة أو المتغيرات غير مفعلة، يسمح بتحسين زمن الاستجابة مع تغيير ضئيل في الكود.
لقد قمنا بنقل هذا التحسين إلى vLLM، وهو متاح في الإصدار 0.22.0 أو الأحدث.
الخلاصة
من خلال تعاوننا مع مجتمع vLLM، قمنا بتنفيذ وتوزيع العديد من تحسينات النواة للنماذج MoE المركبة. نطبق هذه التحسينات في حاوية التعلم العميق LMI على Amazon SageMaker AI. معًا، أدت هذه التحسينات إلى زيادة في النفاذية بنسبة تصل إلى 10 بالمئة وسرعة TTFT بنسبة 9 بالمئة. لبدء استضافة النماذج المخصصة، يرجى الرجوع إلى وثائق استضافة Amazon SageMaker AI.