
أصبح Grok 4.7 من SpaceXAI متاحًا الآن على Amazon Bedrock، التي توفر خيارًا من النماذج الأساسية (FMs) من مزودين متعددين. ووفقًا لشركة SpaceXAI، فقد دُرّب Grok 4.7 للعمل لفترة أطول على المهام الأكثر صعوبة ويعرف متى يتحقق من عمله. وهذا أمر بالغ الأهمية للوكلاء، الذين ينتقلون بالمهمة عبر خطوات عديدة ويجب أن يتحققوا مما يجدونه على الطريق.
الوكيل الذي يعمل بهذه الطريقة يتعين عليه أن يفعل أكثر من مجرد البحث عن المعلومات. فعليه أن يصوغ إجابة مرشحة، ويتحقق منها مقابل ما تعلمه، ويحسّنها حتى تتوافق. يوفر Grok 4.7 إعدادًا لجهد الاستدلال يتحكم في مقدار التأمل الذي يحدث قبل كل استجابة، وبالنسبة لأحمال عمل الوكلاء فإن السؤال العملي هو أي مستوى يجب تشغيله.
في هذه المقالة، نبني وكيلًا يستدعي الأدوات على Grok 4.7 ونقيّمه على ثلاث مهام تتطلب البحث بدلًا من الاطلاع المباشر. المهام هي: تشخيص انقطاع خدمة في خدمتين من تنبيهاته، وجدولة الصيانة في ظل قيود متداخلة، واختيار المجموعة المثلى من عمليات الترحيل في حدود ميزانية. لكل مهمة إجابة صحيحة واحدة بالضبط، تم التحقق منها بالقوة الغاشمة. شغّلنا المهام الثلاث عند كل مستوى من مستويات جهد الاستدلال، ست مرات لكل منها، بإجمالي 72 تشغيلًا للوكيل.
أجاب الوكيل إجابة صحيحة في 67 من أصل 72 تشغيلًا. عند xhigh أجاب إجابة صحيحة في جميع التشغيلات الـ 18، وعند low أجاب إجابة صحيحة في 15 من 18 مع استخدام نحو ثُمن رموز المخرجات فقط. وهذا يمنحك مقايضة واضحة يمكنك ضبطها لكل طلب، ونوضح كيفية قياسها على مهامك الخاصة وكيفية مراقبتها في بيئة الإنتاج.
نستعرض أعداد الرموز بدلًا من العملة في جميع أنحاء المقالة. فأسعار الرموز تتغير، والأعداد هي ما تُشتق منه تكاليفك الخاصة، وبالتالي يبقى القياس المعبَّر عنه بالرموز صالحًا.
ما ت.reportه SpaceXAI عن Grok 4.7
وفقًا لشركة SpaceXAI، يستخدم Grok 4.7 نموذجًا أساسيًا أكبر من Grok 4.6 وقد دُرّب بتشغيل تعلم معزز أطول على مزيج أصعب من المهام. هذا المزيج مرجّح نحو المشكلات التي تستغرق ساعات عديدة لإكمالها. وتفيد SpaceXAI بأن النموذج أفضل في التحقق من عمله الذاتي وفي إدارة السياق الأطول.
نتائج المعايير المرجعية المنشورة من SpaceXAI تتبع هذا التركيز. وتظهر أكبر المكاسب المُبلّغ عنها مقارنة بـ Grok 4.6 في الفئات التي تقيس العمل المستمر بدلًا من الإجابات ذات الدورة الواحدة.
| المعيار المرجعي | الفئة | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | عمل طرفية متعدد الساعات | 20.3% | 37.6% |
| EEBench | الهندسة الكهربائية | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | العمل القانوني | 15.8% | 19.6% |
| CursorBench 4.0 | برمجة طويلة المدة | 40.4% | 46.3% |
| HealthBench Professional | الاستدلال الإكلينيكي | 48.5% | 56.7% |
| AA Briefcase v1.1 | عمل مكتبي متعدد الساعات | 1,546 | 1,657 |
المصدر: SpaceXAI، تقديم Grok 4.7 (https://x.ai/news/grok-4-7). الدرجات كما نشرتها SpaceXAI وقت إطلاق النموذج.
تُظهر المعايير المرجعية كيف يؤدي النموذج عبر مهام قياسية. أما بالنسبة لأعباء العمل الخاصة بك، فالخطوة التالية المفيدة هي القياس على مهام تشبه مهامك، وهو ما يشرحه بقية هذا المقال.
يسرد SpaceXAI نافذة سياق تبلغ 500K رمز لـ Grok 4.7، مع إدخال نصي وصور وإخراج نصي. وعلى Amazon Bedrock، يدعم النموذج جهود استدلال قابلة للتهيئة، واستدعاء الأدوات، والمخرجات المنظمة.
كيف يمكنك الوصول إلى Grok 4.7 على Amazon Bedrock
يعمل Grok 4.7 على bedrock-runtime نقطة النهاية ويتم الوصول إليها عبر الاستدلال عبر المناطق الملف الشخصي. يتوفر ملفان شخصيان:
| ملف الاستدلال | التوجيه | يُستخدم عند |
| us.xai.grok-4.7 | ضمن الجغرافيا الأمريكية | لديك متطلبات إقامة البيانات في الولايات المتحدة |
| global.xai.grok-4.7 | مناطق AWS التجارية | ليس لديك قيود إقامة وتريد أوسع سعة |
تمكّن الاستدلال عبر المناطق من توجيه الطلبات عبر عدة مناطق من AWS، مما يمنحك معدل نقل أعلى دون الحاجة إلى إدارة السعة منطقةً بمنطقة. تحدد الطلبات أحد ملفات الاستدلال بدلاً من معرّف نموذج مجرد.
يدعم النموذج واجهتي برمجة التطبيقات Chat Completions وResponses المتوافقتين مع OpenAI، بالإضافة إلى واجهة Amazon Bedrock Converse API. في Converse، يُعاد الاستدلال ك reasoningContent كتلة إلى جانب text كتلة. في inferenceConfig، مجموعة maxTokens فقط، وضع المعاملات الخاصة بكل نموذج، مثل مستوى جهد الاستدلال، في additionalModelRequestFields.
للاطلاع على القائمة الحالية للمناطق المدعومة ومستويات الخدمة وأسعار الرموز، راجع بطاقة نموذج Grok 4.7 في دليل مستخدم Amazon Bedrock وصفحة تسعير Amazon Bedrock (https://aws.amazon.com/bedrock/pricing/).
المتطلبات الأساسية
- حساب AWS لديه صلاحية الوصول إلى Amazon Bedrock، مع تفعيل الوصول إلى نموذج Grok 4.7.
- بايثون 3.9 أو أحدث، مع
openai,boto3وaws-bedrock-token-generatorتم تثبيته. - بيانات اعتماد AWS المُهيأة في بيئتك.
يحتاج حسابك أو هويتك في AWS Identity and Access Management (IAM) إلى bedrock:InvokeModel على كل من ملف الاستدلال (inference profile) والمشروع الافتراضي لحسابك:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7أوglobal.ما يعادله.arn:aws:bedrock:{region}:{account-id}:project/default.
أدرج كلا الموردين في بيان السياسة. إذن المشروع الافتراضي مطلوب بالإضافة إلى ملف الاستدلال.
الاتصال بالنموذج
للاستخدام في بيئة الإنتاج، نوصي بتوليد رمز حامل (bearer token) قصير الأجل من بيانات اعتماد AWS الخاصة بك الحالية، حتى يبقى التوثيق مرتبطًا بهوية IAM الخاصة بك ولا يتم تخزين أي سر طويل الأجل:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
تُحتسب رموز الاستدلال (reasoning tokens) ضمن رموز المخرجات وتُستهلك max_completion_tokens قبل إنتاج نص الإجابة، لذا اجعل الحد بحجم يترك مجالًا للاثنين معًا. إذا تم بلوغ الحد أثناء الاستدلال، تعود الاستجابة دون نص إجابة، لذا تحقق من وجود محتوى فارغ في كود الوكيل (agent) وارفع الحد إذا لاحظت ذلك. استخدمت تجاربنا حدًا قدره 32,768 رمزًا، وهو ما ترك هامشًا كافيًا عند كل مستوى جهد.
يدعم Grok 4.7 أربعة مستويات من الجهد: low, medium, high، و xhigh. يمكن أن تتغير مستويات الجهد بين إصدارات النموذج، لذا من المفيد التأكد منها من الخدمة نفسها بدلاً من تثبيت قائمة ثابتة في الكود:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
مهام تصميم تتطلب الاستدلال
تختبر العديد من تقييمات الوكلاء الدقة: قراءة سجل، وفلترته، وجمعه. هذه المهام مفيدة، لكن لرؤية ما يضيفه مستوى الجهد في الاستدلال، لا بد من مهمة تتطلب البحث: لا يمكن قراءة الإجابة مباشرة من البيانات، بل يجب اقتراحها ثم التحقق منها.
بنينا بيئة اصطناعية من 20 خدمة، مكشوفة من خلال سبع أدوات، وثلاث مهام مبنية فوقها. لكل مهمة إجابة واحدة صحيحة تماماً، وكل منها مصممة بحيث لا يكفي أسلوب سريع (heuristic) للعثور على الإجابة.
| المهمة | ما يجب على الوكيل فعله | ما يجعلها مهمة استدلال |
| two_fault_diagnosis | تعطلت خدمتان بصمت عند الساعة 03:00 وأصدرت 12 خدمة أخرى تنبيهات. حدد الخدمتين اللتين تعطلتا | الخدمات الفاشلة لا تُطلق تنبيهات، لذا فإن الإجابة ليست بين الخدمات المُصدِرة للتنبيهات. هناك 190 زوجًا ممكنًا، وواحد فقط يفسر التنبيهات المرصودة تمامًا |
| maintenance_schedule | جدولة تحديث ثماني خدمات على مدى أربع ليالٍ، خدمتان في كل ليلة، في ظل عشرة قيود وقاعدة تنص على أن خدمتين من الفريق نفسه لا تشتركان في ليلة أبدًا | هناك 2,520 جدولًا ممكنًا، وواحد صالح فقط. تعتمد قاعدة الفريق على بيانات يجب على الوكيل البحث عنها |
| migration_budget | اختيار المرشحين للترحيل الذين يعظّمون خفض المخاطر ضمن ميزانية، بما في ذلك المتطلبات المسبقة الانتقالية | هناك 53 مجموعة قابلة للتطبيق، وواحدة أمثل. اختيار أفضل نسبة أولاً يعطي مجموعة تنقص تسع نقاط عن الحل الأمثل |
هناك أربع ممارسات تحافظ على موثوقية قياس من هذا النوع، وهي تنطبق على معظم تقييمات الوكلاء.
اذكر كل قاعدة يعتمد عليها المُقيِّم. إذا ترك الطلب حالة حدّية مفتوحة، فقد تُقيَّم إجابة معقولة على أنها خاطئة، وينتهي التقييم إلى قياس المواصفة بدلاً من النموذج. على سبيل المثال، ينص طلب التشخيص صراحةً على أن الخدمة الفاشلة لا تُطلق تنبيهًا من تلقاء نفسها.
أثبت أن لكل مهمة إجابة واحدة. كل بيئة صغيرة بما يكفي للسردها، لذا تحققنا من كل إجابة مرشحة قبل تشغيل أي شيء. بالنسبة للجدولة، هذا بضعة أسطر:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
قيّم سطرًا نهائيًا مطلوبًا، لا الرد الكامل. يطلب كل وسيط من الوكيل أن ينتهي بسطر مثل FINAL: auth, checkout. يقرأ المُقيِّم ذلك السطر فقط، لذا فإن الرد الذي يناقش مرشحين آخرين أثناء شرح استدلاله يُقيَّم على استنتاجه:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
تتبَّع التنسيق بشكل منفصل عن الصحة. السطر النهائي المفقود إشارة مختلفة عن السطر غير الصحيح. في تجاربنا، تضمنت جميع الردود الـ 72 سطرًا نهائيًا قابلًا للتقييم.
قيِّد معاملات الأدوات بـ enum حيث تكون القيم الصالحة معروفة، بحيث تستهدف كل استدعاء أداة موردًا حقيقيًا:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
موجه النظام قصير عمدًا، ويطلب من الوكيل التحقق من إجابته قبل تقديمها:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
حلقة الوكيل هي حلقة استدعاء أدوات قياسية: استدعِ النموذج مع reasoning_effort مضبوطًا، نفّذ كل استدعاء أداة مُعادًا، ألحِق النتيجة مفتاحًا بـ tool_call_id، وكرر حتى يتوقف النموذج عن طلب الأدوات. تتبع prompt_tokens و completion_tokens عبر الحلقة يعطي أعداد الرموز المذكورة في القسم التالي.
النتائج
ست تجارب لكل مهمة عند كل مستوى جهد، 72 تجربة في المجموع. أجاب الوكيل بشكل صحيح في 67.
| المهمة | منخفض | متوسط | مرتفع | xhigh |
| تشخيص عطل اثنين | 5 من 6 | 6 من 6 | 6 من 6 | 6 من 6 |
| جدول الصيانة | 5 من 6 | 5 من 6 | 5 من 6 | 6 من 6 |
| migration_budget | 5 من 6 | 6 من 6 | 6 من 6 | 6 من 6 |
| المهام الثلاث | 15 من 18 | 17 من 18 | 17 من 18 | 18 من 18 |
| لكل تشغيل | منخفض | متوسط | عالٍ | xhigh |
| متوسط رموز المخرجات | 1,184 | 6,430 | 6,778 | 9,147 |
| رموز المخرجات نسبةً إلى المستوى المنخفض | 1.0x | 5.4x | 5.7x | 7.7x |
| متوسط استدعاءات الأدوات | 17.2 | 18.7 | 17.8 | 18.1 |
| الوسيط الزمني المنقضي | 18 ثانية | 98 ثانية | 89 ثانية | 106 ثانية |
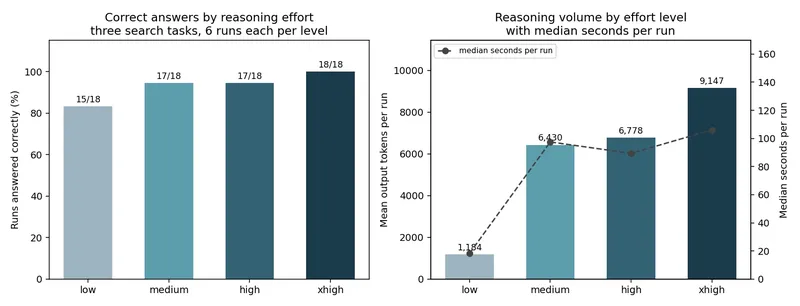
الشكل 1: نسبة التشغيلات التي أُجيب عنها إجابة صحيحة عند كل مستوى من مستويات جهد الاستدلال (يسار)، ومتوسط رموز المخرجات لكل تشغيل مع الوسيط بالثواني لكل تشغيل متراكبًا (يمين)
ثلاث ملاحظات.
xhigh أجاب إجابة صحيحة عن كل التشغيلات. كانت جميع التشغيلات الـ 18 عبر المهام الثلاث صحيحة عند xhigh، و medium و high أجاب بشكل صحيح في 17 من أصل 18 في كل منها. مع ست مرات تشغيل لكل مهمة ومستوى، فإن الفروق بين المستويات استرشادية وليست حاسمة إحصائياً، وكان الاتجاه متسقاً عبر المهام الثلاث جميعها.
يغيّر مستوى الجهد مقدار الاستدلال الذي يقوم به الوكيل، لا مقدار الاستكشاف. كانت استدعاءات الأدوات شبه ثابتة، بين 17.2 و18.7 لكل تشغيل عند كل مستوى. جمع الوكيل الحقائق نفسها بغض النظر عن مستوى الجهد، وما تغيّر هو مقدار الاستدلال الذي طبّقه عليها، حيث ارتفعت رموز المخرجات من 1,184 عند low إلى 9,147 عند xhigh.
low يقدم نسبة جودة مقابل تكلفة قوية. عند low، أجاب الوكيل بشكل صحيح في 15 من أصل 18 تشغيلاً باستخدام نحو ثُمن رموز المخرجات الخاصة بـ xhigh، مع وسيط تشغيل بلغ 18 ثانية. حيثما كان قبول معدل إتمام أقل قليلاً مقبولاً، أو حيثما تتم مراجعة الإجابات لاحقاً، يُعد low خياراً فعّالاً. أما حيثما يجب أن تكون كل إجابة صحيحة من المرة الأولى، فالمستويات الأعلى هي الخيار الافتراضي الأكثر أماناً.
كيف يشكّل مستوى الجهد الإجابة
صُمِّمت المهام حول نوع معين من الصعوبة، والنظر في كيفية تعامل كل مستوى جهد معها يوضّح متى يكون الاستدلال الإضافي مجدياً.
التحسين. تكافئ مهمة الترحيل التفكير في التوليفات بدلاً من ترتيب الخيارات واحداً تلو الآخر. اختيار المرشحين ذوي النسب الفردية الأفضل ينتج إجابة معقولة تقل تسع نقاط عن الأمثل. عند medium وما فوق، وجد الوكيل المجموعة المثلى في جميع الجولات الـ18.
اختبار الفرضيات. تتطلب مهمة التشخيص فحص زوج مرشّح في الاتجاهين: يجب تفسير كل تنبيه، ويجب أن يكون كل خدمة بقيت صامتة متسقاً مع الإجابة. عند medium وما فوق، حدد الوكيل الزوج الصحيح في جميع الجولات الـ18.
إشباع القيود. تجمع مهمة الجدولة عشرة قيود مذكورة مع قاعدة فريق تعتمد على بيانات ملكية يتم البحث عنها. xhigh أنتج الجدول الصالح في كل جولة، وكانت هذه المهمة التي أحدث فيها المستوى الأعلى الفرق الأوضح.
النمط المشترك بين الثلاثة هو أن جهد الاستدلال الإضافي يكون أكثر قيمة حيث يتعين على الوكيل موازنة عدة إجابات مرشحة فيما بينها، بدلاً من اتباع مسار واحد للوصول إلى النتيجة.
مراقبة الاستدلال في بيئة الإنتاج
في بيئة الإنتاج لا تملك إجابة معروفة للمقارنة بها، لكنك تعرف عدد رموز الإخراج ونداءات الأدوات التي استخدمتها كل جولة. وهذا يمنحك إشارة تشغيلية مفيدة.
تبقى الجولات الصحيحة عند كل مستوى فوق حد أدنى واضح من حجم الاستدلال. كل جولة صحيحة عند medium وما فوق استخدمت 1,739 رمز إخراج على الأقل، واستخدمت الجولة النموذجية عدة آلاف. الجولة التي لا تُجري نداءات أدوات، أو التي تنتج إخراجاً أقل بكثير من المعتاد لمستواها، تستحق الإشارة للمراجعة:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
عاير خط الأساس من جولات قمت بتقييمها، لكل مهمة ولكل مستوى جهد، ثم طبّقه على الجولات التي لم تقيّمها. تعامل مع التنبيه كدعوة للفحص أو إعادة التشغيل. عند low، حيث كل جولة قصيرة، يكون حجم الإخراج إشارة أضعف، فاقترنه بفحوصات عشوائية.
طلب التحقق من الوكيل لإجابته في موجه النظام يستحق البقاء، لأنه يجعل استدلال الوكيل سهل المتابعة عند مراجعة جولة. اقترنه بالتقييم الآلي حيثما وُجدت إجابة معروفة، حتى تُقاس الجودة بشكل مستقل عن السجل.
اختيار جهد الاستدلال
تشير هذه النتائج إلى بعض القواعد العملية.
طابق الجهد مع نوع المهمة. المهام التي تنطوي على بحث أو تحسين أو اختبار فرضية تستفيد أكثر من غيرها من medium أو أعلى. المهام التي تتبع مساراً واحداً، أو التي تُراجَع إجاباتها لاحقاً في المصب، يمكنها العمل بكفاءة عند low.
حدد الجهد لكل طلب، لا لكل وكيل. الجهد معلمة في الطلب، فيمكن لوكيل أن يُجري خطوات التخطيط والتحقق عند مستوى أعلى وخطواته الميكانيكية، مثل تنسيق نتيجة أداة، عند low. ذلك يجمع قدراً كبيراً من موثوقية المستوى الأعلى مع تكلفة رموز أقل.
قِس على مهامك الخاصة، مع التكرار. جولة واحدة لكل تكوين تعطي ملاحظة واحدة. تكرار كل تكوين عدة مرات يُظهر مدى اتساقه.
راقب حجم الاستدلال. رموز الإخراج ونداءات الأدوات لكل جولة، متتبعة حسب مستوى الجهد، تمنحك إشارة مبكرة لمراجعة جولة قبل استخدام نتيجتها.
قيود هذا القياس
ست تجارب تشغيل لكل مهمة ولكل مستوى جهد. هذا يكفي لإظهار اتجاه ثابت عبر ثلاث مهام، ولكنه لا يكفي لفترة ثقة. تعامل مع الفروق بين المستويات على أنها استدلالية.
بيئة اصطناعية. تقرأ الأدوات من بيانات مُولَّدة بالشيفرة، وهذا ما يجعل من الممكن إثبات أن لكل مهمة إجابة واحدة بالضبط وتقييمها آليًا. الأدوات الحقيقية تضيف زمن استجابة ونتائج جزئية وأخطاء، ولا شيء من ذلك مُختبَر هنا.
دقائق، لا ساعات. تراوح زمن التشغيل الوسيط من 18 ثانية عند low إلى 106 ثوانٍ عند xhigh. هذا نموذج مصغَّر للعمل طويل الأمد. المنهجية قابلة للنقل، أما الأرقام المطلقة فلا.
إصدار نموذج واحد، ومنطقة واحدة، ومطالبة واحدة لكل مهمة. قد تؤدي الصياغات المختلفة للمهمة نفسها إلى تغيير النتائج، وهذا جزء من سبب أهمية ذكر كل قاعدة بشكل صريح.
أعداد الرموز، لا التكاليف. للتحويل إلى عملة، طبِّق الأسعار الحالية لملف الاستدلال الخاص بك ومستوى الخدمة لديك من صفحة تسعير Amazon Bedrock. يُسعَّر الملفان Global وUS Geo بشكل مختلف، وتطبَّق مضاعفات على مستويي الخدمة Flex وPriority.
ضوابط تشغيلية لأحمال عمل الوكلاء
ادمج إعادة المحاولة في التصميم. الوكلاء التي تُصدر حجمًا كبيرًا من الاستدعاءات ينبغي أن تعامل إعادة المحاولة كجزء من التصميم. حدِّد مهلة للطلب، وأعد المحاولة فقط للأخطاء القابلة لإعادة المحاولة، وتراجَّع أُسّيًا مع عشوائية (jitter)، واحترم ترويسة Retry-After عند إرجاعها:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
تزداد سعة الإنتاجية حسب الطلب مع مرور الوقت، لذا ارفع حمل العمل الجديد ذا الحجم الكبير تدريجيًا بدلًا من البدء بالسرعة الكاملة.
تدقيق تشغيل. يسجِّل تسجيل استدعاءات النماذج بيانات الطلب والاستجابة في Amazon Simple Storage Service (Amazon S3) أو Amazon CloudWatch Logs. يمنحك هذا النص الكامل للتشغيلات التي تريد مراجعتها لاحقًا.
مراقبة حجم الاستدلال على نطاق واسع. تمنحك مقاييس Amazon CloudWatch رؤية إجمالية لاستخدام الرموز، وهنا تصبح خطوط الأساس لكل مستوى الموصوفة سابقًا شيئًا يمكنك إعداد تنبيهات عليه.
إسناد الإنفاق عبر الوكلاء. تفصيل التكاليف في AWS Cost Explorer وتقرير AWS Cost and Usage Report يفصل الاستخدام حسب النموذج، وهذا مجتمعًا مع أعداد الرموز لكل مهمة يمنحك اقتصاديات الوحدة والفاتورة الإجمالية معًا.
مطابقة التكلفة مع الإلحاح. يتم تعيين مستويات الخدمة لكل طلب على حدة، لذا يمكن لنشر واحد أن يرسل تحليلاً ليلياً عبر مستوى Flex وطلباً تفاعلياً عبر Priority. بالنسبة لأحمال العمل التي تعمل بمستوى جهد أعلى، يُعد اختيار المستوى رافعة إضافية على التكلفة.
اختيار ملف تعريف التوجيه. يوسّع الاستدلال عبر المناطق (Cross-Region) مجموعة السعة التي يسحب منها التشغيل الطويل. يخدم ملف التعريف Global من منطقة AWS تجارية من اختيارك ويُسعَّر عادةً بسعر أقل لكل رمز (token) مقارنة بالتوجيه الجغرافي. أما ملف التعريف US فيُبقي المعالجة داخل الولايات المتحدة. اختر بناءً على متطلبات إقامة بياناتك بالإضافة إلى التكلفة.
التنظيف
لا تنشئ الأمثلة في هذه المقالة موارد AWS قابلة للفوترة تتجاوز استخدام الرموز لكل طلب. إذا قمت بإنشاء مفتاح API طويل الأجل لـ Amazon Bedrock، فاحذفه من وحدة تحكم Amazon Bedrock عند الانتهاء، لأنه يظل صالحاً حتى يتم إلغاؤه. أما الرموز قصيرة الأجل المُنشأة من بيانات اعتماد IAM فتنتهي صلاحيتها من تلقاء نفسها.
إذا قمت بتمكين تسجيل استدعاء النموذج إلى Amazon S3 أثناء الاختبار، فراجع الحاوية (bucket) وأزِل الكائنات التي لم تعد بحاجة إليها.
الخاتمة
درَّبت SpaceXAI نموذج Grok 4.7 للعمل لفترات أطول على المهام الأصعب ومعرفة متى يتحقق من عمله. في ثلاث مهام تطلبت البحث بدلاً من الاطلاع المباشر، أجاب الوكيل إجابة صحيحة في 67 من أصل 72 تشغيلاً، وكل تشغيل عند xhigh. ولأن جهد الاستدلال يُعيَّن لكل طلب، يمكنك اختيار موقع كل خطوة من خطوات الوكيل على ميزان المفاضلة بين الشمولية وتكلفة الرموز.
ثلاثة أمور تستحق نقلمها إلى تقييمك الخاص. صمّم المهام بإجابة واحدة قابلة للإثبات واذكر كل قاعدة يعتمد عليها المُقيِّم. كرّر التشغيلات لترى مدى اتساق كل إعداد. وراقب رموز المخرجات واستدعاءات الأدوات حسب مستوى الجهد، حتى تحصل على إشارة تشغيلية إلى جانب قياساتك للجودة.
قراءات إضافية
- تقديم Grok على Amazon Bedrock
- Grok 4.7 متاح الآن على Amazon Bedrock
- توجيه طلبات الاستدلال النموذجي عبر مناطق AWS باستخدام الاستدلال عبر المناطق
- البداية مع Amazon Bedrock
- Chat Completions API
- أسعار Amazon Bedrock
- تقديم Grok 4.7 (SpaceXAI)