
يحتاج محللو الأمن إلى إجابات سريعة حول بنيتهم التحتية السحابية دون إلمام عميق بلغات الاستعلام الخاصة بالمجال. طورت Orca Securityأداةً تغطي أكثر من 900 نموذج سحابي (أنواع الموارد التي يتتبعها Sonar، مثل مثيل Amazon Elastic Compute Cloud (Amazon EC2) أو حاوية Amazon Simple Storage Service (Amazon S3)). وكان الاستعلام عن تلك البيانات يتطلب أسماء نماذج دقيقة، وتنقلاً عبر علاقات متداخلة، واختياراً من بين 18 عاملاً (دوال مقارنة مثل equals أو contains تُستخدم لتصفية النتائج).
ولحل ذلك، عقدت Orca Security شراكة مع AWS لبناء Discovery AI، وهو وكيل استعلام بلغة طبيعية يعمل على Amazon Bedrock. توفر Orca أمناً واعياً بالسياق للسحابة والشيفرة والذكاء الاصطناعي، وSonar هو نظام الاستعلام الخاص بمجالها حيث يبحث المستخدمون ويفلترون ويستكشفون عبر كامل الرسم البياني للبيانات.
في هذه المقالة، نشارك بنية Discovery AI ونتائجها، حيث تحوّل سؤالاً بلغة طبيعية إلى استعلام Sonar. ونتيجة لذلك، خفضت Orca تكاليف الاستعلام بنسبة 90 بالمئة، ورموز الإدخال بنسبة 93 بالمئة، وزمن الاستجابة بنسبة 75 بالمئة مقارنة بالخط الأساسي الأولي.
الجسر بين اللغة الطبيعية والاستعلامات المهيكلة
يدعم نظام الاستعلام Sonar من Orca Security أكثر من 900 نموذج للبنية التحتية السحابية والتطبيقات مع علاقات معقدة بينها. للاستعلام عن هذه البيانات، يبني المستخدمون كائنات JSON تحدد أسماء النماذج بدقة، وتختار من بين 18 عاملاً، وتتنقل في التسلسلات الهرمية للأصل والفرع عبر مزودي الخدمات السحابية. وإتقان ذلك يتطلب إلماماً عميقاً بمخطط Sonar.
لبناء هذه القدرة، انطلق فريق Orca لبناء واجهة بلغة طبيعية قادرة على توليد استعلامات Sonar صالحة من نص عادي.
الإثبات الأولي لمفهومهم حمل المخطط الكامل لـ Sonar في توجيه واحد على أكبر نموذج متاح. تضمن ذلك أكثر من 900 تعريف نموذج، وكل نوع علاقة، ومجموعة سخية من أمثلة الاستعلامات. كانت جودة المخرجات قوية (استجاب الشركاء التصميميون والمستخدمون الداخليون بشكل إيجابي)، لكن ظهرت ثلاثة عيوب جوهرية على نطاق الإنتاج.
كان استهلاك الرموز غير فعال، بنحو 2 مليون رمز إدخال لكل حمل عمل، مما رفع التكلفة. وكان زمن الاستجابة مرتفعاً، بأوقات استجابة من طرف إلى طرف تبلغ حوالي 60 ثانية لكل حمل عمل. وكانت الدقة في الاستعلامات المعقدة متعددة النماذج محدودة لأن العلاقات المتداخلة والاستعلامات متعددة الشروط كانت غالباً تتطلب تحسيناً إضافياً.
تحقق فريق Orca من أن المفهوم يعمل. وكان التحدي التالي هو جعله فعالاً من حيث التكلفة وسريعاً ودقيقاً بما يكفي للإنتاج. ولمعالجة ذلك، صمم فريق Orca ونشر حلاً يعالج آلاف الاستعلامات يومياً بأوقات استجابة تبلغ 15 ثانية باستخدام Amazon Bedrock.
نظرة عامة على الحل
صممت Orca أداة Discovery AI كحل هجين على Amazon Bedrock يجمع بين التوليد المعزز بالاسترجاع (RAG) وبناء الاستعلامات الواعي بالمخطط. يحول النظام الأسئلة بلغة طبيعية إلى مرشحات Discovery صالحة عبر خط أنابيب متعدد المراحل، مع مطابقة كل مرحلة بأنسب نموذج من Amazon Bedrock.
اختارت Orca خدمة Amazon Bedrock لأنها توفر وصولاً متعدد النماذج من خلال واجهة API واحدة، مما يتيح للفريق تخصيص نماذج أساسية مختلفة لكل مرحلة من مراحل خط الأنابيب دون إدارة تكاملات منفصلة. كما يرث Amazon Bedrock ضوابط الحوكمة من AWS عبر AWS Identity and Access Management (IAM)، ونقاط النهاية للشبكة الخاصة الافتراضية (VPC)، وAWS CloudTrail، مما يلبي متطلبات الأمن لدى Orca. وبفضل البنية المحايدة للنماذج، تمكن الفريق من استبدال إصدارات النماذج الأحدث كلما توفرت دون إعادة هندسة خط الأنابيب.
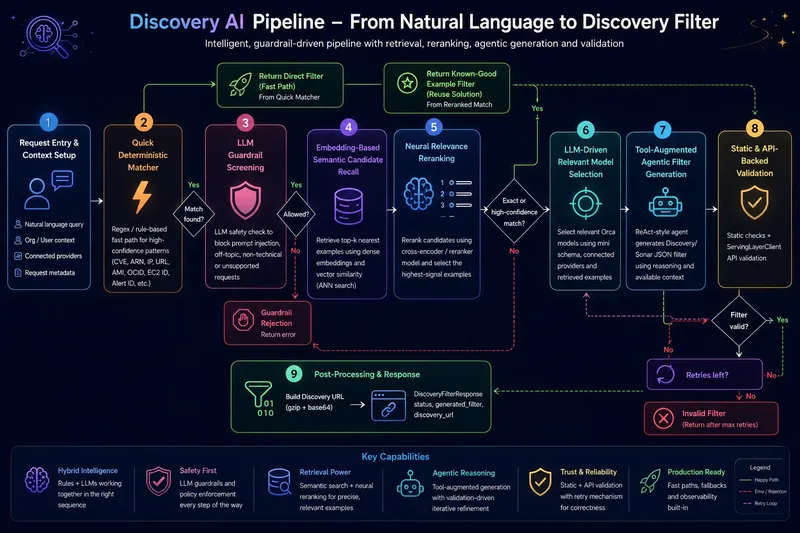
يوضح المخطط التالي بنية خط الأنابيب ذي التسع مراحل.
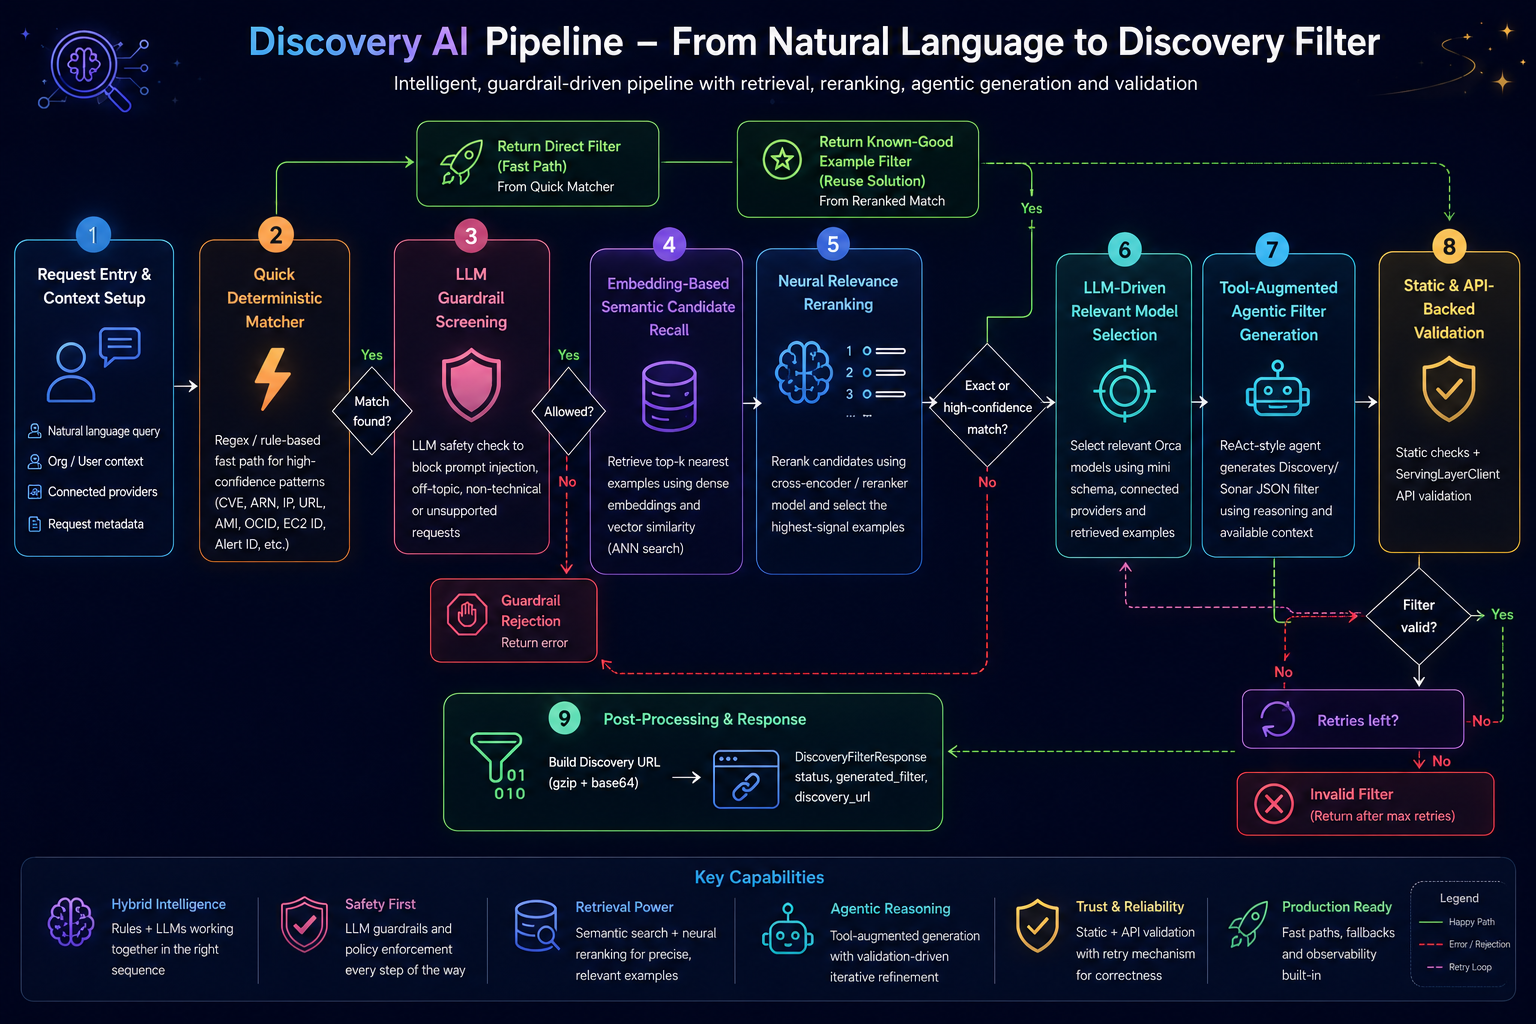
الشكل 1: بنية خط أنابيب Discovery AI متعدد المراحل توضح التدفق من المدخل بلغة طبيعية إلى استعلامات مرشحات Discovery المتحقق منها باستخدام النماذج الأساسية على Amazon Bedrock
يحول خط أنابيب Discovery AI طلباً بلغة طبيعية إلى مرشح Discovery متحقق منه عبر تسع خطوات.
- مدخل الطلب وإعداد السياق: يبدأ خط الأنابيب بدمج طلب المستخدم بلغة طبيعية مع السياق ذي الصلة، بما في ذلك مؤسسة المستخدم، ومزودو الخدمات السحابية المتصلون، وبيانات وصف الطلب. ويساعد هذا السياق خط الأنابيب على تفسير الطلب بدقة وتوليد مرشح Discovery يتوافق مع بيئة العميل.
- المُطابق الحتمي السريع: يحدد Quick Matcher المدخلات المهيكلة مثل عناوين IP، والثغرات والنقائف الشائعة (CVEs)، وARNs، وبصمات الملفات، ومعرفات Amazon Machine Image، ومعرفات Oracle Cloud، ومعرفات EC2، وعناوين URL، ومعرفات التنبيهات. ويستخدم التعبيرات النمطية والمطابقة القائمة على القواعد لاكتشاف الأنماط عالية الثقة. عند العثور على تطابق، يمكن لخط الأنابيب إرجاع مرشح Discovery محدد مسبقاً عبر مسار سريع، دون استخدام استدلال نموذج اللغة الكبير (LLM). وعند عدم العثور على تطابق، يستمر الطلب إلى الخطوة التالية.
- فحص حواجز الحماية للنماذج اللغوية الكبيرة: يتحقق مكوّن الحاجز (Guardrail) مما إذا كان الطلب آمناً وذا صلة وتقنياً ومدعوماً. فهو يحجب محاولات حقن التوجيهات، والطلبات خارج الموضوع، والمدخلات غير المدعومة قبل وصولها إلى بقية خط الأنابيب. وتُرفض الطلبات التي تجتاز فشلها في فحوصات الحاجز مع رسالة خطأ مناسبة. أما الطلبات المعتمدة فتستمر إلى استرجاع الأمثلة.
- استدعاء المرشحين الدلالي القائم على التضمين (Embedding-Based Semantic Candidate Recall): يبحث خط الأنابيب عن أمثلة استعلامات سابقة تم التحقق منها وذات صلة باستخدام Amazon Titan Text Embeddings. ويسترجع الأمثلة الـ 20 الأقرب من مخزن المتجهات استنادًا إلى التشابه الدلالي. وتوفر هذه المرشحات لخط الأنابيب أمثلة على كيفية ترجمة طلبات لغة طبيعية مشابهة سابقًا إلى فلاتر Discovery.
- إعادة ترتيب الصلة العصبي (Neural Relevance Reranking): تُعاد ترتيب المرشحات المسترجعة باستخدام Cohere Rerank 3.5 على Amazon Bedrock. ويحدد الأمثلة الأكثر صلة بالطلب الحالي ويختار الأمثلة الخمسة الأعلى إشارة. عند العثور على مطابقة تامة أو عالية الثقة، يمكن لخط الأنابيب إعادة استخدام الفلتر المعروف بصحته مباشرة. بخلاف ذلك، تُمرَّر الأمثلة المعاد ترتيبها إلى المراحل التوليدية.
- اختيار النموذج ذي الصلة المدفوع بنماذج LLM: يضيّق اختيار النماذج أكثر من 900 نموذج Sonar إلى المجموعة الصغيرة ذات الصلة بالطلب. وهو يأخذ في الاعتبار طلب المستخدم والمزودين المتصلين والأمثلة المسترجعة عند اختيار النماذج المناسبة. وتُقدَّم النماذج المختارة إلى المولّد (Generator) باستخدام مستوى المخطط المناسب، بدءًا من المخططات الدقيقة المدمجة (micro schemas) وصولًا إلى المخططات المصغّرة الأكثر تفصيلاً (mini schemas). هذا يقلل السياق غير الضروري ويجعل التوليد أكثر كفاءة.
- توليد الفلاتر الوكيل المعزز بالأدوات: يستخدم المولّد (Generator) وكيلًا معززًا بالأدوات لبناء فلتر Discovery النهائي. ويفكر عبر مخططات النماذج المختارة والأمثلة المسترجعة وسياق المستخدم والأدوات المتاحة. ويمكن للوكيل تحسين الفلتر تكراريًا أثناء عمله نحو تمثيل صالح لطلب المستخدم.
- التحقق الساكن والمدعوم بواجهة API: يُفحص الفلتر المولَّد من حيث الصحة النحوية والدلالية. يطبق خط الأنابيب أولًا التحقق الساكن ثم يتحقق من الفلتر مقابل واجهة Sonar API الخاصة بـ Orca. عند فشل التحقق، يُعاد خطأ التحقق إلى المولّد حتى يتمكن الوكيل من تصحيح الفلتر والمحاولة مجددًا. إذا وصل إلى الحد الأقصى من المحاولات دون إنتاج فلتر صالح، يُعيد خط الأنابيب استجابة فلتر غير صالح. ويُقيَّد المولّد بالأمثلة المعاد ترتيبها والمخططات المختارة. ويحل التحقق الساكن كل نموذج وحقل ومُعامل بالرجوع إلى تعريفات المخطط تلك. ويُعاد كل خطأ تحقق إلى الوكيل مع تحديد العنصر المخالف، بحيث تعيد المحاولات التأسيس بدلًا من إعادة التخمين.
- المعالجة اللاحقة والاستجابة: بعد إنتاج فلتر صالح، سواء عبر Quick Matcher أو إعادة استخدام مثال معروف بصحته أو التوليد الوكيل، يجهز خط الأنابيب الاستجابة النهائية. وقد خصص الفريق نماذج أساس مختلفة على Amazon Bedrock عبر المكونات بناءً على متطلبات كل مرحلة. Anthropic Claude Haiku 4.5 يشغّل مُختار النماذج والمولّد. وتتطلب هذه المكونات قدرة استدلالية قوية لبناء استعلامات دقيقة. Amazon Nova 2 Lite يتولى الحماية (Guardrail) والتحقق (Validator)، حيث تُعطى الأولوية للاستدلال السريع بتكلفة أقل. ويوفر Amazon Titan تضمينات للبحث الدلالي في مكوّن استرجاع الأمثلة. ويعيد Cohere Rerank 3.5 ترتيب المرشحات المسترجعة لتعظيم الصلة. للتوفر حسب منطقة AWS، راجع التوفر الإقليمي حسب النماذج.
تعظيم الصلة والتنوع في استرجاع الأمثلة
برز استرجاع الأمثلة كأكبر عامل منفرد لتحسين الدقة في خط الأنابيب. فالأمثلة القوية تُعلّم المولّد كيفية ترجمة الأسئلة إلى استعلامات Sonar بكفاءة أكبر من الاعتماد على المخطط وحده، لذا اختبر فريق Orca عدة استراتيجيات استرجاع على Amazon Bedrock. ووازنت كل استراتيجية بين الصلة أو التنوع أو السرعة بطريقة مختلفة، ومقارنتها مباشرة أظهرت أي مجموعة تعمل بشكل أفضل.
أدى البحث الدلالي البحت بأعلى K من تضمينات Amazon Titan بسرعة، لكنه كان يميل إلى إعادة أمثلة شبه مكررة تحرم المولّد من التنوع. حسّنت الصلة الهامشية القصوى (MMR) التنوع، لكنها ضحّت بالصلة عندما يكون المرشح الأعلى هو الإجابة الصحيحة فعلًا. أما استرجاع مجموعة مرشحين أكبر ثم إعادة ترتيبها فقد جلب مجموعة أوسع واستخدم مُعيد ترتيب لاختيار المجموعة الفرعية الأكثر صلة، مما أشار إلى النهج الفائز.
وكان الفائز هو الاسترجاع بعشرين جارًا الأقرب (top-20) باستخدام تضمينات Amazon Titan. ثم أعاد Orca ترتيب هذه النتائج باستخدام Cohere Rerank 3.5 وصولًا إلى الخمسة الأوائل. يمنح هذا النهج المولّد مجموعة صغيرة ومتنوعة وعالية الصلة من الأمثلة دون إجباره على الموازنة بين التغطية والدقة وقت الاسترجاع.
تحميل أكثر من 900 نموذج في السياق
شكّل قيد جوهري الهندسة المعمارية. فلم يكن ممكنًا تضمين مخططات أكثر من 900 نموذج Sonar في كل مطالبة (prompt). وحتى مع النماذج طويلة السياق، فإن ذلك يضر بالتكلفة والدقة معًا.
يحل مُختار النماذج هذه المشكلة. وهو يعمل على Anthropic Claude Haiku 4.5، مستندًا إلى تمثيلات مدمجة وغنية دلاليًا لكل نموذج (الاسم والغرض والحقول الرئيسية والعلاقات الرئيسية). وبالنظر إلى سؤال المستخدم، يعيد فقط النماذج التي يحتاجها المولّد فعلًا. ثم يتلقى المولّد التفاصيل الكاملة للمخطط لتلك النماذج المختارة فقط بالإضافة إلى العلاقات التي تربطها.
منهجية التقييم
للتكرار بثقة، بنى فريق Orca منصة تقييم مستمرة في وقت مبكر من المشروع. تجمع المنصة بين مجموعة بيانات منسقة وطبقة تقييم آلية ومنهج قياس قائم على الشرائح حتى يتمكن الفريق من الثقة في كل تغيير قبل إطلاقه. وتحوّل هذه العناصر مجتمعةً التقييم إلى خطوة روتينية بدلًا من كونه فكرة لاحقة.
تغطي مجموعة بيانات التقييم المنسّقة أنواع الأسئلة وعائلات النماذج ومستويات التعقيد الموجودة في بيئة الإنتاج، لذا فهي تعكس الاستخدام الفعلي. وتقوم طبقة تقييم تعتمد على نموذج لغوي كحكّام (LLM-as-judge) بتقييم الاستعلامات المولّدة من حيث الصحة والاكتمال والتكافؤ الدلالي مع استعلام مرجعي، مما يمنح الفريق إشارة جودة متسقة. ثم تقوم منهجية القياس بتقسيم التغيرات حسب الشرائح، مما يتيح للفريق تحديد أماكن حدوث التراجعات بدقة وما يجب تصحيحه.
كل تغيير في مطالبة (prompt) أو نموذج أو معامل استرجاع أو مثال يمر عبر هذا الإطار قبل نشره في بيئة الإنتاج.
نظام وسم بإشراف خبراء المجال من أجل التحسين المستمر
استدامة الدقة مع تطور بيئات العملاء وظهور أنماط أسئلة جديدة تطلبت أكثر من مجرد نشر أولي قوي. لذلك بنت فريق Orca أداة وسم داخلية لمديري المنتجات ومهندسي الدعم والباحثين في الأمن السيبراني. تتيح لهم هذه الأداة وضع علامات على الاستعلامات وتصحيح المخرجات ودفع التصحيحات إلى بنك الأمثلة في إجراء واحد. علاوة على ذلك، يقوم النظام تلقائيًا بجمع استعلامات الإنتاج ذات الأمثلة المطابقة منخفضة الثقة وتوجيهها إلى خبير المجال المناسب للوسم اليومي. وعند التشغيل التالي لخط المعالجة، يُسترجع المثال الجديد عبر Cohere Rerank 3.5، وتتحسن الدقة في تلك الفئة من الأسئلة في اللحظة نفسها، دون أي نشر.
«واجهة الوسم هي أهم استثمار قمنا به من أجل الجودة على المدى الطويل. فهي تحوّل Discovery AI من نشر ثابت إلى نظام حيّ، يعمل خبراؤنا في المجال على تحسينه باستمرار ضمن سير عملهم المعتاد.»
— أور جاباي، مدير الذكاء الاصطناعي، Orca Security
وبالاقتران مع قابلية المراقبة الشاملة لخط المعالجة ولوحات المعلومات المشتركة الممتدة عبر فرق المنتج والهندسة والفرق المواجهة للعملاء، فإن حلقة التغذية الراجعة هذه هي ما يبقي Discovery AI في حالة تحسين مستمر بعد الإطلاق الأولي.
النتائج
بعد نشر Discovery AI في بيئة الإنتاج، تفوق الحل الجديد خط الأساس الأولي من حيث التكلفة وزمن الاستجابة والدقة. انخفض استهلاك رموز الإدخال (input tokens) بنسبة 93 بالمئة، من نحو 2 مليون رمز إلى 140,000 رمز لكل عبء عمل مماثل. وانخفضت التكلفة الإجمالية بنسبة 90 بالمئة، بدافع انخفاض استهلاك الرموز هذا إلى جانب تخصيص النماذج لكل مرحلة عبر Amazon Bedrock.
كما تحسّن زمن الاستجابة، مع انخفاض أوقات الاستجابة من البداية إلى النهاية بنسبة 75 بالمئة، من نحو 60 ثانية إلى 15 ثانية. وتحسّنت أيضًا الدقة في الاستعلامات المعقدة متعددة النماذج، وفقًا للقياس المستمر من خلال إطار التقييم الخاص بالفريق.
يتعامل Discovery AI الآن مع آلاف الاستعلامات يوميًا في بيئة الإنتاج منذ مارس 2026، مع تحقق خبراء المجال الداخليين وملاحظات العملاء من الجودة.
الخاتمة
في هذا المنشور، شاركنا كيف بنت Orca Security الحل Discovery AI على Amazon Bedrock. فقد خفّض الحل تكاليف الاستعلام بنسبة 90 بالمئة، واستهلاك رموز الإدخال بنسبة 93 بالمئة، وزمن الاستجابة بنسبة 75 بالمئة مقارنة بخط الأساس الأولي. يجمع الحل بين عدة تقنيات رئيسية، تشمل استرجاع الأمثلة القائم على RAG باستخدام Cohere Rerank 3.5، وتخصيص النماذج لكل مرحلة عبر Anthropic Claude Haiku 4.5 وAmazon Nova 2 Lite، والبحث الدلالي المدعوم من Amazon Titan. إضافة إلى ذلك، يوفر نظام الوسم البشري المستمر تحسينًا مستمرًا. وقد سمح هذا المزيج لشركة Orca بتحويل نموذج أولي عامل إلى حل بجودة الإنتاج يكون أرخص في التشغيل وأكثر دقة في الوقت نفسه.
للبدء في بناء حلول مشابهة، استكشف Amazon Bedrock للوصول إلى النماذج الأساسية (FM)، و Cohere Rerank on Amazon Bedrock لتحسين الاسترجاع، و Amazon Titan للتمثيلات المتجهية (embeddings). ولمعرفة المزيد عن أداة الأمن السحابي من Orca Security، تفضل بزيارة orca.security.
لمعرفة المزيد عن كيفية تطبيق Orca Security للذكاء الاصطناعي عبر إطار عملها، راجع كيف تحقق Orca نتائج أمنية باستخدام الذكاء الاصطناعي و كيف تؤمّن Orca تبنّي الذكاء الاصطناعي، بما في ذلك Amazon Bedrock.
لمزيد من المعلومات عن التقنيات المستخدمة في هذا المنشور، اقرأ المنشورات ذات الصلة على مدونة AWS للتعلم الآلي.