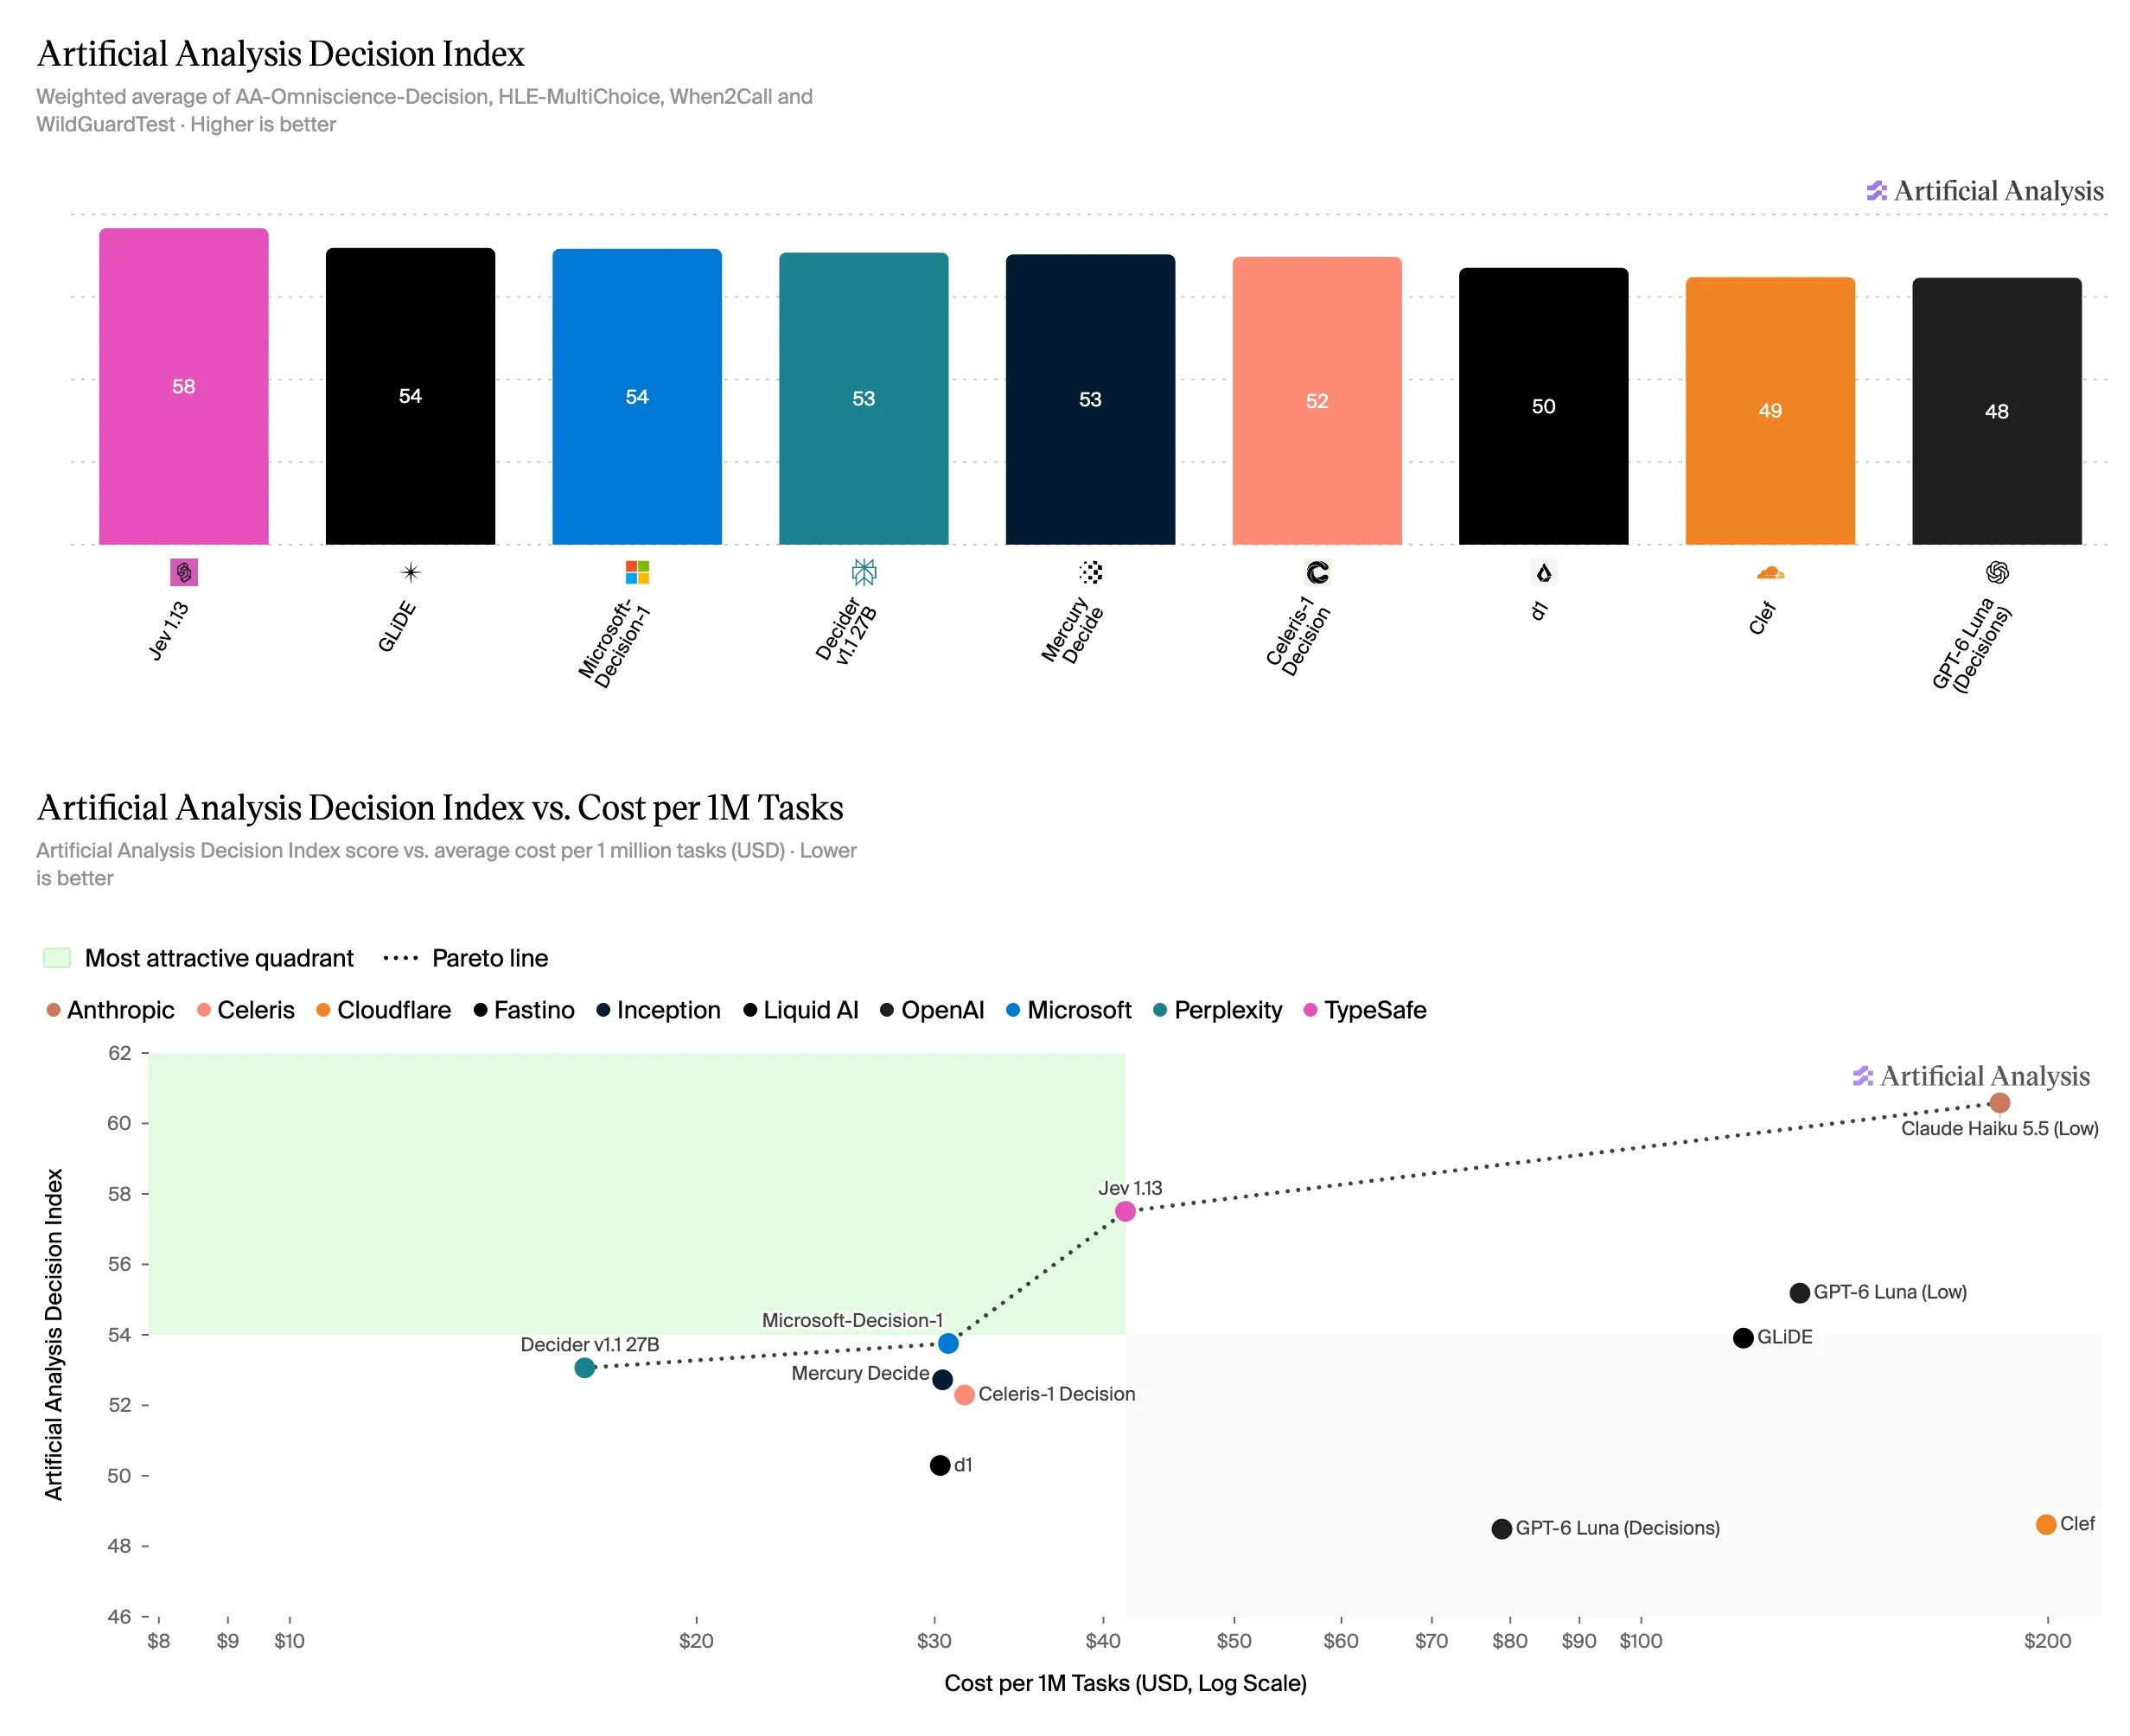
نقدّم مؤشر القرار من Artificial Analysis، الذي يقيس أداء نماذج القرار عبر التصنيف، واستدعاء الأدوات، والمعرفة، والاستدلال. يتصدّر Jev نماذج القرار؛ ولا تزال نماذج اللغة مثل Claude Haiku 5.5 تحقق دقة أعلى، لكن بتكلفة وزمن استجابة أعلى بكثير
تقدّم نماذج القرار إجابات مهيكلة أو تصنيفات مع احتمالات مرتبطة بها، مما يوفر استجابات أسرع وتكاليف أقل من استخدام نماذج اللغة. يقارن مؤشر القرار من Artificial Analysis الإصدار 1.0 القدرة والتكلفة والسرعة لنماذج القرار، كما يقارنها بنماذج اللغة.
المعايير في مؤشر القرار من Artificial Analysis الإصدار 1.0:
➤ AA-Omniscience-Decision: مجموعة بيانات خاصة مكوّنة من 500 سؤال معدّلة من معيار AA-Omniscience الاحتكاري، تقيس معرفة نماذج القرار وميلها للهلوسة
➤ HLE-MultiChoice: 513 سؤالاً اختياراً من متعدد نصياً فقط من اختبار Humanity’s Last Exam، يختبر قدرات الاستدلال لدى نماذج القرار
➤ When2Call: معيار لاستدعاء الأدوات من NVIDIA، يختبر ما إذا كانت النماذج قادرة على أن تقرر بشكل صحيح استدعاء أداة أو طلب توضيح أو الامتناع عن الإجابة أو الرد مباشرةً، ويقيّم قدرات ذات صلة بسير العمل الوكيلية وتوجيه الأدوات
➤ WildGuardTest: معيار للسلامة يقيّم قدرات النماذج في التصنيف عبر الطلبات الضارة من المستخدمين، ورفضات المساعد، والردود الضارة. نستخدم مجموعة فرعية مكونة من 835 صفاً من أصل 1,725 صفاً اختبارياً اتفق فيها جميع المعلّقين البشريين الثلاثة على جميع التسميات الثلاث، بعد استبعاد الأسئلة التي تؤدي باستمرار إلى رفض النماذج
النتائج الرئيسية:
➤ يتصدّر Jev 1.13 مؤشر القرار، ويقع على حدود باريتو للقدرة مقابل التكلفة: يحصل Jev 1.13 من @typesafeai على درجة 58 في مؤشر القرار من Artificial Analysis، متقدماً على GLiDE (54) من @fastinoAI وMicrosoft-Decision-1 (54) من @Microsoft. يمتلك Decider v1.1 بحجم 27B من @perplexity_ai أدنى تكلفة لكل مليون مهمة (Cost per 1M Tasks) عند 17 دولاراً، مع وجود Microsoft-Decision-1 (31 دولاراً) وJev 1.13 (42 دولاراً) أيضاً على حدود باريتو للقدرة مقابل التكلفة. يمتلك Celeris-1 Decision أسرع زمن لكل مهمة عند 0.06 ثانية، أي أسرع بأكثر من 2 مرة من Jev 1.13 (0.13 ثانية لكل مهمة)
➤ نماذج القرار سيّأة المعايرة في مهام المعرفة والاستدلال: عبر جميع مستويات الاحتمالات تقريباً للإجابات المختارة، تكون الدقة أدنى من ذلك الاحتمال لجميع نماذج القرار. هذه الفجوة هي الأكبر في AA-Omniscience-Decision وHLE-MultiChoice، بينما تكون معظم النماذج معايَرة بشكل جيد نسبياً في WildGuardTest (التصنيف) وWhen2Call (استدعاء الأدوات)
➤ تقدم نماذج القرار مزايا كبيرة في السرعة والتكلفة مقارنة بنماذج اللغة، لكنها تتأخر في المعرفة والاستدلال: في مهام التصنيف واستدعاء الأدوات، تؤدي نماذج القرار الرائدة أداءً مماثلاً لنماذج اللغة مع كونها أسرع وأرخص بشكل كبير. ومع ذلك، تتفوق نماذج اللغة بشكل كبير في المعرفة والاستدلال. يحصل Claude Haiku 5.5 (Low) على درجة 61 في مؤشر القرار، أي بـ 3 نقاط متقدمة على Jev 1.13، لكنه يستغرق 1.4 ثانية لكل مهمة مقابل 0.13 ثانية (أبطأ 11 مرة) وتكلفته 184 دولاراً لكل 1M Tasks مقابل 42 دولاراً لـ Jev 1.13 (أغلى 4.4 مرة)
سنواصل تطوير مؤشر القرار من Artificial Analysis لمساعدة المطورين والشركات على فهم أفضل لمتى وكيف يستخدمون نماذج القرار.