تظهر معارك الساحة:
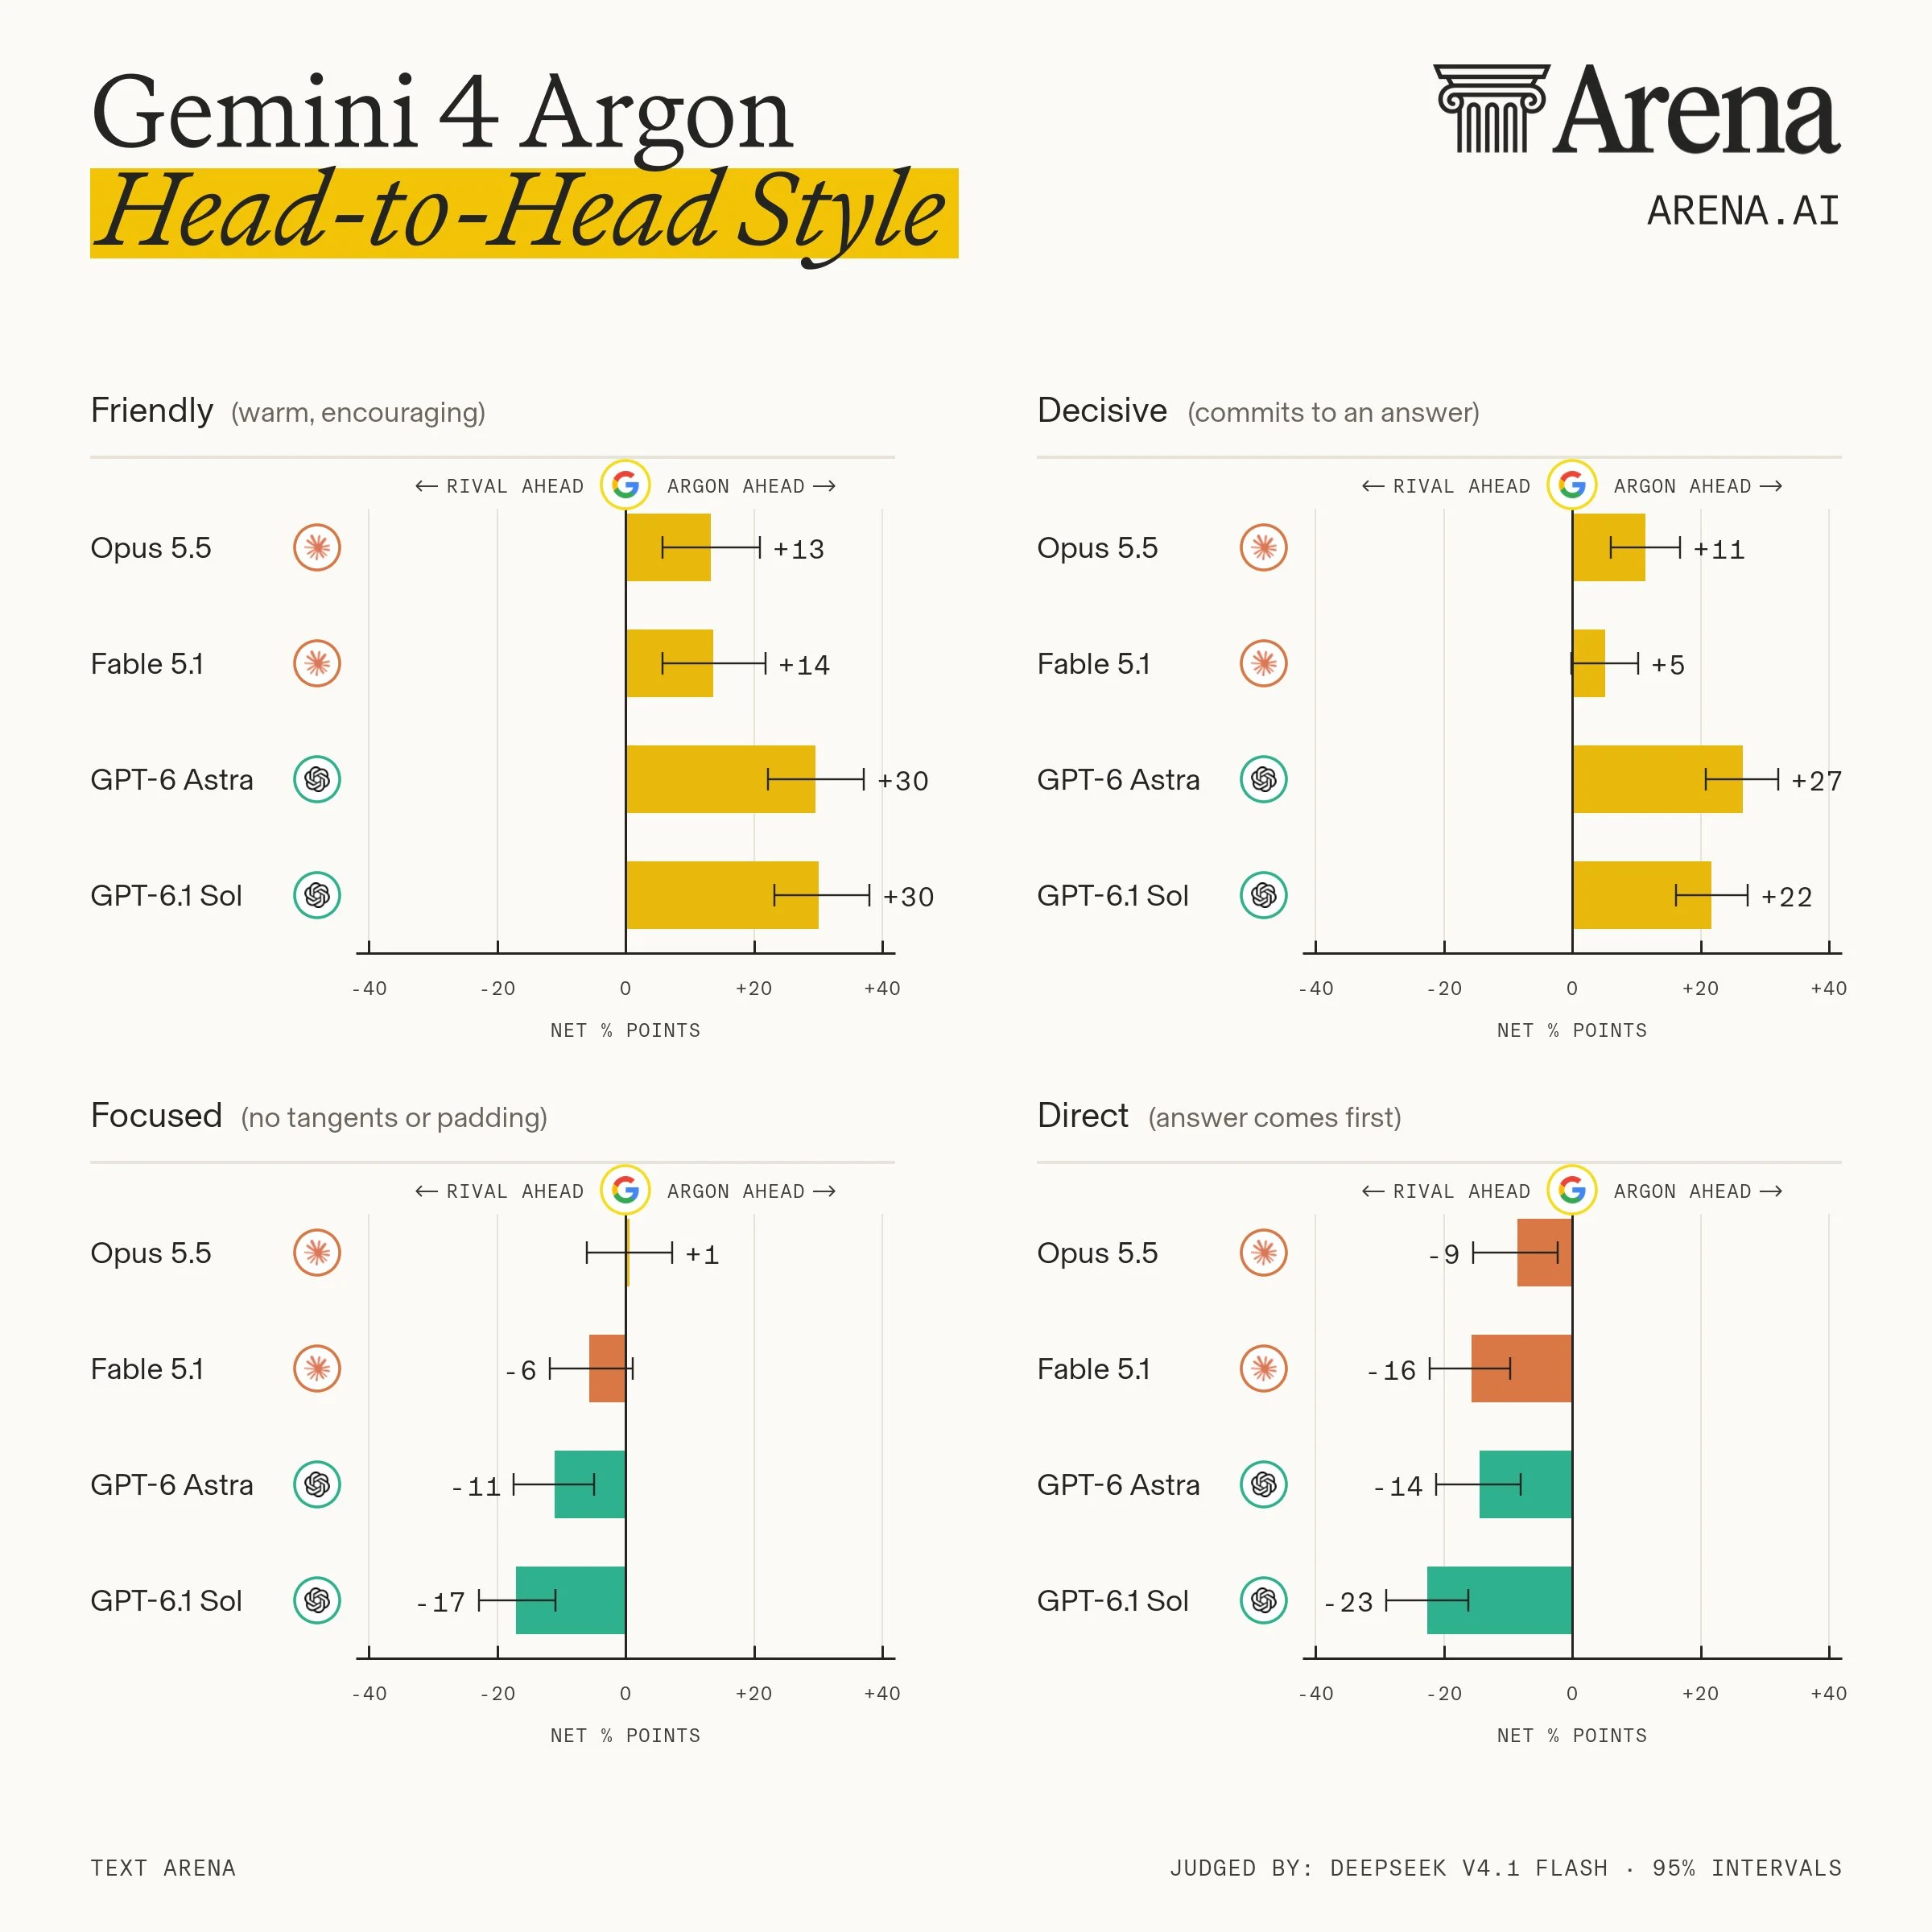
- الإصدار الجديد لـ @GoogleDeepMind أكثر ودية وحاسمًا. يحتفظ بطابع دافئ ومشجع وواضح. ضد GPT-6.1 Sol، قيمت القاضي الذكي أن Argon أكثر وداعة بنسبة 55% مقارنةً بـ Sol بنسبة 25% فقط. ضد Opus 5.5، النسبة هي 46% مقابل 32%.
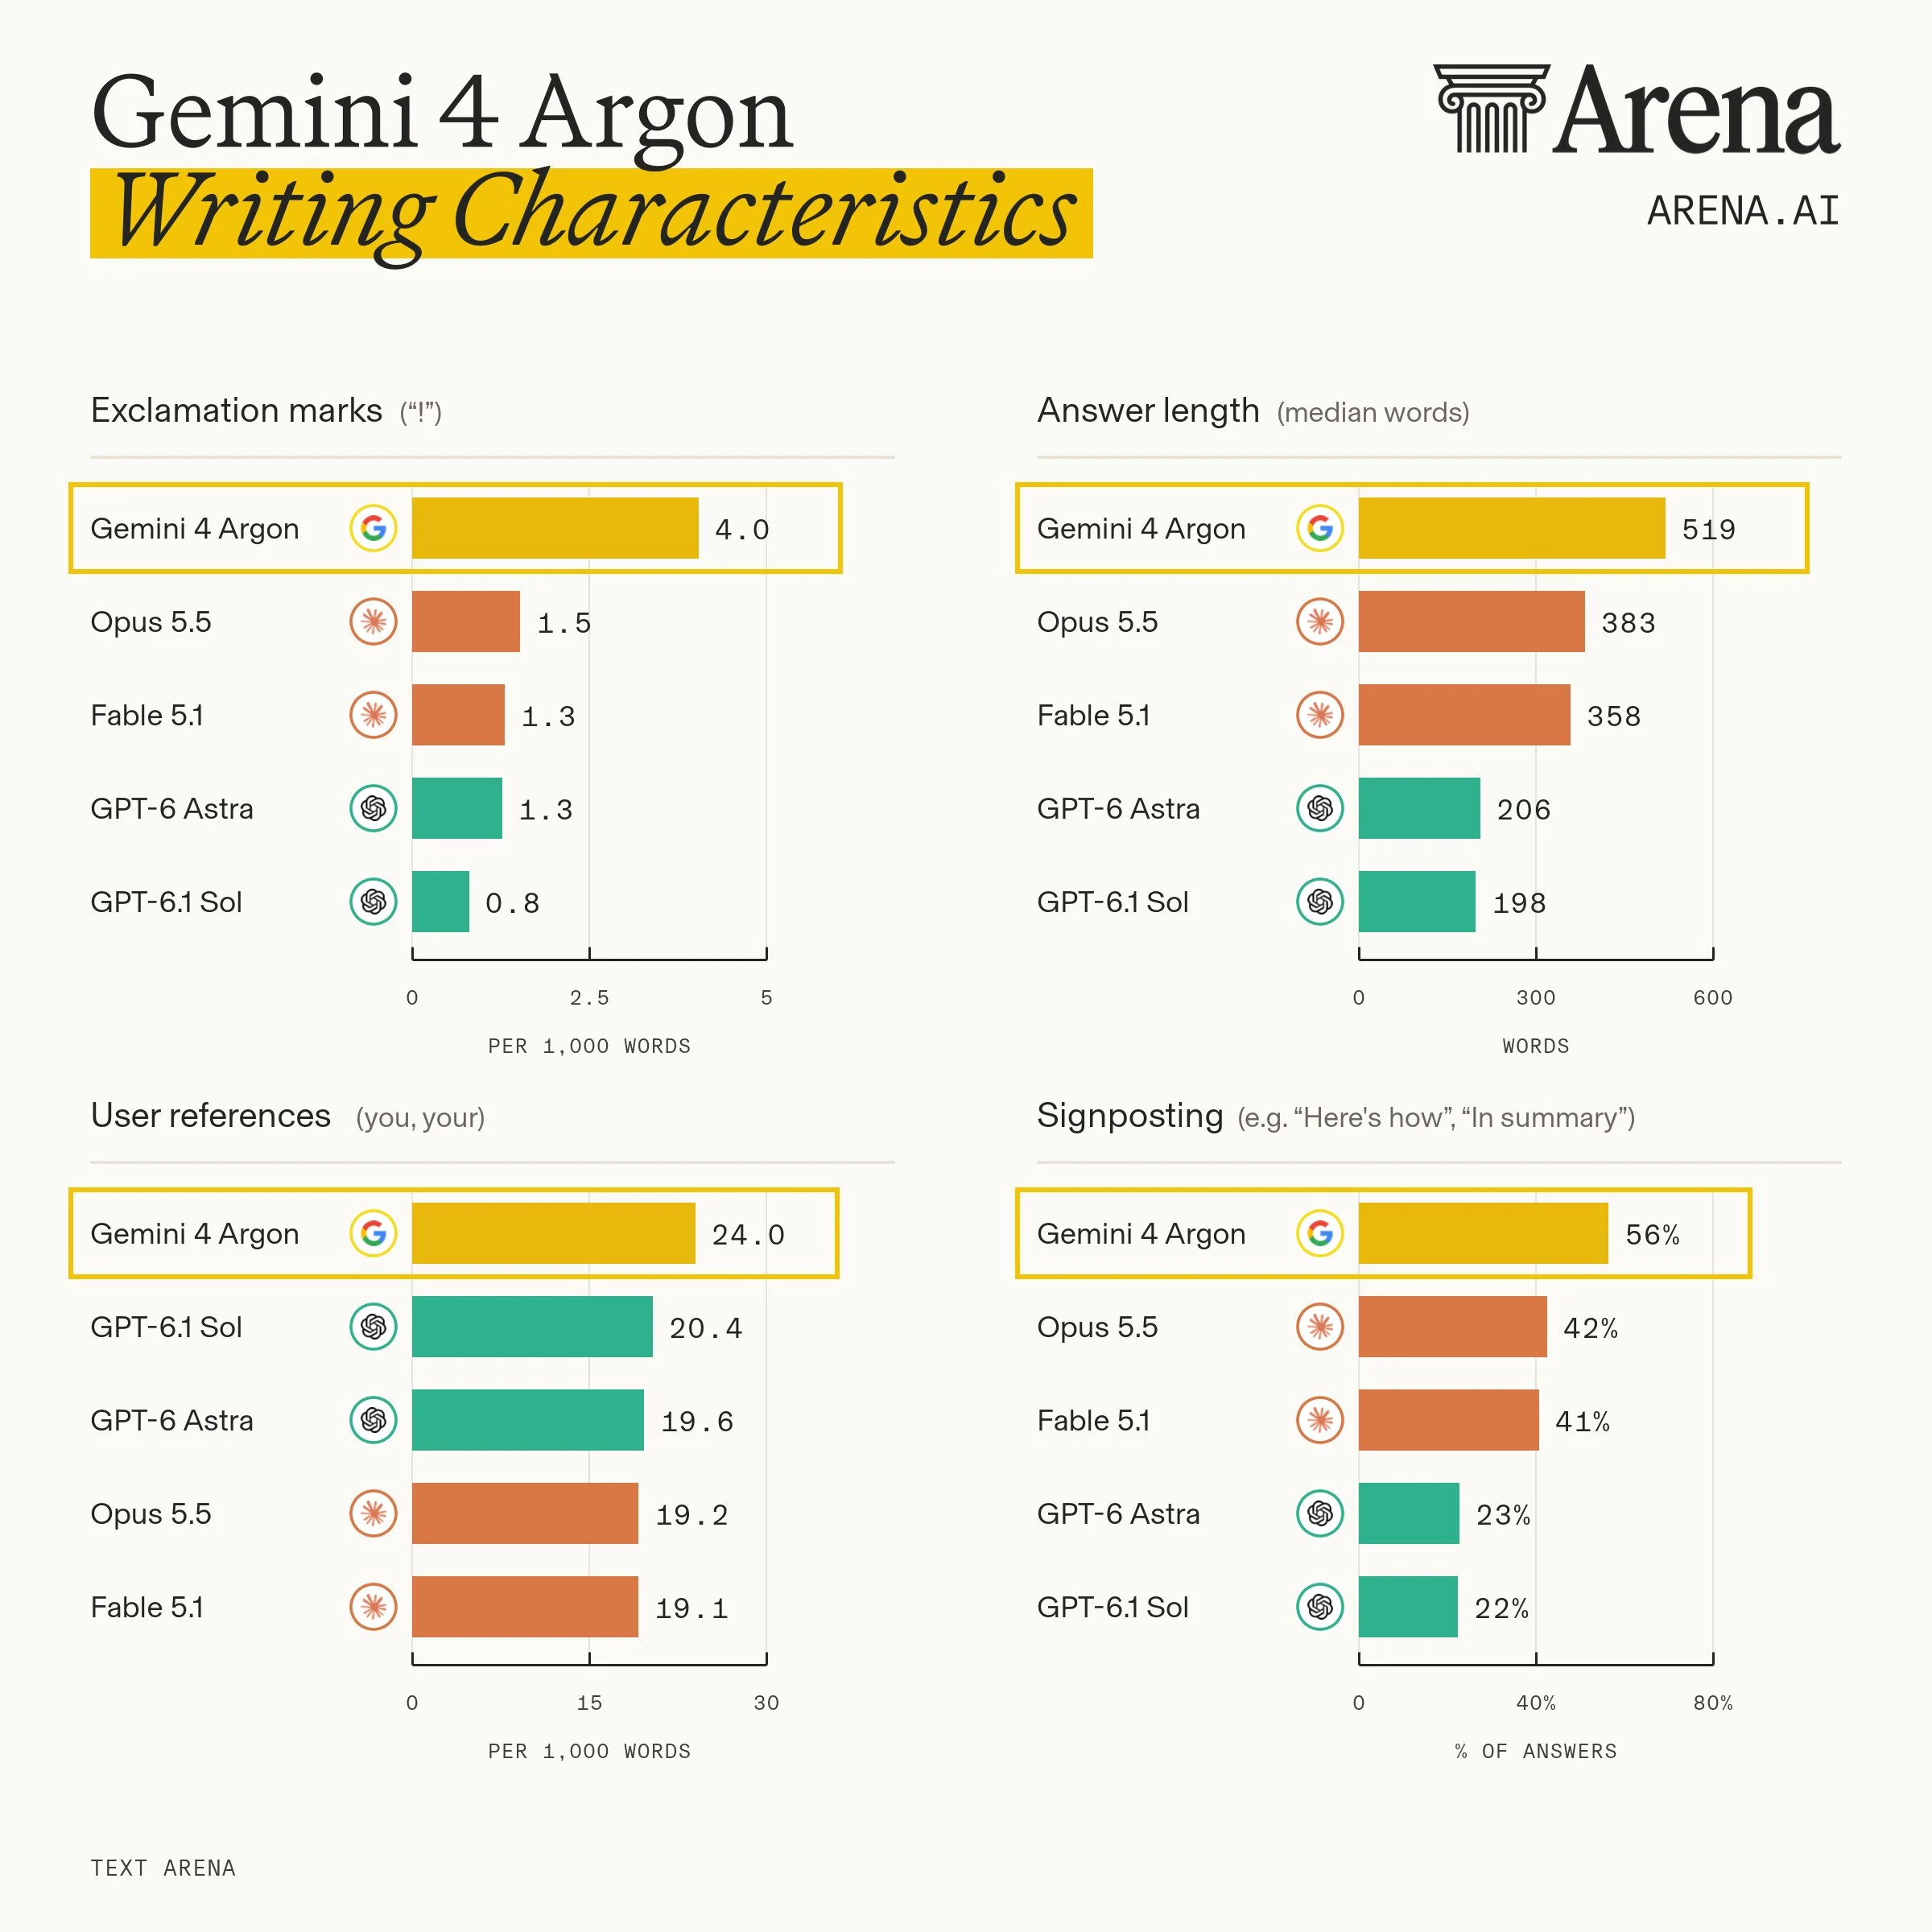
- إنه أكثر حوارية: يتحول النموذج إلى موضوعات مختلفة أكثر، ويكون أقل مباشرًا. تم تقييم إجابات المنافسين كأكثر مباشرة في 32-37% من المقارنات، بينما كانت إجابات Argon فقط في 14-23%. ويتجلى ذلك أيضًا في طول الإجابة: متوسط عدد الكلمات في إجابة Argon هو 519 كلمة، مقابل 358-383 كلمة لـ Claude وحوالي 200 كلمة لأنماط GPT.
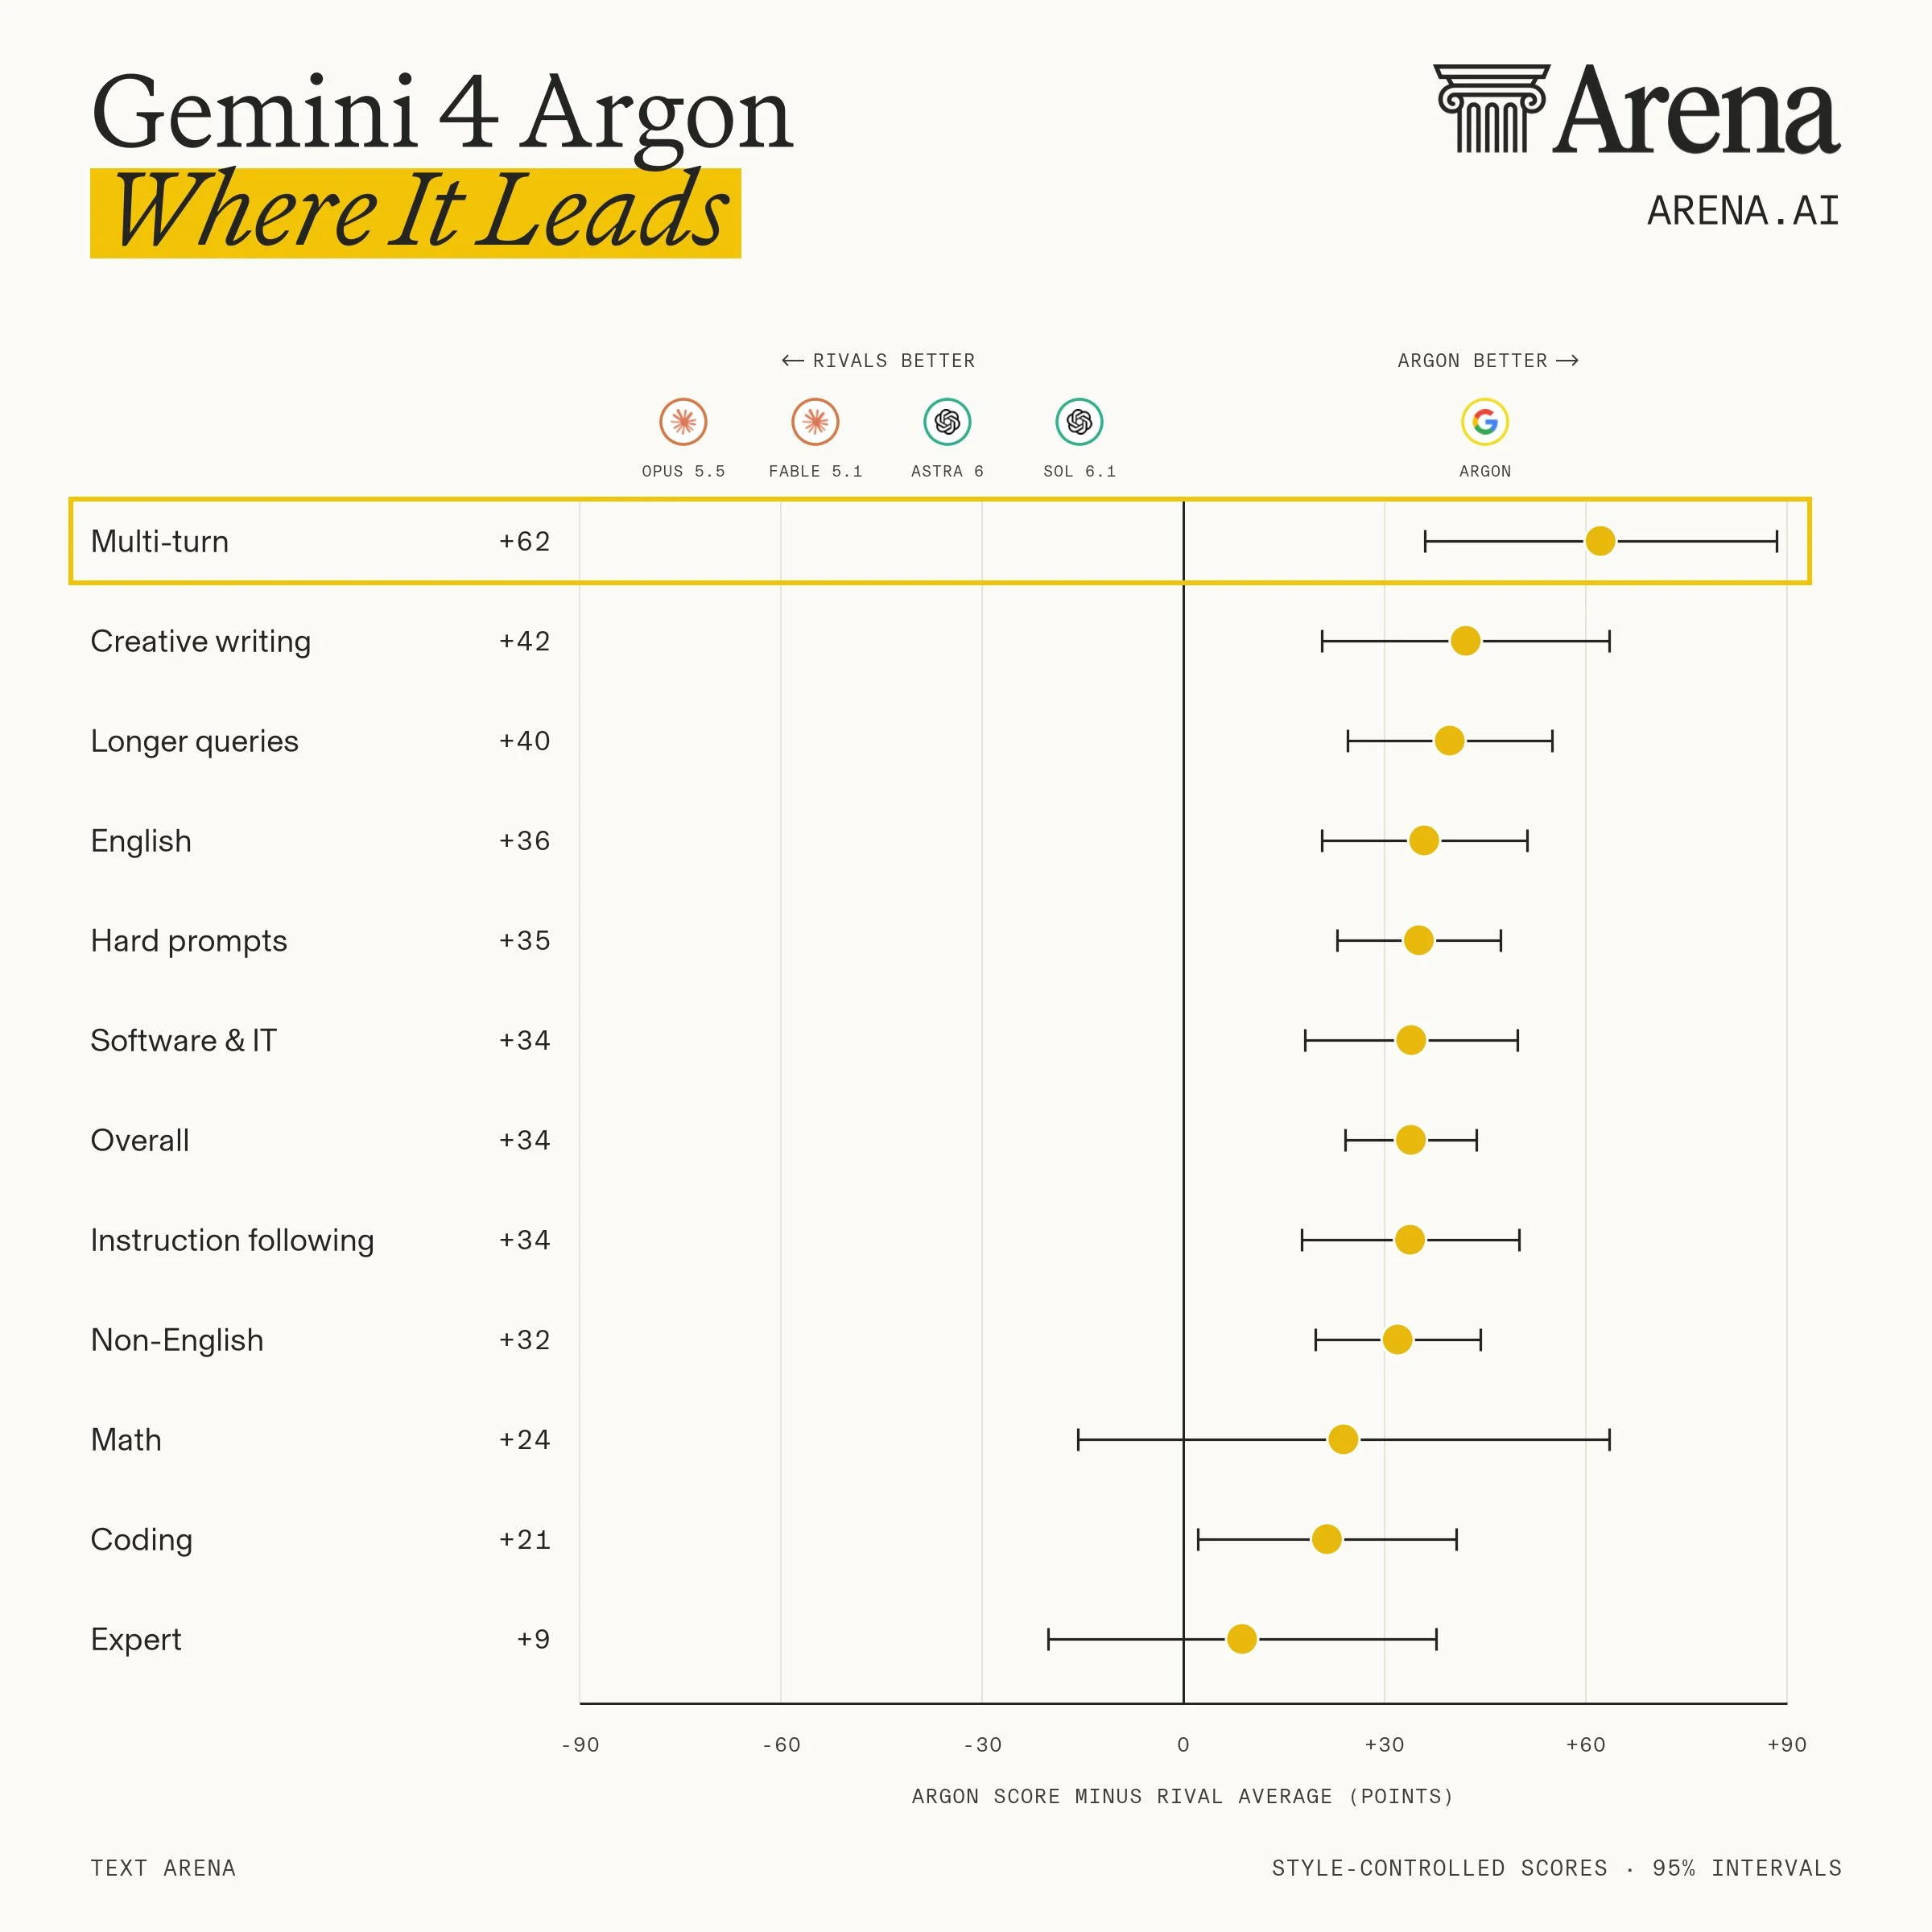
– تظهر هذه السلوكيات في أصوات المستخدمين. لدى أرجون ميزة قوية في الدردشات المتعددة الجولات (+62 نقطة)، والكتابة الإبداعية (+42)، والاستفسارات الطويلة (+40)، وهي الفئات التي يكون فيها الشخصية مهمة للغاية.
- أوضح علامات على أسلوبه القابل للتقبل هي استخدام علامات الاستفهام (حوالي 3 مرة في Opus 5.5 و5 مرات في GPT-6.1 Sol)، والإشارة إلى المستخدم (24 مرة لكل 1000 كلمة، مقابل 19-20 مرة للمنافسين)، والإشارات التوجيهية (56% من إجاباته، مقابل 41-42% لـ Claude و22-23% لـ GPT النماذج).