
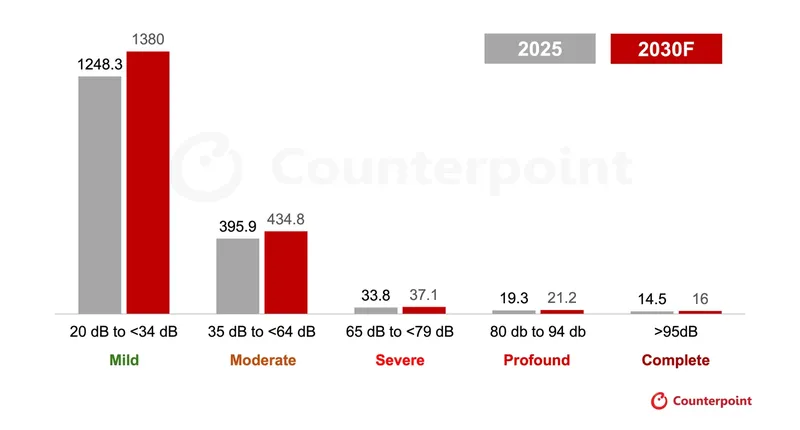
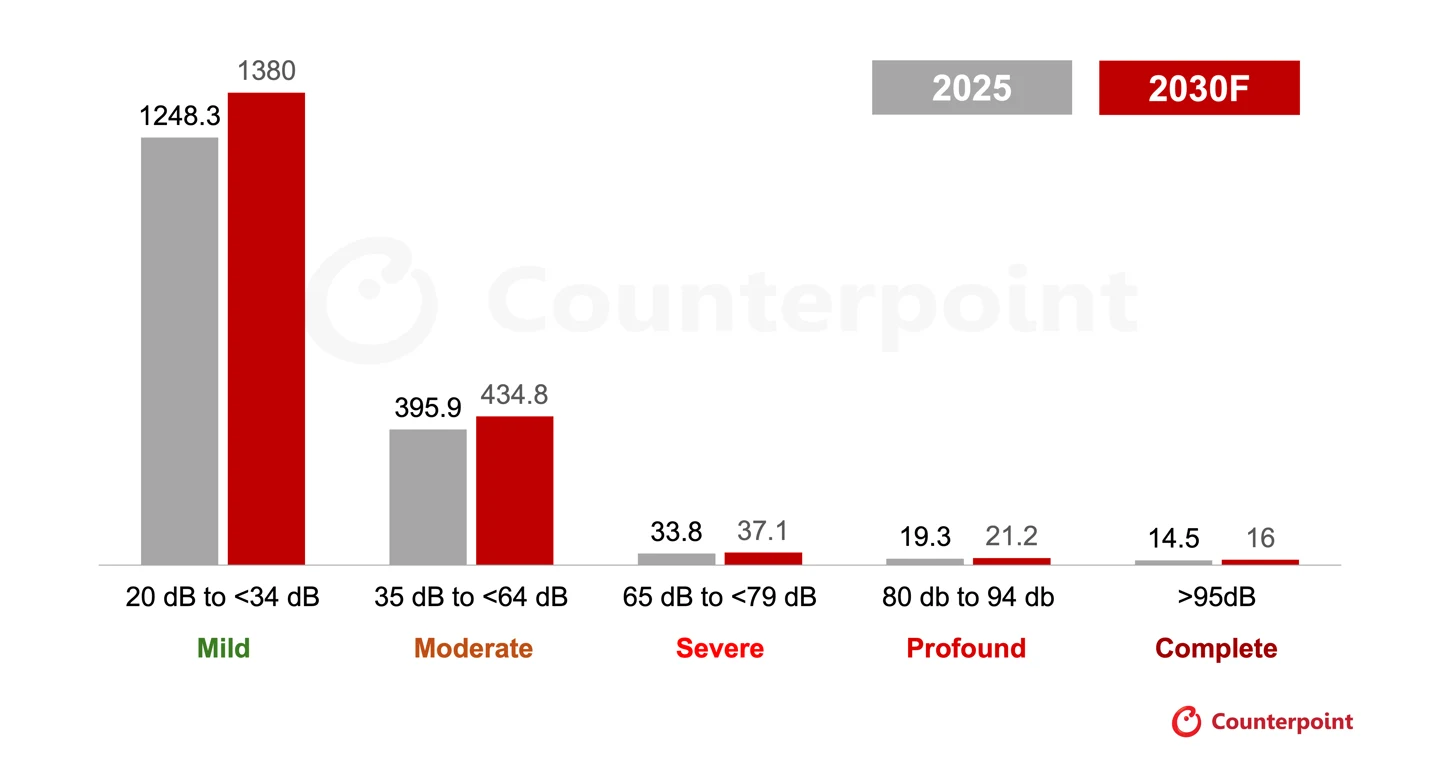
IT之家، في أحدث تقرير بتاريخ 14 أكتوبر، يشير تقرير Counterpoint “توقعات أجهزة الذكاء الاصطناعي القابلة للارتداء العالمية” إلى أنه بحلول عام 2030، من المتوقع أن يتجاوز حجم مبيعات أجهزة السمع الصحية في العالم 31 مليون جهاز، مع نسبة نمو سنوية متوسطة تبلغ 4% بين عامي 2025 و2030. ومع انتشار استخدام الذكاء الاصطناعي في مجال أجهزة السمع، من المتوقع أن يشتمل ما يقرب من 50% من منتجات أجهزة السمع على قدرات الذكاء الاصطناعي على الجانب الطرفي بحلول عام 2030.
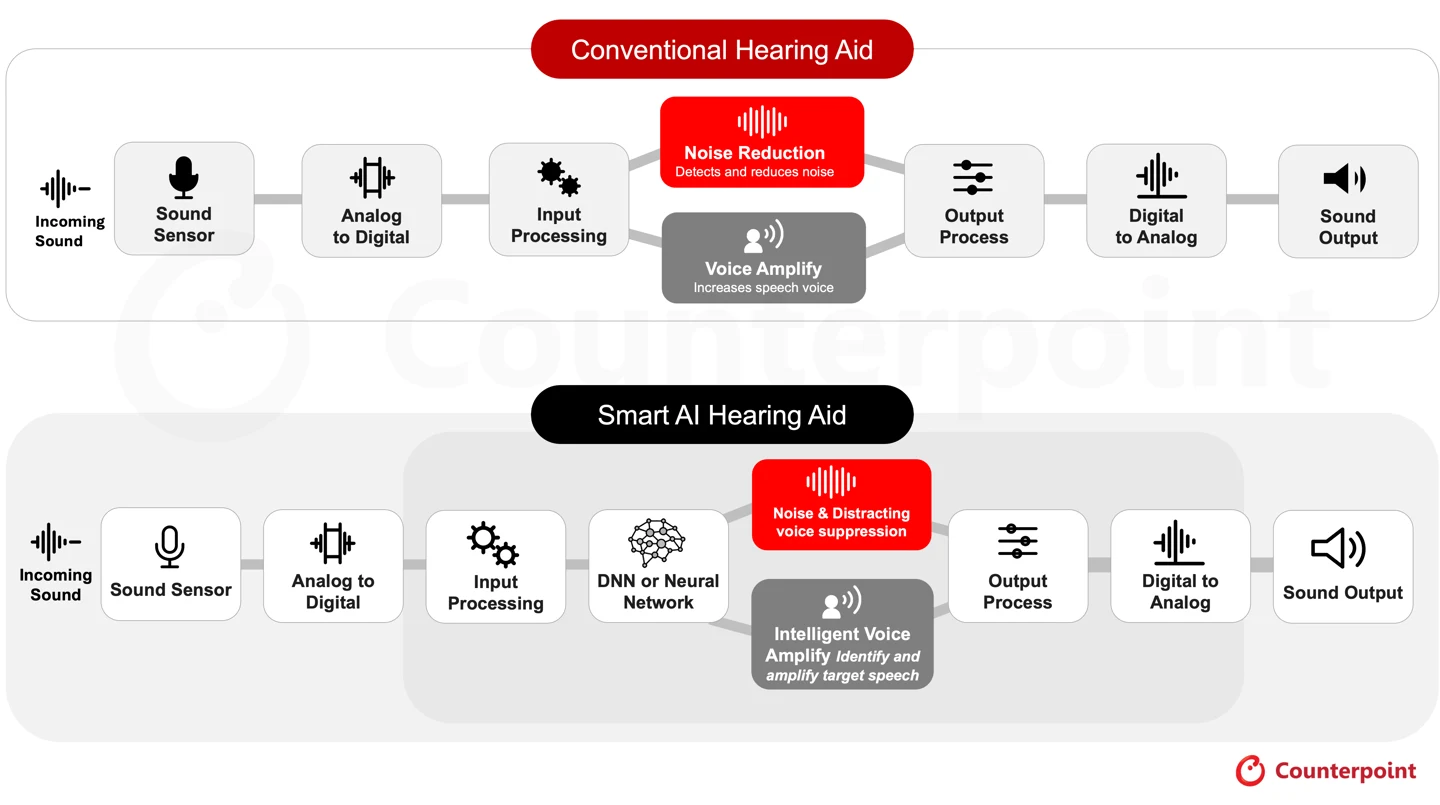
على مدى سنوات، تقدمت أجهزة السماعات الصوتية في تصغير الحجم والاتصال والبطارية، لكن المشكلة الأساسية لا تزال قائمة: من الصعب على المستخدمين سماع الحوارات في بيئات صاخبة. تعتمد أجهزة السماعات التقليدية بشكل رئيسي على معالجة الإشارات الرقمية (DSP): حيث يقوم الميكروفون بجمع الأصوات البيئية، ويحلل المعالج الترددات ودرجة الصوت وغيرها من الخصائص، ثم يحدد باستخدام خوارزميات مُعدة مسبقًا أي أصوات يجب تضخيمها أو تقليلها. تعمل هذه الطريقة بشكل فعال على الضوضاء المستقرة مثل التكييف والمحركات، لكن السيناريوهات الواقعية غالبًا ما تكون أكثر تعقيدًا. مثل وجود عدة حوارات وصوت موسيقى وضوضاء اصطدام الأدوات في مطعم مزدحم، فمن الصعب على النظام القائم على القواعد تحديد الصوت الذي يريد المستخدم سماعه بالفعل.
تقدم الذكاء الاصطناعي حلولًا مختلفة تمامًا: لا تعتمد نماذج الذكاء الاصطناعي على قواعد محددة مسبقًا، بل يمكنها من خلال التعلم التمييز بين صوت الإنسان وصوت الأصوات الأخرى. وبفضل الشبكات العصبية المتقدمة (DNN) التي تم تدريبها على ملايين مجموعات من عينات صوت الإنسان والضوضاء الخلفية، يمكنها التعرف على صوت المتحدث في الوقت الحقيقي، وكبح الضوضاء غير المرغوب فيها.
يمكن للذكاء الاصطناعي تحسين قدرة أجهزة السمع الصوتية على التعرف على الكلام في البيئات الحقيقية، وذلك من خلال فصل الصوت البشري عن الضوضاء، وإبراز المتحدث المستهدف بشكل أولوي، وتحسين الإدراك المكاني، بالإضافة إلى التكيف المستمر مع التغيرات البيئية. تتمتع الذكاء الاصطناعي بشكل خاص في التمييز بين الحروف الدقيقة والمرتبطة بالصوت مثل «s» و«f» و«t» و«sh» و«th»، كما يمكنها مساعدة الناس على التمييز بين الأرقام مثل 15 و50، و17 و70 (حسب ملاحظة موقع IT之家: نطق الكلمتين الإنجليتين «fifteen» و«fifty» متشابهان)، ومن خلال الحفاظ على هذه الخصائص الصوتية الدقيقة، لا يمكن للذكاء الاصطناعي فقط تضخيم الصوت، بل يعزز أيضًا قدرة الفهم الصوتي الفعلي في بيئات مثل المطاعم والاجتماعات والشوارع المزدحمة.
في اختبارات “تعرف على الكلام في الضوضاء” السريرية، يحتاج المستمعون الذين لديهم سمع طبيعي عادةً إلى نسبة إشارة إلى ضوضاء تبلغ حوالي 2 ديسيبل لتحديد الأفكار الرئيسية بنجاح بنسبة 50%؛ أما بالنسبة للمستمعين الذين يعانون من ضعف سمع حسّي عصبي خفيف إلى متوسط، فإن هذا الحاجة يزداد إلى حوالي 8 ديسيبل، ويمكن للذكاء الاصطناعي أن يوفر تحسناً قابلاً للقياس في نسبة إشارة إلى ضوضاء. وفقًا لاختبارات Phonak، فإن استخدام الاتجاه الثابت نحو الميكروفون مع الإعدادات التقليدية يزيد من نسبة التردد إلى الضوضاء بنسبة 6.4 ديسيبل مقارنة بالميكروفون الاتجاهي الكامل؛ وبإضافة تقنية إزالة الضوضاء بالذكاء الاصطناعي، يصل التحسن في الإعدادات الافتراضية إلى 9 ديسيبل، بينما يصل إلى 10.2 ديسيبل في الإعدادات الأقصى، وهو ما يكفي للتواصل بسلاسة في بيئة المطعم.
يمكن للذكاء الاصطناعي أيضًا جعل أجهزة السمع أكثر آلية وشخصية: يمكن لفن التقنية أن يتكيف مع تفضيلات المستخدم وأجواء الاستماع لتعديل معالجة الصوت، مما يقلل من التعديل اليدوي ويخفف العبء المعرفي اللازم لمتابعة الحوار، وبالتالي يقلل من التعب الناتج عن الاستماع ويتحسن ثقة المستخدم في التواصل اليومي. لكن هذه التحسينات لا تخلو من تكاليف: يعتمد تشغيل الشبكات العصبية الاصطناعية المستمر على شحن البطارية واستخدام مساحة الجهاز، لذلك فإن أقوى أجهزة السمع الذكية حاليًا توفر عادةً عددًا قليلًا من الخيارات.
تتطلب أجهزة السمع الصوتية متطلبات عالية للغاية فيما يتعلق بانتظار المعالجة: من جمع الصوت إلى اكتمال المعالجة ومن ثم إرساله إلى الأذن، يجب ضبط العملية بأكملها ضمن 10 مللي ثانية أو أقل لضمان تجربة طبيعية، وهذا يخلق فرقًا جوهريًا بين أجهزة السمع الصوتية ومعظم أجهزة الذكاء الاصطناعي — يمكن للهواتف الذكية تحميل البيانات إلى السحابة وانتظار نتائج الذكاء الاصطناعي للمعالجة، لكن أجهزة السمع الصوتية لا تستطيع تحمل تأخير في العودة والإرسال عبر السحابة، حتى التأخير البسيط قد يؤدي إلى اختلاط الصوت عند المستخدم أو جعل صوته يبدو غير طبيعي.
لذلك، يتطلب معالجة الصوت في الوقت الفعلي أن تعمل الذكاء الاصطناعي على جهاز السماعة المحلي، وليس على هاتف المستخدم أو السحابة، وهذا هو القيمة الأساسية للذكاء الاصطناعي المحلي: يتم تحليل الصوت وتعريفه محليًا بالقرب من الميكروفون والجهاز المستقبل.
المشكلة تكمن في أن سعة بطارية جهاز التسجيل الصوتي نفسه صغيرة جدًا، وقدرته الحسابية محدودة، بالإضافة إلى قيود الحجم الصارمة. لكي يتم دمج قدرات الذكاء الاصطناعي في هذا النوع من الأجهزة، يجب تحسين نماذج الذكاء الاصطناعي والمعالجات بشكل كبير، حتى يمكن تقليل استهلاك الطاقة إلى الحد الأدنى أثناء تحقيق فصل الصوت وتقليل الضوضاء. ستقلل تشغيل الشبكات العصبية الاصطناعية المستمرة من عمر البطارية بشكل كبير: على سبيل المثال، في طراز Peugeot Audéo Infinio Ultra Sphere 2025، يبلغ عمر البطارية عند الاستخدام العادي 56 ساعة، بينما ينخفض إلى 10 ساعات إذا تم تشغيل وظيفة الذكاء الاصطناعي بشكل مستمر، وهذا يوضح بوضوح تكلفة تشغيل الذكاء الاصطناعي محليًا.
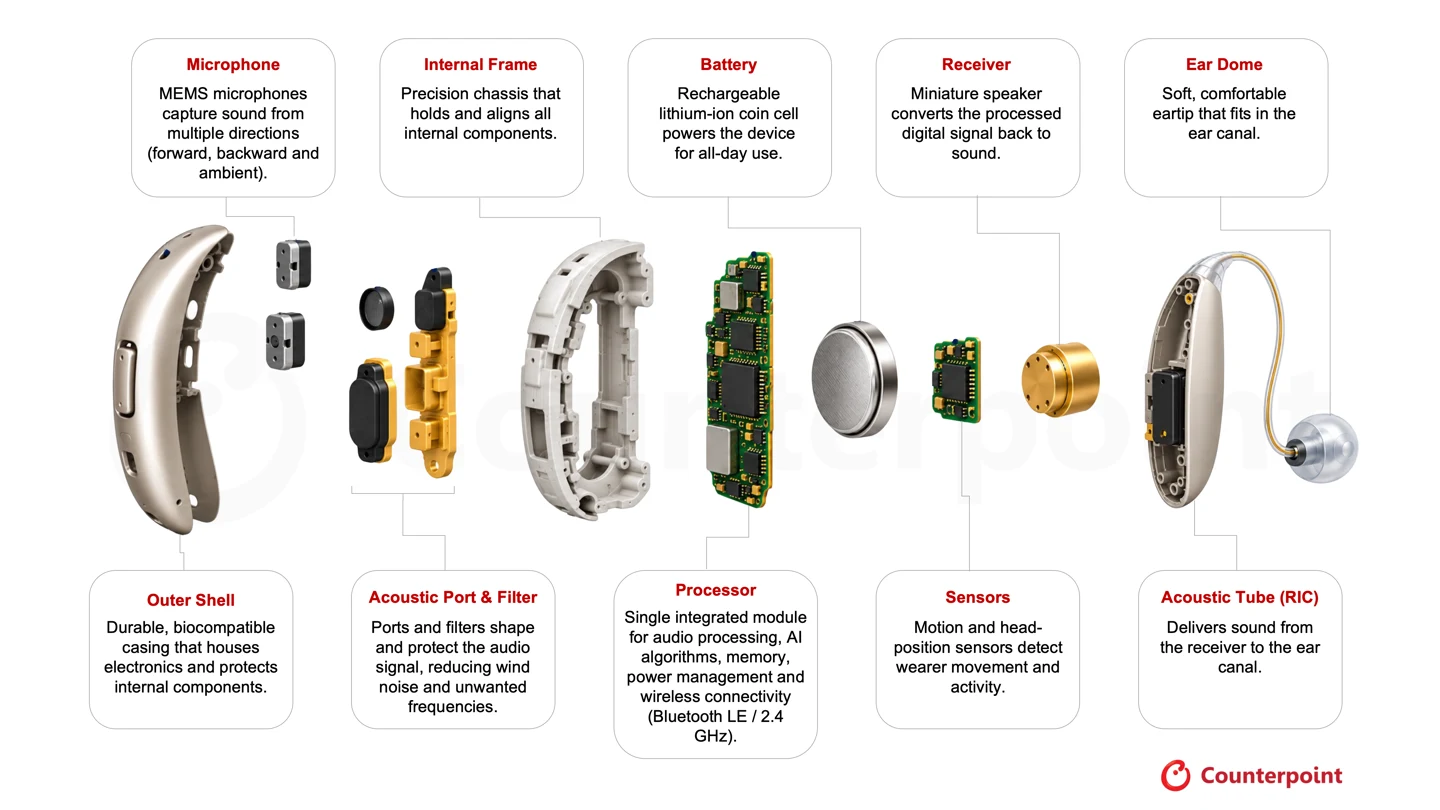
إن تكامل الذكاء الاصطناعي على الجانب الطرفية يجعل السمعات أكثر "ذكاءً"، لكن التكامل الفعال هو الصعوبة الرئيسية في البحث والتطوير: كل تحسين في وضوح الصوت يتطلب تكلفة من الطاقة المتاحة والمساحة، وتظهر بيانات منتجات فولكس-موتورز بوضوح هذا التكلفة. القدرة التنافسية الأساسية للسماعات السمعية الجديدة تكمن في كيفية تمكين الذكاء الاصطناعي من العمل بهدوء في الخلفية، دون استهلاك الكثير من الطاقة أو زيادة حجم الجهاز، بينما توفر صوتًا أكثر وضوحًا وأقل عبئًا للسماع، وتجربة سمع أكثر تخصيصًا. وقد بدأت الصناعة بالفعل في هذه المنافسة التقنية.