
يونينغ، من معبد باوفي
كوانتوم بيت | الحساب العام QbitAI
مع زيادة كمية البيانات المجمعة، هل يمكن للروبوتات أن تصبح أكثر قدرة على العمل؟
هذا العام، من بيانات التشغيل البشرية التي تزيد عن 20000 ساعة التي يستخدمها EgoScale، إلى التدريب المسبق للمليون ساعة لـ Dyna-2، تزداد نطاق تعلم الروبوتات من السلوك البشري.
استخدمت الدراستان الاثنتان مسارات تدريب مختلفة للنماذج، لكنهما كلتاهما تسعيان لإيجاد إجابة على سؤال: هل يمكن للبيانات التشغيلية البشرية أن تتجاوز الحدود التي تحققها أجسام الروبوتات، وتوفر أساسًا لتعلم الروبوتات لمهام أكثر؟
تتبعها أسئلة إضافية: عندما يحتاج الروبوت إلى المشي أو الانحناء أو تنسيق اليدين لتنفيذ المهمة، كم من المعلومات حول التفاعل بين الجسم والبيئة يُحفظ في البيانات الساعية؟
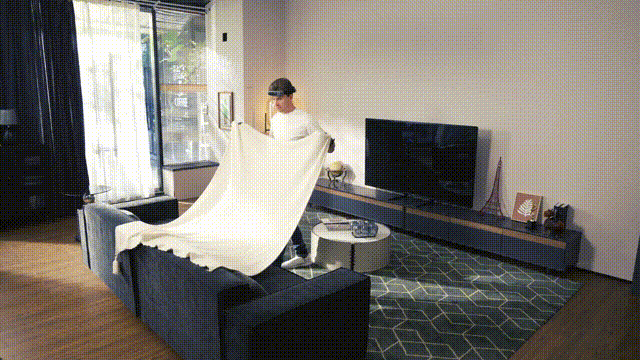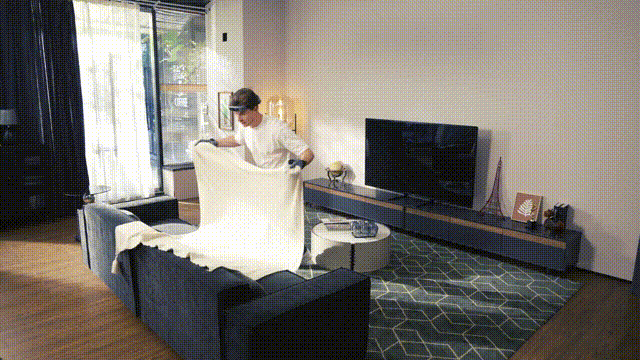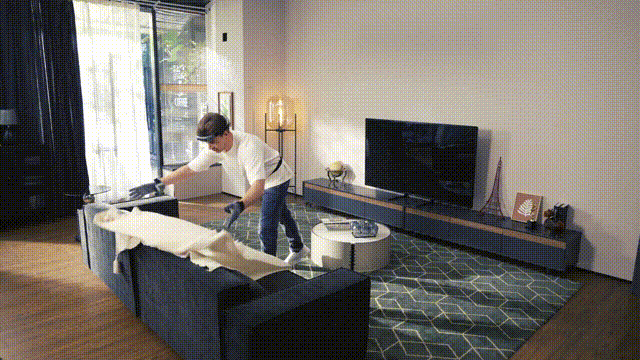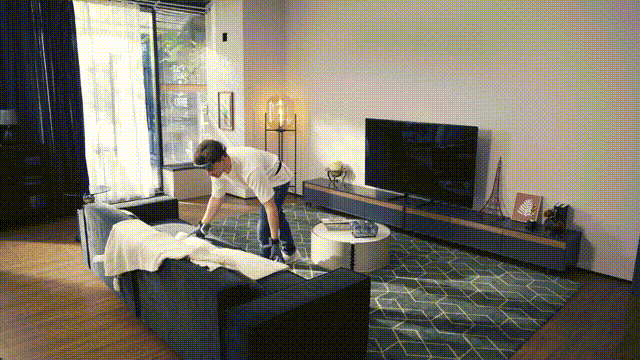
أخذ حزمة، يجب على الشخص أن يذهب أولاً إلى المكان المناسب، ثم ينحني ويمد يده لالتقاط الحزمة، وبعد ذلك يضبط وضعية جسده لرفع الحزمة. يجب التحرك بجانب السرير وتسوية الغطاء، ويجب أيضًا تنسيق مستمر بين حركات القدمين والذراعين وقوة الاتصال.
في بيانات Ego التي تعتمد بشكل أساسي على الصورة، يمكننا رؤية ما قام به الإنسان، لكن ليس بالضرورة أن نلاحظ الحالة الجسدية الكاملة وراء هذه الأفعال.
إذا احتاج الروبوت في المستقبل إلى تعلم التحكم الدقيق في حركة الجسم بأكمله، فإن معرفة كيفية استخدام اليدين فقط قد لا تكون كافية.
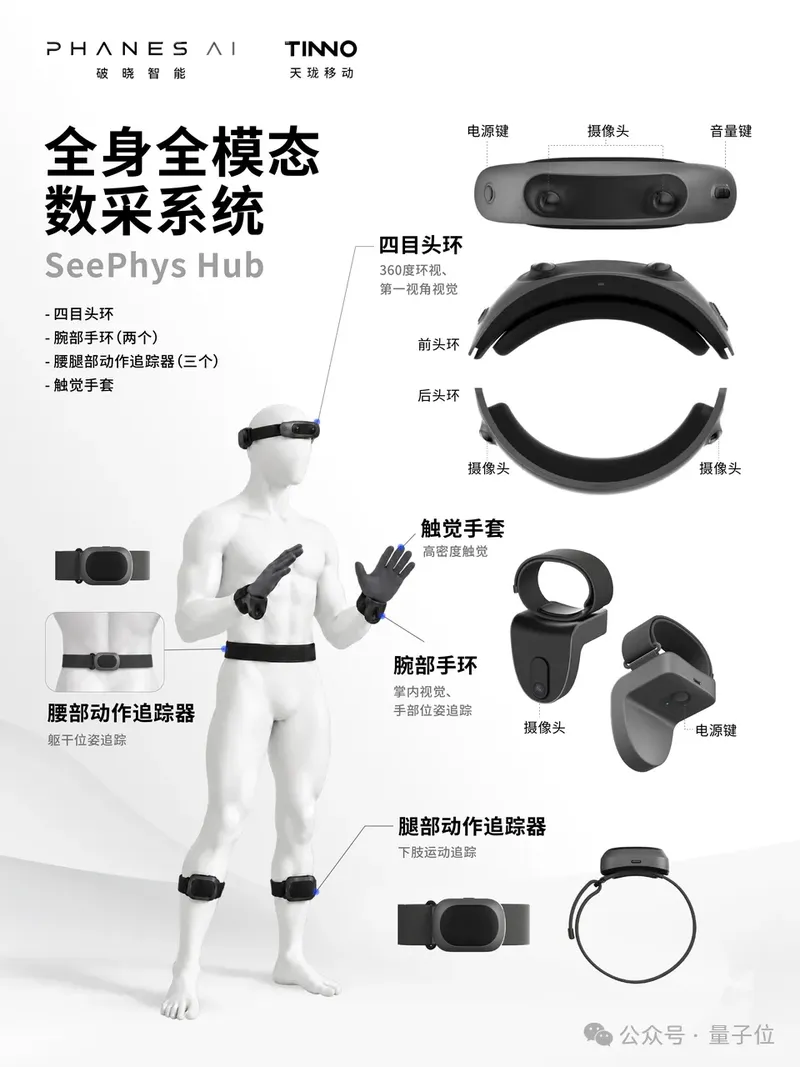
في 14 أكتوبر، أصدرت شركة بوشاو ذكية وشركة تيانلونغ المتنقلة نظام جمع البيانات للحركة الكاملة SeePhys Hub، في محاولة لإضافة هذه المعلومات إلى Ego.
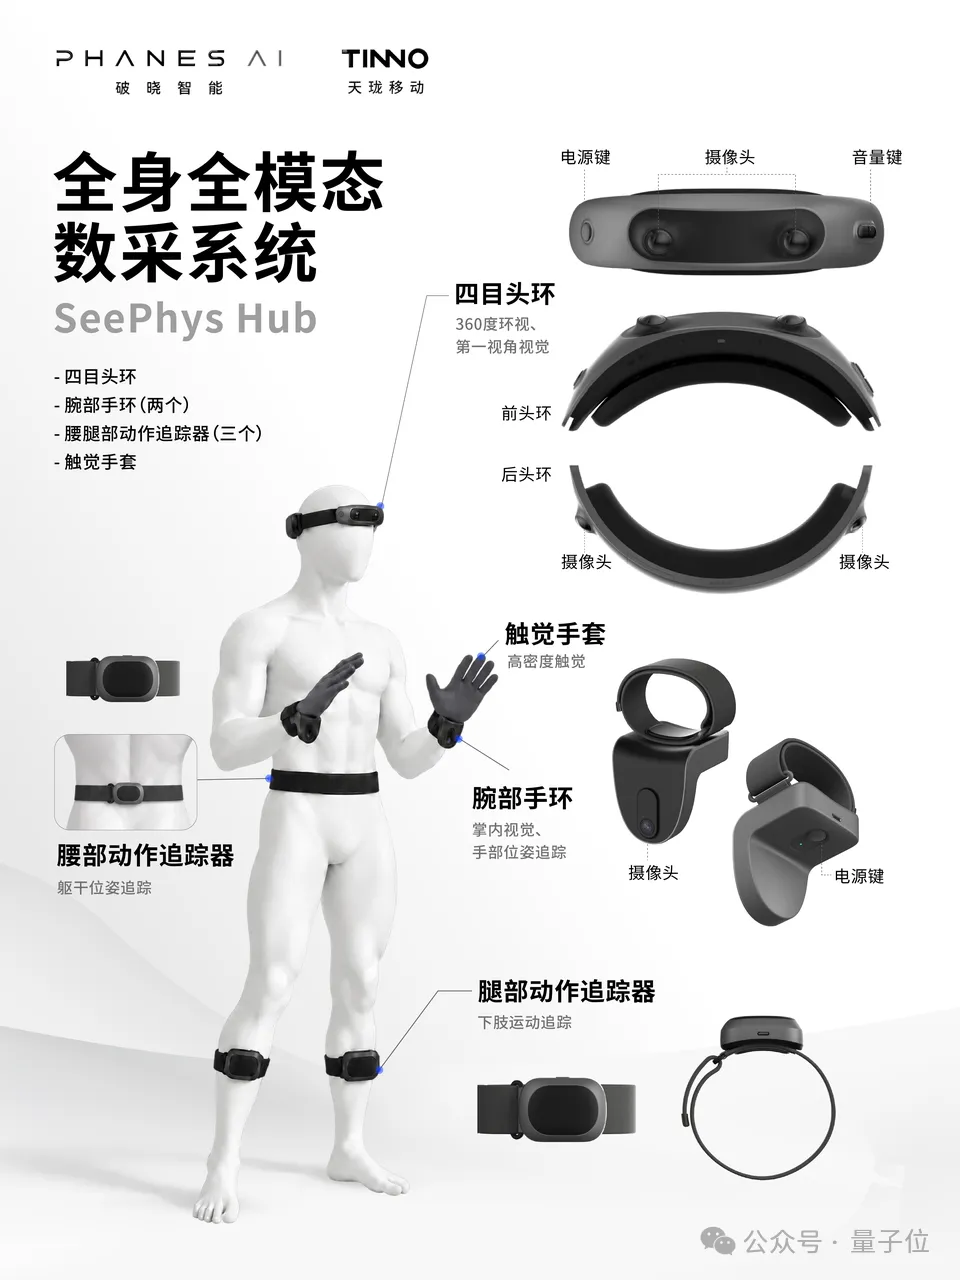
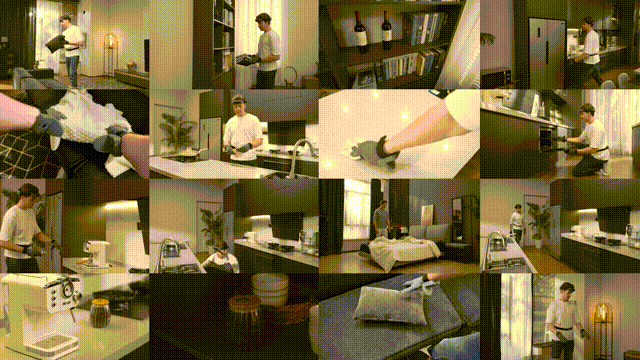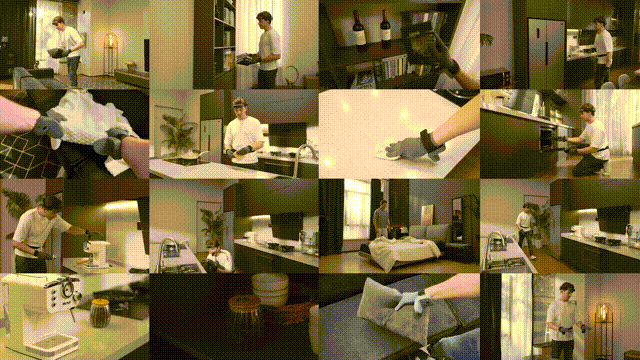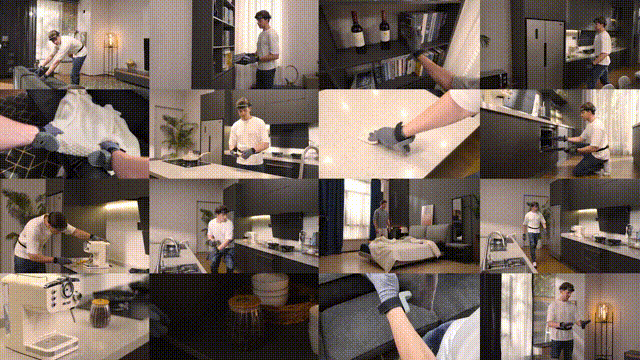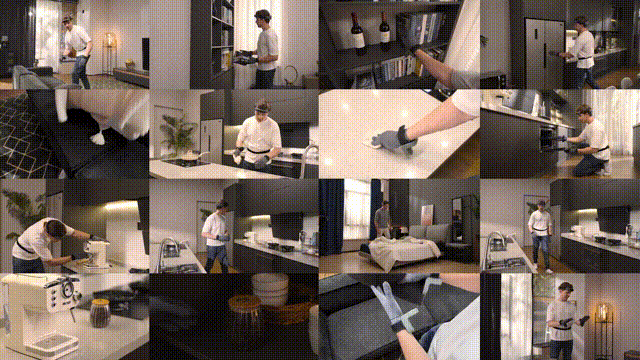
يتكون الجهاز الكامل من حلقة رأس بأربعة عينات، واثنين من الحلقات على المعصمين، وثلاثة أجهزة لتتبع حركات الخصر والساقين، ومجموعة من القفازات اللمسية. يعيد الجهاز استعادة الوضعية الكاملة للجسم من خلال دمج الإشارات البصرية والحركية، ويجمع ضغط الضغط عند الاتصال باليدين وفقًا لاحتياجات المهمة.
إنه يأمل في الحفاظ على مزايا النقل السهل والخفيف لـ Ego، بالإضافة إلى سهولة التجميع على نطاق واسع، وفي الوقت نفسه استعادة المعلومات المتعلقة بالحركة الجسدية والملمس التي تبعد عن الرؤية.
بالنسبة لشركة بورشاو إنيجليتي، ليس الأمر مجرد إضافة عدة أجهزة استشعار، بل هو البحث عن طريقة جمع بيانات دقيقة الجودة ولكن بتكلفة جمع مرتفعة، وبين بيانات Ego الخفيفة ولكن المعلومات فيها محدودة نسبيًا،.
سجل حركات الجسم و"الإحساس باليد" معًا
بيانات جمعت من وجهة الرؤية الأولى، أي بيانات Ego، أصبحت مصدرًا مهمًا لجمع بيانات الـ Embodied.
إيغو جذاب للغاية، حيث يرتدي الشخص الجهاز، ويقوم بعملية التشغيل في سياقات يومية، وتتبع الكاميرا الشخص، ولا يجب أن تتم جمع البيانات دائمًا حول الجسم الفعلي للروبوت.
لكن بالنسبة للمهام التي تتطلب الحركة والتعاون الجسدي الكامل، فإن تسجيل الصور الواردة أمام العين فقط سيؤدي إلى إغفال بعض الحالات الأساسية الرئيسية.
على سبيل المثال، عندما يمد الشخص يده للوصول إلى شيء على ارتفاع عالٍ، يجب تعديل الكتفين والذراعين والجسم معًا. يمكن لكاميرا وجه الوجه الأول التقاط اليدين، لكن ليس بالضرورة أن يتم رؤية مواقع المرفقين والأرجل. عندما يحدث حاجز جسدي أو حاجز الأشياء أو منطقة عمياء في الزاوية، يصبح تقدير وضع الجسم بأكمله أكثر صعوبة.
على الرغم من أن يمكن تقدير هذه الحركات من خلال الفيديو، إلا أن موثوقية التقدير تصبح مشكلة كبيرة عند مواجهة حواجز الجسم نفسه، أو حواجز الأجسام، أو مناطق العماء في المنظور.
حل مشكلة SeePhys Hub هو إضافة عدد قليل من نواتج التتبع في المواقع الرئيسية للجسم البشري.
SeePhys Hub يستخدم نظام العقدة النادرة، حيث يتم تركيب ثلاث أجهزة تتبع الحركة في منطقة الخصر والساقين، ويتم دمج معلومات الرؤية للرأس ومعلومات المعصمين لاستعادة الوضعية الكاملة للجسم من خلال خوارزمية. توفر أجهزة IMU الإشارات المتعلقة بالحركة، بينما توفر UWB معلومات المسافة بين العقدة، ويتم دمجها مع الرؤية لتقدير الوضعية الكاملة للجسم.
تم توسيع نطاق التغطية البصرية أيضًا. يوفر حلقة الرأس ذات الأربعة عيون رؤية شاملة بزاوية 360 درجة، بينما تكمل الكاميرات في المعصم التفاصيل عند التعامل عن قرب. وتسجل القفازات اللمسية المختارة التغيرات في الضغط عند اتصال اليدين بالأشياء. يتم تسجيل معلومات البصر والحركة الجسدية واللمس بشكل متزامن، مما يعيد بوضوح عملية التعامل الحقيقية للإنسان.
قدم فريق البحث والتطوير مثالًا: بعد أخذ الزجاجات من الثلاجة، يميل الشخص ليغلق الباب، ولا تزال الكاميرا خلف رأسه تسجل هذه الحركة. عملية التحكم التي يقوم بها الإنسان في السيناريو الحقيقي تحدث غالبًا من خلال هذا الانعطاف والحركة وتغير الزاوية.
وأسفل ذلك، يوجد "الإحساس باليد".
أخذ حبة عنب، بعد اللمس يجب الاستمرار في الضغط، أم التوقف وتعديلها برفق؟ يقوم الإنسان بتصحيح حركته باستمرار بناءً على الضغط الفعلي لللمس. تسجل قفازات اللمس الضغط الناتج عن اللمس، مما يعطي الحركة في الفيديو إشارة فيزيائية مقابلة.
بالنسبة للنموذج، هذه المعلومات توفر فرصة لمساعدته على فهم العلاقة بين حركة الجسم، والتلامس باليدين، وتغيرات البيئة. الهدف الذي يأمل الفريق في تحقيقه هو زيادة كمية المعلومات المفيدة التي يمكن توليدها من بيانات التشغيل كل ساعة.
يجب أيضًا تطابق الإشارات المتعددة في نفس اللحظة. في الفيديو، عندما يلمس اليد الشيء، يجب أن يتوافق ذلك مع التغيرات في الضغط وحالة الحركة، حتى يمكن تحليل العملية التفاعلية الكاملة. وفقًا لمعلومات المنتج، فإن دقة التزامن للكاميرا داخل حلقة الرأس، وIMU، وUWB لا تتجاوز 0.5 مللي ثانية. هذا الجزء الهندسي غير واضح، ويؤثر أيضًا على ما إذا كانت البيانات من الأشكال المختلفة يمكن أن تتم توصيلها بشكل فعال.
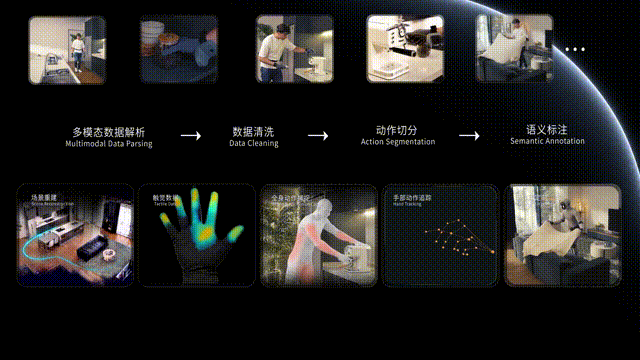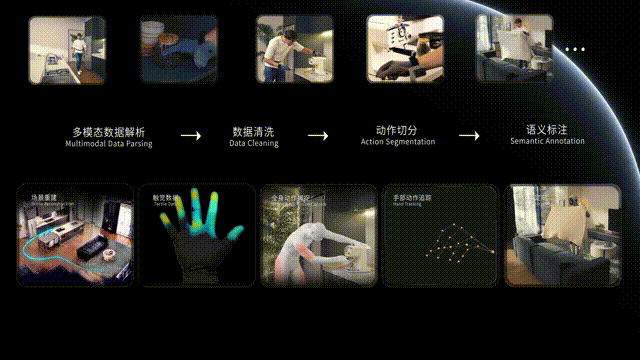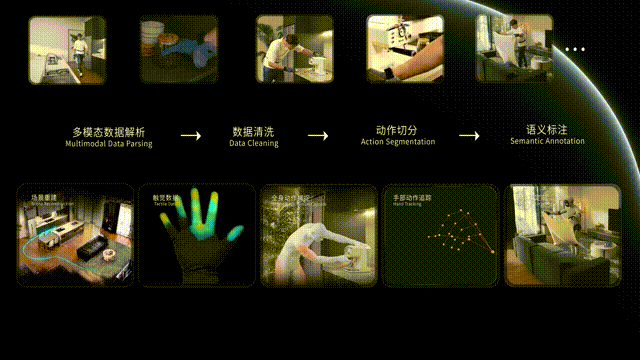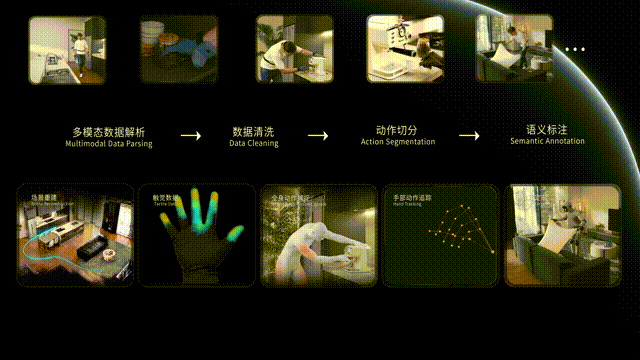
بعد جمع البيانات، يوجد خطوة معالجة أخرى. تقوم المنصة المصاحبة لـ SeePhys Hub بتحليل وتنقية والأتمتة وتصنيف المعنى، كما تربط بين إعادة بناء السيناريو وتقدير الوضعية وتتبع اليدين. ويقوم إعادة توجيه الحركات بتحويل حركات الإنسان إلى الجسم الروبوتي، مما يوفر الدعم للتدريب والتكيف اللاحق.
ليس من الأفضل أن يكون هناك المزيد من أجهزة الاستشعار، فالجمع على نطاق واسع يتطلب اختيارات هندسية جديدة.
بالطبع، يمكن لحالة البيانات الجديدة توفير المزيد من الأدلة، لكن جودة البيانات وقابليتها للاستخدام تعتمد أيضًا على كيفية جمعها، ويعود الأمر إلى التصنيع والمنتج مرة أخرى.
اختيارات المنتج التي يقدمها الفجر تتم على أساس عدد قليل من العقد مع دمج الخوارزمية. وزن الحلق لا يتجاوز 220 جرامًا، ولا يتجاوز وزن حلقة المعصم الواحدة 75 جرامًا. وضع الفريق الوزن الخفيف والتكلفة والحرية في التحرك داخل السيناريوهات الحقيقية في مكان مهم في تصميم المنتج.
وهذا يفسر أيضًا مكانته في خطة الجمع.
في الهرم البيانات ثلاثي الطبقات الذي وصفه يانغ شو، مؤسس ومدير التسويق في الفجر المبكر,الطبقة الأسفل تتمثل في مقاطع الفيديو عبر الإنترنت بكميات كبيرة، حيث يتم تعزيز المعلومات الخاصة بالوضعية واللمسة من خلال خوارزميات؛ أما الطبقة العليا فهي تحتوي على بيانات دقيقة للتقاط الحركة وتشغيل الآلات الحقيقية؛ ويهدف SeePhys Hub إلى الطبقة الوسطى، حيث يحاول توفير إمكانية جمع واسع النطاق وسجل تفاعل أكثر شمولاً.
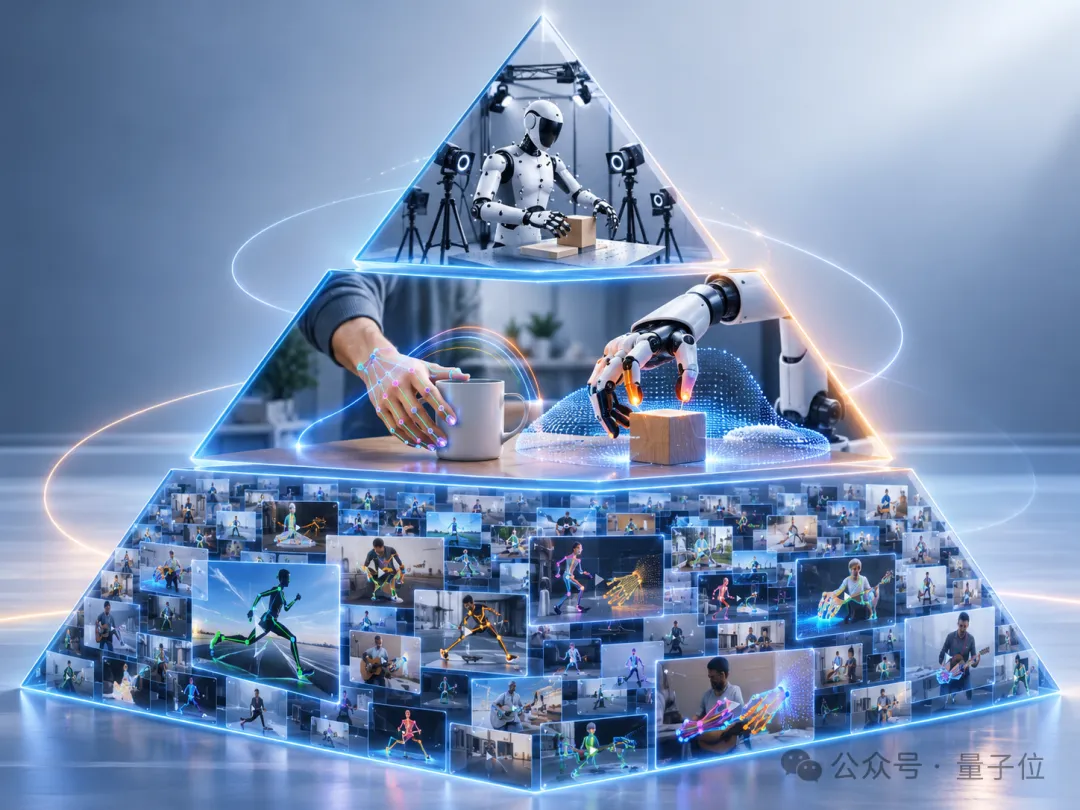 △الصورة تم إنشاؤها بواسطة الذكاء الاصطناعي
تقوم كل طبقة بمهمة مختلفة. يمكن استخدام بيانات الحركة والالتقاط للإشراف على تقدير الوضعية، بينما تساعد بيانات الأجهزة الحقيقية النموذج على التكيف مع الروبوتات، وتوفر مقاطع الفيديو البشرية المزيد من السيناريوهات والعمليات. ما يُضاف من أجهزة الارتداء هو القدرة على الدخول إلى بيئات حقيقية وتسجيل الأحداث مع الناس بشكل مستمر.
تتميز قفازات اللمس بتصميم اختياري، وهي أيضًا نتاج نفس الاعتبارات الهندسية.
وفقًا لما قاله يانغ شو، تواصل الفريق مع بعض جهات جمع البيانات والتشغيل، وكانت المطلب الأول الذي طلبوه منا هو عدم السماح لأفرادنا بارتداء القفازات.
لأنه عند مواجهة سيناريوهات معينة تتعلق بتفريش الأطباق والتي تتطلب الحماية من الماء، فإن التحكم الدقيق يتأثر بارتداء القفازات، وقد تظهر الضوضاء في أجهزة الاستشعار نفسها. لقد واجه الفريق في الاختبارات حالة حيث أخذ القفازات قطعة من الماء بعد عدة مرات، وظلت القفازات الفارغة تُظهر ضغطًا جزئيًا عند فتحها.
يمكن أن يزيد هذا النوع من الضوضاء من صعوبة المعالجة والتدريب اللاحقة. إذا أثرت الأجهزة التي يتم ارتداؤها على عمليات الإنسان، فإن ذلك سيؤثر أيضًا على قيمة السجلات.
لذلك، يمكن استخدام سوار وقفازات SeePhys Hub بشكل منفصل. يختار العملاء الإعدادات حسب المهمة، بينما يواصل الفريق دراسة كيفية تقدير الحس الحسي من خلال البصر، وتوسيع مصادر البيانات المتاحة.
لتوسيع الجهاز بشكل حقيقي، فإن سلسلة التوريد والضمان النوعي أيضًا أمر مهم. في هذه الشراكة، تركز بوشياو على تصميم المنتج والخوارزميات، بينما يقدم تيانلونغ للتحرك خبرات في تحقيق التكلفة المثلى وسلسلة التوريد والضمان النوعي.
تتمحور الخدمات التجارية أيضًا حول قدرات العملاء. وفقًا للتخطيط الفريقي، يمكن للعملاء الذين لديهم قدرة على الخوارزميات شراء الأجهزة والمعالجة الذاتية للبيانات؛ أما العملاء الذين يحتاجون إلى حل شامل، فيمكنهم اختيار الخوارزميات المصاحبة والتركيب المحلي؛ وفي سياقات مثل البحث العلمي، يمكن استخدام منصات السحابة للحصول على البيانات المعالجة.
مزودو جمع البيانات، فرق نماذج الجسم، الجهات المختصة بالسيناريوهات، والمؤسسات العلمية، كلها هي المستخدمون الذين يهدف إليهم الفريق.
في نظر يانغ شو، تشمل المخزونات وراء الأجهزة أيضًا خوارزميات تقدير الوضعية، بالإضافة إلى البيانات المقابلة المستخدمة لتدريب واختبار الخوارزميات. يجب أن يعمل الأجهزة الصلبة والخوارزميات ومعالجة البيانات معًا، حتى يمكن تحويل أجهزة الاستشعار الموجودة على الجسم إلى سجلات تشغيل قابلة للتدريب.
فريق يعمل على نماذج عالمية، لماذا يقوم أولاً بجمع البيانات؟
"هدفنا النهائي يجب أن يكون تحسين النموذج." هذا هو الرد الذي قدم يانغ شوو عند الحديث عن سبب تطوير أجهزة جمع البيانات.
لكن هذا يثير الشكوك، فلماذا تختار شركة لتصنيع روبوتات الدماغ طريقًا "متدرجًا"، وتبدأ من البيانات والمعدات؟
في رأي يانغ شو، المشكلة تكمن بالضبط في ما类型 من البيانات يحتاجه النموذج. إذا أراد التجميع حركة الجسم واللمس باليد والتغيرات البيئية، فسيحتاج إلى سجلات العمليات المناسبة. البيانات المطلوبة صعبة الحصول عليها بتكلفة منخفضة وبشكل تجاري، لذلك اختار الفريق أن يسد هذا الفجوة بنفسه.
هذا الاختيار أيضًا يتعلق بخلفية البحث السابقة ليانغ شو وفريقه.
مؤسس شركة PHANES AI، يانغ شوو، ولد في عام 1998، وهو حاليًا أستاذ محاضر ومشرف على الدكتوراه في كلية علوم الكمبيوتر والتقنية بجامعة هاربين للتكنولوجيا (شنتشن).
قضى يانغ شو فترة طويلة في دراسة النماذج الكبيرة ذات الأشكال المتعددة، ودراسة الرؤية الحاسوبية والذكاء الشخصي، وفي سن الـ26 تم تعيينه كأستاذ جامعي مستمر في جامعة هاربين للتكنولوجيا (شنزين)، وكأستاذ مشرف على طلاب الدكتوراه، وهو أصغر الأستاذين المتميزين في مجال الذكاء الاصطناعي في البلاد.
منذ تأسيسها، أنشأت شركة بوشياو الذكية فريقًا يجمع بين الخبرة في دراسة النماذج والتصنيع الهندسي. ووفقًا للشركة، أكثر من 90% من الأعضاء الأساسيين تخرجوا من جامعات مثل جامعة تشينغهوا، وجامعة بكين، وجامعة هونغ كونغ، وجامعة هاربين للتكنولوجيا، وتشمل البحوث والممارسات الهندسية نماذج كبيرة متعددة الأشكال، والنماذج العالمية، ومعالجة البيانات الضخمة، وتطوير الأجهزة.
سابقًا، قام الفريق بسلسلة من الأبحاث حول جمع البيانات اللمسي، وتوسيعها والاستخدام لها.
في مايو 2026، تم نشر مجموعة بيانات EgoTouch ودراسة TouchAnything. تُسجل الأولى مقاطع الفيديو من وجه أولى، ووضعية اليدين، والضغط الحقيقي لللمسة بشكل متزامن، مما يسمح للنموذج بتعلم العلاقة بين البصر واللمس؛ بينما تحاول الدراسة الأخيرة تقدير منطقة اللمس وتوزيع الضغط من خلال الفيديو، لتوفير معلومات لمسية إضافية لبيانات البصر المتاحة.
عند وصولك إلى TouchWorld، تبدأ هذه “الإحساسات” في المشاركة في تحرك الروبوت. يقوم النموذج بتنبؤ الرؤية والأهداف التي يتم التلامس معها مسبقًا، وفي عملية التنفيذ يتم تصحيح الانحرافات بناءً على الإشارات الحقيقية لللمسة. إدخال المقابلات، مسح القدرات، استخراج الورق، كلها مهام حقيقية تُستخدم من قبل الفريق لاختبار الجهاز الفعلي.
SeePhys Hub سيوسع نطاق البحث من التلامس باليدين إلى الحركة الكاملة للجسم. بالنسبة للتحكم الدقيق في الحركة الكاملة للجسم، يحتاج الروبوت إلى فهم ليس فقط كيف تلمس الأيدي الأشياء، بل أيضًا كيف يتحرك الجسم وكيف يتم تعديل الوضعية، بالإضافة إلى النتائج الفيزيائية التي تنتج عن هذه الحركات.
هذه هي المحتويات التي يرغب نظام الفجر في تعلمها من خلال نموذج العالم الشامل للأشكال والطرق. وفقًا للخطة، يتوقع الفريق إطلاق نموذج العالم الشامل للأشكال والطرق في عام 2027، مع التركيز على اختبار التطبيقات في السيناريوهات المتخصصة مثل الصناعة وتجارة الطعام والتجزئة.
لكن، في المرحلة الحالية من فجر النهار، لا يُعتزم إنشاء جسم الروبوت الخاص بنا.
تفكير يانغ شو هو أن البيانات والنماذج وسياق التطبيق لا يزال يتغير. ما إذا كان الروبوت يجب أن يحمل أجسامًا ثقيلة أو حجم الحمل المطلوب، كل ذلك يؤثر على تصميم الجهاز الفعلي. تحديد الأجهزة المادية مبكرًا قد يحد من اتجاه الخوارزميات اللاحقة، وهو يسمي هذا المخاطر "تكلفة الغرق النقية".
لهذا السبب، يمكن وضع الأجسام الأصلية في مكانها لاحقًا. حاليًا، تستخدم الفريق نموذج الاختبار الخاص بالأجسام العامة، وتخطط للتعاون مع شركات الأجسام والمشاكل السينائية لإجراء تجارب تطبيقية؛ وسننتظر حتى تتضح احتياجات المشاكل السينائية والعائدات التجارية قبل أن نطلق أجسامنا الخاصة.
للنهار الباكر، لديه أيضًا تقييمه الخاص بشأن المنافسة في النماذج. يجب على الروبوتات في النهاية أن تكون قادرة على الإدراك والقرار والتنفيذ في الوقت الحقيقي في بيئة حقيقية، ويُطلب في العديد من الحالات تطبيقها على الجانب الطرفي. بدلاً من توسيع حجم المعلمات بشكل مفرط، كيفية تمكين النماذج ذات الحجم المحدود من امتلاك القدرة على التفاعل الفيزيائي وتحقيق الاستقرار في إنجاز المهام قد تكون تحديًا أكثر واقعية.
عند النظر إلى الوراء، خلال السنوات القليلة الماضية، كانت عملية جمع بيانات الروبوتات تتم على أساس الحذف: من التشغيل عن بعد إلى تطوير الذات، وتخليص الجسم الفعلي للروبوت، وتبسيط أجهزة الجمع، بحيث تصبح العمليات اليومية الإنسانية أكثر قابلية للحصول على بيانات تدريبية على نطاق واسع.
لكن عندما يبدأ الروبوت في تعلم المشي والانحناء ونقل الأشياء والتعاملات الدقيقة، فإن معلومات حركة الجسم والتلامس خارج الكاميرا تصبح جزءًا لا يمكن التخلي عنه بسهولة.
اختيار الفجر يأتي على هذا المسار الخفيف، لإعادة توفير الحركة الكاملة واللمس. يتولى SeePhys Hub تسجيل التفاعلات الحقيقية للبشر بشكل أكثر شمولية، أما نموذج العالم ذو الوسائط المتعددة في المستقبل، فيسعى إلى تعلم علاقة بين الحركات واللمس والنتائج الفيزيائية.
من فهم كيف يقوم المسجل بتحقيق المهام، إلى تمكين الروبوتات من اتخاذ الإجراءات بشكل مستقل. هذه هي الخطوة التالية التي تهدف إليها شركة بوروشي لتحقيق ذلك من خلال بيانات جميع الوسائط والأنماط.
*هذا النص نُشر بإذن من كوالكوميتي، ووجهات النظر تعود ملكيةها للمؤلف الأصلي فقط.*