
Wir haben letztes Jahr EmbeddingGemma eingeführt, um eine leichtere Option für hochwertige Text-Embeddungen anzubieten, damit Ihre Apps Informationen direkt auf Verbrauchergeräten organisieren, suchen und verbinden können. Die Reaktion der Entwicklergemeinschaft übertraf unsere Erwartungen. Mit mehr als 20 Millionen Downloads haben Entwickler es verwendet, um intelligente Suchwerkzeuge auf dem Gerät sowie RAG-Pipelines, die Privatsphäre im Vordergrund stellen, zu ermöglichen.
Heute starten wir EmbeddingGemma 2, das über die Textbereich hinausgeht und Code, Bilder, Videos sowie Audiodateien in einem gemeinsamen Einbettraum vereint. Auf der Gemma 4-Architektur basierend und unter einer kommerziell freigehenden Apache 2.0-Lizenz veröffentlicht, verfügt EmbeddingGemma 2 über 740 Millionen Parameter, was es ideal für die Inferierung direkt auf dem Gerät macht. Es kann helfen, einen bestimmten Videoclip aus einer Sprachnote zu finden oder nach Stunden von Audiodateien basierend auf einer Textanfrage zu suchen – alles wird durch ein einzelnes, nativ multimodales Modell verarbeitet.
Entwickelt aus derselben Technologie wie die Gemini-Embedding-Modelle, ist EmbeddingGemma 2:
- Best-in-class für seine Größe: Erzielt führende Punktzahlen unter den sub-1B multimodalen Embeddern dieser Größe bei Benchmarks wie MTEB (Massive Text Embedding Benchmark) Code und MAEB (Massive Audio Embedding Benchmark), während sie viele größere Modelle in Text-, Vision- und Audioaufgaben gleich oder sogar übertrumpfen.
- Modularer Aufbau: Erfordert nur 270M Parameter für Text-basierte Arbeitslasten mit optionalen Vision- (170M) und Audio- (300M) Kodierenern für eine vollständige Multimodal-Unterstützung.
- Speichereffizient: Durch das Matryoshka-Representation-Learning (MRL) können Entwickler die Ausgabevektoren dynamisch von 768 Dimensionen auf 512, 256 oder 128 Dimensionen reduzieren. Dadurch wird die Speichermenge für lokale Vektordatenbanken sowie der Speicherverbrauch bis zu 6x reduziert.
- Optimiert für die Leistung auf dem Gerät: Funktioniert effizient unter engen Ressourcenbeschränkungen. Durch Quantisierung erfordert EmbeddingGemma 2 auf einem Google Pixel 11 Pro nur etwa ~191MB aktive RAM für einfache Textgewichte und ~567MB für das vollständige multimodale Modell.
- Erweiterter Kontext bereit: Es verfügt über eine 8K-Token-Kontextfenstergröße (4x größer als bei EmbeddingGemma 1), wodurch es direkt auf lokaler Hardware bis zu 5,5 Minuten Audio, 29 Bilder, 58 Videoframes oder interleaved Kombinationen davon verarbeiten kann.
Erhaltung von hochwertiger Qualität für Code, Vision und Audio
EmbeddingGemma 2 entspricht dem starken mehrsprachigen Textverarbeitungsvermögen von EmbeddingGemma und bietet zugleich eine signifikante Verbesserung von 9,92 Punkten in der Code-Leistung (in MTEB Code, von 68,76 auf 78,68), was es ideal für die Indexierung lokaler Codebases, die semantische Codesuche und die Suche nach Coding-Agenten macht. Bei Bildern, Videos, Dokumenten und Audiodaten setzt es ein neues Standard für Qualität pro Parameter für Sub-1B-Modelle und übertrifft sogar einige spezialisierte Modelle, die mehr als doppelt so groß sind.
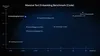
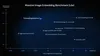
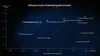
Finden Sie die vollständigen Bewertungsmetriken und Modelinformationen in der EmbeddingGemma 2 Model-Card.
Ermöglichend semantische Suche, Routing und Abruf vollständig auf Gerätsebene
EmbeddingGemma 2 bringt robuste Funktionen direkt in Edge-Hardware. Die lokale Generierung von Embeddings hilft dabei, die Datendiskretion zu gewährleisten, die Latenz im Pipeline zu reduzieren und Entwicklern das Potenzial zu geben, crossmodale Such- und Abrufverfahren vollständig offline zu erstellen.
Wenn es mit generativen Modellen wie Gemma 4 kombiniert wird, ermöglicht EmbeddingGemma 2 on-Device-RAG-Pipelines, die komplexe multimodale Daten verstehen. Da EmbeddingGemma 2 auf Gemma 4 basiert und denselben Text-Tokenizer sowie den Audio-Encoder teilt, können Entwickler beide Modelle gemeinsam in einem einheitlichen Pipeline ausführen – mit einer geringeren Gesamt-Memorieauslastung.
Verwenden Sie Text oder eine Bild, um die besten Übereinstimmungen in Ihrer Medienbibliothek aufgrund semantischer Ähnlichkeit zu finden. Probieren Sie es aus in der Google AI Edge Gallery’s Instant Media Search.
Finden Sie spezifische Momente im Video mit Text- oder Audio-Fragen. Probieren Sie es aus mit dem Video Moments Finder in der Google AI Edge Gallery.
Paarung von EmbeddingGemma 2 für die Abrufung lokaler Dateien mit Gemma 4 für kontextuelles Denken. Probieren Sie es in der Google AI Edge Foresight-App aus.
Erstellen Sie Echtzeit-Bestimmungssysteme, die den multimodalen Kontext für Klassifizierung, Routing und Vorhersagefähigkeiten nutzen, durch die MediaPipe Decision Task API.
Um zu erfahren, wie man Suchsysteme und RAG-Systeme auf dem Gerät mit LiteRT entwickelt, lesen Sie den Google AI Edge-Blogpost.
Anfangskonfiguration mit EmbeddingGemma 2
Wir arbeiteten eng mit den folgenden Partnern zusammen, um sicherzustellen, dass EmbeddingGemma 2 sofort funktioniert, wo Sie es bauen.
- Laden Sie die Modelle herunter: Finden Sie die Gewichte des Models auf Hugging Face und Kaggle. Das Model Garden für Gemini Enterprise Agent Platform wird bald verfügbar sein. Besuchen Sie LiteRT Community auf Hugging Face, um Modelle zu finden, die für den Einsatz auf dem Gerät optimiert sind.
- On-device-Einrichtung: Entwickeln Sie crossplattformale Apps mit Google AI Edge MediaPipe für eine einfache Einbettung, Abruf und Entscheidungsaufgaben oder LiteRT für die Integration von benutzerdefinierten Modellen. Erstellen Sie Browser-Apps mit transformers.js oder WebGPU.
- Verwenden Sie Ihre Lieblingsentwicklungswerkzeuge:: Bereiten Sie das Modell effizient vor, indem Sie Transformers, Sentence-Transformers, MLX, vLLM, llama.cpp, SGLang, Ollama und LMStudio verwenden. Speichern Sie Ihre Embedding-Vektoren mit Qdrant.
- Feinjustierung: Folgen die Anleitung von Unsloth, um zu erfahren, wie man EmbeddingGemma 2 für seine Anwendungsfälle feinjustiert.
Erforschen Sie unseren Entwicklerleitfaden, Dokumentation sowie Leitfäden für Inference und Fine-Tuning.