
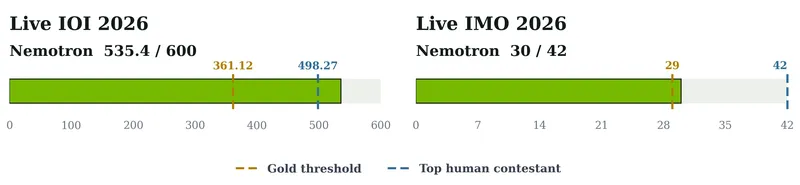
Die Internationale Olympia in Informatik (IOI) und die Internationale Mathematische Olympia (IMO) testen unterschiedliche Fähigkeiten. Die IOI erfordert Algorithmen und Code, die unter strengen Zeit- und Einreichungsbeschränkungen geheime Tests bestehen. Die IMO verlangt rigorose Beweise in natürlicher Sprache. Der Erfolg bei einer der Wettbewerbe ist schwierig. Der Erfolg bei beiden Wettbewerben bedeutet etwas weitergehendes.
Unsere jüngsten Ergebnisse zeigen, dass Nemotron eine starke, anpassbare Grundlage ist, um weltklassige spezialisierte Modelle zu entwickeln. Mit Nemotron 3 verwendeten unsere Teams überwachtes Feinjustieren (SFT), Verstärkungslernen (RL) und Feedback-getriebene Inferenz, um Systeme zu schaffen, die bei IMO 2026 und IOI 2026 den Goldmedaillen-Standard erreicht haben.

| Wettbewerb | Nemotron Spezialisierung | Ergebnis |
|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC mit SFT und GenCorrect | 535,4/600 – über dem Goldschwellenwert von 361,12 und dem höchsten menschlichen Score von 498,27 |
| Meiner Meinung nach 2026 | Nemotron 3 Ultra General, SFT und RL-Checkpoints im Generieren-Überprüfen-Feinjustieren-System | 30/42, über dem offiziellen Goldschwellenwert von 29 |
Das IOI-Ergebnis stammte aus einer Live-Prüfung unter denselben Zeit-, Internetzugang- und Einreichungsbedingungen wie die menschlichen Teilnehmer. Es war ein unoffizieller, unbeaufsichtigter Benchmark und wurde nicht in die offizielle IOI-Rankingliste aufgenommen. Die eingereichten Beweise des IMO-Systems wurden von offiziellen IMO-Bewertern beurteilt.
>Eine wieder verwendbare Spezialisierungsrezeptur
„Leicht zu feinjustieren“ bedeutet mehr als nur das Training eines Checkpointes. Es bedeutet, dass ein kompetentes Grundmodell mit einer klaren, wiederverwendbaren Methode an einen anspruchsvollen Bereich angepasst werden kann.
Über die beiden Projekte umfasste dieses Rezept vier Teile:
- Beginnen Sie mit einem starken Nemotron-Basismodell.
- Kümmeln Sie sich um domain-spezifische Probleme und hochwertige Rechenprotokolle.
- Verwenden Sie standardisierte Trainingsverfahren wie SFT und, wenn nötig, RL.
- Paaren Sie das Spezialmodell mit einem Inferenzloop, der Kandidatenantworten generiert, bewertet und verbessert.
Die Trainings- und Inferenzprozesse waren umfangreich, aber der zugrunde liegende Ansatz ist vertraut und reproduzierbar. Wir mussten für jedes Problem kein neues Grundmodell erstellen. Wir spezialisierten Nemotron auf die jeweilige Aufgabe.
Von allgemeiner Programmierfähigkeit zum IOI-Gold
Für Wettbewerbsprogrammierung haben wir 22.000 Probleme zusammengestellt und synthetische Rechenspuren erstellt, um zwei Spezialisten zu trainieren. Nemotron-3-Nano-CC mit 30 Milliarden Gesamtparameter und 3 Milliarden aktiven Parameter erhielt sowohl SFT als auch RL. Nemotron-3-Ultra-CC mit 550 Milliarden Gesamtparameter und 55 Milliarden aktiven Parameter erhielt SFT.
Die Entwicklung bei IOI 2025 macht den Wert der Spezialisierung leicht sichtbar. Nano verbesserte sich von 130 Punkten vor dem Training auf 280 Punkte nach SFT und auf 291 Punkte nach RL. Mit GenCorrect, unserer iterativen Generieren-Evaluieren-Refinieren-Strategie, erreichte er 468 Punkte und überschritt den goldenen Schwellenwert von 438,3. Ultra-CC erreichte mit derselben Testzeit-Strategie 502 Punkte.

Diese Experimente zeigten auch, dass die Anpassung nicht auf jeder Skala gleich aussehen muss. SFT erzeugte den größten Gewinn von Nano, während RL eine kleinere, aber konstante Verbesserung hinzufügte. Für das stärkere Ultra-Modell reichte eine einzige SFT-Periode aus, um das vollständig nachgebildete Nano-Modell bei IOI, ICPC und LiveCodeBench Pro zu übertreffen. Diese Erkenntnis leitete das für die Wettbewerbe spezifische Ultra-CC-System, das bei IOI 2026 535,4 von 600 Punkten erzielte.
Das Lehren von Nemotron, um zu beweisen, zu überprüfen und zu überarbeiten
Das IMO-Projekt setzte dieselbe Idee auf die Olympiade-Mathematik an. Beginnend mit Nemotron 3 Ultra trainierte man einen Spezialisten mit SFT und einen anderen mit RL.
Das SFT-Corpus enthielt 414.890 qualitativ gefilterte Beispiele für 15.818 einzigartige Beweisprobleme. Es tat mehr als nur die endgültigen Antworten zu lehren. Die Daten umfassten die Erzeugung von Beweisen, ihre Verbesserung, Überprüfung und Meta-Überprüfung – sodass das Modell lernte, Argumente zu konstruieren, Lücken zu erkennen, Kritiken zu beantworten und zu beurteilen, ob ein Beweis vollständig war. Das RL-Modell wurde auf 9.597 Beweisproblemen trainiert, die in der Nähe der Kapazitätsgrenze des Modells ausgewählt wurden.
Beide nach dem Post-Training erstellten Checkpoints überwogen im Entwicklungsexperiment das allgemeine Verfügbarkeitsmodell. Der SFT-Checkpoint war am stärksten in der ersten Suchrunde, während der RL-Checkpoint den besten einzelnen Checkpoint-Ergebnis erzielte. Ihre Stärken waren komplementär, sodass das finale System sowohl die spezialisierten als auch das allgemeine Modell verwendete.
Für jedes IMO-Problem generierten die Modelle Kandidatenbeweise, bewerteten sie, gaben Kritiken und optimierten die vielversprechendsten Versuche. Eine separate Hochkompetenzstufe wählte den endgültigen Antrag aus. Das gesamte System funktionierte in natürlicher Sprache, ohne formellen Prover, externe Tools oder Internetzugang. Es erhielt 30 von 42 Punkten, einschließlich voller Punkte für vier der sechs Probleme, und übertraf den offiziellen Goldmedaillen-Schwellenwert.

>Fine-Tuning und Testzeit-Rechenarbeit arbeiten zusammen
Unsere frühere IOI 2025 Hugging Face-Post zeigte, wie die Rechenleistung während der Tests Modelle mit offenem Gewicht bis zum Gold-Niveau erreichen kann. Die neuen Ergebnisse fügen eine wichtige Komponente hinzu: eine bessere Spezialisierung liefert dem Inferenzsystem bessere Kandidaten, bessere Kritiker und bessere Verbesserungen.
Bei IOI verwandelte GenCorrect die Vorteile des Feinjustierns in größere Verbesserungen über mehrere Runden der Rückmeldung. Bei IMO war es wertvoller, komplementäre SFT- und RL-Checkpoints zu verwenden, als einfach mehr Beispiele aus einem Checkpoint zu extrahieren. In beiden Fällen resultierte das beste Ergebnis daraus, einen fähigen Spezialisten mit einem System zu kombinieren, das suchen, überprüfen und verbessern kann.
Diese Unterscheidung ist wichtig. Die Medaillen wurden nicht allein durch feine Anpassungen hergestellt, und sie wurden auch nicht allein durch gewaltsames Sampling erstellt. Sie entstanden durch die gemeinsame Entwicklung des Modells, der Daten und des Inferenzzyklus.
Offene Modelle, Daten und Rezepte auf Hugging Face
Wir wollen, dass diese Ergebnisse auch außerhalb von Wettbewerben nützlich sind. Die Nemotron Labs IMO 2026-Kollektion vereint die SFT- und RL-Checkspuren, beide Trainingsdatensätze sowie das Nemotron-IMO-Bench, ein neues Benchmark mit 200 olympiadnahen Problemen. Das IMO-Paper beschreibt den Trainingsansatz und das System für Generierung, Überprüfung und Verbesserung, während der NeMo-Skills-Repository den IMO-Inferienpipeline, Prompts, eingereichte Beweise und einen reproduzierbaren Quickstart enthält. Für kompetitive Programmierung ist der Nemotron-3-Ultra-CC-Modell auf Hugging Face verfügbar, und das IOI-Paper liefert die Trainingsrezept und die GenCorrect-Methodik. Der IOI-Evaluations- und Inferienpipeline ist ebenfalls in NeMo-Skills verfügbar.
Zusammen bieten IMO und IOI außergewöhnlich anspruchsvolle Beweise für eine einfache Idee: Nemotron kann in Weltklasse-Experten für bestimmte Bereiche umgewandelt werden, dann mit transparenten Inferenzworkflows kombiniert werden, um Probleme an der Grenze der menschlichen Leistung zu lösen.
Wir freuen uns, zu sehen, was die Hugging Face-Community als Nächstes entwickelt.