

Arabische WER: 20.92% · Parameter: 1.6B · Emiratische WER (TII-Evaluation): 22.73%
Wir stellen Falcon-ASR vor, unser Spracherkennungsmodell mit 1,6 Milliarden Parametern für Arabisch, mit besonderem Fokus auf den emiratischen Dialekt. Entwickelt am Technology Innovation Institute (TII) in Abu Dhabi, unterstützt es außerdem Englisch, Französisch, Spanisch und Portugiesisch.
In unserer Evaluation erreichte Falcon-ASR eine durchschnittliche Wortfehlerrate von 20.92% über sechs arabische Testdatensätze, verglichen mit dem besten veröffentlichten Ergebnis von 23.17% in dem von uns verwendeten Leaderboard-Snapshot. Bei unserer internen emiratischen Evaluation verzeichnete es die niedrigste Wort- und Zeichenfehlerrate unter den verglichenen Systemen.
Wir unterstützen auch Wortzeitstempel für Transkriptionen, wobei jedes transkribierte Wort mit seiner Position im Audio verknüpft wird.
Gesprochenes Arabisch erkennen
Arabische Sprache variiert je nach Region, Sprecher und Situation. Ein Modell, das eine formelle Nachrichtensendung verarbeiten kann, kann dennoch Schwierigkeiten mit einem Gespräch auf Emiratisch oder mit über eine Telefonleitung aufgenommenen Sprache haben. Dialektales Arabisch verfügt zudem über weniger transkribierte Ressourcen als Modernes Standardarabisch (MSA), was Training und Evaluation erschwert.
Wir haben Falcon-ASR auf Emiratisch, MSA, anderen Golf- und arabischen Dialekten sowie Englisch trainiert. Unser Ziel ist es, die Wörter zu transkribieren, die Menschen in der Alltagssprache verwenden, einschließlich dialektaler Formen und Sprachwechsel.
Arabische Benchmark-Ergebnisse
Die Open Universal Arabic ASR Leaderboard, gepflegt vom ELM Research Center, ordnet Systeme nach dem gleichgewichteten Durchschnitts-WER über sechs Testdatensätze. Sie berichtet außerdem die Zeichenfehlerrate (CER). Niedrigere Werte sind bei beiden Metriken besser. Unsere Falcon-ASR-Evaluation folgt diesem Protokoll.

WER = Word Error Rate (Wortfehlerrate); CER = Character Error Rate (Zeichenfehlerrate). Ein niedrigerer Wert bedeutet eine bessere Leistung.
Wir haben Falcon-ASR auf denselben sechs Benchmarks unter Verwendung der gepinnten Manifeste des Leaderboards evaluiert. Die Konkurrenzwerte sind die veröffentlichten Leaderboard-Durchschnitte, geprüft am 30. September 2026. Der durchschnittliche WER von Falcon-ASR liegt 2.25 Prozentpunkte unter dem besten veröffentlichten Ergebnis in diesem Snapshot.
Evaluation emiratischer Sprache
Öffentliche Evaluationsdaten umfassen bereits Emiratisches: Casablanca verfügt über eine VAE-Teilmenge. Wir ergänzen diese Abdeckung durch eine interne Evaluation zusätzlicher emiratischer und Golf-Sprachaufnahmen, wobei zurückgehaltene Aufnahmen und von Menschen validierte Transkripte verwendet werden, um die Transkriptionsgenauigkeit über die öffentliche VAE-Teilmenge hinaus zu bewerten.
In unserer internen emiratischen Evaluation erreichte Falcon-ASR 22.73% WER und 10.19% CER:

Falcon-ASR hat den niedrigsten WER und CER unter den hier verglichenen Systemen. Sein WER liegt 4.07 Prozentpunkte unter Qwen3-Omni, dem zweitbesten Ergebnis. Die Ergebnisse zeigen eine verbesserte Transkriptionsgenauigkeit sowohl auf Wort- als auch auf Zeichenebene bei dieser Evaluation.
Training für verschiedene Aufnahmebedingungen
Wir berücksichtigten Hintergrundgeräusche, überlappende Sprache, Musik, Raumhall und Telefoneffekte sowie Variationen in Geschwindigkeit und Tonhöhe. Wir wandten dieselbe Behandlung auf emiratische Aufnahmen an, um das Modell einer Reihe von Bedingungen auszusetzen, denen es in Meetings, Anrufen und anderen Alltagaufnahmen begegnen kann.
Englisch und andere Sprachen
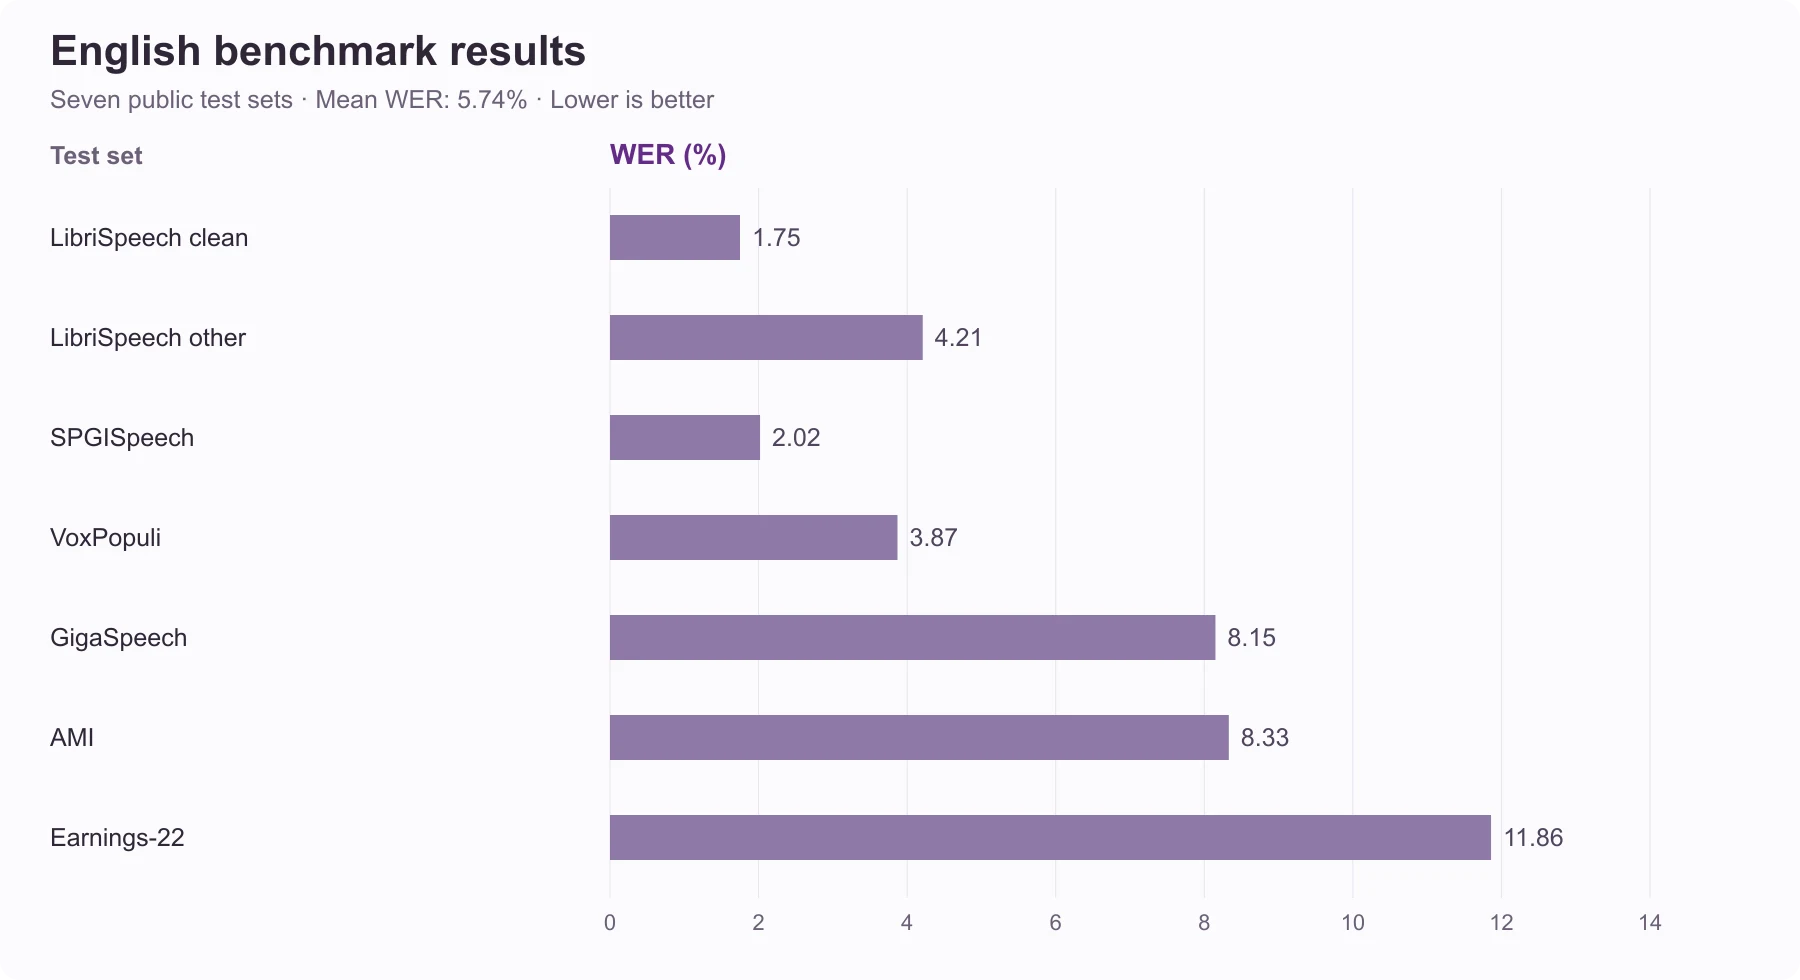
Falcon-ASR transkribiert Englisch mit denselben Modellgewichten. In unserer Evaluation an den sieben öffentlichen englischen Testdatensätzen, die vom Hugging Face Open ASR Leaderboard verwendet werden, erreichte es einen durchschnittlichen WER von 5.74%.

Das Modell unterstützt außerdem Französisch, Spanisch und Portugiesisch. Alle fünf Sprachen verwenden dieselben Gewichte, ohne dass ein Sprach-Flag erforderlich ist. Die Ausgabe ist ein Transkript in der gesprochenen Sprache.
Modellgrundlage
Falcon-ASR baut auf unserer Falcon3-Audio-Arbeit auf. Die Architektur und der Trainingsansatz für Falcon3-Audio werden beschrieben in Konkurrierende Audio-Sprachmodelle mit dateneffizientem einstufigem Training auf öffentlichen Daten.
Falcon ASR ausprobieren
Unser Hugging Face Demo Space ermöglicht es Ihnen, Falcon-ASR auszuprobieren und seine Transkriptionsfähigkeiten zu erkunden. API-Zugang und native Anwendungen sind geplant. Wir laden Sie ein, die Demo mit Ihren eigenen Aufnahmen zu testen.
Danksagungen
Wir danken dem Team hinter dem Falcon-Emirati-Modell für seine Unterstützung bei arabischen Foundation-Modellen. Lesen Sie über ihre neueste Arbeit im Falcon-Emirati-Blogbeitrag.
Wir danken außerdem aufrichtig Mikhail Lubinets für die kontinuierliche Unterstützung bei der Recheninfrastruktur.
نقدّم Falcon ASR
نقدّم Falcon-ASR، نموذجنا للتعرف على الكلام العربي بحجم 1.6 مليار معلمة، مع اهتمام خاص باللهجة الإماراتية. طوّرنا النموذج في معهد الابتكار التكنولوجي (TII) في أبوظبي، وهو يدعم أيضًا اللغات الإنجليزية والفرنسية والإسبانية والبرتغالية.
في تقييمنا، حقق Falcon-ASR متوسط معدل خطأ في الكلمات بلغ 20.92% عبر ست مجموعات اختبار باللغة العربية، مقارنةً بأفضل نتيجة منشورة بلغت 23.17% في نسخة لوحة المتصدرين التي استخدمناها. وفي تقييمنا الداخلي للهجة الإماراتية، سجّل النموذج أدنى معدلات خطأ في الكلمات والأحرف بين الأنظمة التي قارناها.
ندعم أيضاً الطوابع الزمنية على مستوى الكلمات في عمليات التفريغ النصي، بحيث ترتبط كل كلمة بموضعها في التسجيل الصوتي.
التعرف على العربية المنطوقة
يختلف الكلام العربي باختلاف المنطقة والمتحدث وظروف التسجيل. فقد ينجح نموذج في تفريغ نشرة إخبارية رسمية، ثم يجد صعوبة في تفريغ محادثة باللهجة الإماراتية أو تسجيل عبر الهاتف. كما أن الموارد الصوتية المفرّغة نصيًا للهجات العربية أقل من تلك المتاحة للعربية الفصحى، مما يزيد صعوبة التدريب والتقييم.
درّبنا Falcon-ASR على اللهجة الإماراتية والعربية الفصحى ولهجات خليجية وعربية أخرى، إلى جانب الإنجليزية. وهدفنا هو تفريغ الكلمات التي يستخدمها الناس في حديثهم اليومي، بما في ذلك الصيغ اللهجية والانتقال بين اللغات.
نتائج الاختبارات العربية
ترتّب لوحة المتصدرين المفتوحة الشاملة للتعرف على الكلام العربي، التي يديرها مركز ELM للأبحاث، الأنظمة وفق متوسط معدل خطأ الكلمات عبر ست مجموعات اختبار، بوزن متساوٍ لكل مجموعة. وتعرض أيضًا معدل خطأ الأحرف (CER). وكلما انخفضت قيمة أي من المقياسين، كان الأداء أفضل. ويتبع تقييمنا للنموذج هذا البروتوكول.
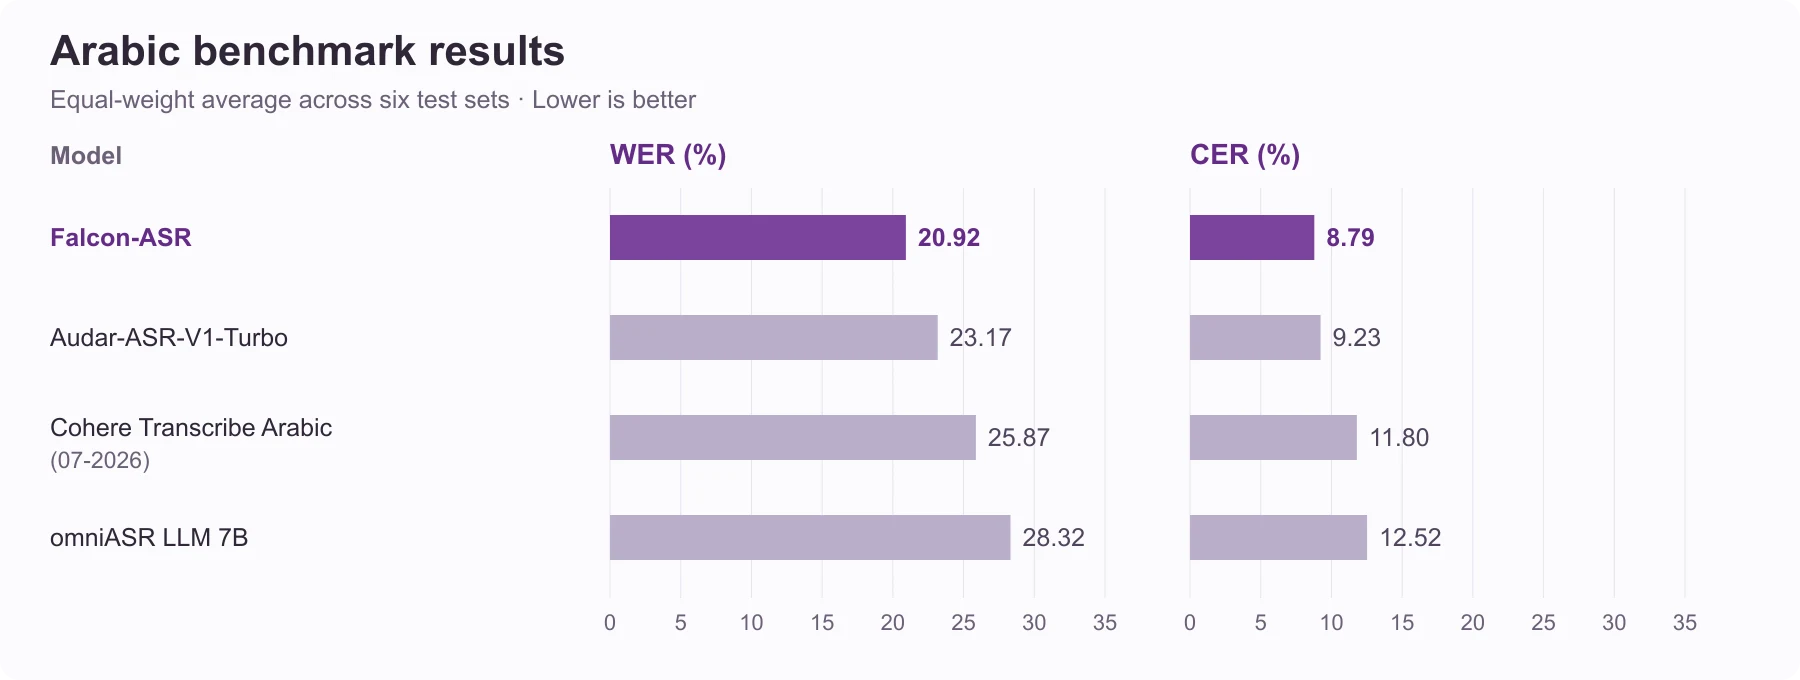
WER هو معدل خطأ الكلمات؛ وCER هو معدل خطأ الأحرف. تشير القيمة الأقل إلى أداء أفضل.
قيّمنا Falcon-ASR على مجموعات الاختبار الست نفسها، باستخدام قوائم العينات المثبّتة في لوحة المتصدرين. وأرقام النماذج المنافسة هي المتوسطات المنشورة في اللوحة، والتي جرى التحقق منها في 30 سبتمبر 2026. وكان متوسط خطأ الكلمات للنموذج أفضل بمقدار 2.25 نقطة مئوية من أفضل نتيجة منشورة في تلك النسخة.
تقييم اللهجة الإماراتية
تتوافر بالفعل بيانات عامة لتقييم اللهجة الإماراتية، إذ تضم مجموعة Casablanca قسمًا خاصًا بالإمارات. ونكمّل هذه التغطية بتقييم داخلي لتسجيلات إضافية من الكلام الإماراتي والخليجي، باستخدام تسجيلات مخصّصة للاختبار ونصوص مرجعية خضعت لمراجعة بشرية، لتقييم دقة التفريغ على مواد إضافية إلى جانب البيانات الإماراتية العامة.
حقق Falcon-ASR في تقييمنا الإماراتي الداخلي معدل خطأ كلمات قدره 22.73٪ ومعدل خطأ أحرف قدره 10.19٪:
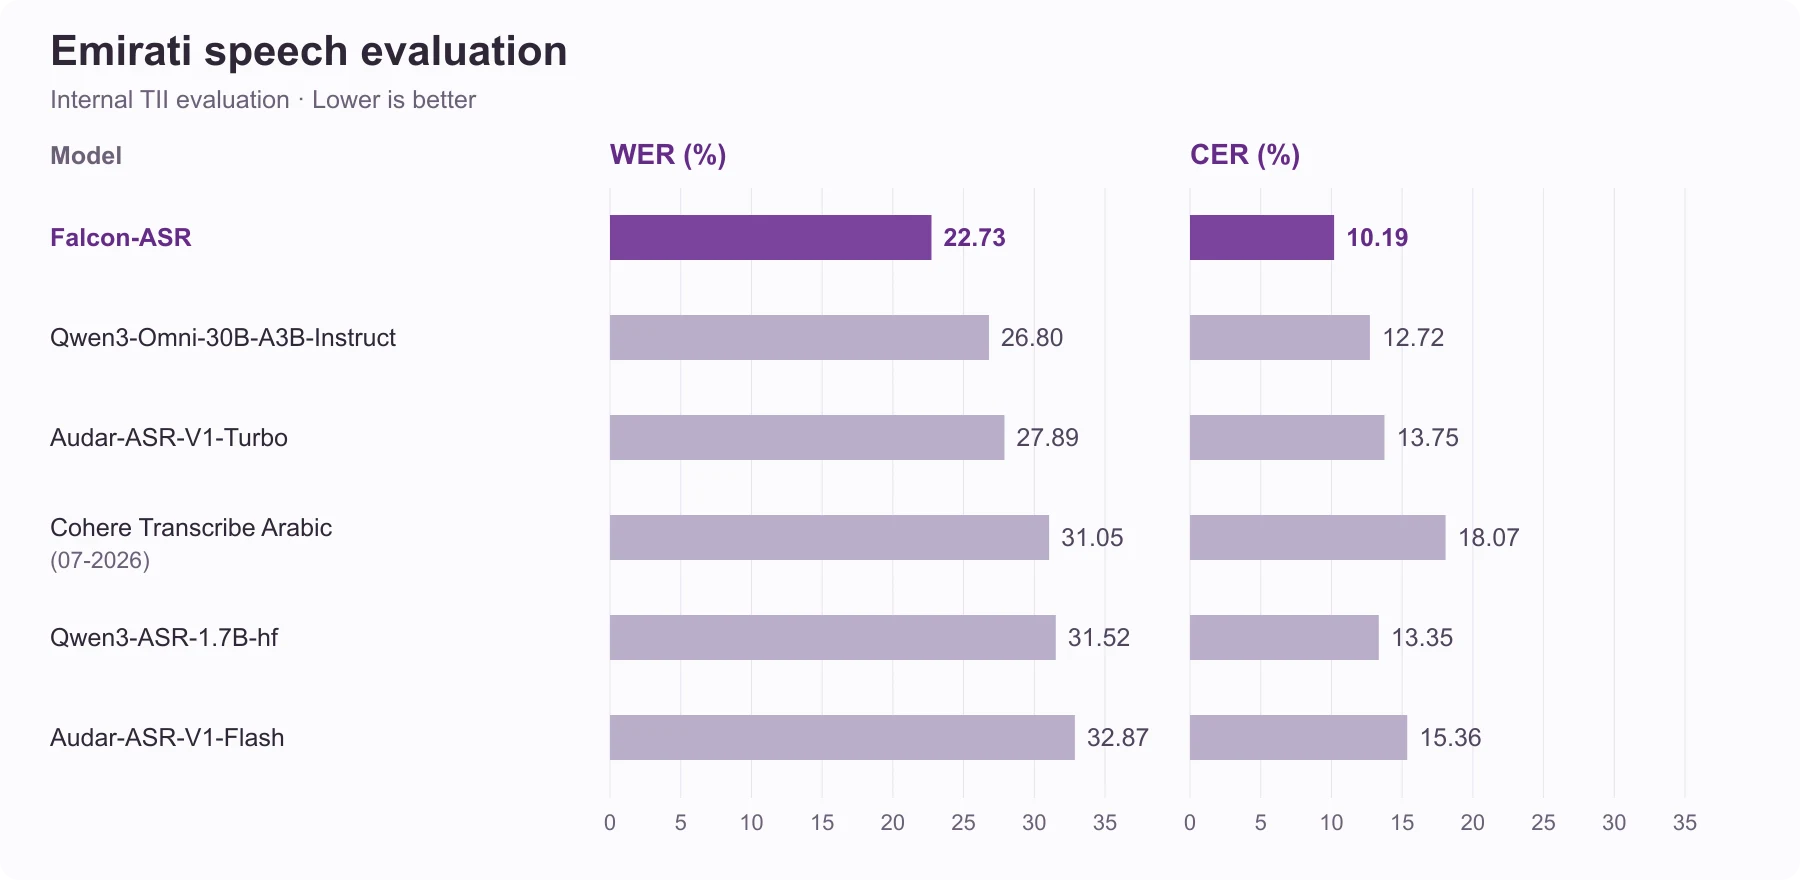
سجّل Falcon-ASR أقل معدل لخطأ الكلمات والأحرف بين الأنظمة المقارَنة هنا. وكان معدل خطأ الكلمات أقل بمقدار 4.07 نقطة مئوية من Qwen3-Omni، صاحب النتيجة التالية. وتُظهر النتائج تحسنًا في دقة التفريغ على مستوى الكلمات والأحرف في هذا التقييم.
التدريب على ظروف تسجيل مختلفة
ضمّنا بيانات التدريب ضوضاء خلفية وكلامًا متداخلًا وموسيقى وصدى الصوت وتأثيرات الاتصالات الهاتفية، إلى جانب تغيّرات في سرعة الكلام وحدّة الصوت. وطبّقنا المعالجة نفسها على التسجيلات الإماراتية، لتهيئة النموذج للتعامل مع ظروف مختلفة قد يواجهها في الاجتماعات والمكالمات والتسجيلات اليومية الأخرى.
الإنجليزية واللغات الأخرى
يفرّغ Falcon-ASR الكلام الإنجليزي باستخدام أوزان النموذج نفسها. وفي تقييمنا على مجموعات الاختبار الإنجليزية العامة السبع المستخدمة في لوحة Hugging Face المفتوحة للتعرف على الكلام، بلغ متوسط معدل خطأ الكلمات 5.74٪.
يدعم النموذج أيضاً الفرنسية والإسبانية والبرتغالية. وتستخدم اللغات الخمس أوزاناً واحدة، دون الحاجة إلى تحديد اللغة مسبقاً. ويكون الناتج تفريغاً نصياً باللغة المنطوقة.
أساس النموذج
يستند Falcon-ASR إلى أعمالنا في Falcon3-Audio. وتعرض ورقة Konkurrenzfähige Audio-Sprachmodelle mit dateneffizientem einstufigem Training auf öffentlichen Daten بنية Falcon3-Audio ونهج تدريبه.
Falcon ASR ausprobieren
ermöglicht unsere Demo auf Hugging Face Falcon-ASR auszuprobieren und seine Fähigkeiten bei der Sprachtranskription zu erkunden. Der Zugriff über eine API und native Anwendungen ist geplant. Wir laden euch ein, das Modell mit euren eigenen Aufnahmen zu testen.
Dank und Anerkennung
Wir danken dem Team hinter dem Modell Falcon-Emirati herzlich für seine Unterstützung im Bereich der Foundation Models für die arabische Sprache. Die neuesten Arbeiten des Teams können über den veröffentlichten Artikel über Falcon-Emirati.
eingesehen werden. Ebenso möchten wir Mikhail Lubinets unseren aufrichtigen Dank für seine kontinuierliche Unterstützung der Recheninfrastruktur aussprechen.