
Cornerstone OnDemand, Inc. (Cornerstone) ist ein globaler Marktführer für Lösungen zur Arbeitskräftequalifizierung und betreut 140 Millionen Nutzer in 186 Ländern. Das Unternehmen baute ein Multi-Agenten-KI-System, das den Datenbankbetrieb von reaktivem Katastrophenschutz in proaktive, sich selbst orchestrierende Workflows verwandelt. Das System mit dem Namen Orion AI nutzt Amazon Bedrock und Strands Agents, ein Open-Source-Agenten-Orchestrierungsframework von AWS, um spezialisierte Agenten zu koordinieren.
Vor Orion AI verbrachte das Enterprise DataOps-Team von Cornerstone bis zu 45 Minuten pro Datenbankvorfall damit, manuell Systemviews abzufragen und Protokolle abzugleichen, bevor Aufgaben teamübergreifend weitergegeben wurden. Mit Orion AI sank die Dauer der Datenbankdiagnose von 45 auf 10 Minuten, eine Reduzierung um 78 %. Ein dreiköpfiges Team lieferte das System in sechs Monaten ab.
In diesem Beitrag gehen wir auf das operative Problem ein, dem Cornerstone gegenüberstand, darauf, wie das Team Orion AI entwarf, die gemessenen Ergebnisse sowie die Designentscheidungen, die andere Teams wiederverwenden können.
Die operative Herausforderung
Vor Orion AI arbeitete das Enterprise DataOps-Team von Cornerstone reaktiv und hatte mit vier wiederkehrenden Problemen zu kämpfen:
- Untersuchungen zur Datenbankperformance dauerten etwa 45 Minuten pro Vorfall und verteilten sich über mehrere Tools und Systemviews.
- Datenbank-Lebenszyklus-Workflows erforderten 10 oder mehr manuelle Schritte, vom Herstellen von Verbindungen bis zur Kommunikation von Statusaktualisierungen.
- Die Berichterstattung zwischen dem Site-Reliability-Engineering-Team (SRE) und dem Datenteam lief mit 15 Minuten Verzögerung.
- Redundante und sich überschneidende Warnungen erzeugten Rauschen, das die wichtigen Signale überdeckte.
Zusammen bedeutete dies, dass die Ingenieure ihre Zeit mit manueller Koordination statt mit der Behebung von Problemen verbrachten.
Die Lösung: Orion AI
Orion AI ist ein Multi-Agenten-System, bei dem ein koordinierender Agent (der Meta-Orchestrator) Aufgaben an spezialisierte untergeordnete Agenten delegiert, die in einer Hub-and-Spoke-Topologie angeordnet sind. Ingenieure interagieren über eine Webanwendung damit, stellen Fragen und genehmigen Aktionen an dem Ort, an dem sie ihre operative Arbeit ohnehin koordinieren. Die Agenten decken Infrastrukturüberwachung, Datenbankdiagnose, Datenbank-Lebenszyklusoperationen, Kundenanalysen und wissensbasierte Unterstützung ab.
Zwei Grundsätze leiteten den Aufbau: Datenschutz mithilfe von AWS-Kontrollen im Rahmen des Shared-Responsibility-Modellsund tiefe Integration in bestehende operative Tools. Amazon Bedrock bot verwalteten Zugang zu Foundation Models, und Strands Agents lieferte die Orchestrierungsschicht.
Ergebnisse
Orion AI lieferte messbare Verbesserungen bei Diagnosegeschwindigkeit und -genauigkeit und befreite das Team von manueller Koordination. Durch die Automatisierung manueller Engpässe und die Straffung teamübergreifender Workflows erzielte Cornerstone die folgenden Ergebnisse.
| Metrik | Vorher | Nachher | Verbesserung |
| Zeit für Datenbankdiagnose | 45 Minuten | 10 Minuten | 78 % schneller |
| Manuelle Lifecycle-Schritte | 10+ Schritte | 1 Interaktion | 70 % Reduzierung |
SRE-to-data-team Berichtsverzögerung |
15 Minuten | Sofortig | Echtzeit |
| Redundante Warnungen | Hohes Grundvolumen | Gefiltert | 65% Reduktion (Median) |
Schnellere Fehlerbehebung bei Performance-Problemen
Die Reduzierung der Datenbank-Diagnosezeit war Orion AIs bislang größter einzelner Effizienzgewinn. Zuvor verbanden sich Ingenieure manuell mit der betroffenen SQL Server-Instanz, fragten System Views nach Blocking Chains und Wait Types ab, durchsuchten Logs zur Isolierung lang laufender Queries und korrelierten die Beweise zu einer Hypothese über die Ursache. Dies dauerte im Durchschnitt etwa 45 Minuten pro Vorfall.
Mit Orion AI teilen sich drei spezialisierte Agents die Untersuchung, wobei jeder eine eigene Phase verantwortet. Über die Diagnose hinaus trägt Orion AI Probleme bis zur Behebung: Es identifiziert die Ursache, empfiehlt die Korrektur und erstellt ein ausgefülltes Jira-Ticket, das dem zuständigen On-Call-Ingenieur zugewiesen wird. Ein manueller Übergabeprozess in vier Schritten wird zu einer einzigen Interaktion zusammengefasst.
Automatisiertes Datenbank-Lifecycle-Management
Aufgaben, die zuvor mehr als 10 manuelle Schritte erforderten – vom Herstellen von Datenbankverbindungen über das Ausführen systemübergreifender Queries bis hin zur Kommunikation von Statusupdates – laufen nun als einzige Interaktion in natürlicher Sprache. Orion AI identifiziert die passenden Tools und Datenquellen, führt Queries systemübergreifend aus, validiert die Ergebnisse und liefert eine einheitliche Antwort. Aus Sicht des Ingenieurs reduziert sich die Arbeit darauf, Orion AI eine Eingabe zu machen und die gemeldeten Ergebnisse zu validieren.
Echtzeit-Überwachung und reduzierte Warnungsmüdigkeit
Orion AI entfernte die 15-minütige SRE-to-data-team Berichtsverzögerung und ersetzte periodische manuelle Prüfungen durch kontinuierliche systemübergreifende Sichtbarkeit.
Orion AI reduzierte redundante Warnungen um im Median 65 Prozent durch Deduplizierung, Schwellenwertfilterung und Signalübergreifende Korrelation. Von zuvor 10 generierten Warnungen erreichen nun nur noch 3–4 die Ingenieure. Warnungen werden direkt an die verantwortlichen Teams weitergeleitet, ohne eine zwischengeschaltete Alerting-Ebene.
Zentrale Designprinzipien
Drei Entscheidungen prägten Orion AI, und Sie können sie auf Ihre eigenen Multi-Agent-Projekte anwenden:
- Agents nach Domäne aufteilen, nicht nach Aufgabenkomplexität: Jeder Agent verfügt über einen schmalen Satz an Tool-Integrationen für eine operative Domäne. Dies hält den Kontext eines Modells fokussiert und verbessert die Genauigkeit der Toolauswahl, anstatt einen einzigen Allzweck-Agenten alles erledigen zu lassen.
- Standardmäßig Keyword-Routing verwenden, mit semantischer Suche als Rückfallebene: Vorhersehbare Anfragen werden für Geschwindigkeit per Keyword abgeglichen. Mehrdeutige Anfragen fallen zur Genauigkeit auf die semantische Suche zurück. Dies hält die Latenz niedrig, ohne bei schwierigeren Queries Korrektheit einzubüßen.
- Konversationsspeicher auf Sitzungen begrenzen und ihn bei Live-Metriken umgehen: Persistenter Speicher unterstützt Konversationen mit mehreren Runden, aber operative Fragen lesen immer den aktuellen Systemzustand. Das Umgehen des Speichers bei Live-Metriken hilft zu verhindern, dass veraltete Daten Echtzeitdiagnosen verfälschen.
Architekturübersicht
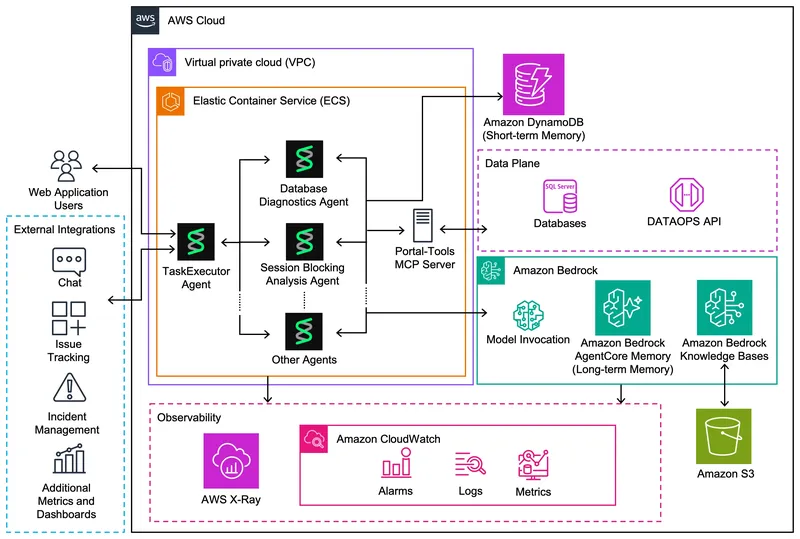
Orion AI wird als containerisierte Services auf Amazon Elastic Container Service (Amazon ECS) betrieben. Nutzer interagieren über eine Webanwendung, die jede Anfrage an den passenden Agent weiterleitet, die erforderlichen Tools aufruft und die Antwort zusammenstellt. Das folgende Diagramm zeigt, wie diese Komponenten innerhalb der AWS Cloud verbunden sind.
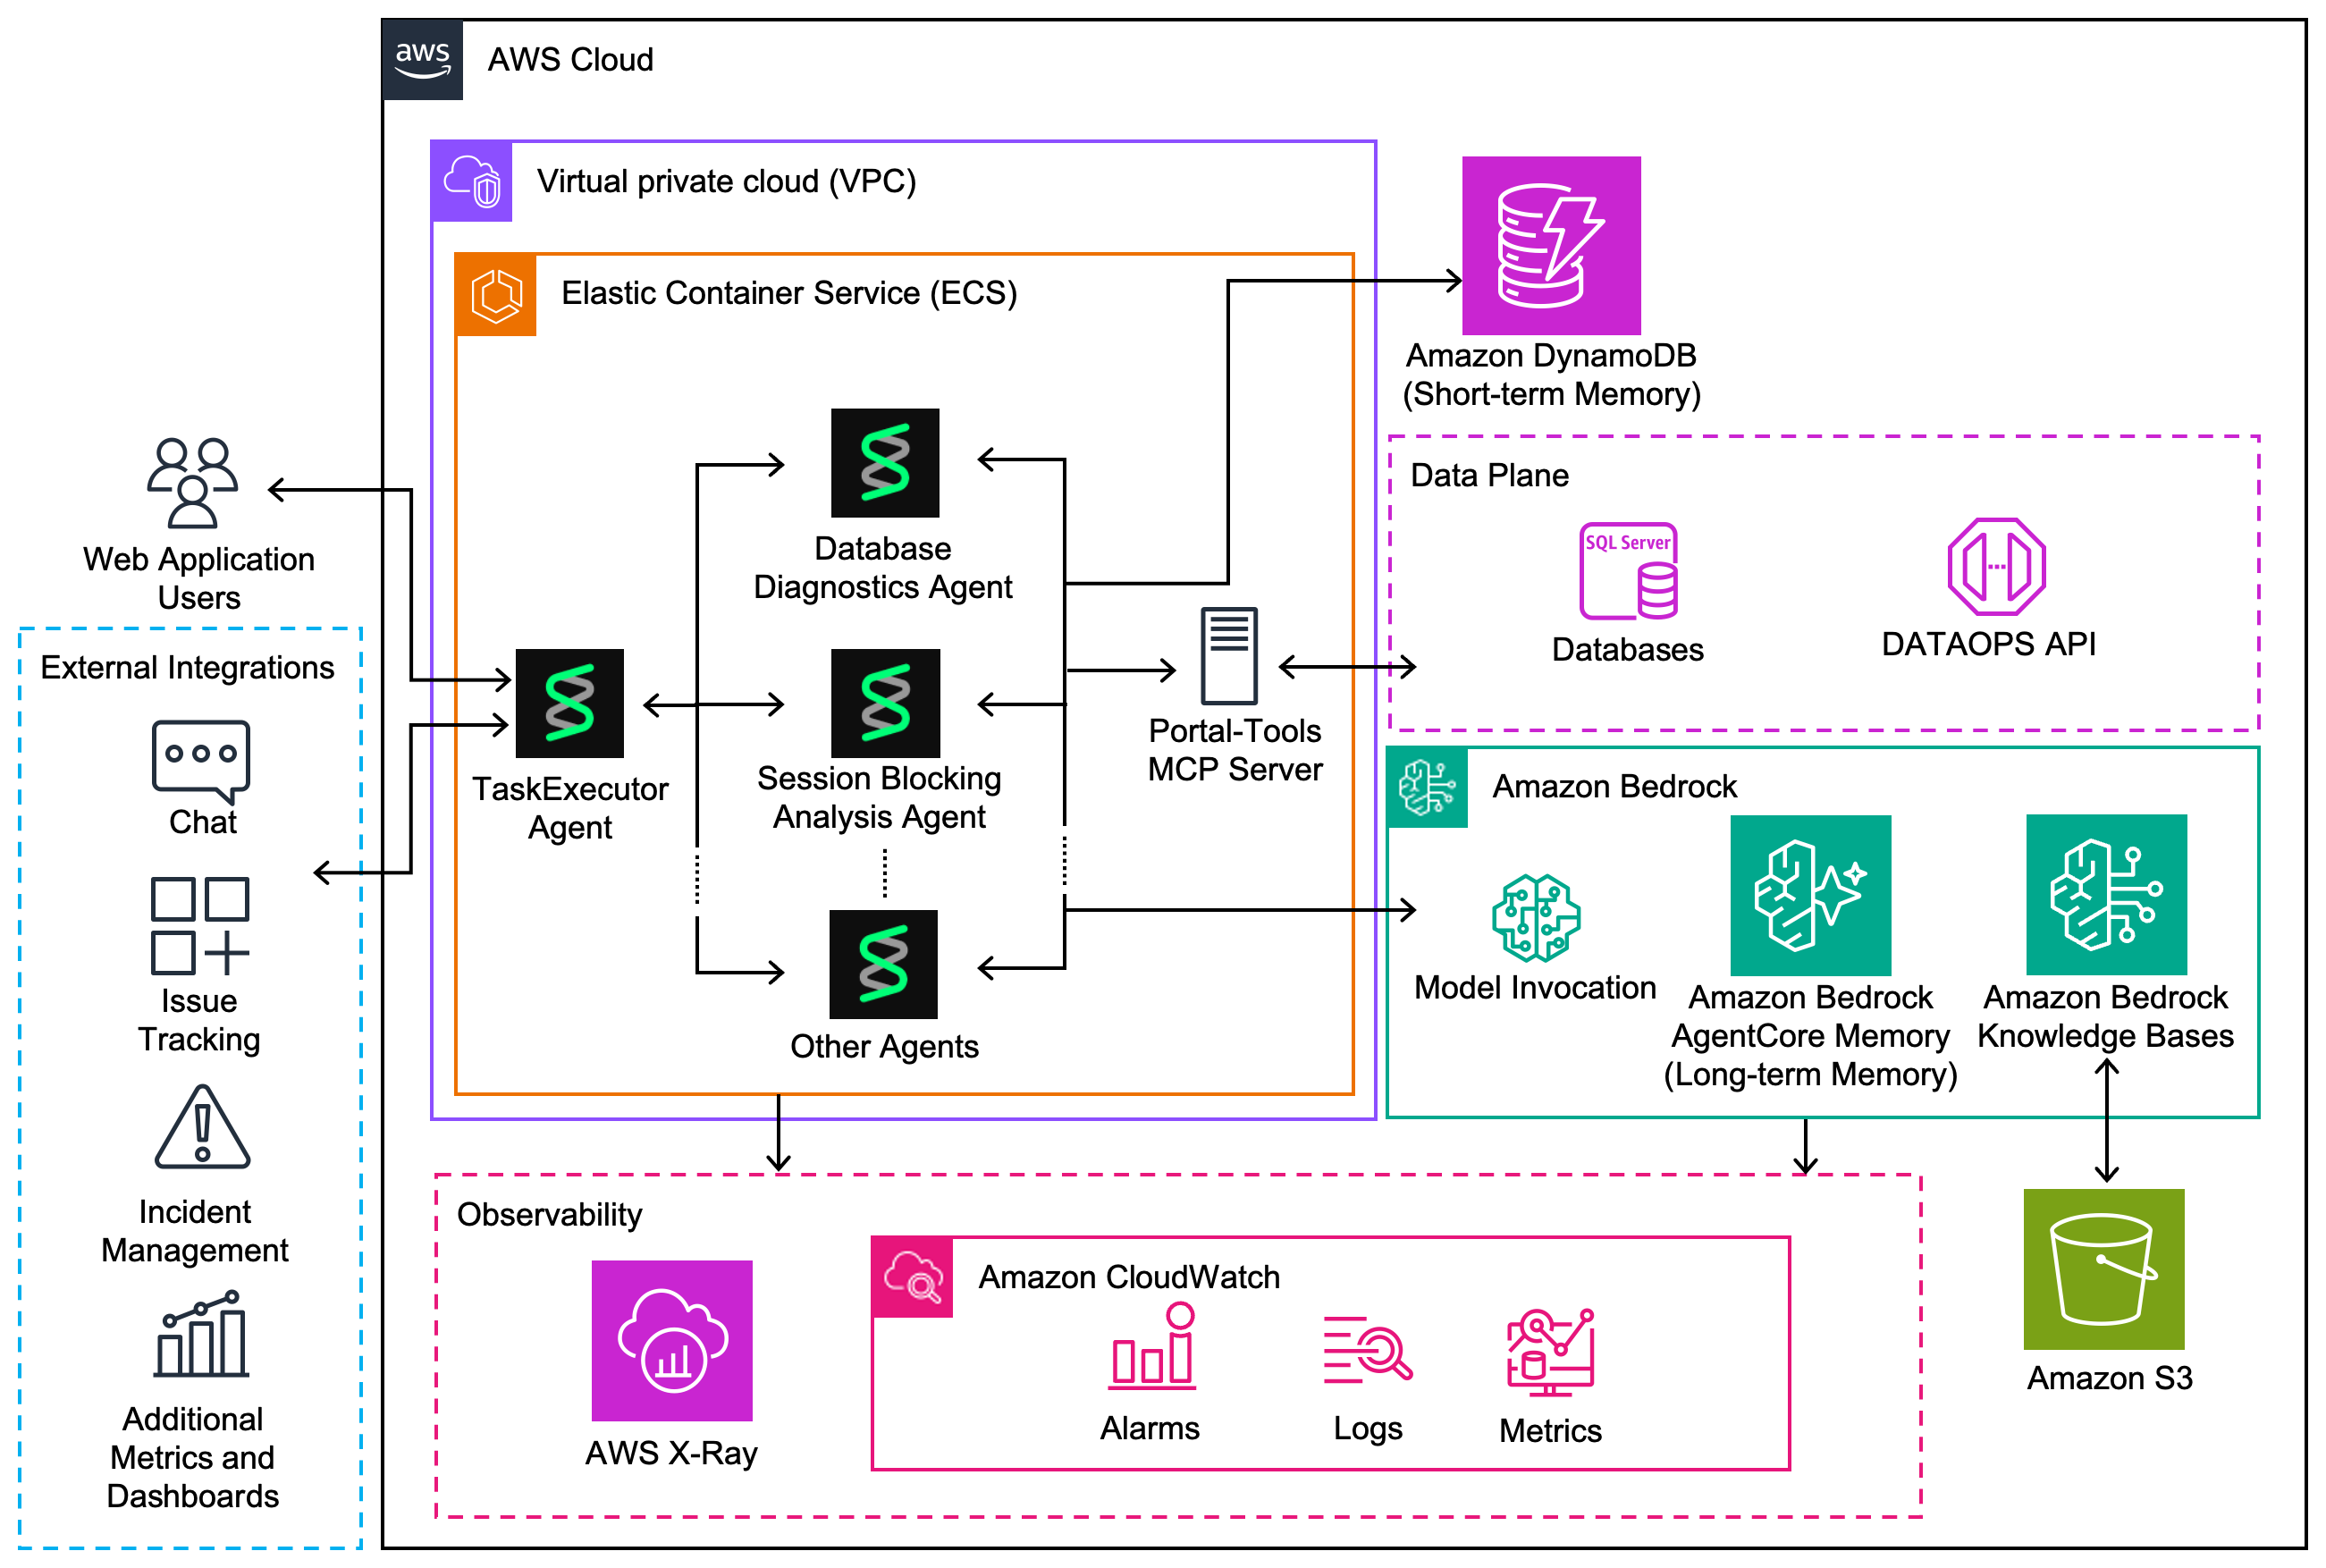
Abbildung 1: Orion AI-Architektur: ein Meta-Orchestrator auf Amazon ECS leitet Anfragen an spezialisierte Agents weiter, die über einen Portal-Tools MCP-Server auf Datenquellen zugreifen und Amazon Bedrock für Modelle, Langzeitspeicher und Retrieval Augmented Generation nutzen
Architektur im Detail
Die zuvor genannten Designprinzipien zeigen sich konkret in der Architektur. Der Rest dieses Abschnitts führt durch die Kernkomponenten von Orion AI.
Aufbau des Hub-and-Spoke-Musters mit Strands Agents
Orion AI bildet seine Topologie mit einer Handvoll Strands Agents-Primitiven ab. Die Agent Klasse ist der Baustein sowohl für spezialisierte Agenten als auch für den Meta-Orchestrator. Die Tools jedes Agenten sind gewöhnliche Python-Funktionen, die mit dem @tool Decorator markiert sind. Dieser leitet die Spezifikation eines Tools aus den Typ-Hinweisen und dem Docstring der Funktion ab, sodass kein separates Schema gepflegt werden muss. BedrockModel umschließt das Amazon-Bedrock-Modell, auf dem jeder Agent läuft, und MCPClient verbindet Agenten mit externen Toolservern.
Die Topologie:
- Der Hub ist ein einzelner Strands Agent, der als Meta-Orchestrator fungiert (der TaskExecutor). Er besitzt keine Domänen-Tools — nur Routing-Tools (
find_relevant_agents,call_agent) und Ablaufsteuerungs-Tools (emit_plan_step,emit_confirmation_gate), damit er eine Anfrage Schritt für Schritt durchdenken kann. - Die Spokes sind unabhängige
AgentInstanzen, die träge über eine registry-basierte Decorator-Struktur geladen werden. Jeder verfügt über sein eigenes Modell, seine Domänen-Tools und einen lokalisierten Systemprompt.
Zur Laufzeit ruft der Hub einen Spezialisten namentlich über das registrierte call_agent Tool auf. Jeder Spezialist durchläuft seine eigene Tool-Aufrufschleife und gibt synthetisierten Text an den Hub zurück, der die endgültige Antwort zusammenstellt.
Hybrides Routing
Orion AI verwendet ein keyword-first Routing mit semantischer Suche als Fallback. Ungefähr 80 Prozent der Anfragen werden über einen In-Memory-Schnellpfad mit Schlüsselwörtern in weniger als einer Millisekunde aufgelöst. Wenn Schlüsselwörter nicht ausreichen, um die Absicht zu bestimmen, fällt das System auf eine semantische Suche zurück, die auf Amazon Titan Text Embeddings V2 basiert und nach Bedeutung routet. Informationen zur Modellverfügbarkeit nach AWS-Region finden Sie unter Supported models by AWS Region in Amazon Bedrock.
Wenn der direkte Tool-Aufruf nicht geeignet ist, wird eine Fallback-Kette aktiviert: Amazon Bedrock Knowledge Bases, die vollständig verwaltete Retrieval Augmented Generation (RAG)-Funktion, ruftBetriebs-Dokumentation ab, sodass Antworten in genehmigten Verfahren fundiert sind und nicht ohne Kontext generiert werden.
Domänenspezifische Agents und ihre Grenzen
Orion AI verwendet 13 domänenspezifische Agents. Die drei SQL-Server-Agents veranschaulichen, wie die Aufteilung in Domänen den Phasen einer echten Untersuchung entspricht:
- Der Database-Diagnostics-Agent deckt Blockadeketten, Wartetypen und lang laufende Abfragen auf und übersetzt technische Erkenntnisse in geschäftliche Auswirkungen mit Empfehlungen zur Behebung. Er beantwortet die Frage: „Was passiert und was bedeutet es.“
- Der Session-Blocking-Analysis-Agent führt mehrstufige Untersuchungen mit Reasoning-Modellen durch, um Blockadeketten auf den ursprünglichen Blockierer zurückzuführen. Er beantwortet die Frage: „Warum passiert dies und was ist die Grundursache“ und liefert priorisierte Empfehlungen – von der sofortigen Beendigung der Sitzung bis zu langfristigen architektonischen Korrekturen.
- Der Real-Time-SQL-Diagnostics-Agent fragt SQL-Server-Instanzen direkt über Cornerstones DATAOPS API nach Live-Blockadedaten und Analysen von Sitzungen mit hoher CPU-Auslastung ab. Er beantwortet die Frage: „Was ist gerade jetzt wahr.“
Die übrigen Agents folgen demselben Prinzip der engen Zuständigkeit: Infrastrukturüberwachung, Betriebsanalysen, Datenbank-Lebenszyklusverwaltung, Kundenanalysen, Wissensabruf aus Runbooks, Benachrichtigungsrouting, Zerlegung zusammengesetzter Abfragen, Auflösung von Availability-Group-Listenern und Aufwärmen von Modellverbindungen.
Tool-Integration und Dienstanbindung
Orion AI erreicht Datenquellen über zwei Muster:
- Model Context Protocol (MCP) für Tools, die mehrere Agents gemeinsam nutzen (zum Beispiel Real-Time SQL Diagnostics). Ein Strands-
@toolFunktionsaufruf sendetMCPClientüber streamable HTTP an einen Portal-Tools-MCP-Server, der auf SQL Server und die DATAOPS API zugreift. Die Jira-Integration folgt demselben Ansatz über externe Atlassian-MCP-Tools. - Direkte SDK- oder REST-API-Aufrufe für Quellen, die die gemeinsame MCP-Schnittstelle nicht benötigen. Dazu gehören Metriken und Dashboards, Bereitschaftspläne und Amazon Bedrock Knowledge Bases über AWS SDK for Python (Boto3).
Diese Aufteilung bedeutet, dass jeder Agent den leichtesten Mechanismus verwendet, der zu seiner Quelle passt, während der MCP-Server die Tools zentralisiert, die mehrere Agents gemeinsam nutzen. Diese Verbindungen laufen über TLS, und Anmeldeinformationen wie das MCP-Token und die REST-API-Autorisierung werden pro Anfrage bereitgestellt, nicht im Agent-Code hinterlegt.
Konversationelles Gedächtnis
Amazon Bedrock AgentCore, eine Plattform zum Erstellen, Verbinden und Optimieren von Agents in großem Umfang mit jedem Framework oder Modell, bietet die sitzungsübergreifende Speicherschicht. Orion AI koordiniert den Kontext über einen zentralen Speichermanager, der parallel aus drei Ebenen liest, jede mit eigenem Timeout und eigener Token-Zuteilung.
Orion AI koordiniert den Kontext über drei Ebenen. Das Kurzzeitgedächtnis hält den Kontext derselben Sitzung in Amazon DynamoDB, standardmäßig ruhend verschlüsselt, gepaart mit einer rollierenden Gesprächszusammenfassung, die Amazon Nova 2 Lite asynchron erstellt. Das Langzeitgedächtnis bietet sitzungsübergreifenden Abruf über AgentCore Memory, eine Funktion von Amazon Bedrock AgentCore, namespaced nach Benutzer-ID. Nach Abschluss einer Aufgabe ruft Orion AI create_event auf, um automatisierte Extraktion, Zusammenfassung und Konsolidierung auszulösen. Eine dritte Ebene, das Inter-Agent-Gedächtnis, ist ein flüchtiger Speicherblock im Arbeitsspeicher, der Erkenntnisse über die Schritte von Sub-Agents hinweg innerhalb einer einzigen Aufgabe trägt.
Der Speichermanager ruft über die Ebenen hinweg innerhalb eines harten Timeouts von 500 Millisekunden ab, bei einem Budget von 4,000 Token, gestützt durch einen Least-Recently-Used-Cache. Wenn eine Anfrage den aktuellen Systemzustand betrifft, umgehen die Agents den Speicher vollständig und lesen Live-Daten, damit veralteter Kontext keine Echtzeitdiagnosen verunreinigt.
Verantwortungsvolle KI und Schutzmechanismen
Da die DataOps-Sicherheit von domänenspezifischen Regeln abhängt, etwa davon, welche Datenbankoperationen disruptiv sind, baute das Team eine eigene Guardrail-Logik, anstatt sich auf generische Inhaltsfilter zu verlassen. Orion AI wendet Kontrollen über vier Ebenen hinweg an:
- Sicherheitsbeschränkungen auf Prompt-Ebene die in den Systemprompt jedes Agents eingefügt werden und gefährliche Empfehlungen blockieren (zum Beispiel das Beenden kritischer Datenbankprozesse) und nicht-disruptive Methoden erzwingen.
- Ein Human-in-the-Loop-Bestätigungsgate das destruktive Operationen anhält, bis der Benutzer innerhalb eines Zeitfensters von fünf Minuten bestätigt, mit standardmäßiger Ablehnung bei Timeout.
- Eigene Guardrail-Module zur Eingabevalidierung (Längenbegrenzungen, Blockierung von Prompt- und SQL-Injection), Ausgabe-Bereinigung (Schwärzung von Geheimnissen und personenbezogenen Daten), Ratenbegrenzung, rollenbasierte Zugriffskontrolle und Kostenverfolgung pro Anfrage.
- Schutz auf Routing-Ebene der die Beantwortung operativer Abfragen aus dem Speicher blockiert und die Ausführung von Live-Tools für Fragen zum aktuellen Zustand erzwingt.
Observability
Orion AI nutzt Standard-AWS-Observability-Services für Monitoring und Debugging. Amazon CloudWatch liefert Metriken und strukturiertes Logging für Routing-Konfidenz, Latenz und Agent-Aufrufaktivität. AWS X-Ray verfolgt verteilte Aufrufe über Agent-Ausführungen hinweg für eine End-to-End-Sichtbarkeit des Anfragepfads.
Erkenntnisse
Die Designentscheidungen, die Orion AI ermöglicht haben, lassen sich wiederverwenden. Die Aufteilung der Agenten nach Domänen erlaubte es jedem Agenten, schlanke Tool-Integrationen mit sich zu führen, ohne den Kontext eines einzigen Modells aufzublähen. Die Verwendung von Keyword-Routing als Standard mit semantischer Suche als Fallback hielt die Latenz niedrig, ohne bei mehrdeutigen Anfragen Genauigkeit einzubüßen. Die Beschränkung des Konversationsspeichers auf Sitzungen bei gleichzeitiger Umgehung für Live-Metriken hielt die Echtzeit-Diagnostik vertrauenswürdig.
Das Team traf auch pragmatische Infrastrukturentscheidungen. Sie brachten Compute auf Amazon ECS unter, weil Amazon Bedrock AgentCore runtime, eine Funktion von Amazon Bedrock AgentCore, zu Projektbeginn nicht verfügbar war, und sie evaluieren es jetzt als zukünftige Migrationsoption. Wenn Sie heute eine Lösung bauen, wägen Sie denselben Kompromiss für Ihren eigenen Stack ab: Beginnen Sie mit dem, was jetzt stabil und verfügbar ist, und überdenken Sie es, wenn verwaltete Funktionen reifen.
Fazit
Orion AI reduzierte die Datenbankdiagnose von 45 Minuten auf 10, vermied 70 Prozent der manuellen Lifecycle-Schritte und senkte das Alert-Rauschen um 65 Prozent. Ein dreiköpfiges Team lieferte sie in sechs Monaten auf Amazon Bedrock. Die Muster hinter diesen Ergebnissen können andere Betriebsteams übernehmen: domänenspezifische Agenten, hybrides Routing und sitzungsbasierten Speicher mit einer Live-Metrics-Umgehung.
Um mit Multi-Agenten-Orchestrierung auf AWS zu beginnen, sehen Sie sich die AWS Solutions Library guidance.