
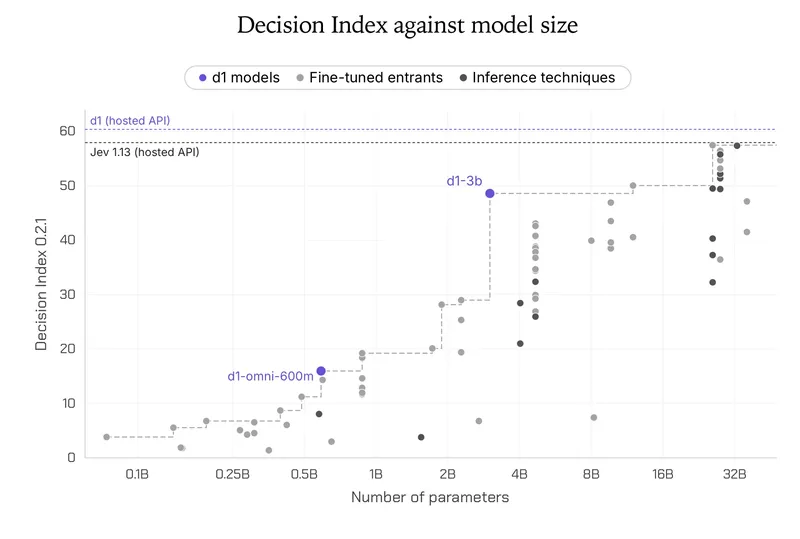
Heute veröffentlichen wir zwei offene Entscheidungsmodelle in unserer d1-Entscheidungsmodellfamilie: d1-3B und d1-omni-600M (experimentell).
- Bestes Entscheidungsmodell unter 10B im Decision Index 0.2.1: d1-3B erreicht 48.57, vor jedem 4B- und 9B-Modell sowie vor Decider 35B-A3B (47.11).
- Multimodal: d1-3B unterstützt Text und Bilder, während d1-omni-600M Text und Bilder oder Text und Audio unterstützt
- Schnell: d1-3B beantwortet eine Frage in 16 ms auf einem NVIDIA Jetson AGX Thor, in 26 ms auf einem Jetson AGX Orin und in 50 ms auf einem Jetson Orin Nano
Wie wir Entscheidungsmodelle für den Edge-Bereich gebaut haben
Diese offenen d1-Entscheidungsmodelle basieren auf unseren Liquid Foundation Models (LFMs). Anders als unsere generativen Modelle erzeugen Entscheidungsmodelle keine Tokens, sondern antworten in einem einzigen Forward Pass.
d1-3B und d1-omni-600M werden aus zwei sehr unterschiedlichen Backbones trainiert:
- d1-3B wird trainiert aus LFM2.5-VL-3B, unserem neuesten VLM, das decoder-only ist. Es akzeptiert Text und Bilder als Eingaben.
- d1-omni-600M wird trainiert aus LFM2.5-Encoder-350M, einem bidirektionalen Encoder. Es fügt Vision- und Audio-Encoder hinzu, um alle drei Modalitäten zu verarbeiten. Es akzeptiert entweder Text und Bild oder Text und Audio als Eingaben. Dieses Modell befindet sich derzeit in einer frühen Research-Release und wird weiterentwickelt.
Benchmark-Ergebnisse
Wir haben d1-3B und d1-omni-600M auf sieben öffentlichen Datensätzen benchmarked, die Leseverständnis, Toxizitätserkennung, Intent-Klassifizierung, medizinisches QA und sprachübergreifendes Verständnis abdecken. d1-3B erreicht einen mittleren Score von 82.9, den höchsten in der Tabelle und über Decider 4B. d1-omni-600M erreicht 78.4 und übertrifft Decider 2B (77.1) mit nur einem Viertel der Parameter.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| Mittelwert | 78.4 | 82.9 | 77.1 | 81.1 |
Wir haben überprüft, dass d1-3B die Vision-Fähigkeiten seines LFM2.5-VL-3B Backbones auf standardmäßigen Vision-Benchmarks beibehält und dass d1-omni-600M alle drei Modalitäten verarbeitet. Wir berichten über keine Vision- oder Audio-Benchmarks, da der Decision Index v0.3 nur einen privaten Vision-Split enthält und Audio-Decision-Benchmarks derzeit ein ungelöstes Problem sind.
Geschwindigkeit
In Zusammenarbeit mit NVIDIA haben wir d1-3B auf dem NVIDIA-Stack auf NVIDIA GeForce RTX 4090, NVIDIA Jetson AGX Thor, Jetson AGX Orin 64 GB und Jetson Orin Nano evaluiert. Da d1-omni-600M eine frühe Forschungsversion ist, berichten wir in dieser Version über keinerlei Geschwindigkeitswerte dafür.
Edge-Inferenz. d1-3B beantwortet eine einzelne Frage in unter 50 ms auf jedem gemessenen Gerät. Drei Fragen benötigen nur das 1.3-fache der Zeit einer Frage, wobei das AGX Thor von 16 ms auf 20 ms steigt.
| Eine Frage | 3 Fragen | 3.4K-Token-Zustand | 384px-Bild | 64 Zustände, gepackt | |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| Jetson AGX Orin 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
GPU-Inferenz. Auf der GPU beantwortet d1-3B eine Frage in unter 10 ms und verarbeitet ein 384px-Bild in unter 18 ms auf beiden Plattformen.
| Eine Frage | 3 Fragen | 3.4K-Token-Zustand | 384px-Bild | 64 Zustände, gepackt | |
|---|---|---|---|---|---|
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
So verwenden Sie offene d1-Entscheidungsmodelle
Greifen Sie auf d1-Entscheidungsmodelle zurück, wenn Sie schnelle, strukturierte Entscheidungen benötigen, einschließlich multimodaler Eingaben. d1-3B liefert die höchste Entscheidungsqualität in seiner Größe, während d1-omni-600M dort passt, wo die Footprint-Größe wichtig ist.
Installieren Sie die Abhängigkeiten (erfordert transformers>=5.14):
pip install "transformers>=5.14" torch torchvision pillow
Diese Modelle liefern ihren eigenen Code mit, also laden Sie ihn mit trust_remote_code=True:
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
Der Kürze halber führen wir nur das Beispiel für d1-3B an. Siehe die d1-omni-600M-Modellkarte für Anweisungen zur Ausführung.
Erste Schritte mit offenen d1-Entscheidungsmodellen
Beide Entscheidungsmodelle sind Open-Weight und heute auf Hugging Face verfügbar:
- Herunterladen: d1-3B und d1-omni-600M auf Hugging Face.
- Ausprobieren: führen Sie die Demos in unserem System One Arcade Hugging Face Space aus.
Wir können es kaum erwarten zu sehen, was Sie entwickeln.
Zitat
Wenn Sie diese Arbeit verwenden, zitieren Sie bitte den Release-Blog-Beitrag:
@article{liquidAI2026opend1,
  author  = {Liquid AI},
  title   = {Open d1: Edge decision models for text, vision, and audio},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/open-d1},
}