
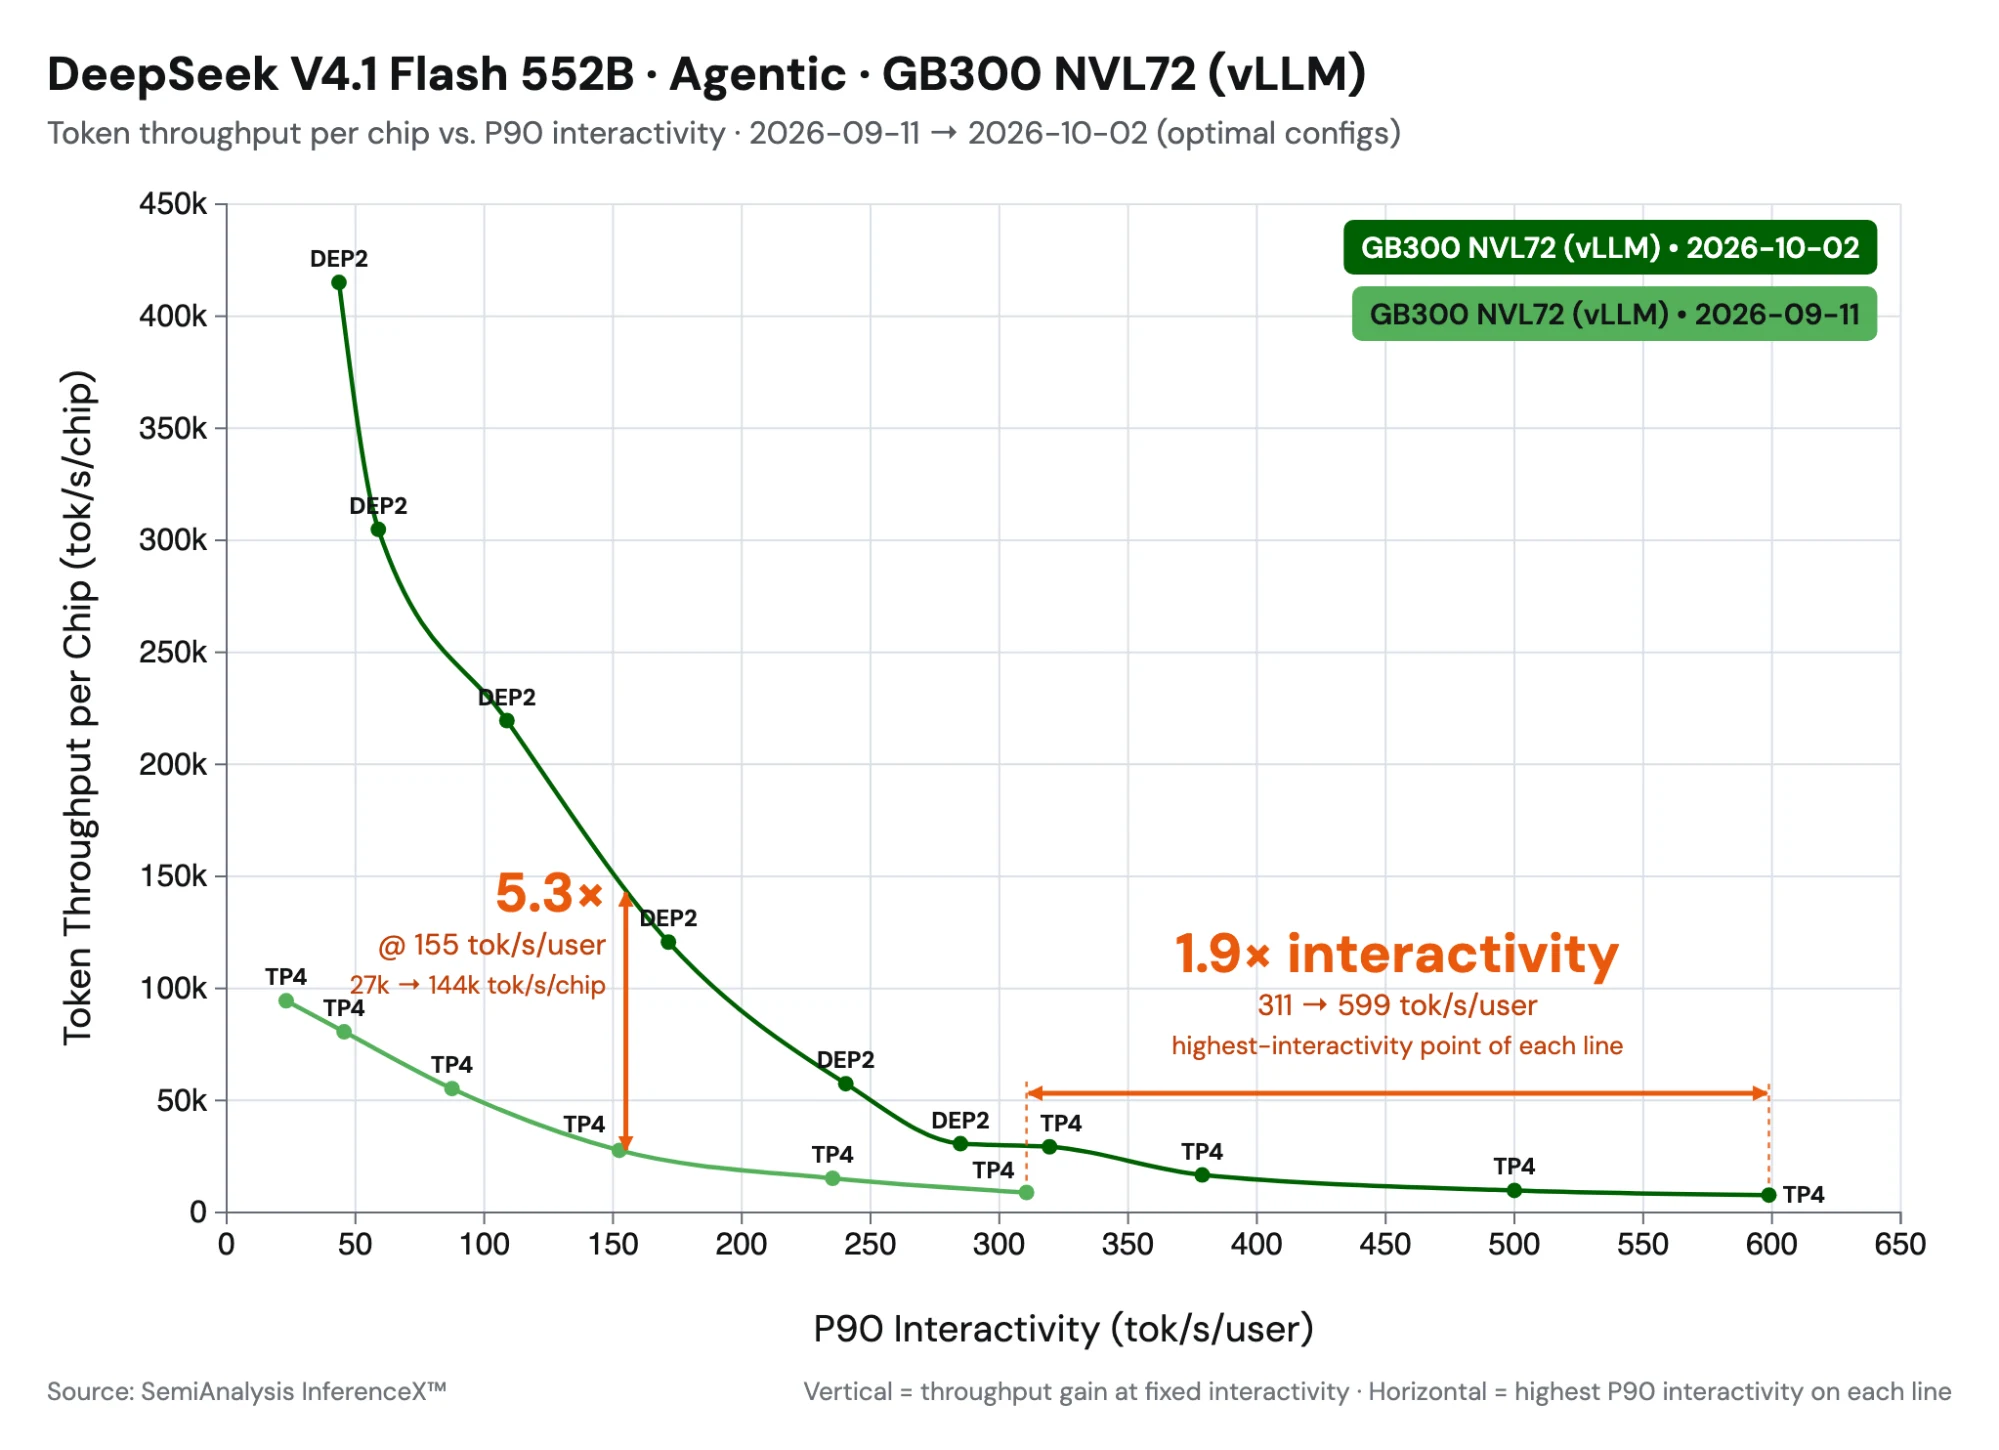
TL;DR: In den drei Wochen nach der Veröffentlichung von DeepSeek-V4.1-Flash optimierten Inferact und die vLLM-Community das Modell und erreichten eine 1.9×-Beschleunigung bei niedriger Konkurrenz sowie eine 5.3×-Durchsatzverbesserung unter einer 150-TPS-Beschränkung. Die Leistungsverbesserung resultiert aus:
-
Wir implementierten SWA bounded replay mit CUDA graphs und erreichten eine Reduzierung der TTFT um ~30%.
-
Wir integrierten DeepSeeks kürzlich veröffentlichte Kernels, darunter MegaAttention, Mega-mHC, Mega-Gate und DeepSelect.
-
Wir fusionierten und parallelisierten die verbleibenden Kernels aggressiv, einschließlich mHC-Seitenströmen, und fusionierten all-reduce mit den vorherigen und nachfolgenden Operationen zu einem einzigen Kernel.
DeepSeek V4.1 führt eine hocheffiziente Architektur für langfristige agentic-serving-Aufgaben ein: Mit seiner kausalen Encoder-Decoder-Architektur (CED) aktiviert das Modell beim Decode 16B Parameter pro Token, beim Prefill jedoch nur 8B Parameter. Das Modell ist außerdem äußerst speichereffizient. Es kombiniert mehrere Techniken, um die Größe des KV-Cache zu verkleinern: Compressed Sparse Attention 2 (CSA2), FP4 KV cache und Inter-Layer-KV-Cache-Sharing, und drückt den globalen KV-Fußabdruck auf 890 Bytes pro Token. Dieser Beitrag zeigt, wie wir diese Modell-ebenen-Optimierungen von DeepSeek mit Systemoptimierungen auf vLLM-Seite kombinieren, um einen 5×-Durchsatz auf dem SemiAnalysis AgentX agentic-serving-Benchmark zu erreichen. Wir heben unsere Optimierungen in zwei Kategorien hervor: SWA bounded replay und kernelbezogene Optimierungen.
SWA bounded replay
DeepSeek-V4.1-Flash führt zwei Arten von KV-Caches. Global KV ist komprimiert, über Layer hinweg geteilt und wird in FP4 mit etwa 890 Bytes pro Token gespeichert (V4.1-Bericht). Sliding-window-KV (SWA) ist unkomprimiert in FP8 und deckt die letzten 128 Positionen in jedem der 40 Layer ab.
SWA-KV verursacht zwei Kosten:
-
Prefix caching muss es an jeder möglichen Treffergrenze speichern, was mehr als das 10×-Fache des Speicherbedarfs von globalem KV kostet.
-
Prefill führt die Layer 21–39 für jedes Prompt-Token aus, obwohl Decode nur deren letzten 128 Positionen liest.
Ein naheliegender Ansatz ist, SWA-KV neu zu berechnen, statt es zu cachen. Genaue Neuberechnung ist jedoch teuer, da das 128-Token-Fenster jedes Layers von früheren Positionen im darunterliegenden Layer abhängt, sodass der Wiederaufbau über L Layer das ungefähre Wiederabspielen von L × 128 Tokens bedeutet.
DeepSeek V4.1 führt SWA bounded replay ein, das Exaktheit gegen Effizienz tauscht. Es führt nur die letzten 128 Tokens erneut aus und schneidet das SWA-Fenster am Replay-Start ab. Das Ergebnis ist nicht bit-exakt, aber DeepSeek berichtet von vernachlässigbarem Qualitätsverlust (Details unten). vLLM wendet es an zwei Stellen an, eine für jede Kostenart.
Encoder-Seite: Wiederaufbau des Fensters bei einem Cache-Treffer
Bei encoderseitigem Replay cached vLLM nur das globale KV und überspringt SWA-KV. Bei einem Präfixtreffer der Länge H führt es die Tokens [H − 128, H) erneut aus, um SWA-KV wieder aufzubauen, wobei die Fenster bei s = H − 128 abgeschnitten werden.
Decoder-Seite: Überspringen des größten Teils des Prompt-Prefills
In DeepSeek V4.1s CED-Architektur berechnet Layer 20 das globale KV des Decoders, und die Layer 21–39 nutzen es wieder. vLLM führt daher Layer 20 für jedes Token aus, um dieses globale KV zu erzeugen, und führt die Layer 21–39 nur für die letzten 128 Tokens jeder Anfrage aus. Bei langen Prompts überspringt dies fast die Hälfte des Modells.
CUDA graphs für die gekürzten Layer
Nach dem Kürzen leisten die Layer 21–39 so wenig GPU-Arbeit, dass sie beim eager-Ausführen die Kernel-Start-Overhead dominiert und die GPU ungenutzt bleibt. Ihre Eingabeformen unterscheiden sich auch von denen der Layer 0–20, sodass die beiden Teile nicht in einem einzigen CUDA-Graph erfasst werden können. vLLMs unterbrechbarer PIECEWISE-Graph bricht bereits mitten im Modell ab, was eine natürliche Aufteilung ergibt: Die Layer 0–20 werden auf dem vollen Batch erfasst, und die Layer 21–39 werden separat auf dem gekürzten Batch erfasst. Dies macht CUDA graphs für gekürzten Prefill nutzbar und ermöglicht den Layern 21–39 die Verwendung ihrer eigenen Erfassungsgrößen für eine bessere Graph-Abdeckung.
SWA bounded replay ist für DeepSeek-V4.1 standardmäßig aktiviert und wird gesteuert durch --[no-]swa-bounded-replay.
Genauigkeits- und Leistungsergebnisse
Obwohl SWA bounded replay nicht exakt ist, hat DeepSeek nur vernachlässigbaren Qualitätsverlust gemeldet. Wir haben dies in vLLM an Benchmarks wie GSM8K und GPQA bestätigt und keinen bedeutenden Genauigkeitsunterschied beobachtet (Abweichungen innerhalb von etwa 1.5 Standardfehlern).
Bei der Leistung tauscht die Encoder-Seite ein Prefill-Fenster pro Treffer gegen Cache-Speicherplatz, daher stammt die Beschleunigung von der Decoder-Seite. Wir messen die Single-Request-Prefill-TTFT in drei Einstellungen: Replay aus; Replay an ohne Decoder-CUDA graphs (Layer 21–39 laufen im eager-Modus, und nur eager-Schritte werden gekürzt); und Replay an mit Decoder-CUDA graphs.
Decoder-Replay mit CUDA graphs reduziert die Prefill-Berechnungszeit um 30–40%. CUDA graphs sind am wichtigsten bei kurzen Prompts, wo Kernel-Starts der Engpass sind: Ohne sie übersteigt der Start-Overhead die GPU-Einsparungen, und das Replay ist langsamer als die Basislinie (bis zu +12% bei 1K auf DEP2). Bei langen Prompts ist die GPU-Arbeit groß genug, um den Start-Overhead zu verdecken, sodass eager-Replay bereits den Großteil des Gewinns erfasst und CUDA graphs noch einige Punkte mehr hinzufügen.
Kernels
DeepSeek veröffentlichte DeepSeek-V4.1-Flash zusammen mit neuen Kernels in drei seiner Repositorys. DeepSelect ist eine neue Top-k-Bibliothek für DeepSeek Sparse Attention. DeepGEMM fügte Sparse-Indexer-Kernels und mehrere GEMM-bezogene fusionierte Kernels hinzu. FlashMLA fügte NVFP4-KV-Cache-Unterstützung und einen fusionierten Attention-Kernel hinzu, MegaAttention. Wir haben mehrere dieser Open-Source-Kernels in vLLM integriert und verfolgen den Fortschritt in #57448.
Mega-mHC (#56962). Mega-mHC verschmilzt die mHC-Kette in einem Kernel: den Post-Schritt, den verzögerten Pre-Schritt und RMSNorm. Er ersetzt einen bestehenden TileLang-Fusionspfad, den DeepGEMMs Implementierung nun übertrifft. Der Kernel ist 1.14–1.51× schneller als die TileLang-Version auf NVIDIA GB200.
Mega-Gate (#56266). Mega-Gate verschmilzt den MoE-Router (Gate-GEMM, Expert-Scoring, Bias und Top-k-Auswahl) in einem Kernel. Zuvor liefen diese Operationen als ein GEMM gefolgt von einem separaten Top-k-Kernel, was einen zusätzlichen Launch und einen Roundtrip durch den Speicher für die Scores kostete. Diese Fusion führt zu 1.18–1.31× Kernel-Beschleunigungen bei mittleren Batchgrößen.
mHC-Multistream-Overlap (#57603). In V4.1 werden die mHC-Koeffizienten um eine Subschicht verschoben, sodass das GEMM der Koeffizienten für die nächste Nahtstelle nur Restströme liest, die bereits existieren, bevor Attention oder das FFN läuft. Keine Seite braucht die Ausgabe der anderen, bis der nächste Post/Pre-Schritt sie kombiniert. Bei kleinen Batchgrößen berechnet vLLM nun die Koeffizienten des nächsten mHC-Blocks auf einem separaten CUDA-Stream, parallel zu Attention und FFN. Dies verbirgt Arbeit, die sich sonst auf dem kritischen Pfad von latenzgebundenem Decode befände. Im TP4-Szenario mit niedriger Latenz reduziert dies die Latenz um etwa 4%.
Sparse-MQA-Logits (#56254). In V4.1 wählen spätere Indexer-Schichten ihr Top-k aus einem festen Satz von 16K Kandidatenpositionen. Frühere Implementierungen berechnen den Score für den gesamten Kontext und maskieren alle Nicht-Kandidaten-Blöcke vor dem Scoring. DeepGEMMs Sparse-Kernel bewerten nur die Kandidaten, sodass die Kosten nicht mehr mit dem Kontext wachsen. Pro Schicht auf NVIDIA GB300 ist es 1.2× schneller bei 8K Tokens und 14–23× schneller bei 512K. End-to-End auf 4× NVIDIA GB300 verbessert sich Decode um 3–6%. Prefill ist 1.43× schneller bei 512K und 2× schneller bei 1M Kontext.
MegaAttention mit NVFP4-komprimiertem KV (#56935). FlashMLAs MegaAttention-Kernel führt Query-RoPE, Sparse Attention, inverse RoPE auf der Ausgabe und die FP8-Konvertierung in einem einzigen Launch durch und schreibt direkt in den Puffer, den die Ausgabeprojektion liest. Dadurch entfallen die separaten Kernel und Speicher-Roundtrips zwischen Attention und der nächsten Schicht. Er liest auch ein neues NVFP4-komprimiertes KV-Format, das 45% kleiner ist als der bisherige FP8-KV-Cache. MegaAttention verbessert die Kernel-Effizienz zudem um 1.45× durch aggressive Fusion, die HBM-Schreibvorgänge zwischen Operationen eliminiert.
Fused-WO-A-Kernel mit niedriger Latenz (#58634). Für kleine Decode-Batches auf Blackwell verschmelzen wir inverse RoPE, FP8-Quantisierung, das WO-A-Batch-GEMM und MXFP8-Neuquantisierung in einem einzigen CuTe-DSL-Kernel, wodurch sich die Pre-WO-B-Kette von drei Kerneln auf einen reduziert. Die zentrale Idee ist, Zwischenaktivierungen on-chip zu halten und Datenbewegung mit Berechnung zu pipeline, um zusätzliche Kernel-Launches und Global-Memory-Roundtrips zu vermeiden, die bei kleinen Batchgrößen dominieren. Dies verbessert den fused WO-A-Pfad um bis zu ~2.1× und liefert bis zu ~6–7% niedrigere Inter-Token-Latenz bei niedriger Konkurrenz.
Engram. V4.1s Engram-Schichten schlagen Zeilen aus zwei großen FP8-Tabellen nach, die durch gehashte Token-n-Gramme gekennzeichnet sind. Jeder Schritt liest nur wenige Zeilen, daher sind Tabellenplatzierung und Lookup-Latenz wichtiger als Rechenleistung. Wir prefetchen CPU-offloaded Engram-Lookups asynchron und überlappen Host-Memory-Zugriffe mit Decoder-Berechnungen, um Decode mit kleinen Batches zu beschleunigen (#56512). Engram-Heads werden mit einem einheitlichen TP/DP-Schema geshardet, und kollokalierte DP-Replikate teilen sich dieselben Host-Tabellen, wodurch redundante Kopien und jegliche DP-Kommunikation auf dem Lookup-Pfad vermieden werden (#57651). Für diese großen host-residenten Tabellen unterstützen wir auch Transparent Huge Pages (THP), um Page-Fault-Overhead zu reduzieren, was bis zu 10× schnellere Lookup-Kernel für Prefills liefert (#56926). Wir haben auch Optimierungen für Fälle hinzugefügt, in denen nicht genug Huge Pages verfügbar sind (#59327).
Agentic-Leistung
Wir messen die Leistung mit dem SemiAnalysis AgentX Benchmark als repräsentativer agentic Serving-Workload (ausführlich in unserem vorherigen Beitragbeschrieben). Zusammen ergeben diese Optimierungen erhebliche Leistungsverbesserungen von vLLM gegenüber unserer Day-0-Implementierung. Wie Abbildung 6 zeigt, verbessert sich unser Low-Latency-Ergebnis um 1.9× gegenüber unserem Day-0-Ergebnis, und das High-Throughput-Ergebnis verbessert sich um etwa 5×.
Für Low-Latency-Serving verwenden wir TP4 mit FlashInfer-Attention. Decode mit kleinen Batches ist größtenteils durch Speicherbandbreite begrenzt, daher passt das Sharding der Modellgewichte auf vier GPUs gut dazu. Wir haben auch MegaAttention ausprobiert, aber sein Hauptvorteil liegt in Einstellungen mit höherem Durchsatz, wo Fusion mehr Spielraum hat. Bei TP4 war dieser Vorteil viel kleiner, und FlashInfer war in unseren Läufen letztlich schneller.
Für hohen Durchsatz wechseln wir zu DEP2 und verwenden DP Attention, wobei die Experten auf GPUs aufgeteilt sind. Da V4.1 einen gemeinsamen KV-Latent über alle Köpfe hinweg nutzt, würde TP den KV-Cache über die GPUs hinweg duplizieren. DP vermeidet diese Duplizierung: Jede GPU speichert KV nur für die Anfragen, die sie bedient, wobei Session-Affinity die Prefix-Cache-Lokalität über mehrere Runden hinweg bewahrt. MegaAttention reduziert den KV-Fußabdruck pro Anfrage zusätzlich mit NVFP4, was ihn gegenüber FP8 nahezu halbiert und die Parallelität pro GPU erhöht.
Bemerkenswert ist, dass V4.1 äußerst speichereffizient ist und im gesamten Benchmark kein KV-Cache-Offloading benötigt. Wir erwarten, dass KV-Cache-Offloading bei höherer Parallelität mit P/D-Disaggregierung zunehmend hilft.
SWA bounded replay verbesserte zusammen mit Kernel-Optimierungen auf der Prefill-Seite auch die TTFT erheblich.
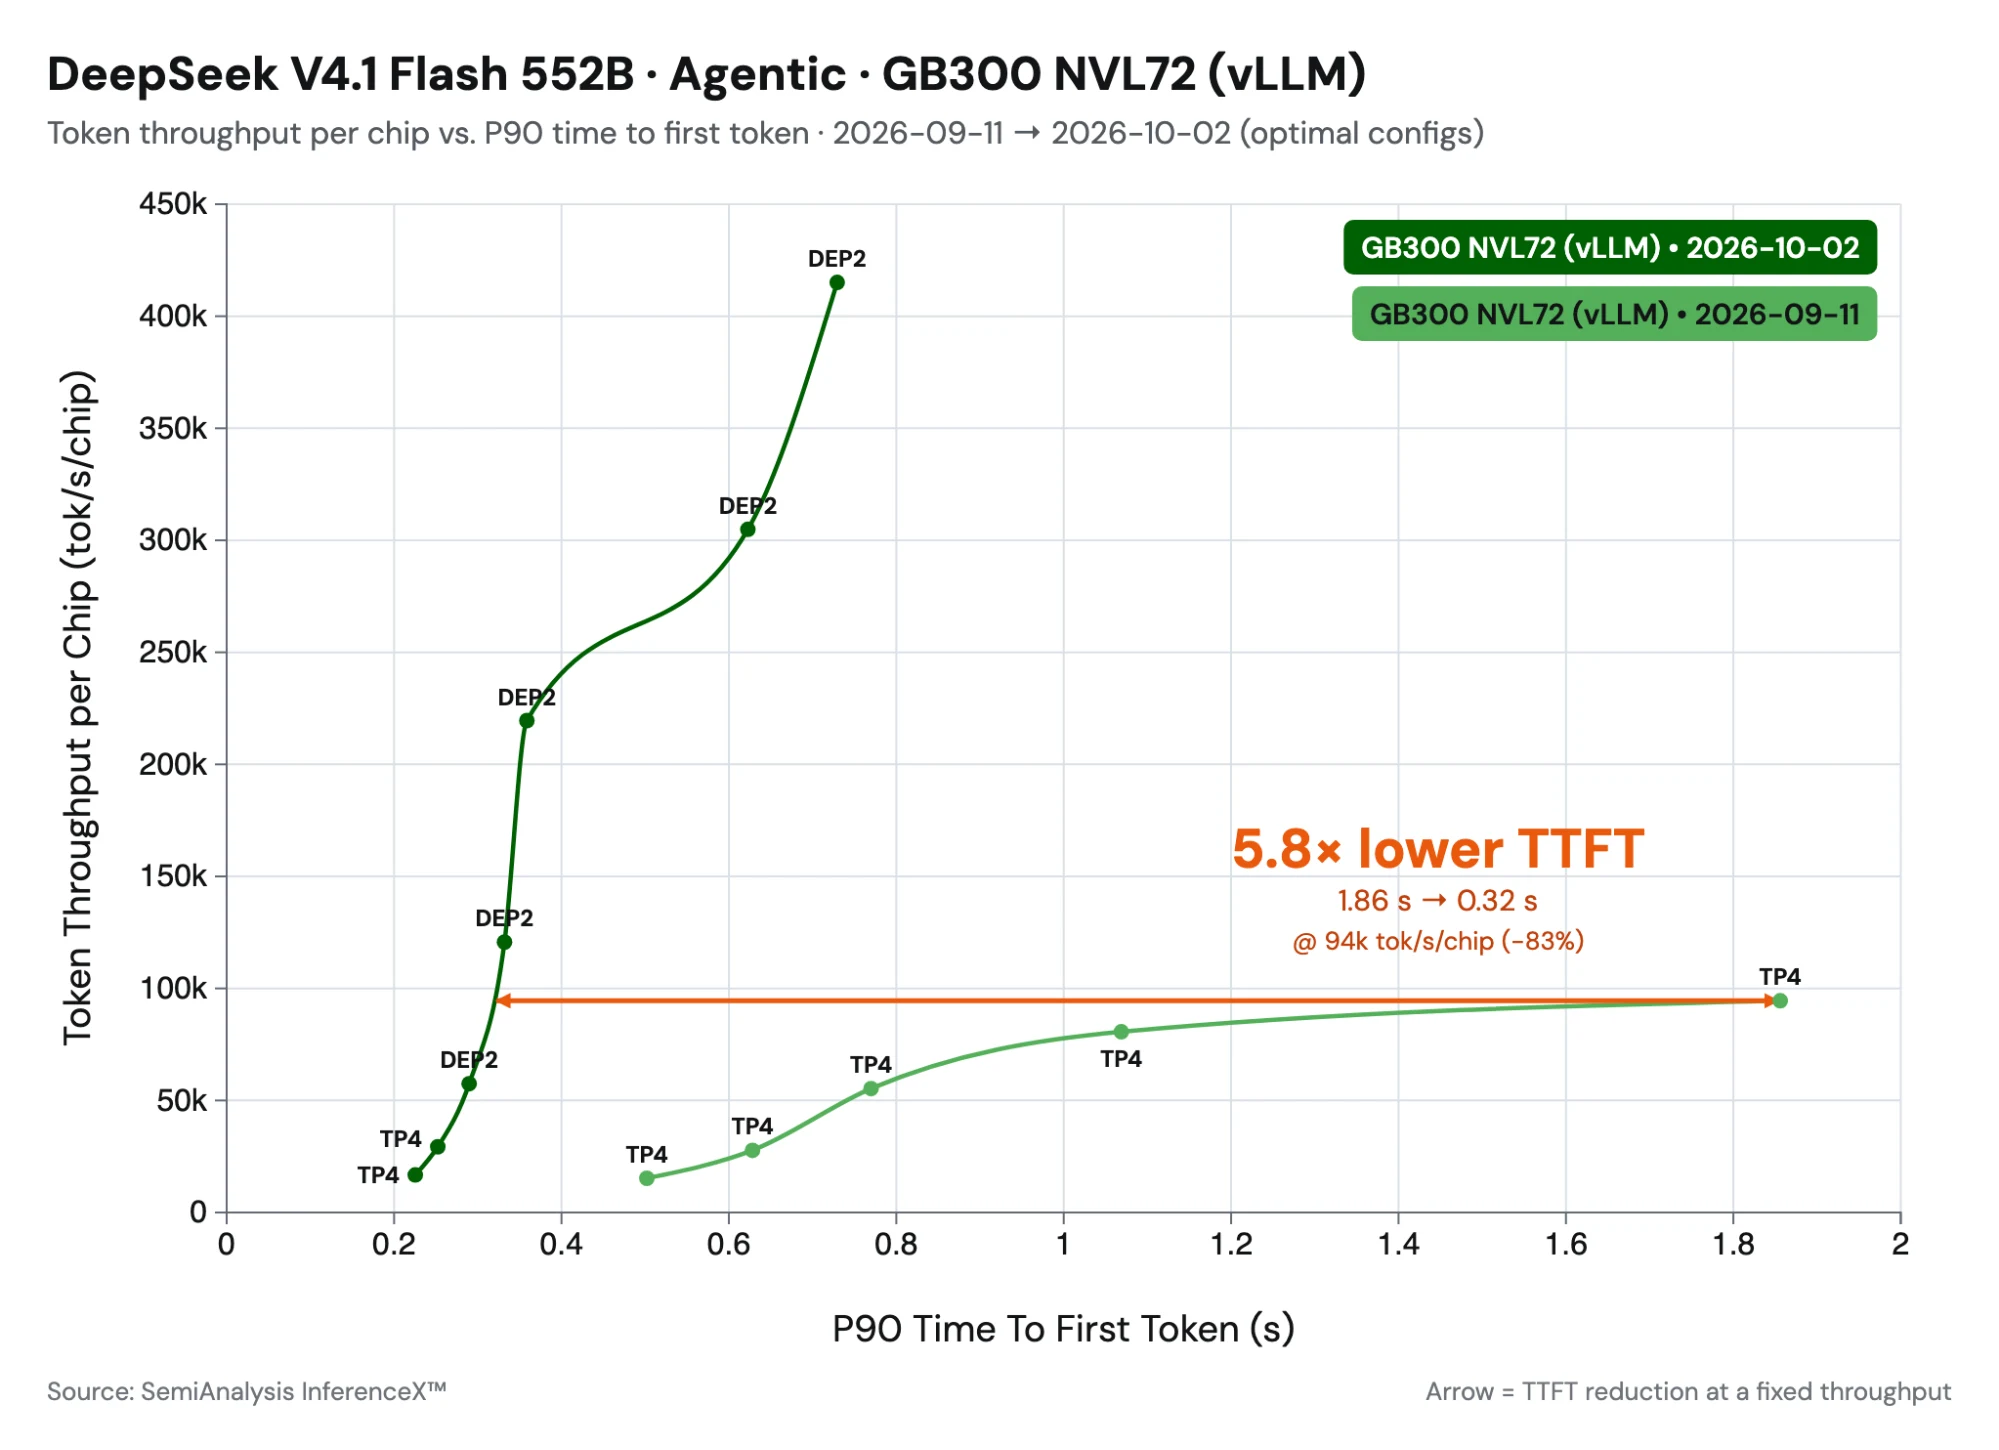
Abbildung 7 zeigt den optimierten TTFT–Durchsatz-Kompromiss. Bei einem Durchsatz von rund 100K sinkt die TTFT durch drei kombinierte Optimierungen um fast 70%:
-
SWA bounded replay lässt die obere Hälfte des Modells nur die letzten 128 Tokens verarbeiten und halbiert damit die Prefill-Berechnung ungefähr.
-
CUDA Graphs halten die kleine, gekürzte Wiederholung schnell auf der GPU, statt durch CPU-Kernel-Launches begrenzt zu sein, sodass wir die volle Beschleunigung realisieren.
-
Kernel-Verbesserungen beschleunigen die Modellberechnung.
Danksagungen
Wir danken DeepSeek für die Open-Source-Veröffentlichung von DeepSeek-V4.1-Flash und den zugehörigen Kernels, dem Inferact-Team für den anfänglichen Model Bring-up und die Optimierungen, NVIDIA für die Zusammenarbeit und Unterstützung sowie SemiAnalysis für den AgentX-Benchmark.