
IT之家 Nachricht vom 8. Oktober: Bei einer Veranstaltung am 7. Oktober um 10 Uhr Pazifikzeit (1 Uhr Pekingzeit am 8. Oktober) in San Francisco, USA, kündigte Microsoft an, dass GitHub Copilot noch vor Monatsende lokale KI-Modell-Inferenz unterstützen wird,Entwickler können automatisch oder manuell zwischen Cloud-Modellen und On-Device-Modellen wechseln.
GitHub Copilot ist ein KI-Programmierassistent von Microsoft, der sich in Tools wie Visual Studio Code und die CLI integrieren lässt und anhand des Codekontexts Vervollständigungen, Erklärungen oder Refactoring-Vorschläge generiert.
GitHub Copilot ist derzeit auf in der Cloud gehostete Modelle angewiesen, wobei ein Koordinator die Anfragen nach Leistung, Kosten und Genauigkeit weiterleitet. Microsoft plant, diesen Mechanismus noch in diesem Monat zu erweitern, sodass Copilot automatisch zwischen Cloud-Modellen und lokalen KI-Modellen wählen und Inferenzaufgaben im Hintergrund koordinieren kann.
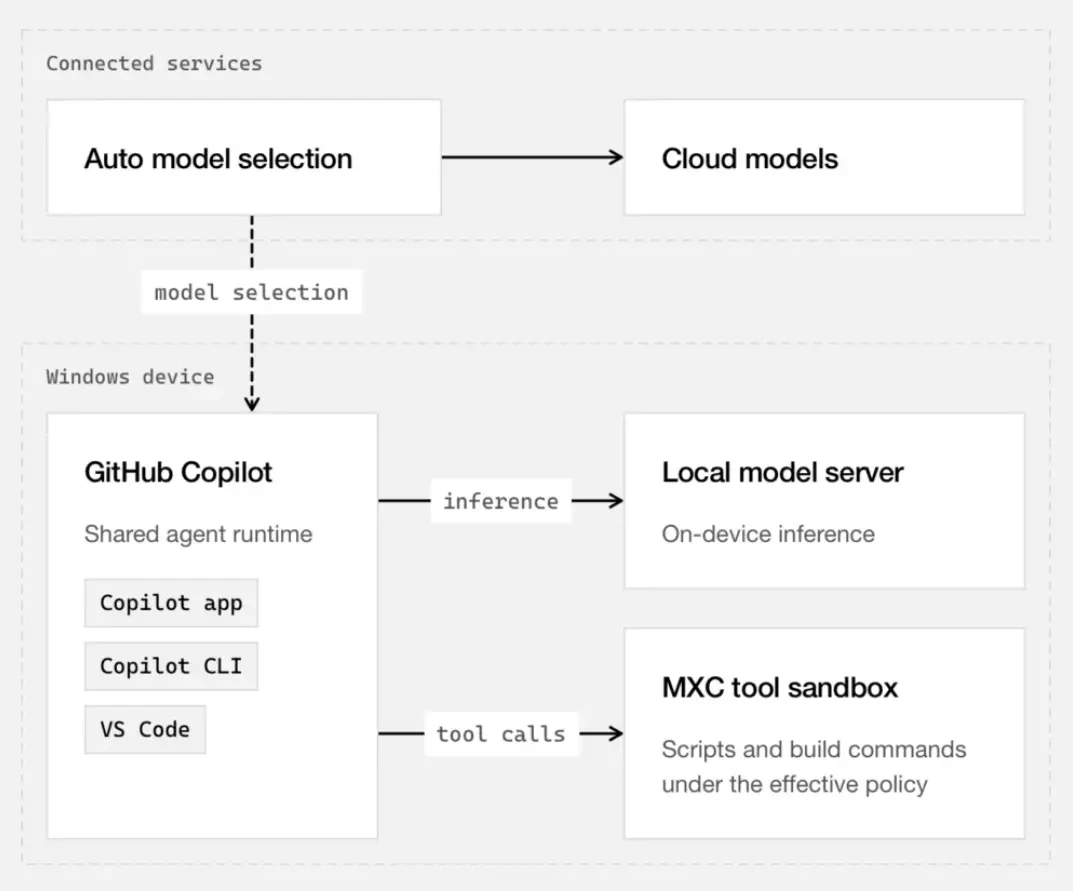
Microsoft bietet GitHub-Copilot-Nutzern zwei Modi an: automatische Orchestrierung oder erzwungene Verwendung des On-Device-Modells. Nutzer können ihre Präferenzen in der GitHub Copilot CLI, in der Copilot-App und in Visual Studio Code festlegen.
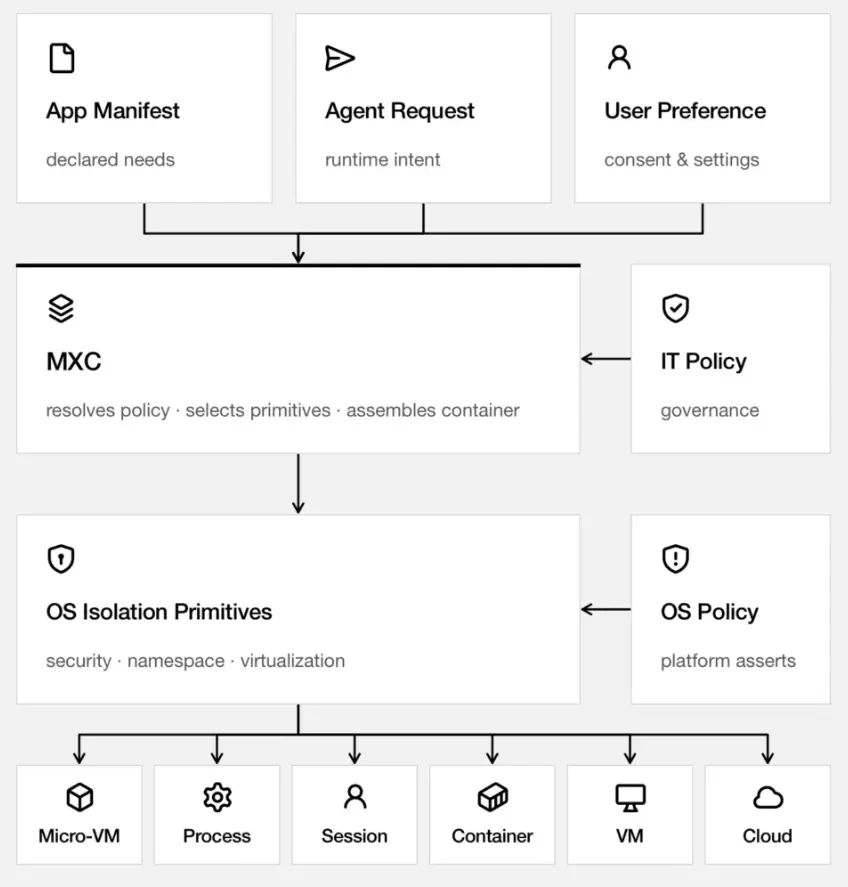
Die Auswahl des lokalen Modells unterstützt die Angabe von Anbieter, Modell oder Endpunkt; Entwickler können über Windows ML MAI Code 1.1 Flash auswählen oder einen OpenAI-kompatiblen lokalen Endpunkt verbinden und eines der dort bereitgestellten Modelle nutzen.
Microsoft hat das „Mixture-of-Experts“-Modell MAI Code 1.1 Flash mit insgesamt 137 Milliarden Parametern und 6,8 Milliarden aktiven Parametern vorgestellt, das durch Quantisierung und Speculative Decoding Reaktionsgeschwindigkeit und Speicherverbrauch optimiert.
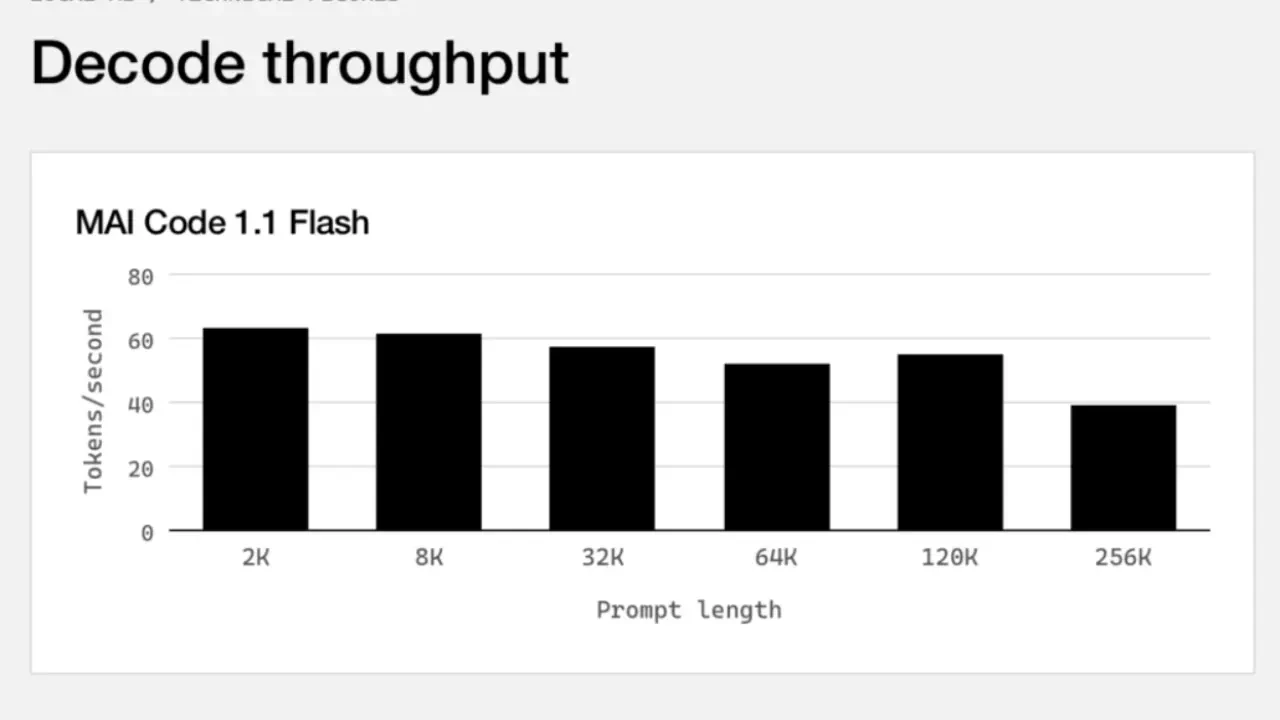
Praxistests des Modells auf dem Surface Laptop Ultra zeigten deutliche Verbesserungen bei der Spitzenspeichernutzung, der Token-Auslastung und der Verarbeitungsgeschwindigkeit bei komplexen Aufgaben. Tests zur Decodierungs-Durchsatzrate zeigten bei Prompt-Längen von 2K bis 256K Token einen Durchsatz zwischen 40 und 63 Token pro Sekunde. IT之家 fügt die zugehörigen Bilder wie folgt an:
Sonderthema zur Microsoft-Surface-Laptop-Ultra-Veranstaltung