
Was der KI beibringt, ARC-Abstraktionsrätsel zu lösen, sind ausgerechnet Katzen?
In der neuesten Arbeit von He Kaimings Team wirdNAT-ARC vorgestellt, ein rein visuelles Verfahren zur Lösung von ARC.
Es verlässt sich nicht auf LLMs, sondern nutzt Katzen, Hunde, Blumen und Gras von ImageNet zur Vortraining, damit das Modell lernt zu „sehen“, und überträgt dies dann auf abstraktes Gitter-Reasoning.
Im Ergebnis erreichte das beste Einzelmodell von NAT-ARC einen pass@2-Score von 63,4 % auf ARC-1, nach Ensembling waren es 70,2 %.
Dies ist das erste Mal, dass ein rein visuelles Verfahrensich dem Niveau spezialisierter LLM-Systemeannähert.
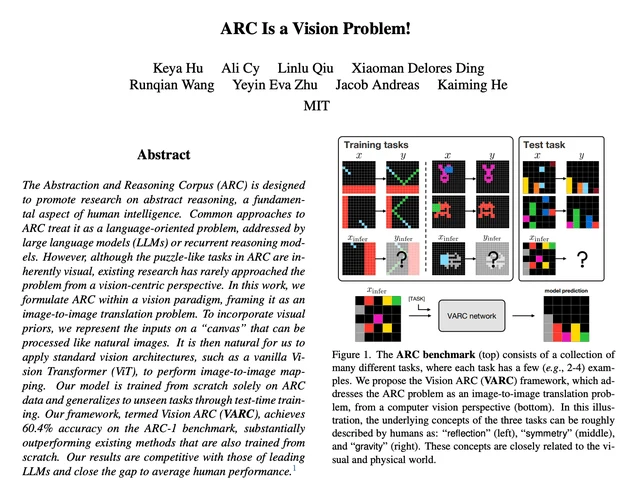
ARC gilt als einer der schwersten KI-Visuellen-Intelligenztests: Man erhält einige Ein-/Ausgabebeispiele mit farbigen Gittern, soll die dahinterliegende verborgene Transformationsregel erschließen und diese dann auf neue Gitter anwenden.
Bisherige dominante Lösungsansätze übersetzten die Gitter durchweg in Text oder Symbole und überließen das Reasoning dem LLM.
Diese Arbeit macht es gerade anders und nutzte nicht einmal ARC-Gitter in der Vortrainingsphase.
Die visuellen Fähigkeiten, die das Modell aus der realen Welt gelernt hat, wurden mühelos auf das völlig abstrakte Reasoning mit farbigen Gittern übertragen.
ARC-Rennstrecke: Der Aufstieg der visuellen Verfahren
ARC steht für Abstraction and Reasoning Corpus und wurde 2019 von Keras-Erfinder François Chollet vorgeschlagen.
Jede ARC-Aufgabe hat ein einheitliches Format: ein zweidimensionales Gitter von maximal 30×30 mit höchstens 10 Farben; die Aufgabe liefert 2 bis 5 Ein-/Ausgabebeispielpaare, und der Herausforderer muss aus den Beispielen die verborgene Transformationsregel ableiten und diese Regel auf ein völlig neues Eingabegitter anwenden, um dessen Ausgabe vorherzusagen.
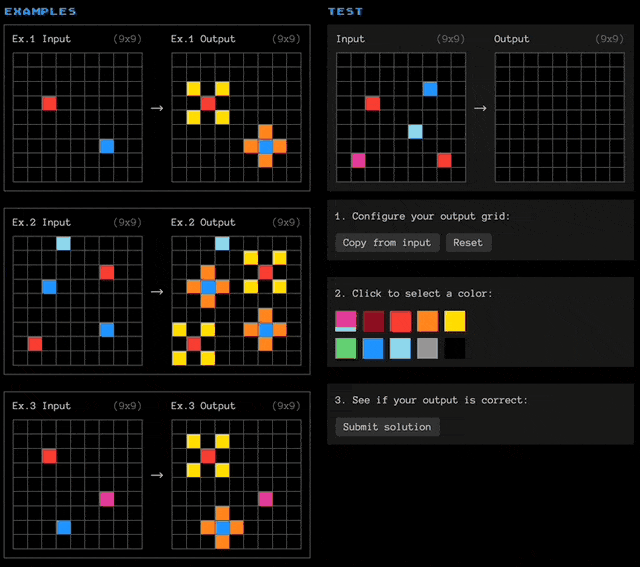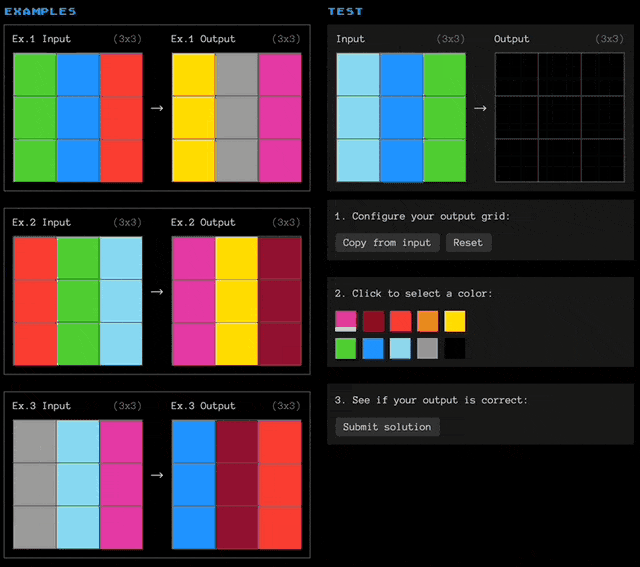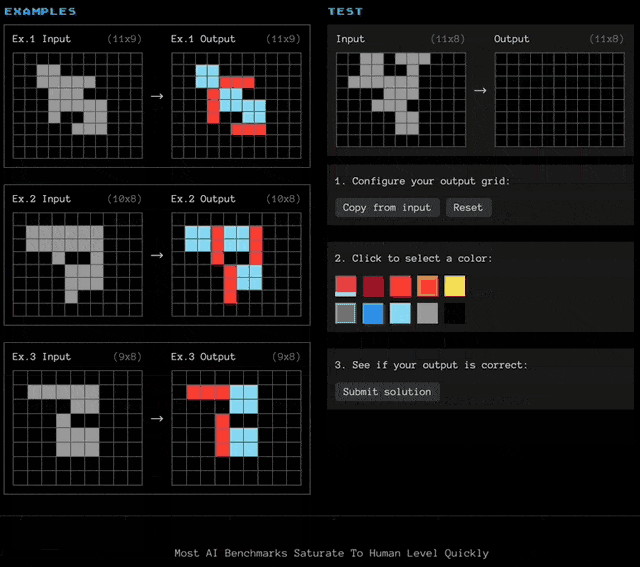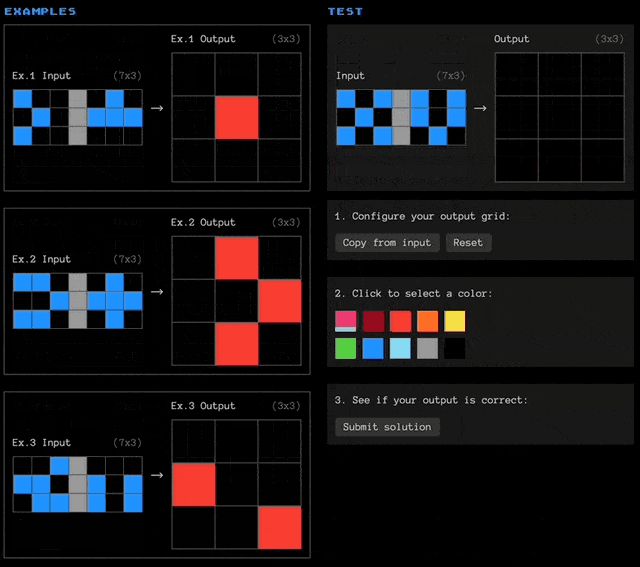
Diese Aufgaben klingen nach kindlichen Intelligenzrätseln zum Musterfinden in Bildern, doch für KI ist ARC extrem schwer.
Zum einen ist die Veränderungsregel jeder Aufgabe anders – es gibt kein festes Muster zum Auswendiglernen.
Hinzu kommt, dass die Datenmenge winzig ist: Aus zwei, drei Beispielen müssen abstrakte Regeln abgeleitet und präzise ausgeführt werden.
Diese Kombination machte ARC zumBenchmark für die Messung abstrakter Reasoning-Fähigkeiten von KI.。
Derzeit dominieren auf der ARC-Rennstrecke fast ausschließlich LLM-Ansätze; deren gemeinsame Strategie besteht darin, die Gitter in Text- oder Symbolsequenzen zu übersetzen und sie dem Sprachmodell zu übergeben.
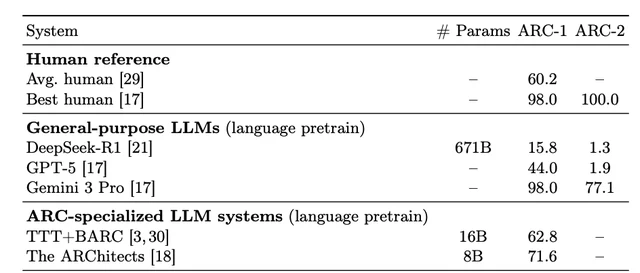
Der visuelle Weg begann erst später aufzusteigen.
Eine Gruppe von Forschern schlug einen völlig anderen Weg ein: Statt die Gitter in Text zu übersetzen, ließen sie visuelle Modelle die Gitterbilder direkt verarbeiten.
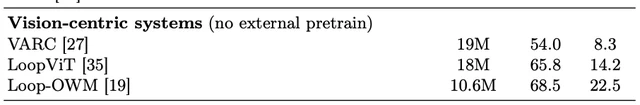
Der wichtigste Schritt darin stammt von demselben MIT-Team, dasVARCvorschlug; diese Methode definiert ARC als bedingte Bild-zu-Bild-Übersetzungsaufgabe neu und erreicht mit einem visuellen Modell mit 19M Parametern 54 %.
LoopViT fügt in diesem Rahmen einen rekursiven Reasoning-Mechanismus hinzu und erreicht mit 18M Parametern 65,8 %.
Loop-OWM nutzt ein videovortrainiertes Modell für few-shot und erreicht mit 10,6M Parametern 68,5 %.
Diese Modelle sind um mehrere Größenordnungen kleiner als die LLM-Ansätze, aber ihre Leistung beginnt gleichzuziehen.
Doch der visuelle Weg hat weiterhin einen strukturellen Schwachpunkt.
Dass LLMs bei ARC immer bessere Ergebnisse erzielen, hat unter anderem den Grund, dass sie durch das Pretraining auf riesigen Textkorpora allgemeine Fähigkeiten aufgebaut haben: Je größer das Modell und je umfassender das Pretraining, desto deutlicher fällt das Scaling bei nachgelagerten Aufgaben aus.
Die Modelle der meisten visuellen ARC-Ansätze werden hingegen von einer zufälligen Initialisierung aus trainiert und profitieren nicht von den Vorteilen des Pretrainings.
Darauf aufbauend besteht das Ziel von NAT-ARC darin, für den visuellen Weg den Schritt des Pretrainings nachzurüsten und dessen Scaling-Engpass zu überwinden.
Nach den Katzenbildern folgt die Herausforderung ARC
Der Kerngedanke von NAT-ARC ist,vor den visuellen Ablauf von VARC einen Schritt mit ImageNet-MAE-Pretraining einzufügen.。
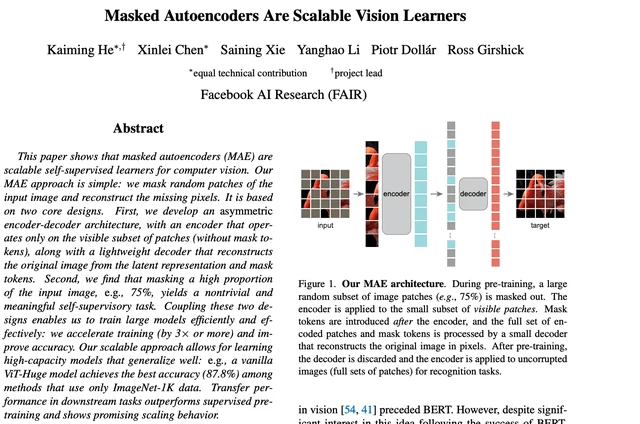
MAE (Masked Autoencoder) ist eine 2022 von Kaiming He während seiner Zeit bei FAIR vorgeschlagene Methode zum selbstüberwachten visuellen Pretraining.
Beim Trainingsprozess wird ein Bild großflächig verdeckt, und das Modell muss das Originalbild aus den verbleibenden Fragmenten wiederherstellen.
Durch diese Aufgabe kann das Modell die Form von Objekten, deren Struktur und räumliche Beziehungen verstehen.
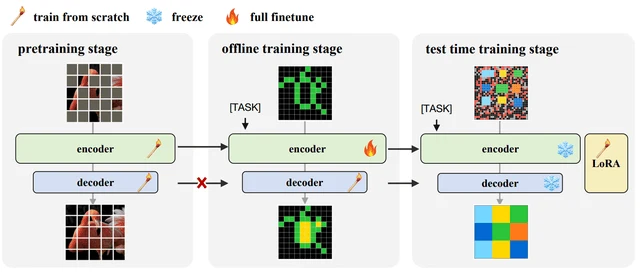
Bei NAT-ARC werden die auf ImageNet (ein Datensatz mit etwa 1,3 Millionen natürlichen Bildern von Katzen, Hunden, Blumen, Pflanzen usw.) trainierten Encoder-Gewichte von MAE direkt zur Initialisierung des visuellen Encoders verwendet, während der Decoder ab einer zufälligen Initialisierung trainiert wird.
Der gesamte Ablauf besteht aus drei Schritten.
- Erster Schritt: Vortraining des Encoders mit MAE auf ImageNet;
- zweiter Schritt: Offline-Training des gesamten Encoder-Decoders auf dem ARC-Trainingssatz;
- dritter Schritt: beim Testen ein LoRA-Finetuning für jede Aufgabe einzeln.
In der Feinabstimmungsphase gibt es pro Aufgabe nur 2 bis 5 Demonstrationspaare, und das Modell versucht, anhand dieser wenigen Beispiele die Regel der jeweiligen Aufgabe zu „lernen“.
Ein Detail ist bemerkenswert: NAT-ARC nutzt direkt den öffentlichen Checkpoint von MAE, ohne einen einzigen Cent zusätzlich für Vortraining auszugeben.
Allerdings wurde dieser Checkpoint ursprünglich für größere ImageNet-Bilder entworfen, während ARC-Gitter nur 64×64 Pixel groß sind – die Größenunterschiede sind erheblich.
Zur Anpassung verwirft NAT-ARC das ursprüngliche Patch-Embedding und die Positionskodierung, behält nur die Backbone-Gewichte und verwendet stattdessen 2D RoPE als Positionskodierung.
Kurz gesagt behält NAT-ARC nur die auf ImageNet erworbene Fähigkeit von MAE zur Extraktion visueller Merkmale, wirft aber alle an die Bildgröße von ImageNet gebundenen räumlichen Wahrnehmungsteile weg und lernt sie auf flexiblere Weise neu.
Doch warum sollte etwas, das aus Katzen- und Hundefotos gelernt wurde, der abstrakten Gitter-Inferenz zugutekommen?
Die Arbeit liefert mit einer Aufmerksamkeitsvisualisierung einen Hinweis.
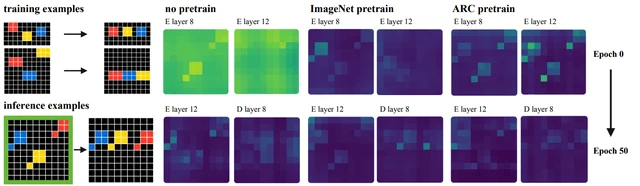
Die Forscher stellten Modelle mit drei verschiedenen Initialisierungsarten (ohne Vortraining, mit ImageNet-MAE-Vortraining und mit ARC-artigem Gitter-MAE-Vortraining) vor dieselbe ARC-Aufgabe und beobachteten ihre Aufmerksamkeitsverteilung, bevor sie überhaupt mit dem ARC-Training begannen.
Das Ergebnis war deutlich: Bei zufällig initialisierten Modellen war die Aufmerksamkeit gleichmäßig verteilt und ohne Schwerpunkt; das mit ImageNet vortrainierte Modell konnte dagegen bereits Vordergrund und Hintergrund unterscheiden und richtete seine Aufmerksamkeit automatisch auf die bedeutungsvollen Musterbereiche im Gitter.
Dieses Modell hatte noch nie ein ARC-Gitter gesehen, doch die auf ImageNet erworbene Fähigkeit, „Objekte vom Hintergrund zu unterscheiden“, wirkte auf ARC-Gittern ganz natürlich.
Die Forscher gingen noch weiter und zerlegten das Ergebnis auf Task-Ebene.
Sie filterten 15 ARC-Aufgaben heraus, die sich durch das Vortraining signifikant verbessert hatten, und stellten nach manueller Kennzeichnung fest, dass sich diese Aufgaben auf zwei Aufgabentypen konzentrieren.
Davon gehören 6 zum Typ match-and-copy, bei dem das Modell übereinstimmende Objekte, Farben oder Muster erkennen und die entsprechende Struktur dann in die Ausgabe kopieren muss;
weitere 6 gehören zum Typ connected-component reasoning, bei dem das Modell räumlich zusammenhängende Bereiche erkennen, ausfüllen oder neu einfärben muss.
Diese beiden Fähigkeiten entsprechen genau visuellen Prior aus natürlichen Bildern.
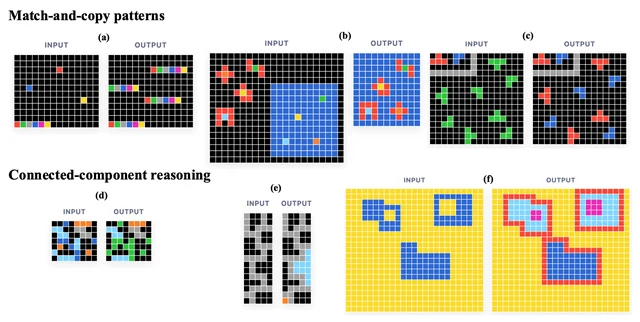
Das auf ImageNet beim Betrachten von Katzen gelernte „die Katze vom Wiesenhintergrund zu trennen“ wurde in ARC zu „diesen zusammenhängenden farbigen Bereich aus dem Gitter zu erkennen“.
Die Grundlogik der visuellen Welt und der abstrakten Welt teilt sich also bei Operationen wie Objektgruppierung, Musterabgleich und Regionensegmentierung offenbar dieselben Repräsentationen.
Aus Katzen gelernt, auf Katzen angewendet
Die Ergebnisse von NAT-ARC auf ARC-1 sind schließlich wie folgt.
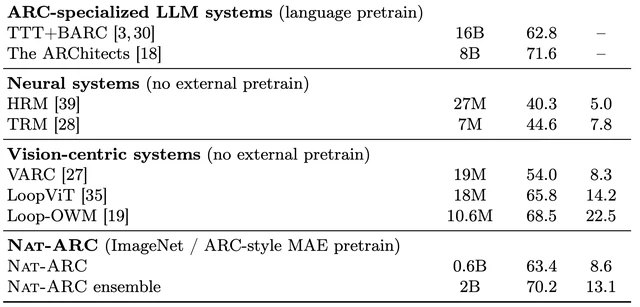
Das leistungsstärkste Einzelmodell nutzt die huge-Größe mit 0,6B Parametern und erreichte ein pass@2-Ergebnis von 63,4±0,7%.
Beim Ensembling poolten die Forscher die mit drei verschiedenen Vortrainingsstrategien (ohne Vortraining, mit ImageNet-MAE-Vortraining, mit ARC-artigem Gitter-MAE-Vortraining) trainierten Modelle und führten eine Mehrheitsabstimmung durch, womit sie 70,2±0,6% pass@2 mit insgesamt etwa 2B Parametern erreichten.
Als Vergleichspunkt erreichten The ARChitects, die speziell auf ARC feingetunt waren, 71,6% – mit einem Sprachmodell mit 8B Parametern.
Der visuelle Ansatz erreichte mit einem Viertel der Parameterzahl die Tore dedizierter LLM-Systeme.
Über die Zahlen hinaus ist der wichtigste Befund dieser Arbeit, dass das Vortraining den Skalierungs-Engpass des visuellen Ansatzes überwand.
Ohne Vortraining verschlechterten größere Modelle das Ergebnis sogar; erst mit Vortraining begann das Skalieren, positive Erträge zu bringen.
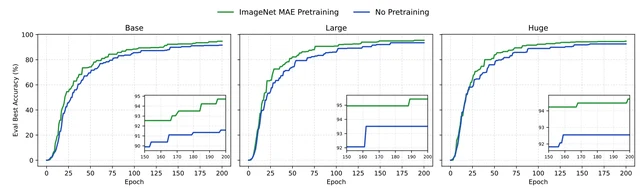
Schauen wir uns zunächst die Trainingskurven an. In der Offline-Trainingsphase konvergierte das Modell mit ImageNet-Vortraining deutlich schneller, und zwar auf allen drei Skalierungsstufen base, large und huge, mit am Ende auch höherer Genauigkeit.
Der interessanteste Fund versteckt sich jedoch in den Scaling-Kurven.
Ohne Vortraining stieg die Leistung beim Übergang von base zu large noch, ging aber von large zu huge sogar zurück.
Das Modell wird größer, die Ergebnisse werden schlechter – ein in Deep Learning ungewöhnliches Phänomen, das zeigt, dass die Datenmenge der ARC-Aufgabe einfach zu gering ist: Das Wachstum der Modellkapazität brachte keine bessere Generalisierung, sondern Overfitting.
Mit ImageNet-Vortraining dagegen wurde die Scaling-Kurve gesund: Auf allen drei Stufen base, large und huge stiegen die Werte kontinuierlich an – je größer das Modell, desto besser das Ergebnis.
Ein besonders cooles Experiment im Paper ist eine visuelle Verifikation.
Die Forscher trainierten einen Autoencoder, der ImageNet-Bilder in eine diskrete Rasterdarstellung mit 60×60 Zellen und 10 Farben abbildete – eine Katzenbild wurde damit gewissermaßen in ein ARC-Raster „übersetzt“.
Anschließend führten sie mit NAT-ARC eine ARC-Transformation auf diesem Raster aus – eine Drehung um 180° plus einen blauen Rahmen rundherum – und dekodierten es zurück in Pixel.
Das Ergebnis: Die Katze war tatsächlich gedreht, der Rahmen tatsächlich hinzugefügt. Das aus Katzenbildern trainierte Modell kehrte in dieser Aufgabe wieder zu den Katzen zurück.
Dieses Experiment verwandelte die Aussage „Natürliche Bilder und ARC-Raster teilen sich denselben Repräsentationsraum“ von einer statistischen Zahl in einen visuellen Beweis.
Die auf ARC-Rastern gelernten Transformationsregeln lassen sich direkt auf latente Repräsentationen natürlicher Bilder anwenden – und umgekehrt genauso.
Die Verbindung zwischen abstrakten Regeln und visuellen Repräsentationen existiert in diesen beiden Welten also von vornherein.
Über die Autoren
Die Erstautorin des Papers, Xiaoman Delores Ding, ist Mitglied am MIT CSAIL und stammt aus der Gruppe von Kaiming He.
Sie ist zugleich Erstautorin von VARC; NAT-ARC baut gewissermaßen direkt auf ihrer vorherigen Arbeit auf und treibt sie weiter voran.
Zu den weiteren Autoren gehört Keya Hu, eine der ersten Studentinnen von Kaiming He, die ihr Bachelorstudium an derShanghai Jiao Tong University。
abschloss. Außerdem Katelyn Gan und Victor Yin, ebenfalls vom MIT, beide Bachelorstudierende und beide als student researcher am CSAIL tätig.
Der korrespondierende Autor Kaiming He braucht kaum eine Vorstellung: Er ist der Autor von ResNet und MAE, und anhand dieser beiden Arbeiten lässt sich nahezu die Hauptlinie der visuellen KI der letzten zehn Jahre nachzeichnen.
Seit seinem Wechsel zum MIT liefert er kontinuierlich Grundlagenarbeiten zur visuellen KI; dieses Paper verwendet ausgerechnet die von ihm selbst vor vier Jahren vorgeschlagene MAE als Vortraining-Werkzeug – er schlägt mit einer alten eigenen Waffe einen neuen Weg ein.
VARC wurde bereits bei der CVPR 2026 angenommen, NAT-ARC ist deren direkte Fortsetzung.
Dieses Team beharrt mit zwei aufeinanderfolgenden Papern auf einer rein visuellen Route zur Lösung von ARC und突破t auf einer Strecke, auf der LLMs dominieren, mit experimentellen Daten immer wieder die Obergrenze des visuellen Ansatzes.
Paper-Adresse:
https://eccv.ecva.net/virtual/2026/poster/5527