
Yunzhong, berichtend aus Ao Fei Si
Quantum Bit | Öffentlicher Account QbitAI
OpenAI wirft in letzter Zeit wirklich Schlag auf Schlag schwere Bomben in die mathematische Welt.
Im letzten Monat verkündete OpenAI, dass sein AI-Modell in nur 88 Stunden eines der sieben großen Millenniums-Probleme gelöst hat, das die Menschheit seit hundert Jahren beschäftigt – die Navier-Stokes-Gleichungen; gestern veröffentlichte man zudem 722 mathematische Manuskripte, darunter gleich drei zum Millenniums-Problem.
Doch im PaperBenchX-Bewertungstest von UniPat AI, mit 93 echten Aufgaben zur Reproduktion von Paper, erreichte das stärkste Modell, GPT-6 Astra, eine vollständige Reproduktionsrate von nur 13,98 %.
△Gesamtleistung und leistungsphasen der 10 getesteten Konfigurationen bei 93 Reproduktionsaufgaben
Lass uns den Gedanken nachgehen!Aktuelle Modelle sind zwar bereits zu großartigen Durchbrüchen wie der Lösung von Millenniums-Problemen der Mathematik fähig, doch eine verlässliche End-to-End-wissenschaftliche Reproduktion gelingt ihnen selten.
(Mit ernstem Gesicht) Das wirft einige Fragen auf: Im breiten Feld von AI for Science – anhand welcher Kriterien sollen wir beurteilen, ob „die Wissenschaft richtig gemacht“ wurde? Im Sinne einer rigorosen und soliden Forschungshaltung: Was ist eigentlich der erste Schritt auf dem Weg zum AI-Mathematiker und gar zum General AI Scientist? Und wie sollten wir einen verifizierbaren und vergleichbaren Maßstab entwickeln, um den Fortschritt von AI in der wissenschaftlichen Forschung wirklich zu messen?
Mit welchem Maßstab soll man den Fortschritt von AI in der Wissenschaft messen?
Lassen wir uns in diesem Moment noch einmal die öffentliche Brief genauer zu Herzen gehen, die von Terence Tao, Yu Deng und insgesamt 25 Fields-Medaillengewinnern gemeinsam veröffentlicht wurde.
Sie bestätigen zwar, dass die mathematischen Fähigkeiten großer Sprachmodelle rasant gestiegen sind und diese bereits bedeutende Probleme der Mathematik lösen können, stellen aber eine noch entscheidendere Frage:AI-Unternehmen behandeln die Lösung mathematischer Probleme als Benchmark-Test, was für die Mathematik als Wissenschaft und für die mathematische Gemeinschaft schädlich ist.
Dies ist also kein Brief gegen AI; er stellt eine viel schlichtere Frage:Mit welchem Maßstab misst man eigentlich den Fortschritt von AI in der Wissenschaft?
Im Brief steht auch ein Satz mit noch größerem Gewicht: Das Missverhältnis, mathematische Problemlösungen als Benchmark-Test zu behandeln, ist nur Teil eines umfassenderen Missverhältnisses, das gleichermaßen andere wissenschaftliche und kreative Berufe sowie die gesamte Gesellschaft betrifft.
Tatsächlich werden die oben genannten Fragen, wenn man sie vom Bereich der Mathematik auf die Naturwissenschaften und gar auf gesellschaftliche Bereiche ausweitet, nur noch schwieriger zu beantworten sein.
Die Mathematik hat zumindest eine letzte Verteidigungslinie: Lean. Ob ein Beweis korrekt ist, kann die Maschine Schritt für Schritt überprüfen; die Wahrheit oder Falschheit der Antwort hat ein Sicherheitsnetz.
In anderen wissenschaftlichen Bereichen hingegen gibt es für einen Reflexionskoeffizienten einer elektromagnetischen Simulation, ein Banddiagramm oder eine konvergierte Bandlücke kein Lean. Eine Zahl, die mit dem Paper übereinstimmt, kann dahinter ein falsches physikalisches Modell verbergen, eine nicht konvergierte Simulation oder eine ungültige Nachbearbeitung, die zufällig einen plausiblen Wert ergibt.
Bevor man also die Fähigkeiten eines General AI Scientist misst, der eigenständig Probleme formuliert, Experimente entwirft und neue Entdeckungen macht, gibt es eine grundlegendere Frage:Kann er eine bereits veröffentlichte wissenschaftliche Arbeit zuverlässig wiederholen und nachweisen, dass er es richtig gemacht hat?
Die Logik hinter dieser Frage ist: Da eine Reproduktion eine eindeutig richtige Antwort hat, kann sie präzise bewertet werden.
Eine kürzlich von UniPat AI veröffentlichte Arbeit„PaperBenchX“zielt genau darauf ab – sie erstellt aus 93 Forschungs-Papern 93 Reproduktionsaufgaben. Diese Aufgaben erstrecken sich über 12 Forschungsrichtungen und 10 domänenspezifische wissenschaftliche Umgebungen, darunter Elektromagnetismus, Photonik, Chemie, Materialwissenschaft, Biologie und Robotik, und umfassen 3168 von Experten validierte Bewertungspunkte.Es ist der erste multidisziplinäre End-to-End-Benchmark der Welt zur Reproduktion von Paper-Ergebnissen.
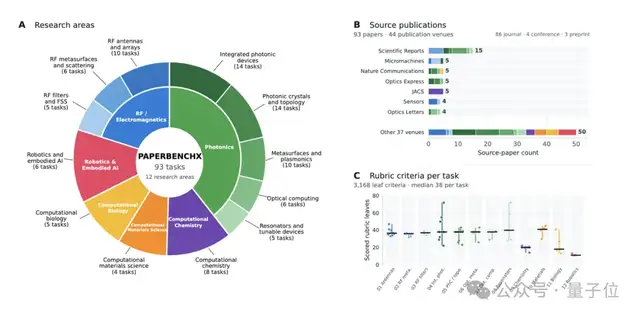
△Aufgabenverteilung, Quell-Paper und Zusammensetzung der Bewertungspunkte von PaperBenchX
Die Prüfungsregeln von PaperBenchX sind ganz einfach:
Der Agent erhält eineechte wissenschaftliche Arbeit, eine containerisierte Umgebung, in der die entsprechende wissenschaftliche Software bereits installiert ist, sowie ein Aufgabenblatt, das beschreibt, „welcher Teil reproduziert werden soll“.;
Der Agent gibt zurück: einenausführbaren Reproduktions-Workflow;
. Bewertungskriterien, Toleranzen und Referenzantwortenbleiben dem Agent vollständig verborgen。
. Ein besonders wichtiger Punkt: Die Arbeit selbst ist öffentlich, der Agent kann die Ergebniszahlen in der Arbeit natürlich sehen. Doch offensichtlich prüft diese Prüfung nicht, ob man „die Antwort errät“, sondern ob die KI in der Lage ist, einen wissenschaftlich tragfähigen Ablauf nachzubauen und selbst die Belege zu erzeugen, die diese Schlussfolgerung stützen.
Was misst PaperBenchX also eigentlich?
Die Antwort: Es misst nicht, „wie viele Zahlen man erhalten hat“, sondern erkennt nur neu erzeugte Belege an. Nach der Abgabe des Agents löscht das System sämtliche Ausgaben, trennt die Netzwerkverbindung und führt den Workflow in einer isolierten Umgebung von Grund auf erneut aus. Der Bewerter vertraut ausschließlich den Produkten dieser Wiederholung.Man kann sagen, dass dies in gewissem Sinne ein „Lean“ für wissenschaftliche Simulationen ist.
Wie sind die Ergebnisse ausgefallen?
Das Ergebnis: Von 93 Aufgaben zur Reproduktion von Papern erreichte das stärkste Modell, GPT-6 Astra, eine vollständige Reproduktionsrate von nur 13,98 %.
Das bedeutet: Zwar können die Modelle in etlichen Aufgaben plausibel aussehende Ergebnisse liefern, doch die Erfolgsquote, einen vollständigen Workflow wirklich von Grund auf zum Laufen zu bringen und Belege zu erzeugen, die mit der Arbeit übereinstimmen und überprüfbar sind, liegt bei weniger als einem Siebtel.
Das ist der Abstand zwischen der heutigen KI und einem General AI Scientist, der die Grenzen verschiedener Wissenschaftsbereiche überschreiten kann.
Die Bedeutung von PaperBenchX liegt darin, dass dieser Abstand zum ersten Mal quantifiziert wurde.。
Derzeit wählt das UniPat-AI-Team aus jedem Forschungsbereich 1 repräsentative Aufgabe aus, insgesamt werden12 Testaufgabenals Open Source veröffentlicht. Diese Aufgaben decken verschiedene Forschungsbereiche und wissenschaftliche Software-Stacks ab und können zur Evaluierung von Agents, zum Debugging von Reproduktions-Workflows sowie zur Untersuchung der Fähigkeit von Modellen zur End-to-End-Reproduktion in realen wissenschaftlichen Umgebungen genutzt werden.
Gleichzeitig werden 81 geschlossene Testaufgaben gepflegt, um die Diskriminierungsfähigkeit und die langfristige Evaluierungsgültigkeit von PaperBenchX zu erhalten.
Was steht hinter den 13,98 % – woran scheitert die zuverlässige Reproduktion?
Als Nächstes betrachten wir im Detail die von PaperBenchX auf derselben Gruppe von 93 Aufgaben evaluierten 10 Konfigurationen aus modernsten Modellen und Agent-Frameworks, analysieren die Bewertungsergebnisse und klären, woran die zuverlässige Reproduktion tatsächlich scheitert.
△ (a) zeigt die Phasenwerte der getesteten Konfigurationen; (b) zeigt die Beziehung zwischen der Anzahl der Interaktionsrunden und dem Wert; (c) zeigt die Zeitverteilung der Workflows in den gesampelten Trajektorien
Teilweise Fertigstellung ist nicht gleichbedeutend mit vollständiger Reproduktion
Betrachten wir zunächst Abbildung a, die Phasenwerte der getesteten Konfigurationen. Man erkennt, dass bei allen getesteten Konfigurationen die Durchschnittswerte für Modellierung (Modeling) und Ausführung (Execution) bei 62,70 % bzw. 61,84 % liegen, während die Validierung (Validation) nur 42,80 % erreicht.
Das bedeutet: Der Agent kann Teile der Modellierung durchführen, den Solver aufrufen und Ergebnisdateien erzeugen, aber diese Ergebnisse sind nicht unbedingt korrekt, und es ist nicht sicher, dass sie belegen, dass sie die Schlussfolgerungen der Arbeit wirklich stützen. Insgesamt fällt es ihnen noch schwer, die einzelnen Schritte miteinander zu verbinden und eine vollständige, vertrauenswürdige Reproduktion durchzuführen.
Mehr Interaktion bedeutet nicht zwangsläufig bessere Reproduktionsergebnisse
Betrachten wir nun Abbildung b, die Beziehung zwischen der Anzahl der Interaktionsrunden und dem Wert. Die Trajektorienanalyse zeigt, dass lange Laufzeiten oft wiederholte Versuche, Fehlerbehebung oder die Fortsetzung von Berechnungen mit falschen Modelleinstellungen bedeuten. Dies zeigt, dass mehr Interaktionsrunden nicht zwangsläufig zu höheren Werten führen.
Frühzeitige Entscheidungen bestimmen, ob die nachfolgende Ausführung von Wert ist
Betrachten wir nun Abbildung c, die Zeitverteilung der Workflows in den gesampelten Trajektorien. Nehmen wir Fable 5 als Beispiel: Es verwendet 37,1 % der Zeit für die Rekonstruktion der Arbeit und die Code-Implementierung – den höchsten Anteil an Vorabinvestitionen unter den fünf Modellen –, erreicht aber dennoch mit weniger Interaktionen nahezu optimale Teilwerte.
Das heißt: Ob Vorabinvestitionen wie das Verständnis der Arbeit, die wissenschaftliche Modellierung, die Parameterwahl und die Versuchsorganisation sinnvoll sind, bestimmt weitgehend, ob die nachfolgenden Berechnungen zu einer Verschwendung von Ressourcen werden.
Denn wenn die Geometrie, die Randbedingungen, die Modendefinition oder entscheidende Parameter bereits im Vorfeld falsch eingestellt wurden, dann berechnet der Solver selbst bei normalem Lauf nur ein falsches wissenschaftliches System. Eine falsche Entscheidung am Anfang kann dazu führen, dass mehrere Stunden nachfolgender Berechnungen vollständig ihren Wert verlieren.
Zusammenfassend lässt sich anhand eines scheinbar erfolgreichen Durchlaufs oder der letztendlichen Ausgabe allein nicht zwischen verschiedenen Fehlerursachen unterscheiden. Bei manchen Agents laufen die Experimente erfolgreich, aber das wissenschaftliche Modell oder die Ergebnisanalyse ist falsch; andere Agents können den erneuten Lauf nicht abschließen, weil ein vertrauenswürdiger Lösungsprozess fehlt oder der Code fehlerhaft ist.
Das UniPat-AI-Team hat außerdem einige entscheidende Punkte genannt, die für eine „zuverlässige Reproduktion“ erforderlich sind:
Die Schwierigkeit liegt nicht darin, „ob etwas läuft“, sondern „ob das, was läuft, wissenschaftlich haltbar ist“ : Eine scheinbar passende Zahl kann aus einem falschen Modell, ungeeigneten Parametern, einer nicht konvergierten Simulation oder einer ungültigen Nachverarbeitung stammen;
Die Bewertung der Ergebnisse muss auf neu erzeugten Nachweisen beruhen, nicht auf den Selbstauskünften des Agents: Ausgaben löschen, Netz trennen, erneut ausführen und nur die Wiedergabe-Artefakte anerkennen;
Ein Teil der Fortschritte ist real, vollständige Reproduktionen sind jedoch noch selten: Agents sind bereits in der Lage, plausible Simulationen zu schreiben und diese zum Abschluss zu bringen, aber es bleibt schwierig, dafür zu sorgen, dass der gesamte Prozess und die Endergebnisse einer Überprüfung standhalten.
Das differenzierende Design von PaperBenchX
Die Etablierung der „Reproduktion einer gesamten Arbeit“ als Evaluierungsparadigma für Agents geht nicht auf UniPat AI zurück; OpenAIs PaperBench ist eine ähnliche Arbeit.
Doch die bisherigen Aufgaben konzentrierten sich auf den Bereich Machine-Learning-Artikel. Wenn man wirklich in wissenschaftliche Forschungsszenarien wie Physik, Chemie oder Materialwissenschaften eintritt, ist die Reproduktion einer Arbeit nicht mehr so einfach wie „den Code einmal ausführen“, und es ergeben sich drei Herausforderungen:
Das wissenschaftliche Problem verstehen: Eine Arbeit ist keine Anleitung, die man einfach befolgen kann. Angesichts echter wissenschaftlicher Probleme muss der Agent die Forschungsziele selbst verstehen und beurteilen, wie Randbedingungen gesetzt werden, wie Dispersion behandelt wird und welche Parameter die Schlussfolgerungen wirklich beeinflussen – statt einfach gemäß der README den Code einmal auszuführen;
Die wissenschaftliche Simulation korrekt durchführen:Den Code erfolgreich zum Laufen zu bringen ist nur der erste Schritt. Werden Parameter wie Auflösung, Solver-Toleranz oder Simulationsdauer falsch eingestellt, kann das zu völlig falschen numerischen Ergebnissen führen. Der Agent muss außerdem Diagnosemeldungen lesen und verstehen, Anomalien wie numerische Divergenz erkennen und beurteilen, wann Parameter angepasst oder das Gitter verfeinert werden muss. All dies sind keine allgemeinen Codeausführungsfähigkeiten, sondern Urteile, die stark vom fachspezifischen Wissen abhängen;
Beurteilen, ob die Ergebnisse wirklich vertrauenswürdig sind:Dies ist der am leichtesten übersehene und zugleich verhängnisvollste Schritt. Eine Zahl herauszubekommen, die zur wissenschaftlichen Veröffentlichung passt, bedeutet nicht, dass wissenschaftlich korrekt gearbeitet wurde. Ein falsches physikalisches Modell, eine noch nicht konvergierte Simulation oder sogar eine unsinnige Nachverarbeitung können ein „richtig aussehendes“ Ergebnis liefern. Daher gibt es bei der wissenschaftlichen Reproduktion, anders als bei gewöhnlichen Code-Aufgaben, kein einfaches pass/fail-Kriterium; der Agent muss zudem beurteilen können, ob der wissenschaftliche Prozess hinter dem Ergebnis zuverlässig ist.
Echte wissenschaftliche Reproduktion verlangt vom Agenten die Bewältigung einer vollständigen Kette: zuerst das wissenschaftliche Problem verstehen, dann die wissenschaftliche Berechnung ausführen und schließlich die wissenschaftliche Schlussfolgerung verifizieren. Diese drei Punkte sind genau die Grundfertigkeiten, die ein AI Scientist besitzen muss:Wissenschaft verstehen, Wissenschaft ausführen, Wissenschaft beurteilen.
Man kann es daher so verstehen: PaperBenchX misst nicht, ob ein Agent einen Abschnitt Forschungscode ausführen kann, sondern ob er einen relativ vollständigen wissenschaftlichen Arbeitsablauf bewältigen kann.
Dies bildet auch den Kernunterschied zwischen PaperBenchX und bestehenden ähnlichen Benchmarks – dahinter stehen mehrere zentrale Designentscheidungen dieser Arbeit:
Erstens: Der Agent muss in echter wissenschaftlicher Software arbeiten, nicht in einer Machine-Learning-Aufgabe mit ausgetauschten Fachdaten.
PaperBenchX umfasst 12 Forschungsrichtungen und 10 Simulationsplattformen, wobei jedes Fachgebiet sein eigenes Parametersystem, seinen eigenen Berechnungsablauf und eigene Konvergenzkriterien hat. Bestehende Benchmarks (PaperBench, ScienceAgentBench usw.) bleiben im Wesentlichen auf den ML/Python-Stack beschränkt; PaperBenchX ist der erste Reproduktions-Benchmark, bei dem Agenten in verschiedenen Fachgebieten direkt mit fachspezifischen nativen Solvern wie Ansys HFSS, Ansys Lumerical, Meep, PySCF/GPU4PySCF und ABACUS konfrontiert werden.
Zweitens müssen die von den Agenten eingereichten Ergebnisse vollständig reproduzierbar sein.
Nach der Einreichung des Agenten löscht das System sämtliche Ausgaben, trennt die Netzverbindung und führt den gesamten Arbeitsablauf in einer isolierten Umgebung erneut aus. Nur wissenschaftliche Ergebnisse, die in diesem Prozess neu erzeugt werden können, gelangen in die anschließende Bewertung – jedes Bewertungselement ist an eine konkrete wissenschaftliche Anforderung gekoppelt und wird durch Programmprüfungen und Bewertungen durch große Sprachmodelle beurteilt.
Drittens erfordert das begrenzte Zeitbudget, dass der Agent die Abwägungen im Forschungsprozess selbst vornimmt.
Budget pro Aufgabe4 – 24 Stunden, Median 7 Stunden. Innerhalb dieses Zeitfensters muss der Agent selbst entscheiden, wie er Rechenleistung verteilt: wann er Zwischenergebnisse überprüft, ob nach fehlgeschlagenen Berechnungen ein erneuter Lauf nötig ist, welche Parameter sich eine Anpassung lohnen und worauf er in der begrenzten Zeit seine Kraft konzentrieren sollte. Das entspricht eher der Arbeitsweise in der realen Forschung als einer Codeausführungsaufgabe mit unbegrenzten Versuchen.
Viertens schließt die Verifikationsmethode jede Möglichkeit des Schummelns aus.
Bei üblichen Code-Benchmarks genügt ein Durchlauf der Unit-Tests, um zu wissen, ob etwas stimmt – doch die wissenschaftliche Reproduktion lässt sich nicht allein durch ein pass/fail beurteilen. Daher zerlegt PaperBenchX die Verifikation in drei Ebenen, von denen jede eine Frage beantwortet:
Lässt sich das Ergebnis erneut erzeugen: Nachdem der Agent die Aufgabe eingereicht hat, löscht das System alle von ihm erzeugten Ausgaben, trennt die externe Netzverbindung und führt den Arbeitsablauf in einer isolierten Umgebung von Grund auf aus. Was sich nicht ausführen lässt, zählt schlicht nicht. Dieser Schritt filtert alle Möglichkeiten aus, Ergebnisse manuell zusammenzusetzen, sich auf Caches zu verlassen oder Antworten aus dem Internet zu kopieren;
Sind die Belege nachvollziehbar: Es muss möglich sein, den zugehörigen Berechnungsprozess zurückzuverfolgen. Wenn der Agent etwa behauptet, eine Simulation sei konvergiert, muss er entsprechende Konvergenzprotokolle vorlegen; wird eine physikalische Größe berichtet, müssen die Simulationsausgaben, die dieses Ergebnis erzeugt haben, sowie die anschließenden Analyseschritte auffindbar sein. So wird nicht nur eine isolierte Zahl bewertet, sondern die vollständige Beweiskette, die diese Zahl stützt.
Ist das Ergebnis wissenschaftlich haltbar: Schließlich beurteilt das Evaluationssystem, ob die Ergebnisse den konkreten wissenschaftlichen Anforderungen genügen. Jedes Bewertungskriterium entspricht einer klaren wissenschaftlichen Anforderung samt der benötigten Belege. Bei Fragen, die sich eindeutig berechnen lassen – etwa numerische Konsistenz, Einheiten oder Fehlertoleranzen – prüft ein Programm automatisch; bei Fragen, deren Beurteilung Fachwissen erfordert, entscheidet ein LLM-Gutachter.
Und Zudem: Texte, die der Agent selbst verfasst hat – etwa die Formulierung „Reproduktion erfolgreich“ – werden niemals als Beweis gewertet und niemals als Anweisung an die Bewerter behandelt. So wird vermieden, dass ein Agent „durchschlüpft“, indem er einen scheinbar vollständigen Bericht schreibt, ohne die zugrunde liegenden wissenschaftlichen Berechnungen tatsächlich durchgeführt zu haben.
Damit stellt sich die Frage noch weiter zugespitzt:Wie lassen sich die wissenschaftlichen Schlussfolgerungen einer Arbeit überhaupt in eine Menge von Anforderungen zerlegen, die sich ausführen, neu berechnen und objektiv beurteilen lassen?
PaperBenchX übergibt eine Arbeit nicht einfach an den Agenten und vergleicht dann die finalen Zahlen. Jede Aufgabe muss zunächst die beiden Phasen „Konstruktion von Kandidatenaufgaben“ und „Verifikation und Prüfung“ mit insgesamt neun Schritten durchlaufen, bevor sie offiziell in die Evaluation eingeht.
△ Der zweiphasige, neunstufige Prozess der Aufgabenkonstruktion und Verifikation von PaperBenchX
Das heißt, PaperBenchX kompiliert die wissenschaftlichen Schlussfolgerungen einer Arbeit in ein neues Objekt: einen wissenschaftlichen Arbeitsablauf, der von einer KI ausführbar, von der Umgebung wiedergebbar, anhand der Originalbelege nachrechenbar und am Ende vom Bewertungssystem Punkt für Punkt überprüfbar ist.
Weitere Details dazu, wie man „eine wissenschaftliche Arbeit in eine evaluierbare Reproduktionsaufgabe verwandelt“, findet man auf GitHub oder im Blog der offiziellen Website~
GitHub-Open-Source-Link:
https://github.com/UniPat-AI/PaperBenchX
Link zum Blog der offiziellen Website:
https://unipat.ai/blog/PaperBenchX
— Ende —