
Mehrere Teams innerhalb desselben Unternehmens benötigen zunehmend gemeinsame Zugriff auf teure GPU-Klustren für ihre generative AI-Aufgaben, während gleichzeitig die Isolierungsgrenzen, die Ressourcengerechtigkeit und die operativen Unabhängigkeit erhalten bleiben. Man kann sich ein Team für Datenwissenschaft vorstellen, das große Sprachmodelle trainiert, eine Gruppe für Computervision, die Inferenzlasten ausführt, sowie ein Forschungsteam, das mit neuen Modellarchitekturen experimentiert. Alle diese Teams könnten Zugriff auf denselben Cluster benötigen. Ohne eine gut entwickelte Mehrteilnehmerarchitektur (Mehrteams-Architektur) stehen Organisationen vor unkontrolliertem Ressourcenverbrauch, schwacher Isolierung zwischen Teams, einer Unfähigkeit, die gemeinsamen GPU-Kosten den Teams zuzuordnen, und administrativen Aufwänden, die die Innovation verlangsamt.
Amazon SageMaker HyperPod ist ein speziell konzipierter AI-Dienst, der die Verwaltung großskaliger Rechenclusters für gen-AI-Arbeitslasten vereinfacht. Er stellt widerstandsfähige, optimierte Clustere aus Amazon Elastic Kubernetes Service (Amazon EKS) oder Slurm bereit, sodass Organisationen verteilte Trainings, interaktives Entwickeln und Modellinferierende auf großer Skala durchführen können. Gleichzeitig übernimmt er automatisch die Überwachung der Knotenverfügbarkeit, die Fehlerbehebung und die Lebenszyklusverwaltung des Clusters.
In diesem Artikel präsentieren wir eine Referenzarchitektur für die Erstellung einer Mehrteilnehmerumgebung auf Amazon SageMaker HyperPod mit EKS. Diese Architektur nutzt AWS IAM Identity Center für die zentrale Authentifizierung, SageMaker-AI-Domains pro Team für eine personalisierte Benutzerfreundlichkeit, Kubernetes-Namenbereiche für die Isolation von Arbeitslasten, HyperPod Task Governance für eine gerechte Ressourcenzuteilung sowie Kostenallokation auf Namenbereichebene für die Sichtbarkeit der Ausgaben pro Team und das Aufbringen von Gebühren. Am Ende dieses Artikels haben Sie ein klares Konzept, das es mehreren Teams ermöglicht, einen einzigen HyperPod EKS-Cluster effizient zu teilen.
Überblick über die Architektur
Das folgende Diagramm zeigt die Hochlevel-Architektur einer multi-Tenant-HyperPod-EKS-Deployment. In diesem Beispiel teilen sich zwei Teams (Team A und Team B) einen einzigen HyperPod-EKS-Kluster, wobei jeder Team innerhalb seines eigenen isolierten Namensraums arbeitet.
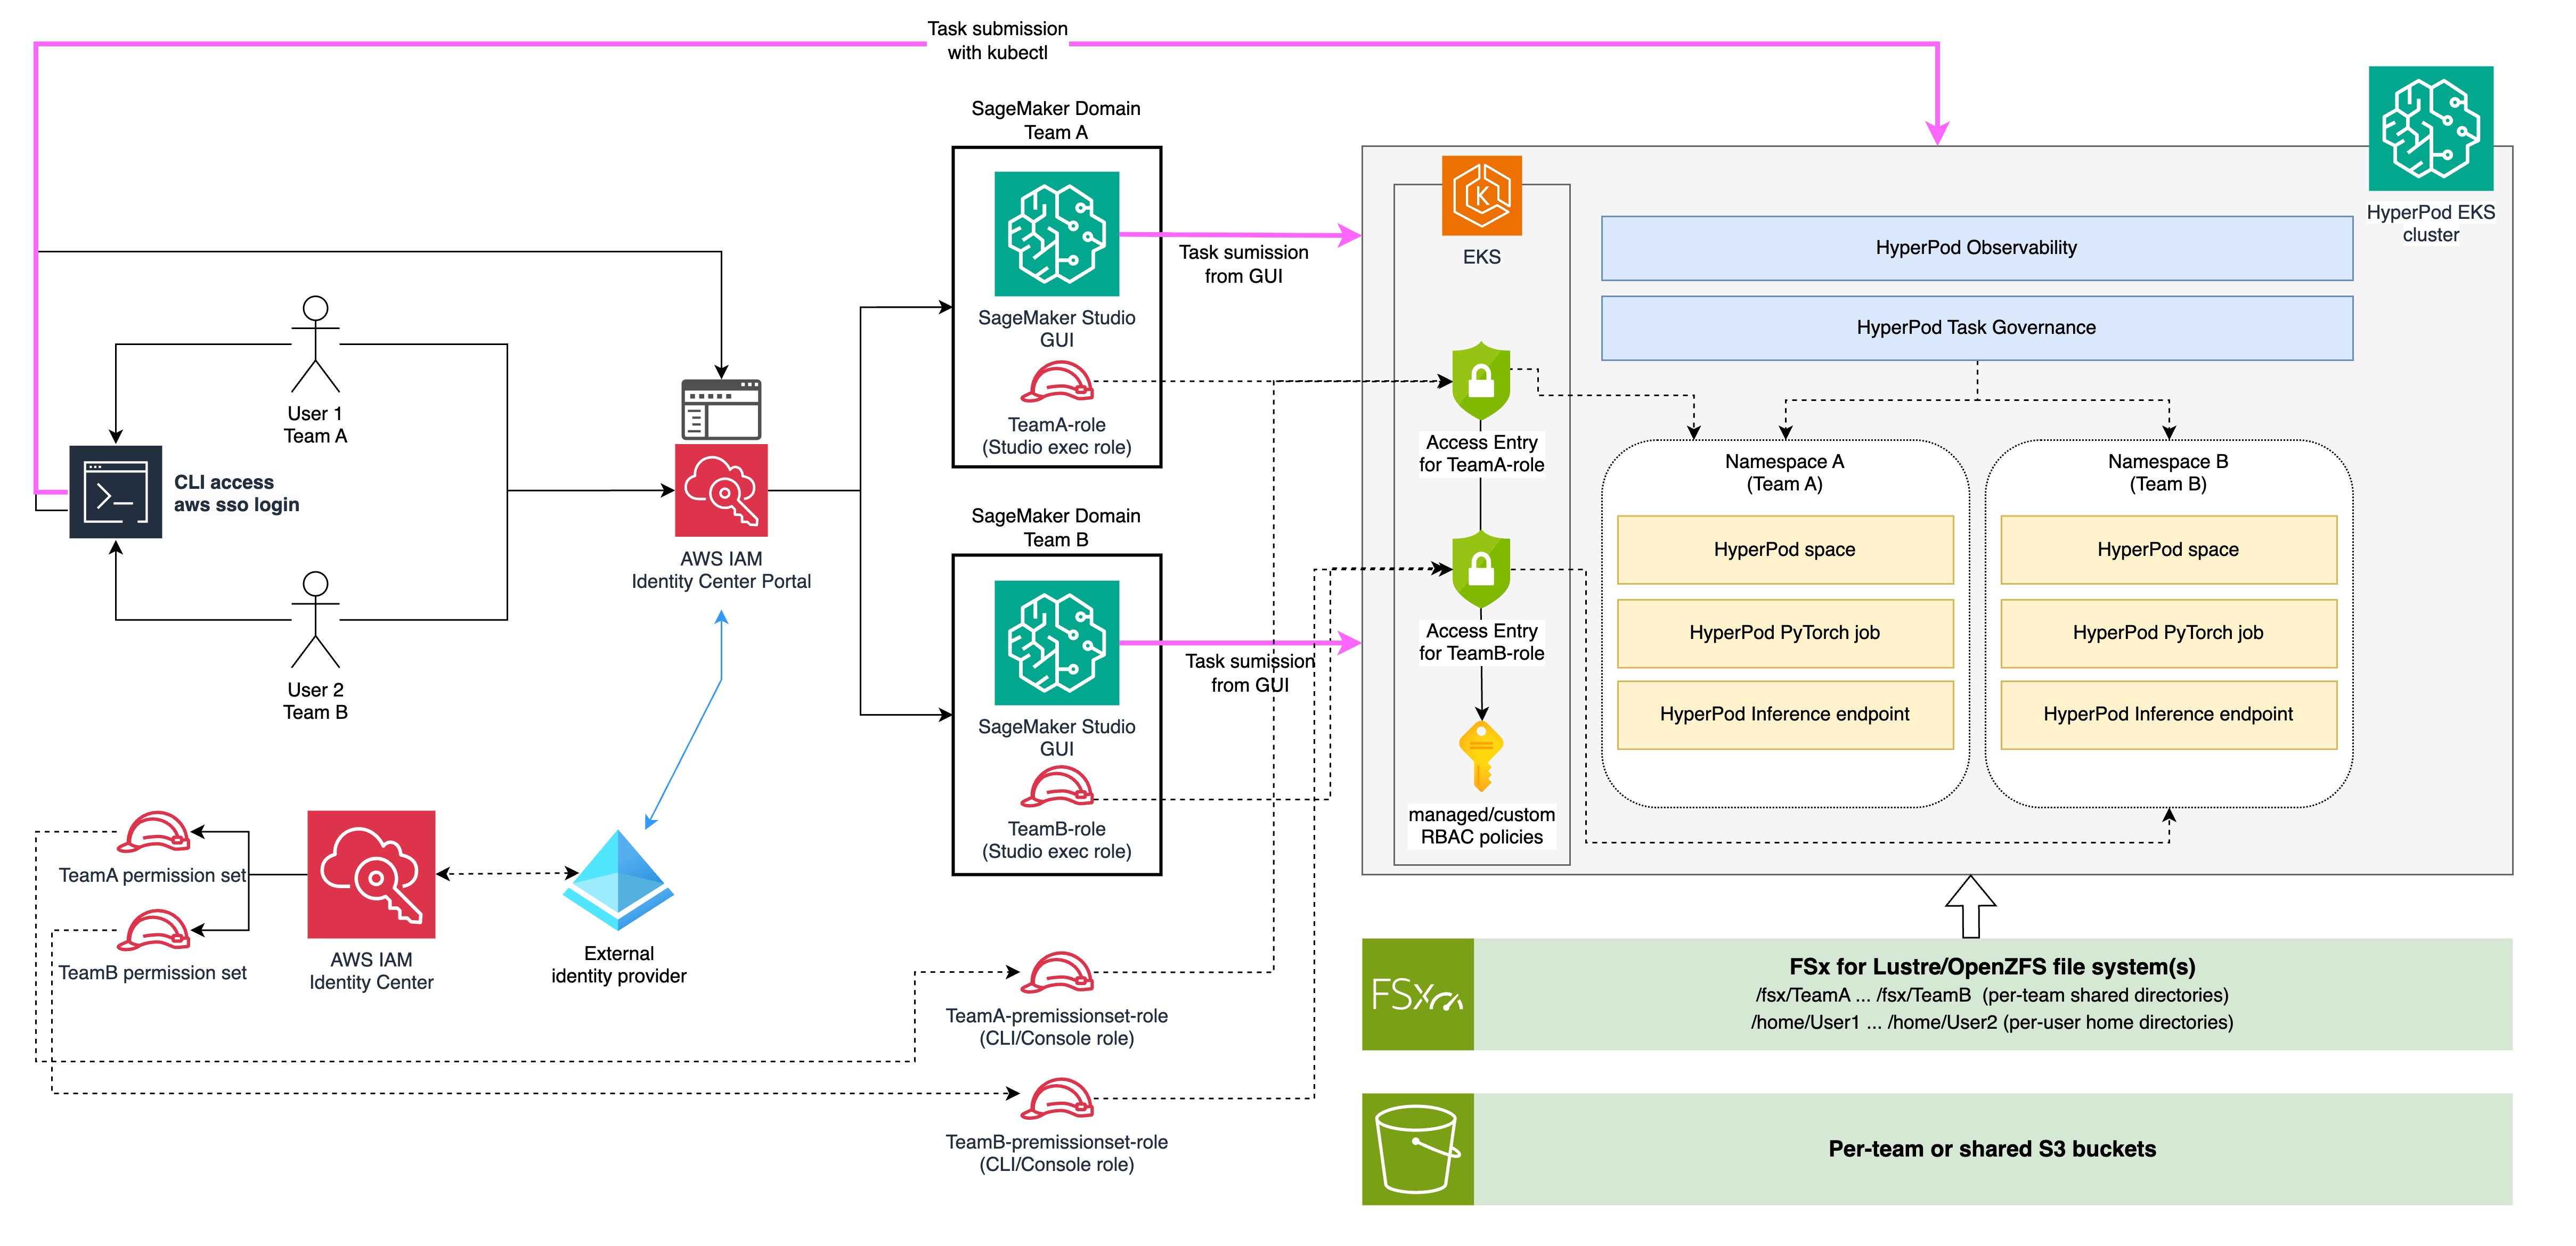
Abbildung 1: Hochwertige Mehrteilnehmer-Architektur für zwei Teams, die einen HyperPod EKS-Clustern teilen
Die Architektur ist aufgebaut als eine schichtweise Flussstruktur von links nach rechts, die die Benutzeridentität durch Autorisierungskontrollen verbindet und in isolierte Arbeitslast-Namenräume im Cluster führt.
Benutzer und Authentifizierung
Auf der linken Seite interagieren einzelne Benutzer jeder Mannschaft (Benutzer 1 aus Team A, Benutzer 2 aus Team B) mit dem System über zwei Wege. Beide Wege erfolgen durch das AWS IAM Identity Center Portal, das mit einem externen Identitätsdienstleister (wie Microsoft Entra ID) verbunden ist, der im unteren linken Bereich angezeigt wird.
Der erste Weg erfolgt über den CLI-Zugriff. Die Benutzer authentifizieren sich mit aws sso login, woraufhin sie zum Identity Center-Portal weitergeleitet werden, und erhalten anschließend vorübergehende Zugangsdaten aus dem Bereich der Berechtigungen ihres Teams, um direkt Aufgaben in den EKS-Cluster mit kubectl zu senden. In dem Diagramm fließt die rosa Pfeil vom CLI-Terminal über den oberen Teil direkt in den HyperPod EKS-Cluster.
Der zweite Weg erfolgt direkt über das Identity Center-Portal, wo die Benutzer die SageMaker Studio-Anwendung auswählen, um sich für ihren teamspezifischen SageMaker AI- Bereich anzumelden.
Jedes Team hat ein entsprechendes Berechtigungsset (TeamA-Berechtigungsset, TeamB-Berechtigungsset), das die für die CLI-Werkebenen erforderlichen AWS Identity and Access Management (IAM)-Policies enthält. Identity Center bereitet automatisch eine IAM-Rolle für jedes Berechtigungsset vor, die im Diagramm als TeamA-permissionset-role und TeamB-permissionset-role (mit dem Label „CLI/Console-Rolle“) dargestellt wird. Diese Rolle dient als IAM-Primus, wenn Benutzer durch aws sso login authentifizieren.
SageMaker AI Domains
Vom Identity Center-Portal werden die Benutzer zu ihrem team-spezifischen SageMaker AI-Domain geleitet. Jeder Domain (SageMaker AI-Domain Team A und SageMaker AI-Domain Team B) bietet eine dedizierte Amazon SageMaker Studio-GUI und ist mit einer team-spezifischen Ausführungsrolle (TeamA-role und TeamB-role) konfiguriert. Diese Domains dienen als primäre Arbeitsplatzinteraktion, sodass die Benutzer Aufgaben über die GUI einreichen können (wie von den roten Pfeilen gezeigt, die zu EKS führen).
EKS Zugriffskontrolle
Am EKS-Grenzpunkt wenden die Zugriffszeichen IAM-Rollen auf Kubernetes-Rechte an. Das Diagramm zeigt die Zugriffszeichen für TeamA-role und TeamB-role (die Ausführungsrollen von Studio), die Anfragen, die aus der SageMaker Studio-GUI kommen, autorisieren. Die Zugriffszeichen müssen auch für die von Identity Center bereitgestellten CLI/Console-Rollen (TeamA-permissionset-role und TeamB-permissionset-role) konfiguriert werden, um Anfragen, die über kubectl eintreffen, zu autorisieren. Alle Zugriffszeichen sind mit verwalteten oder benutzerdefinierten Rollensystem-RBAC-Policies (repräsentiert durch das Schlüssel-Symbol) verbunden und beschränkt auf den vom Team festgelegten Namespace. Daher können Nutzer, egal ob der Zugriff aus Studio oder der CLI kommt, nur mit Ressourcen in ihrem eigenen Namespace interagieren.
HyperPod EKS-Cluster
Der Cluster selbst ist mit zwei überlappenden Plattformschichten oben dargestellt: HyperPod Observability (für Überwachung und Dashboards) und HyperPod Task Governance (für Verwaltung der Rechenquoten und Planungsprioritäten). Unter diesen Schichten ist der Cluster in Namespace A (Team A) und Namespace B (Team B) unterteilt. In jedem Namensraum können Teams ihre eigenen HyperPod Spaces (interaktive Entwicklungsumgebungen), HyperPod PyTorch-Jobs (distribuirte Trainingslasten) und HyperPod Inference-Endpunkte (Modelldienste) betreiben.
Speicherung
Unter dem Cluster umfasst die Architektur zwei Speicherebenen. Die erste ist ein POSIX-kompatibles Dateisystem (Amazon FSx für Lustre oder Amazon FSx für OpenZFS), das in gemeinsame Verzeichnisse pro Team (/fsx/TeamA, /fsx/TeamB) und per-User-Home-Verzeichnisse (/home/User1, /home/User2) unterteilt ist. Die zweite Ebene sind Amazon Simple Storage Service (Amazon S3)-Behälter für den Objektstorage, die von der IAM-Ausführungsrolle des Teams gesteuert werden.
Diese Architektur isoliert jeden Team von der Authentifizierung über die Berechtigung bis zur Ausführung des Arbeitsumfangs, während die kostspielige GPU-Infrastruktur effizient genutzt wird.
Authentifizierung und Zugriffskontrolle
Die Grundlage jedes Multi-Tenant-Systems ist eine robuste Authentifizierung: Es wird überprüft, wer die Benutzer sind, bevor sie mit irgendeinem Ressourcen interagieren. In dieser Architektur dient AWS IAM Identity Center als zentrale Authentifizierungsschicht, die mit einem externen Identitätsdienst verbunden ist, um die Benutzeridentitäten und Gruppenzugehörigkeiten zu verwalten.
Warum AWS IAM Identity Center
AWS IAM Identity Center (Nachfolger von AWS Single Sign-On) bietet einen einzigen Ort zur Verwaltung der Identitäten des Personals in allen AWS-Konten und Anwendungen. Für eine Multi-Tenant-HyperPod-Implementierung bietet es mehrere wichtige Funktionen:
- Zentralisierte Identitätsverwaltung – Anstatt separate Benutzerdatenbanken für jeden AWS-Dienst zu halten, bietet Identity Center eine einzige Quelle für alle Benutzeridentitäten und deren Gruppenzugehörigkeiten.
- Föderation mit bestehenden Identitätsdiensten – Die meisten Unternehmen verwalten ihre Mitarbeiteridentitäten bereits in Systemen wie Microsoft Entra ID (früher Azure AD), Okta oder Ping Identity. Identity Center integriert sich mit diesen Diensten, sodass Organisationen ihre bestehende Identitätsinfrastruktur wieder verwenden können, ohne Benutzerkonten duplizieren zu müssen.
- Native Integration mit SageMaker AI – Die Domains von SageMaker AI unterstützen die Authentifizierung über Identity Center, sodass Benutzer über ihren Unternehmensidentitätsdienst mit Single Sign-On (SSO) in SageMaker Studio einloggen können.
- AWS-Kontenzugriff – Identity Center kann auch Benutzern Zugang zum zugrunde liegenden AWS-Konto mit spezifischen Berechtigungen gewähren, die die CLI-Arbeitsabläufe neben der Studio-GUI-Erfahrung unterstützen.
- Erforderlich für Amazon Managed Grafana – Amazon Managed Grafana verwendet Identity Center als Authentifizierungsmechanismus für Workforce-User, was die natürliche Wahl ist, wenn die Teams auch Zugang zu Observability-Dashboards zum Überwachen ihrer Arbeitslasten benötigen.
Erfahren Sie mehr: Was ist IAM Identity Center
Konfiguration von Identity Center mit einem externen Identitätsdienstleister
In dieser Referenzarchitektur verwenden wir Microsoft Entra ID als externen Identitätsdienstleister, obwohl das gleiche Muster für die meisten Standard-Security Assertion Markup Language (SAML) 2.0-Provider gilt.
Die Konfiguration umfasst:
- Gruppendynamik im Identitätsdienstanbieter – In Entra ID erstellen Sie Gruppen, die zu Ihren organisatorischen Teams entsprechen. Im Beispiel definieren wir drei Gruppen:
TeamA,TeamBundAdmin. Jede Gruppe enthält die Benutzer, die zum jeweiligen Team gehören (zum Beispieluser1-teamA@example.comin derTeamA-Gruppe). - SCIM-Provisioning – Aktivieren Sie die Synchronisation zwischen Entra ID und AWS IAM Identity Center durch SCIM (System for Cross-domain Identity Management). SCIM ermöglicht die automatische Provisionierung und De-Provisionierung von Benutzern und Gruppen. Wenn ein neuer Benutzer in die
TeamA-Gruppe in Entra ID aufgenommen wird, wird er automatisch in das Identity Center synchronisiert und erhält ohne manuelle Eingriffe die entsprechende Zugriffsberechtigung. - SAML-basierte Authentifizierung – Konfigurieren Sie die SAML 2.0-Feudalität so, dass die Benutzer bei der Authentifizierung gegen Entra ID vorgenommen werden. Identity Center fungiert als Dienstleister und vertraut den Aussagen aus Ihrem Entra ID-Tenant.
Mit dieser Konfiguration verwalten Sie die Teammitglieder (die alle nachfolgenden Autorisierungsentscheidungen beeinflussen) in Ihrem bestehenden Unternehmendatenbank und wird automatisch an AWS weitergegeben.
Das folgende Bild zeigt ein Beispiel dafür, wie organisatorische Teams in Microsoft Entra ID dargestellt werden können, mit speziellen Gruppen für TeamA, TeamB und Admin.
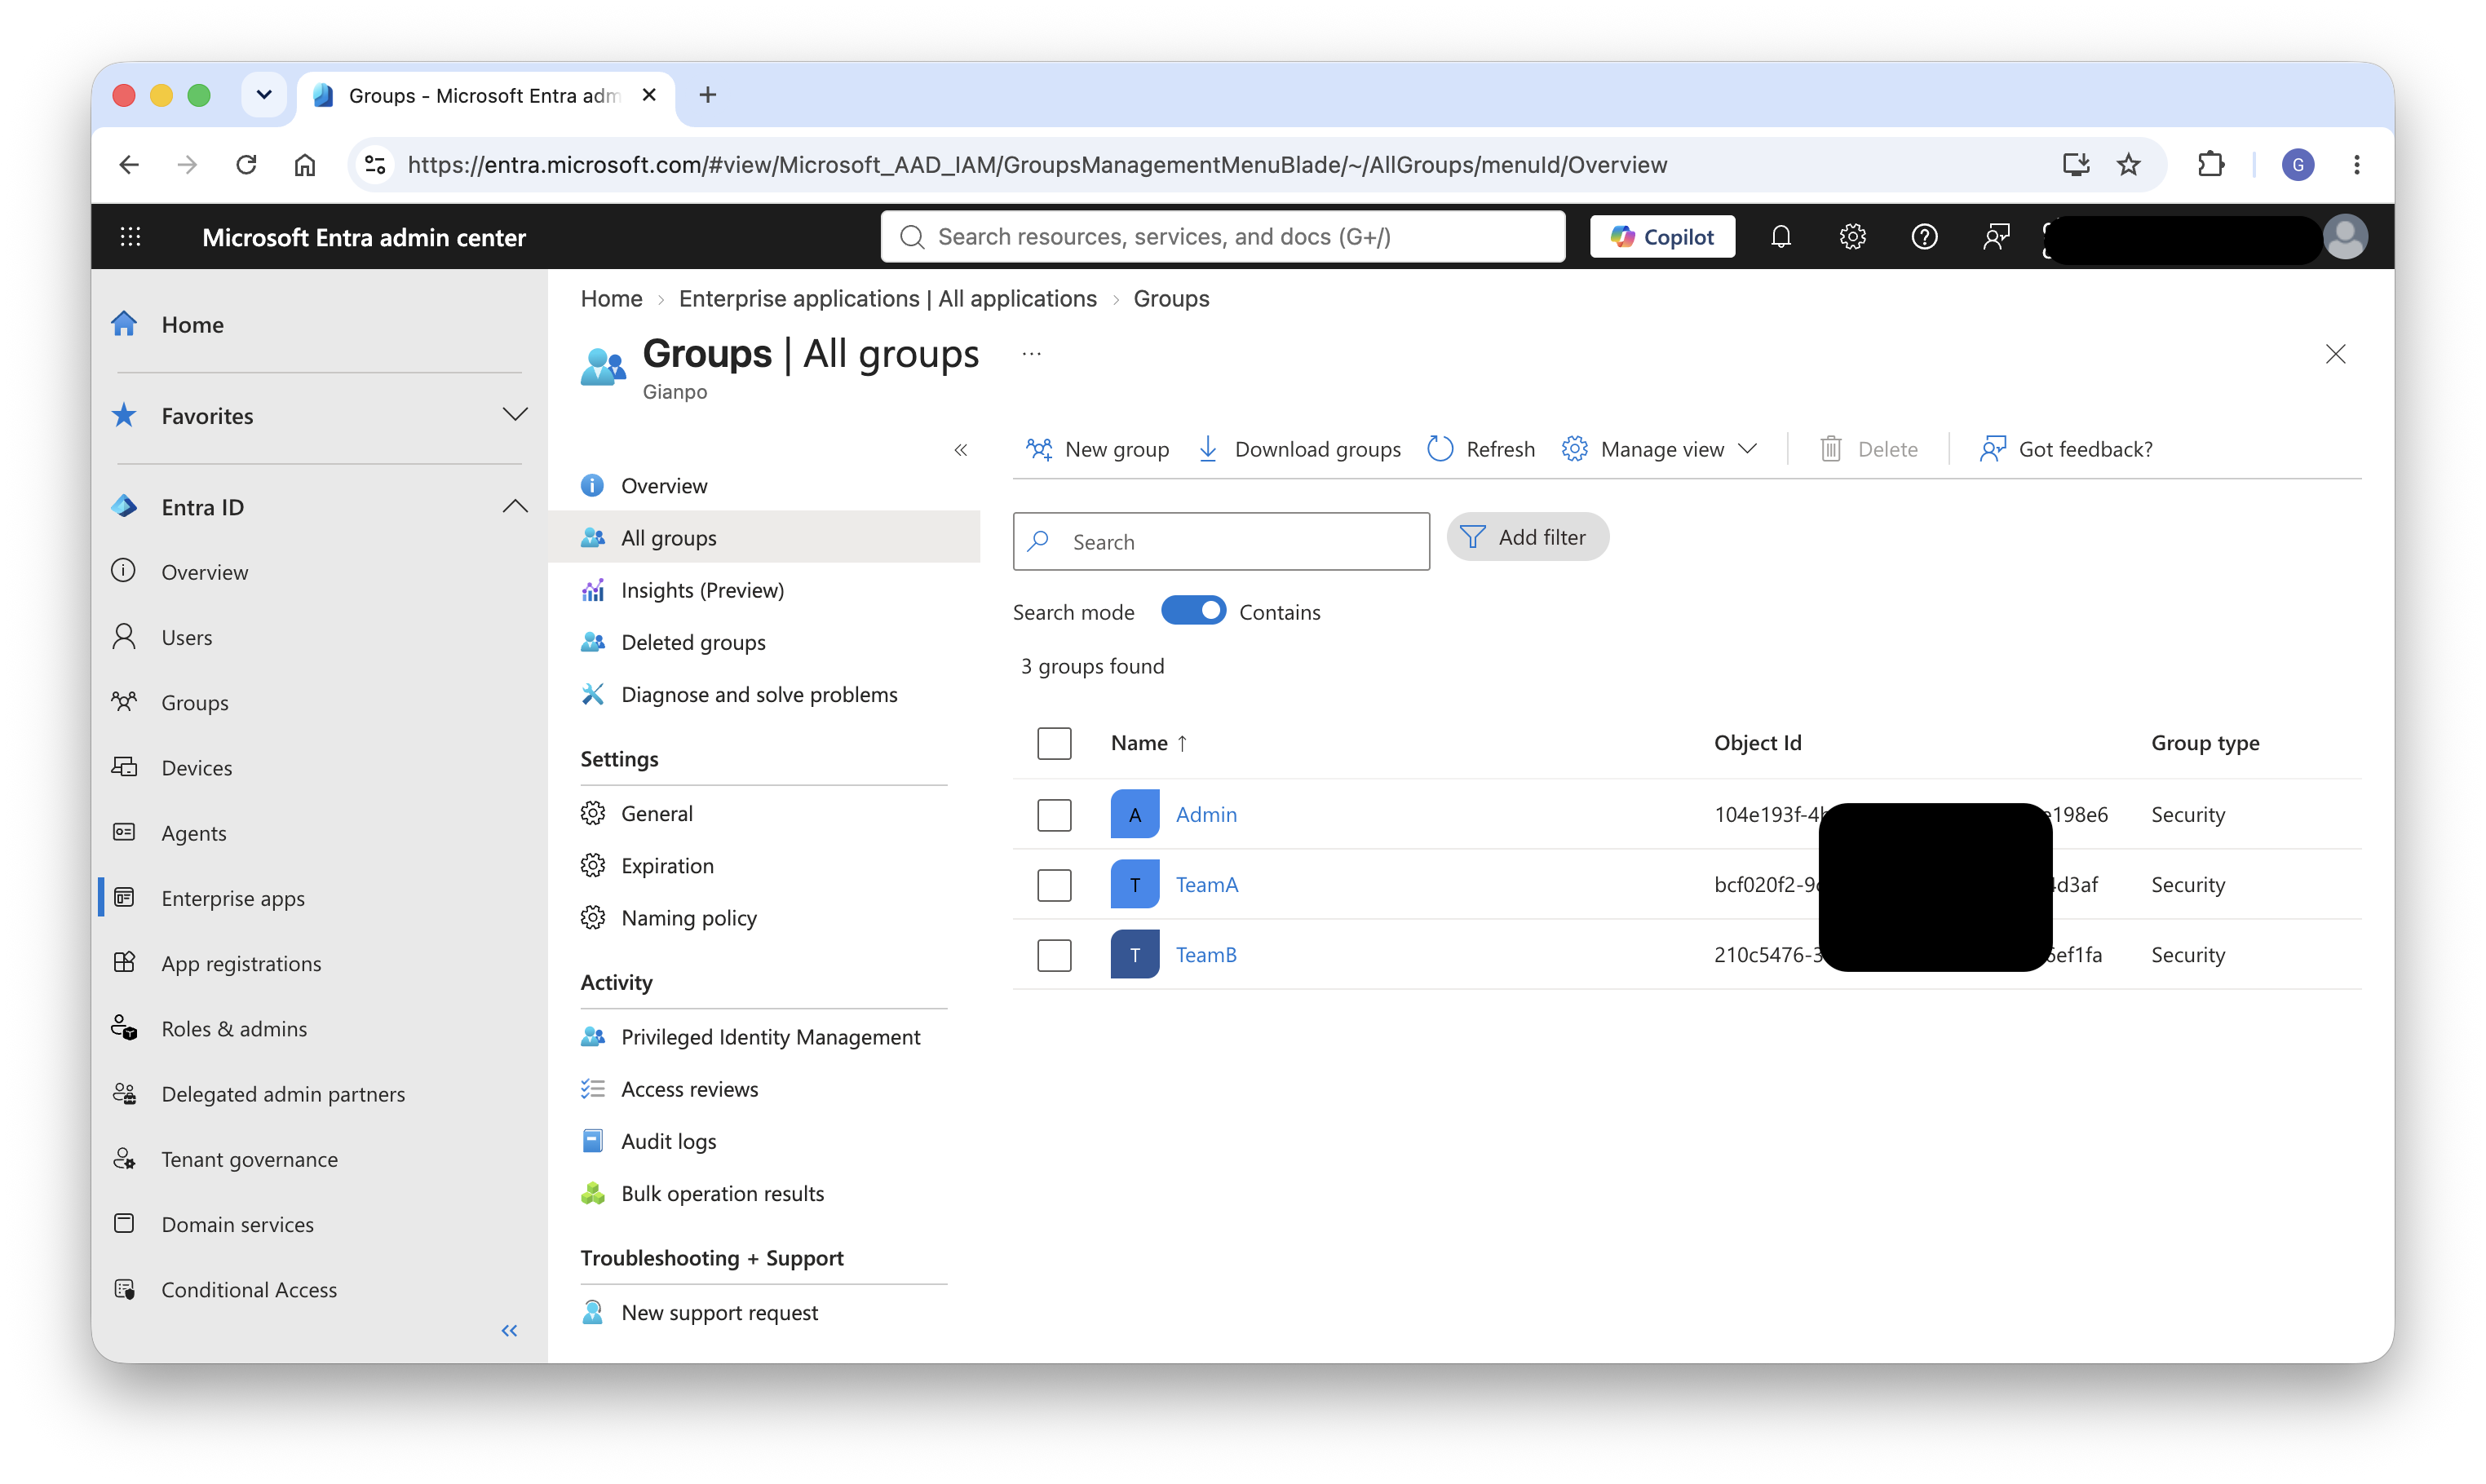
Abbildung 2: Organisationale Teams dargestellt als Gruppen in Microsoft Entra ID
Dann zeigt das folgende Bild die entsprechenden Gruppen in AWS IAM Identity Center an, die automatisch durch SCIM-Synchronisation von Entra ID bereitgestellt werden.
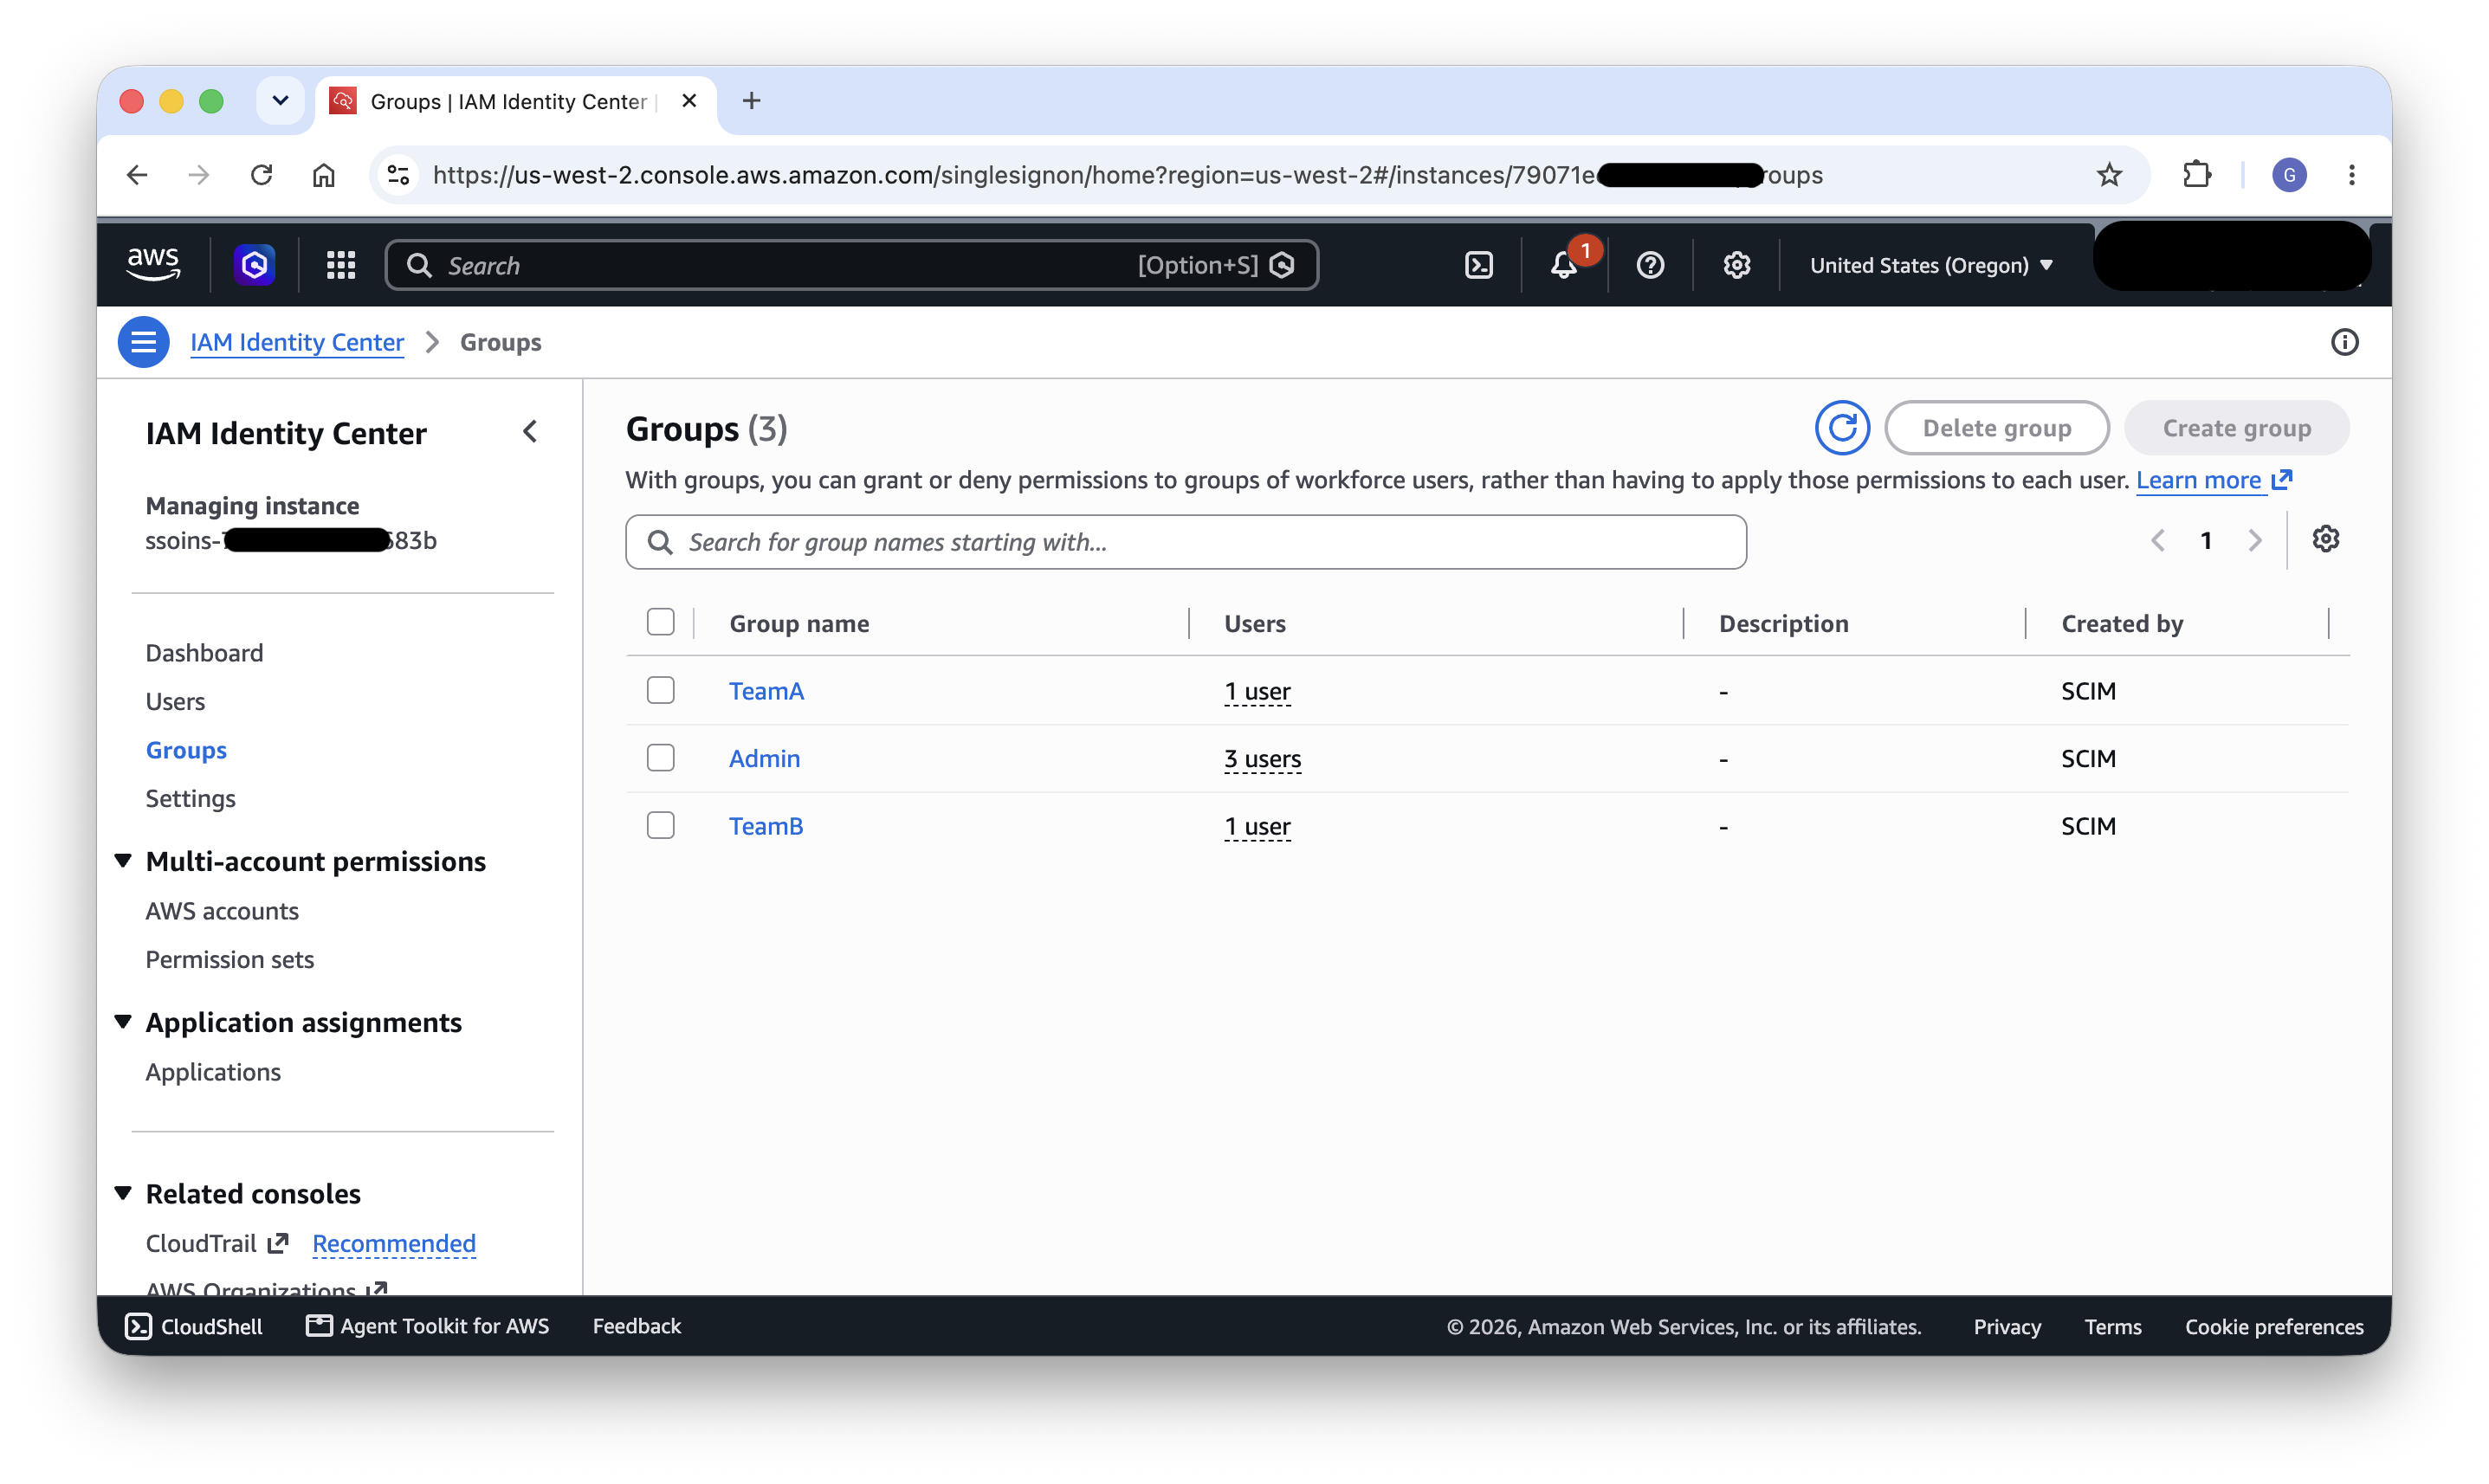
Abbildung 3: Entsprechende Gruppen in AWS IAM Identity Center, bereitgestellt durch SCIM
Mehr erfahren: Verbinden eines externen Identitätsdiensts · SCIM-Profil und SAML 2.0-Implementierung
Autorisierung
Nach der Authentifizierung folgt die nächste Ebene der Autorisierung: das Kontrollieren der Handlungen, die jede Gruppe über die AWS-Dienste und den Kubernetes-Clustern ausführen kann. In dieser Architektur funktioniert die Autorisierung auf zwei Ebenen: IAM für Service-Level-Zugriff und Kubernetes RBAC für Cluster-Level-Zugriff.
Teamübergreifende IAM-Rollen
Jedes Team benötigt eine spezielle IAM-Rolle, die die auf dem AWS-Niveau erforderlichen Berechtigungen für ihre AI- und maschinelle Lernung (ML)-Workflows umfasst. Diese Rollen fungieren als SageMaker-AI-Domänenausführungsrolle und definieren, welche AWS-Dienste das Team erreichen kann.
Eine typische IAM-Rolle für ein Team sollte Polizei enthalten, die Zugriff ermöglichen:
- Amazon SageMaker AI – Zur Verwaltung von HyperPod-Klustern, MLflow-Tracking-Servern und anderen SageMaker AI-Ressourcen über die SageMaker AI API.
- Amazon S3 – Für das Lesen von Trainingsdatensätzen und das Schreiben von Modellartefakten, Checkpoints und Logs. Erweitern Sie diese Berechtigungen auf Team-spezifische Bucket-Prefixe.
- Amazon CloudWatch – Zur Ansicht von Logs und Metriken, die mit den Workloads des Teams zusammenhängen.
- Amazon EKS – Insbesondere die Berechtigungen
eks:AccessKubernetesApiundeks:MutateViaKubernetesApi, die die SageMaker Studio GUI benötigt, um im Namen des Benutzers auf die Kubernetes-API zuzugehen (z. B. zur Listeung von Spaces oder zur Einreichung von Jobs).
Die Vertrauensrichtlinie für jede IAM-Rolle muss sagemaker.amazonaws.com als vertrauenswürdiges Subjekt enthalten, damit SageMaker AI die Rolle im Namen der Benutzer ausführen kann, wenn diese über Studio arbeiten. Wenn Sie beabsichtigen, dieselbe Ausführungsrolle für die Identität eines EKS Pods für Workloads innerhalb des Clusters zu verwenden (wie später im Abschnitt über Amazon S3-Storage besprochen), muss die Vertrauensrichtlinie auch pods.eks.amazonaws.com als vertrauenswürdiges Subjekt enthalten. Der Zugriff über die CLI durch Identity Center verwendet eine separate Berechtigungsgruppe mit eigenen Richtlinien (siehe Abschnitt „Zugriff auf den AWS-Kontozugang durch Identity Center“), sodass die CLI-Berechtigungen unabhängig eingeschränkt werden können.
Erfahren Sie mehr: Wie die SageMaker AI-Exekutionsrollen verwenden
AWS-Kontozugriff über Identity Center
Abgesehen von SageMaker Studio benötigen Teams oft direkten Zugang zum AWS-Konto für CLI-Aufgaben wie das Ausführen von kubectl-Befehlen, die Erstellung von Skripten für Workflows oder die programmgesteuerte Zugriff auf Ressourcen. Die Identity Center-Permissionssets bieten diese Fähigkeit.
Für die Admin-Gruppe vergeben Sie ein Berechtigungspaket mit administrativen Zugriffen, wie es von den Richtlinien Ihres Unternehmens gefordert wird, und gewähren Sie den notwendigen Zugang zum Konto für die Clusterverwaltung und administrative Aufgaben.
Für Team A und Team B erstellen Sie Berechtigungssets mit Inline- oder verwalteten Richtlinien, die die für die CLI-Arbeitsabläufe benötigten Berechtigungen direkt gewähren. Ein typisches Team-Berechtigungsset umfasst Berechtigungen für eks:AccessKubernetesApi (um Kubernetes-Ressourcen vom AWS-Konsole aus zu sehen), zugängliche S3-Zugriffe auf die Daten des Teams und CloudWatch-Zugriff zur Überwachung. Diese Richtlinien werden unabhängig von der Studio-Exekutionsrolle definiert, sodass Administratoren die CLI-Berechtigungen an die spezifischen Operationen anpassen können, die die Teams von der Kommandozeile aus durchführen.
Benutzer erhalten vorübergehende Zugangsdaten über die AWS Command Line Interface (AWS CLI) mit dem aws sso login, und können diese dann verwenden, um kubectl zu konfigurieren, um direkt mit dem EKS-Cluster interagieren zu können.
Das folgende Bild zeigt die Einzelspieler-Right-Set-Einstellungen in AWS IAM Identity Center, die eine eingeschränkte Zugriffmöglichkeit für AWS-Konten für CLI-Workshops wie das Ausführen von kubectl und aws sso login gegenüber dem EKS-Cluster bieten.
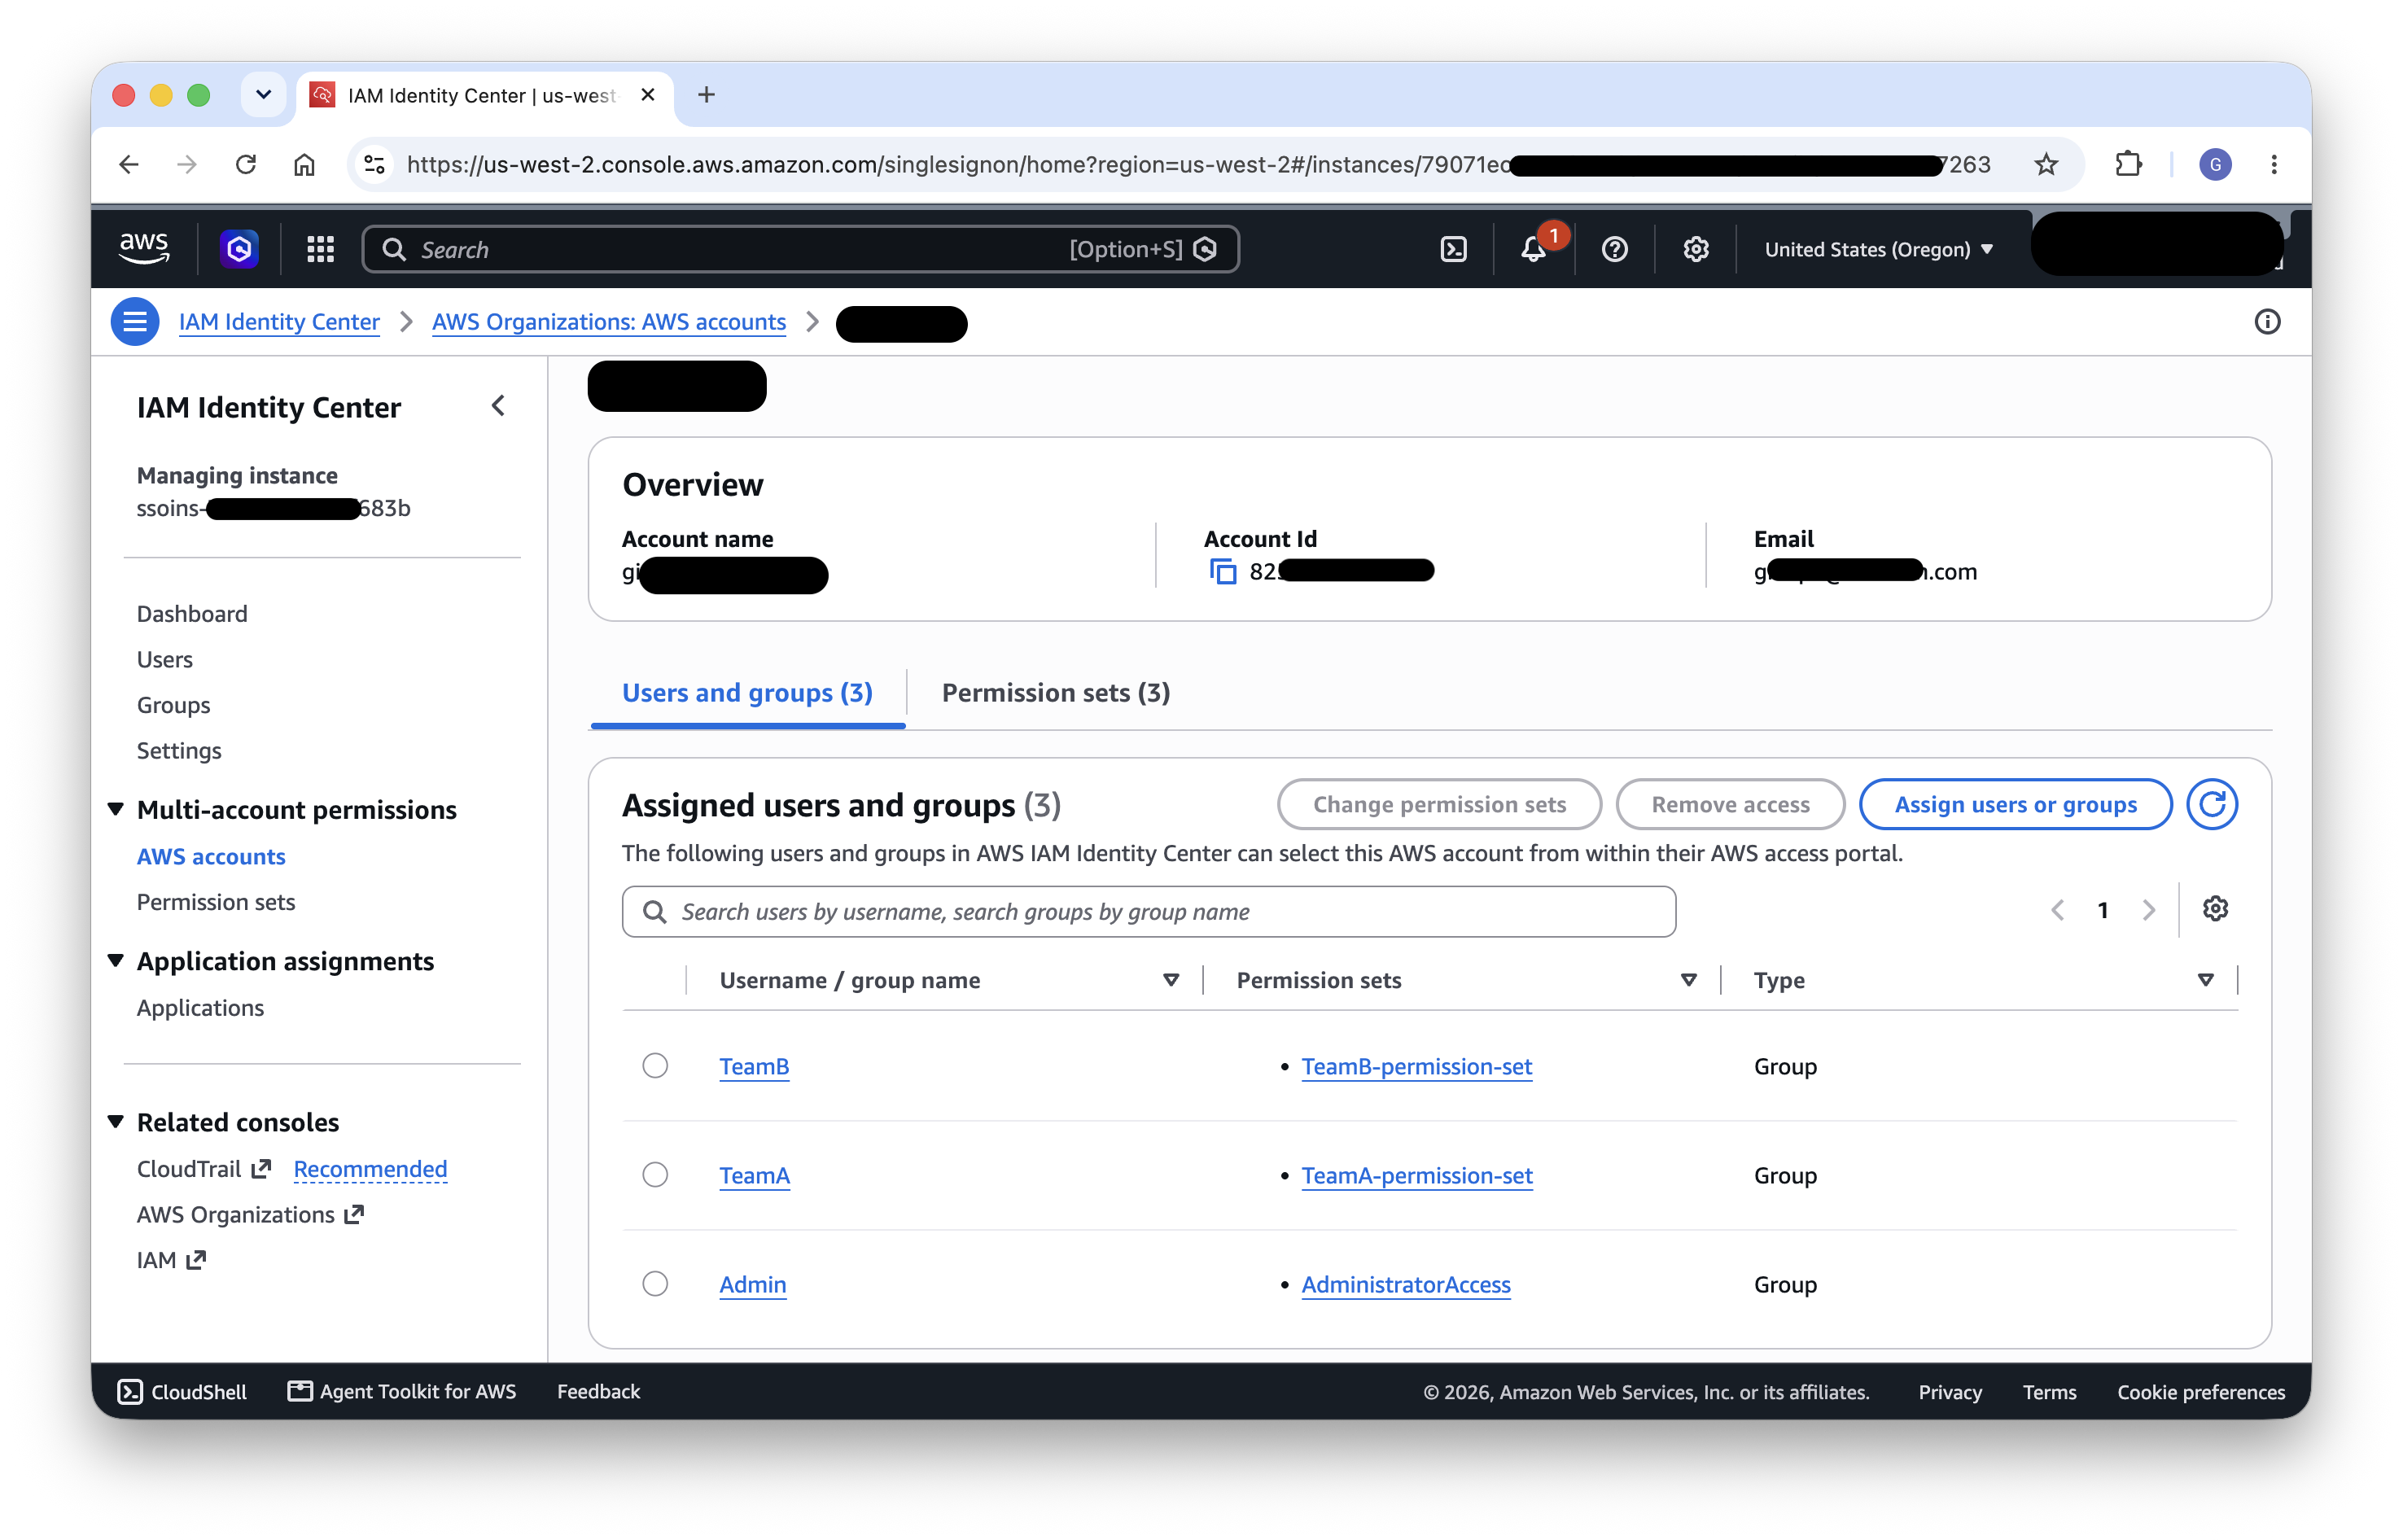
Abbildung 4: Team-ebene Berechtigungsgruppen in AWS IAM Identity Center für CLI-Werkebenen
Erfahren Sie mehr: Verwalten von AWS-Konten mit Berechtigungs Sets
Konfiguration der AWS CLI
Die Teammitglieder konfigurieren die AWS CLI, um durch Identity Center zu authentifizieren, indem sie aws configure sso ausführen. Dadurch werden Profile in ~/.aws/config erstellt, die die entsprechende Identity Center-Sitzung und das Berechtigungsset referenzieren. Jedes Teammitglied verwendet sein teamspezifisches Profil, wenn es über die Kommandozeile mit dem Cluster interagiert, wodurch die Autorisierungsgrenzen erhalten bleiben – unabhängig davon, ob der Zugriff von Studio oder aus einem lokalen Terminal stammt.
Die erzeugte Konfiguration definiert einen gemeinsamen sso-session-Block für das Identity Center-Portal sowie ein Profil pro Team, wobei jedes Profil auf die Berechtigungen des jeweiligen Teams verweist. Die Teammitglieder führen anschließend aws sso login --profile <team> aus, um vorübergehende Kredite auszugeben, die auf ihre Berechtigungen bezogen sind:
[sso-session my-sso]
sso_start_url = https://d-xxxxxxxxxx.awsapps.com/start
sso_region = us-west-2
sso_registration_scopes = sso:account:access

[default]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = OpsAdmin
region = us-west-2

[profile team-a]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamA-permission-set
region = us-west-2

[profile team-b]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamB-permission-set
region = us-west-2
Erfahren Sie mehr: Konfiguration der Authentifizierung im IAM Identity Center mit der AWS CLI
SageMaker AI Domains
SageMaker AI Domains bieten die Arbeitsumgebung für jedes Team an, mit einer individuellen Benutzerfreundlichkeit, vorverwalteten Ausführungsrollen und integrierten Integration mit der Authentifizierung von Identity Center.
Warum SageMaker AI Domains
Ein einzelnes SageMaker AI-Domain pro Team ist ein etablierter Muster, um mehrteamsige Umgebungen zu organisieren. Diese Vorgehensweise bietet mehrere Vorteile:
- Etabliertes Mehrteams-Modell – AWS hat diese Vorgehensweise ausführlich dokumentiert, um Geschäftsbereiche oder Teams mit mehreren Domains zu trennen; es handelt sich dabei um eine bewährte und unterstützte Konfiguration.
- Authentifizierung mit Native Identity Center – Jeder Domain kann mit der Authentifizierung durch Identity Center konfiguriert werden, wodurch die Benutzer einmal über ihren Unternehmensidentitätsdienst einloggen und direkt in die Studio-Umgebung ihres Teams gelangen.
- Integrierte Teamkonfiguration – Domains bieten bereits Mechanismen, um Konfigurationen für Benutzer und Teams anzugeben, ohne zusätzliche benutzerdefinierte Entitäten erforderlich zu sein. Beispielsweise können Einstellungen wie die Rolle der Teamausführung auf Ebene des Domains festgelegt werden, und auf Ebene des Benutzerprofiles überschrieben, um maximale Flexibilität zu erreichen.
- Navigationsanpassung – Mit den Domainsetzungen können Administratoren die Navigations Elemente verbergen, die nicht für den Arbeitsablauf des Teams relevant sind, und eine fokussierte Benutzeroberfläche für HyperPod-Szenarien bereitstellen.
Erfahren Sie mehr: SageMaker AI-Domänen-Entitäten und Statuse · Überblick über mehrere Domains
Einstellung der Team-Domains
Erstellen Sie ein SageMaker AI-Domain pro Team mit Authentifizierung durch Identity Center. In unserem Beispiel erstellen wir TeamA-domain und TeamB-domain. Jeder Domain wird wie folgt konfiguriert:
- Standard-Executions-Rolle – Setzen Sie die Standard-Executions-Rolle des Domains auf die für das Team spezifische IAM-Rolle, die im Bereich der Autorisierung erstellt wurde. Alle durch Studio ausgeführten Aktionen erhalten daraufhin die entsprechenden Berechtigungen.
- Identity Center-Gruppenzuweisung – Fügen Sie die entsprechende Identity Center-Gruppe (zum Beispiel die
TeamA-Gruppe) dem Domänen hinzu. Dadurch wird die SageMaker Studio-Anwendung für alle Mitglieder dieser Gruppe aktiviert, sodass sie Zugang zur Studio-Oberfläche erhalten. - Verifizierung der Anwendungszuweisung – Nach der Konfiguration des Gruppenzugriffs prüfen Sie die Anwendungszuweisung in Identity Center, um sicherzustellen, dass die richtigen Gruppen auf die richtigen Domains zugewiesen sind.
- Navigationsanpassung – Konfigurieren Sie die Standard-Navigationseinstellungen für jeden Domain, um nur die relevanten Funktionen anzuzeigen. Beispielsweise können Sie Elemente verbergen, die nicht mit den HyperPod-Arbeitsabläufen zusammenhängen, und so eine optimierte HyperPod-fokussierte Benutzerfreundlichkeit bieten, die die kognitive Belastung der Teammitglieder reduziert, die nur mit HyperPod-Ressourcen arbeiten müssen.
Das folgende Bild zeigt die SageMaker AI-Konsole mit einem Domänenbereich pro Team (TeamA-domain und TeamB-domain), wobei jeder Team einen isolierten Arbeitsraumgrenzen hat.
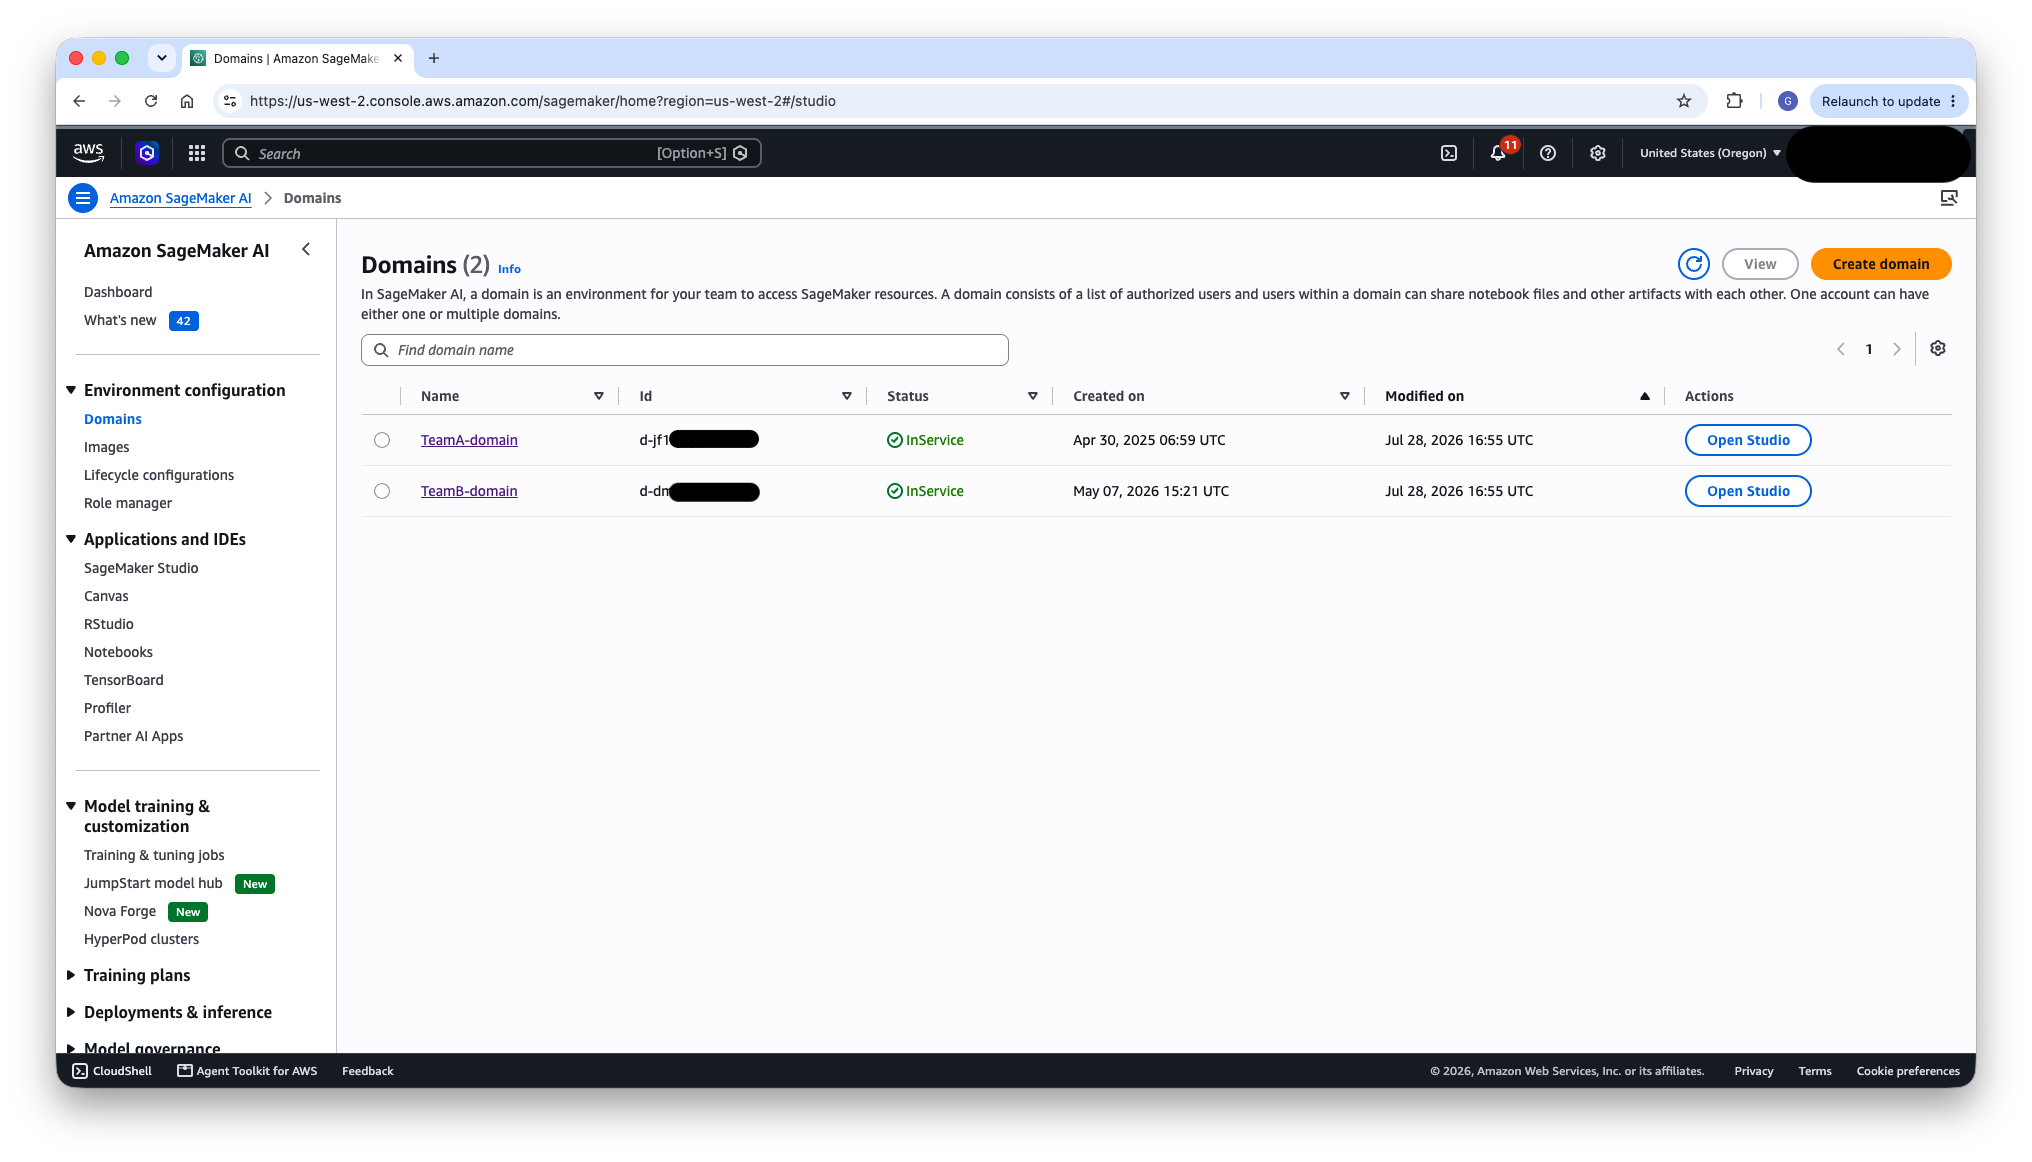
Abbildung 5: Ein SageMaker-Domain pro Team im SageMaker-Konsole
Dann zeigt das folgende Bild die Details von TeamA-domain an, einschließlich der zugewiesenen Identity Center-Gruppen.
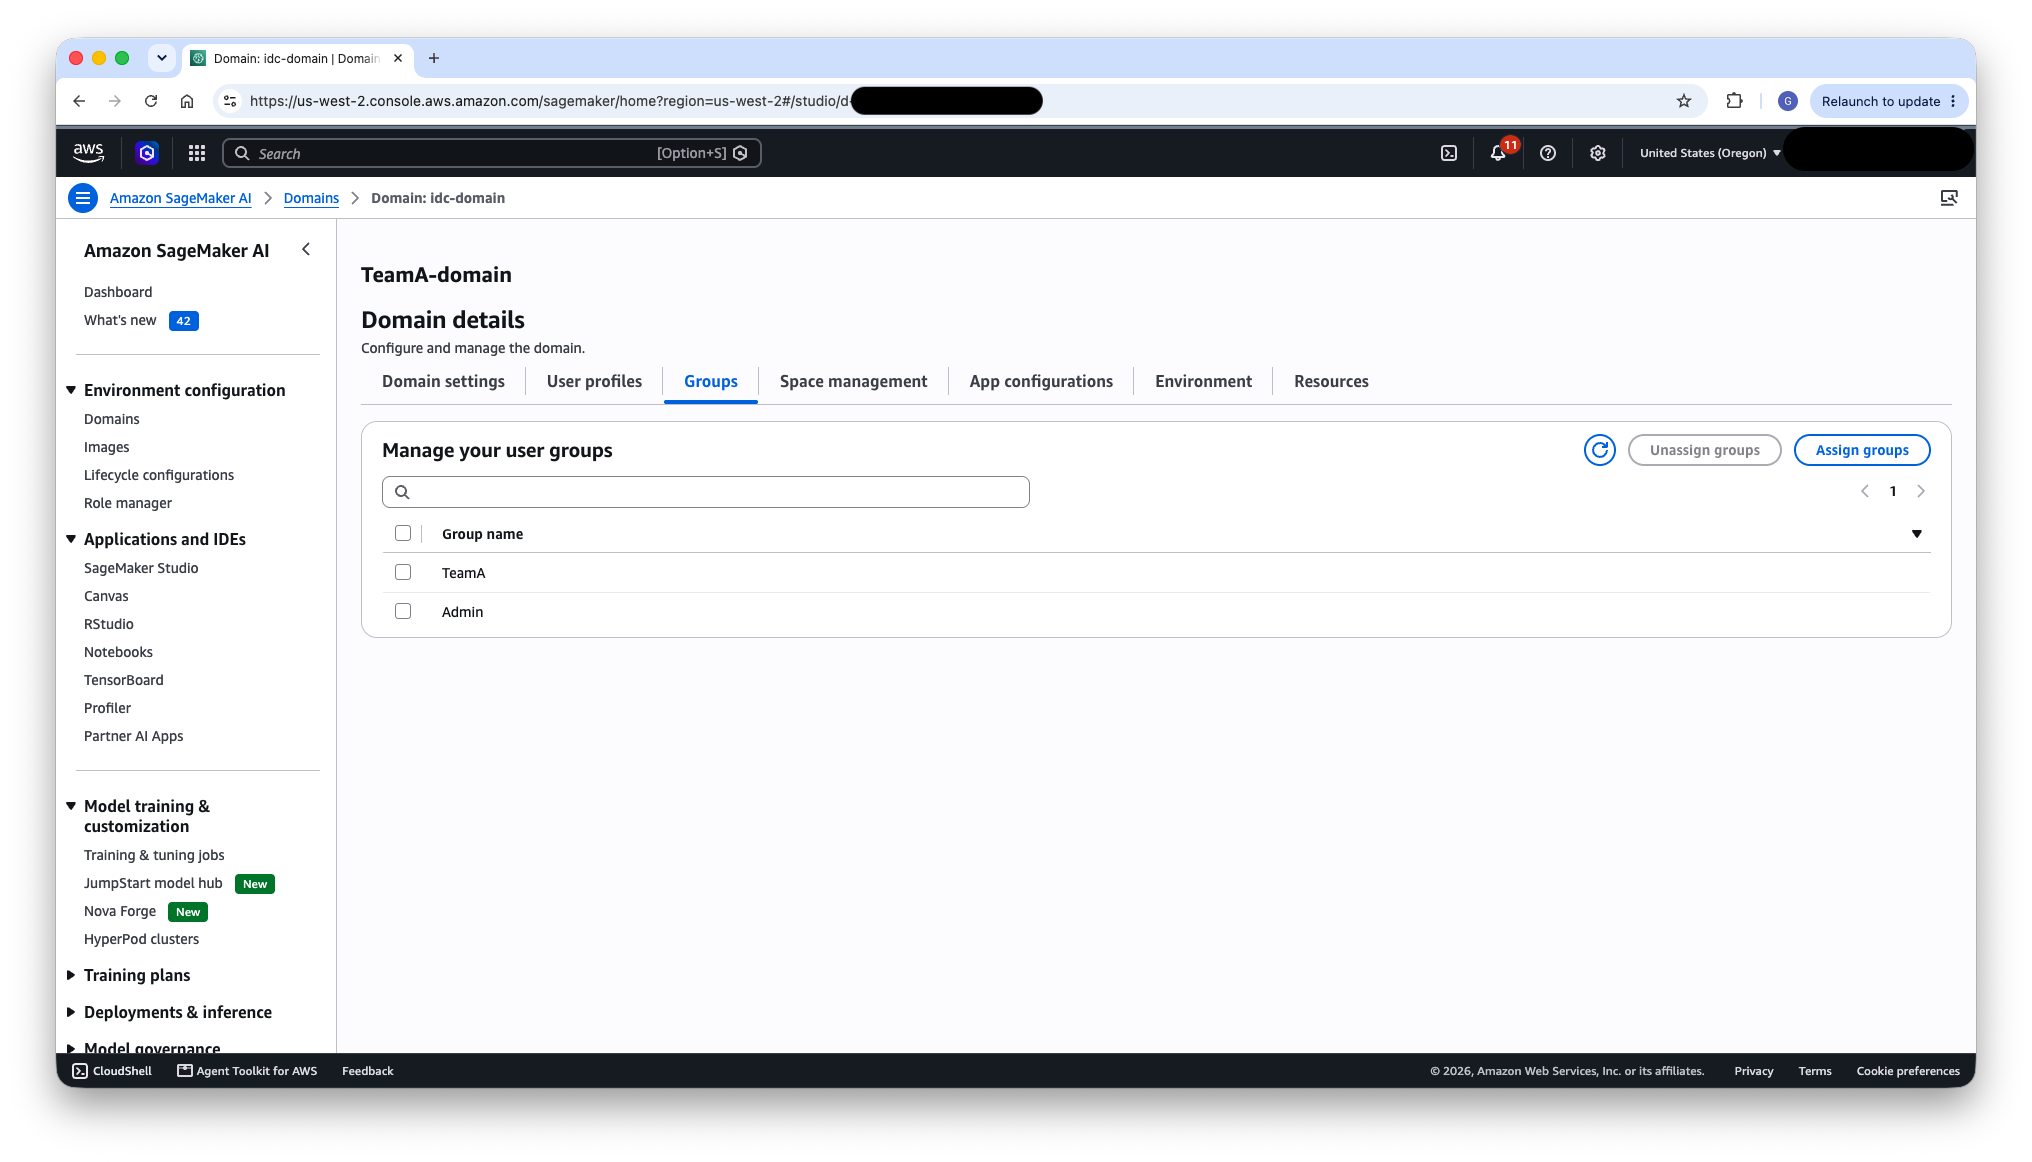
Abbildung 6: Konfiguration von TeamA-domain mit den zugewiesenen Identity Center-Gruppen
HyperPod EKS-Klusterkonfiguration
Der HyperPod EKS-Cluster ist der Ort, an dem die Arbeitslasten ausgeführt werden. Die Mehrfachnutzung auf Cluster-Ebene wird durch Kubernetes-Namenbereiche für Isolierung und EKS-Zugriffszeichen für Autorisierung erreicht.
Namensraum-Isolation
Erstelle für jedes Team einen separaten Kubernetes-Namespace, beispielsweise hyperpod-ns-team-a und hyperpod-ns-team-b. Namespaces bieten eine logische Grenze innerhalb des Clusters, die die Arbeitslasten jedes Teams (Spaces, Trainingsaufgaben, Inference-Endpunkte) voneinander trennt.
Anmerkung: Namensräume sind eine Isolationsgrenze, keine harte Sicherheitsgrenze. Diese Architektur zielt auf mehrere Teams innerhalb einer einzigen Organisation ab: Teams, die einen Cluster unter einem gemeinsamen Verwaltungsbereich und einer Grundlage des gegenseitigen Vertrauens teilen. Sie ist nicht für die mehrfache-Kunden-Isolation zwischen unverlässlichen Nutzern konzipiert.
Namensräume, RBAC und Quoten verhindern unbeabsichtigte Einflüsse (Gruppen übernehmen gegenseitig Ressourcen oder überschreiten ihre Rechenallokationen), aber sind keine Verteidigung gegen einen entschlossenen böswilligen Benutzer: Namensraum-basierte Pods teilen dieselben Knoten und Kernel, und Ressourcen, die auf dem Cluster verteilt sind (Knoten,
PersistentVolumes, CRDs, einige Operatorkomponenten), befinden sich außerhalb jedes Namensraums.Für unvertrauensvolle Mieter oder strenge regulatorische Isolierung sollten stärkere Grenzen verwendet werden, wie z. B. getrennte Clustere oder Accounts, dedizierte Node-Pools und Runtime-Sandboxing. Im Fall eines multi-team-Szenarios erreicht die Namensraum-Isolation in Kombination mit RBAC, Task-Gouvernanz-Konten und den später beschriebenen POSIX-Identitätskontrollen ein angemessenes Gleichgewicht zwischen Trennung und operativer Einfachheit.
Namensräume können manuell mit kubectl create namespace erstellt werden oder automatisch durch HyperPod Task Governance bereitgestellt werden, das Namensräume als Teil seiner Quoten- und Planungseinstellungen verwaltet.
Das folgende Bild zeigt die Cluster-Namen spaces (verwaltet mit HyperPod Task Governance), wobei jedes Team einen separaten Namen space hat.hyperpod-ns-team-a und hyperpod-ns-team-b) Bereitstellung von Arbeitslast-Isolation.
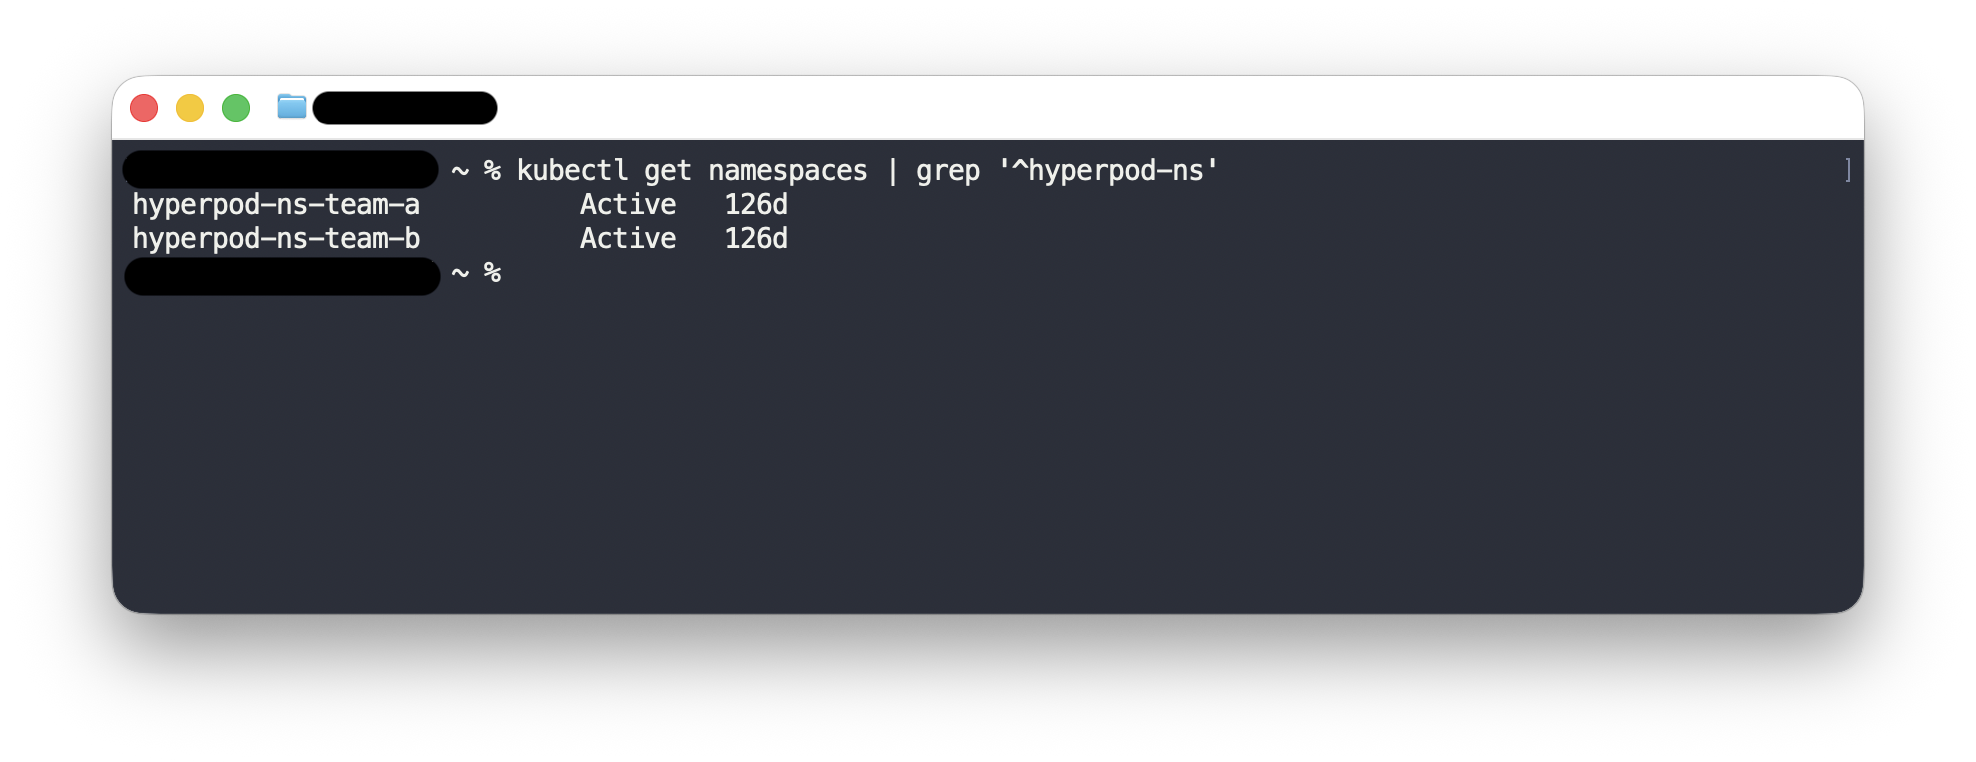
Abbildung 7: Spezieller Kubernetes-Namespace pro Team für Arbeitslastenisolation
Erfahren Sie mehr: Kubernetes Namespaces
Netzwerkisolierung
Namensräume beschränken den Netzwerkverkehr nicht. Standardmäßig ist das Netzwerkinfrastruktur von Kubernetes flach: Jeder Pod kann zu jedem anderen Pod in allen Namensräumen zugänglich sein. Folglich kann ein Pod in hyperpod-ns-team-a eine Verbindung zu einem Pod in hyperpod-ns-team-b herstellen, es sei denn, man fügt Kontrollen hinzu. Um die Zugänglichkeit zwischen Podn und Podn entlang der Teamgrenzen zu begrenzen, verwenden Sie Kubernetes NetworkPolicy-Ressourcen.
Der empfohlene Muster ist default-deny pro Namespace: Man beginnt damit, den gesamten Eingang (und optional auch den Ausgang) zu verweigern, und erlaubt anschließend explizit den Traffic, den jede Gruppe benötigt – in der Regel die Kommunikation innerhalb des Namenspaces sowie der erforderlichen Ausgänge wie DNS, Speicher-Endpunkte und AWS-APIs. Im folgenden Beispiel wird der gesamte Eingang im Namespace einer Gruppe verweigert und der Traffic nur von Pods innerhalb desselben Namenspaces erlaubt.
# 1. Default-deny all ingress in the team's namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}  # applies to all pods in the namespace
  policyTypes:
  - Ingress
---
# 2. Allow ingress only from pods within the same namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-same-namespace
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector: {}  # any pod in this namespace
NetworkPolicy Durchsetzung hängt von einer Container-Netzwerk-Schnittstelle (CNI) ab, die dies unterstützt. Auf EKS kann man die Unterstützung für Netzwerkpolitik in der Amazon Virtual Private Cloud (Amazon VPC) CNI aktivieren.
Wie bei Namensräumen reduzieren die NetworkPolicies die unbeabsichtigte Kommunikation zwischen Teams und verringern den Bereich, aber sie sind allein keine konfrontative Sicherheitsgrenze auf gemeinsamen Knoten. Für eine stärkere Trennung sollten dedizierte Knotenpools pro Team oder separate Clustere verwendet werden, wie bereits erwähnt.
Erfahren Sie mehr: Kubernetes-Netzwerkpolicies · Amazon VPC CNI-Netzwerkpolicy
EKS-Zugriffseinträge
EKS-Zugriffzeichen verbinden IAM-Principale mit Kubernetes-RBAC-Rechten. Für jedes Team erstellen Sie zwei Zugriffzeichen:
- Eintrag für den Zugang zum Studio – Die IAM-Principalkonfiguration ist die SageMaker AI-Domain-Erstellungsrolle des Teams. Dieser Eintrag wird verwendet, wenn Aktionen aus der SageMaker Studio-GUI stammen.
- CLI-Zugang-Eintrag – Der IAM-Primär ist die von SSO bereitgestellte Rolle, die durch Identity Center für das Berechtigungsset des Teams erstellt wird (nach dem Muster
AWSReservedSSO_<permission-set-name>_<unique-id>). Dieser Eintrag wird verwendet, wenn Benutzer mit dem Cluster interagieren.kubectl.
Beide Einträge sind im Namespace des Teams mit verwalteten oder benutzerdefinierten Kubernetes-Policies eingebettet. Beispielsweise gewähren beide Einträge für Team A nur Berechtigungen innerhalb von hyperpod-ns-team-a. Die beiden Einträge können je nach Wunsch unterschiedliche RBAC-Policies verwenden. Zum Beispiel kann der CLI-Eintrag den Schreibzugriff auf bestimmte Ressourttypen einschränken, während der Studio-Eintrag vollständigen Zugriff ermöglicht.
Mit dieser Skalierung kann es sein, dass der Zugriff entweder vom Studio oder von der CLI stammt – die Benutzer können nur mit den Ressourcen in ihrem eigenen Namensraum interagieren. Der Versuch, Ressourcen im Namensraum eines anderen Teams aufzulisten oder zu ändern, führt zu einem Kubernetes Forbidden-Fehler.
Für fortgeschrittenere Szenarien können Sie Kubernetes-Gruppen im Zugriffs-Eintrag verwenden, um Benutzer auf benutzerdefinierte Cluster-Rollen oder Rollen zu umlegen, die feinere Berechtigungen bieten als die standardmäßigen verwalteten Politiken.
Das folgende Bild zeigt eine EKS-Zugriffsentrance für die Rolle von Team B, die auf den Namespace hyperpod-ns-team-b reduziert wurde, sodass die Berechtigungen nur innerhalb des Namespaces von Team B angewendet werden.
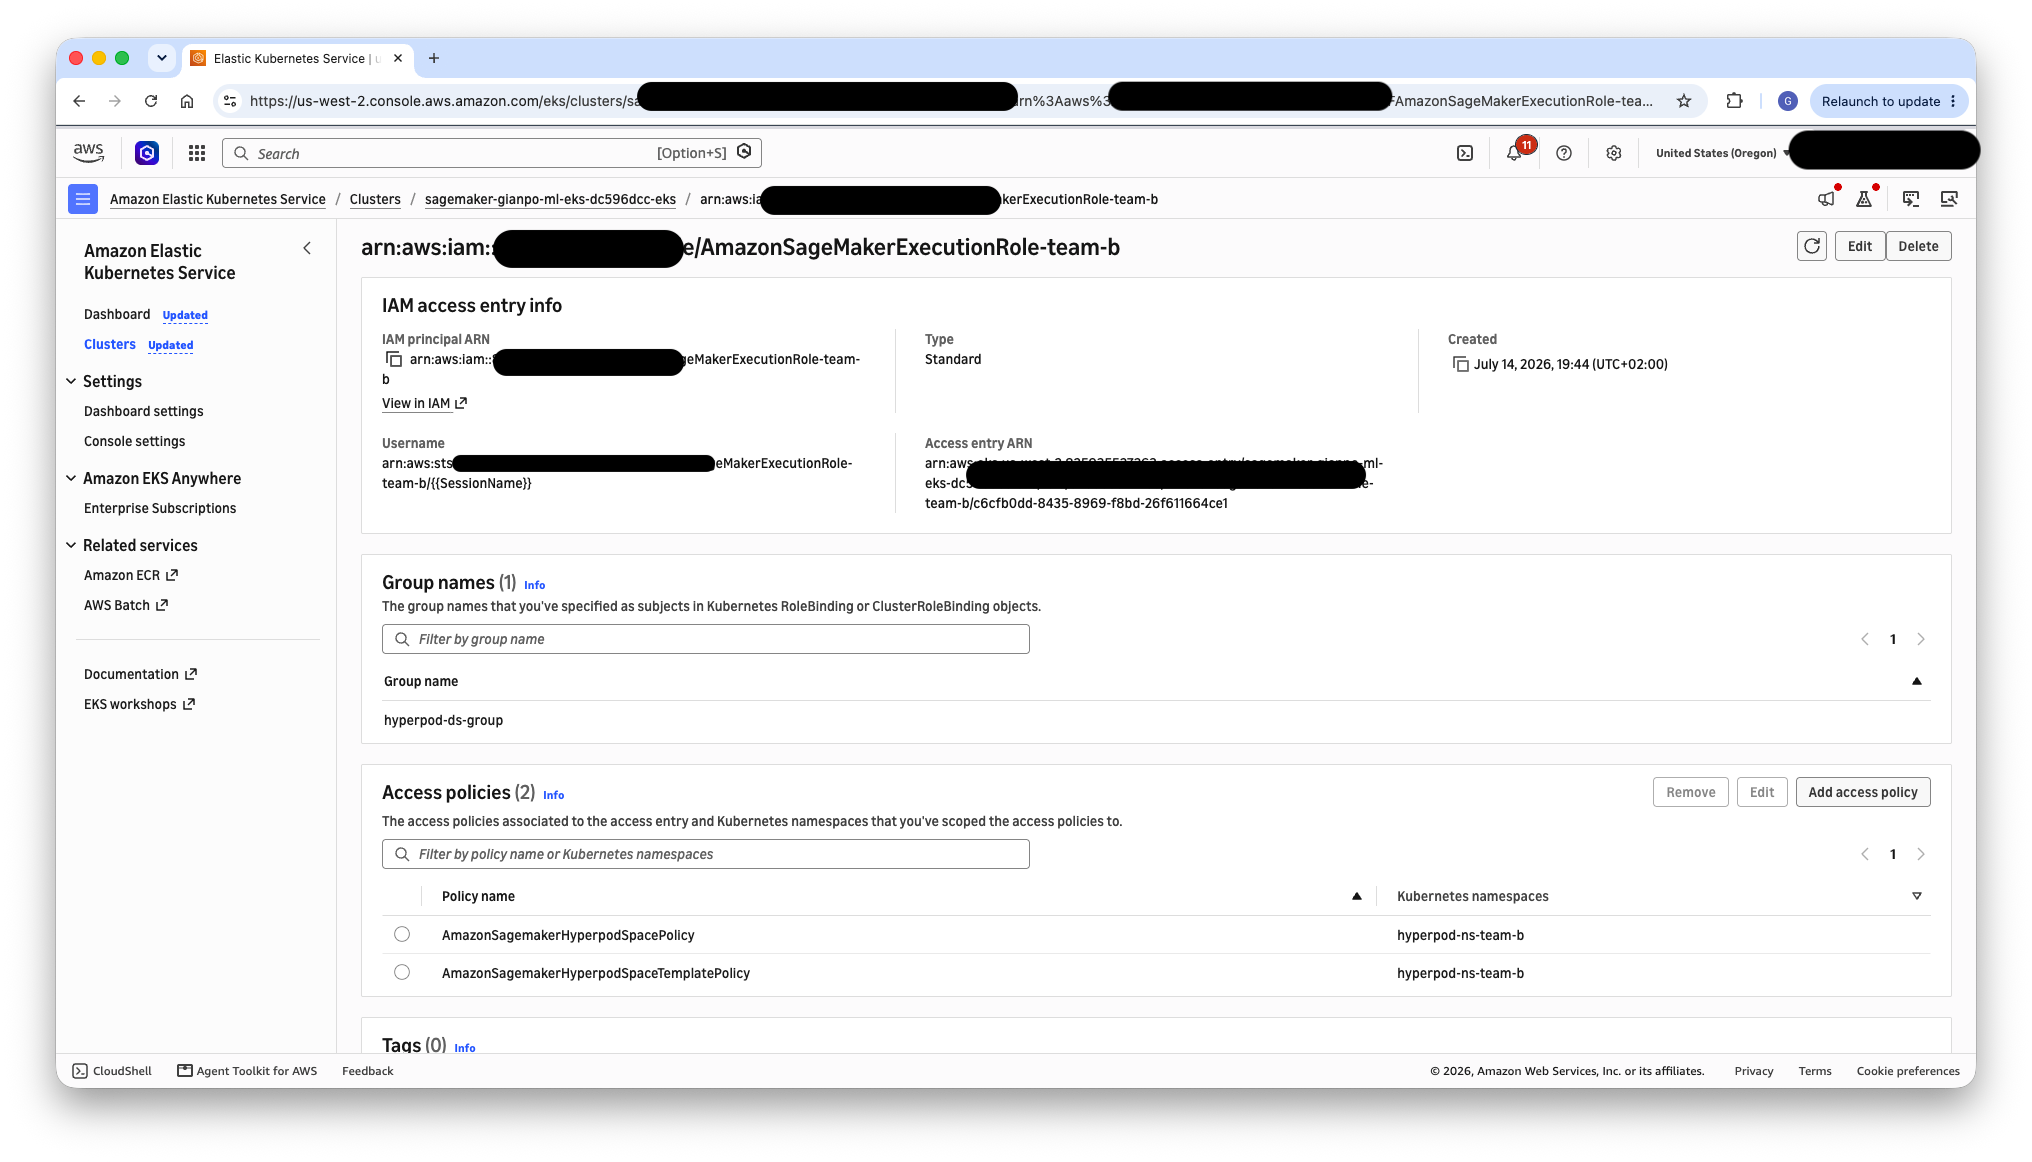
Abbildung 8: EKS-Zugriffseintrag, der auf den Namespace von Team B beschränkt ist
Erfahren Sie mehr: Verleihen IAM-Benutzern Zugriff auf Kubernetes durch EKS-Access-Entries
HyperPod Task Governance
Wenn Task Governance auf dem Cluster aktiviert ist, bietet es eine zusätzliche Schicht für die Ressourcenebene-Verwaltung:
- Quoten berechnen – Definieren Sie die Menge der GPU- und CPU-Leistung, die jede Gruppe nutzen kann. Dadurch wird verhindert, dass eine einzelne Gruppe während der Trainingsläufe das gemeinsame Hardware-System monopolisiert.
- Prioritäten – Weisen jedem Team oder Arbeitsauftrag eine Planungspriorität zu, sodass kritische Produktionsinferierende Arbeitslasten die experimentellen Trainingsaufgaben übernehmen können, wenn die Ressourcen begrenzt sind.
- Fair Scheduling – Bei Task Governance erfolgt die Ressourcenzuteilung, wenn mehrere Teams um Ressourcen konkurrieren, nach den konfigurierten Richtlinien, anstatt nach dem Prinzip „Wer zuerst kommt, mahlt zuerst“.
Konfigurieren Sie die Aufgabenverwaltung mit angemessenen Quoten und Prioritäten für den Team-Namenstab, indem Sie eine Balance zwischen den garantierten Mindestzuweisen und der Kapazität für plötzliche Arbeitslasten erreichen.
Das folgende Bild zeigt die Bereichallokationen für die Task-Gov-Infrastruktur für die beiden Teams, wobei dem Namespace jedes Teams eine eigene Quoten für die Cluster-Rechenkapazität zugewiesen wird.
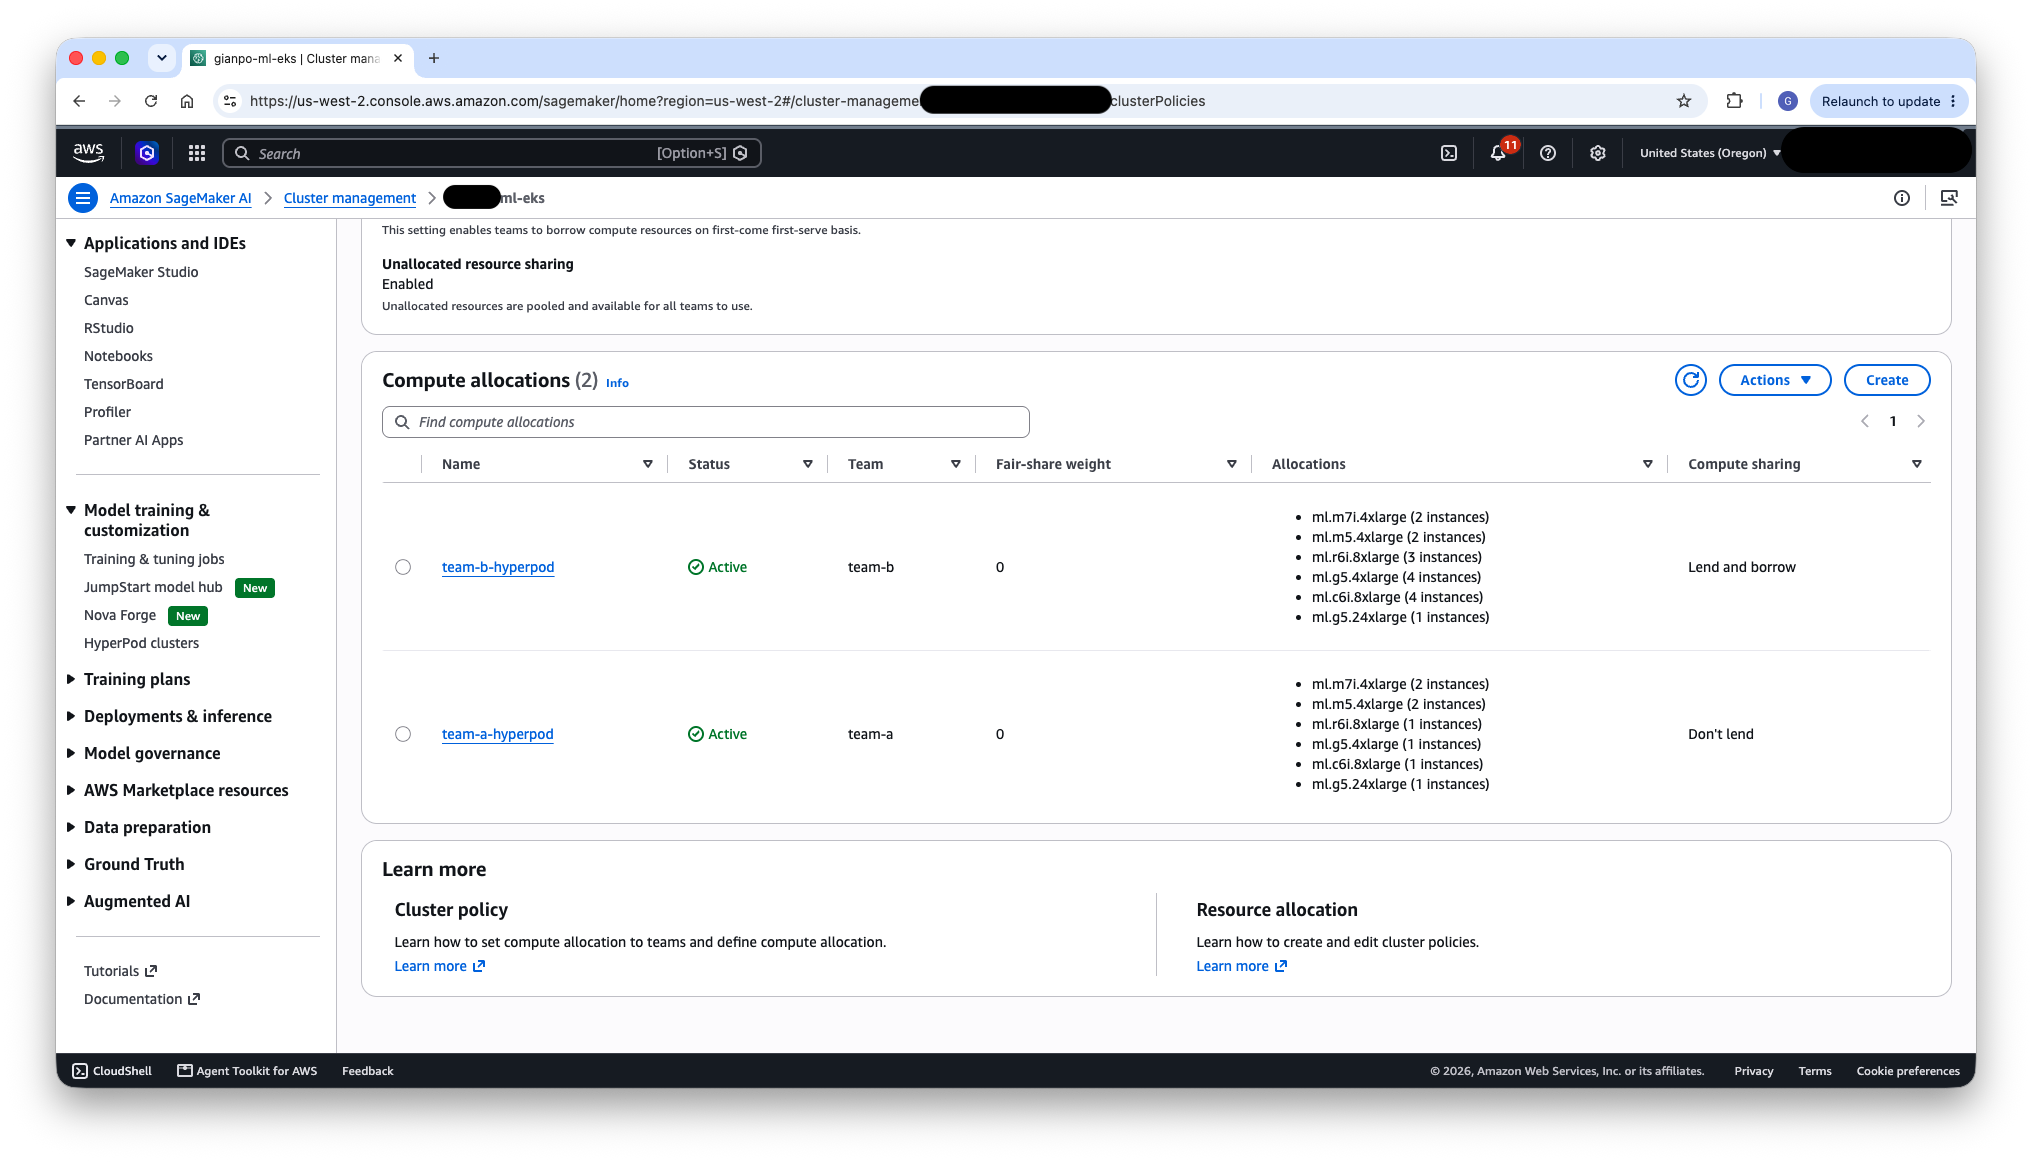
Abbildung 9: Aufgabensteuerung – Bereichsallokationen pro Team-Namenbereich
Erfahren Sie mehr: SageMaker HyperPod-Task-Governance
Speicherung
Speicher ist eine wichtige Komponente von KI- und maschinellem Lernen (AI/ML)-Umgebungen, die von verschiedenen Teams genutzt werden. Die Teams benötigen leistungsstarke Dateisysteme für Trainingsdaten, Checkpoints und Modellartefakte, während gleichzeitig angemessene Zugriffsgrenzen zwischen den Teams gewahrt bleiben müssen.
POSIX-kompatible Dateisysteme
Für Arbeitslasten, die ein gemeinsames, hochleistungsfähiges POSIX-Dateisystem erfordern (was bei verteiltem Training üblich ist, bei dem mehrere Knoten das gleiche Datenset lesen oder Checkpoints schreiben), sollten Sie die folgenden Optionen in Betracht ziehen:
- Amazon FSx for Lustre – Bietet einen hohen Durchsatz und geringe Latenz an eine parallele Dateisystem-Abfrage, ideal für großskalige Trainingslasten, die große Datensätze in hoher Geschwindigkeit lesen müssen.
- Amazon FSx für OpenZFS – Bietet ein allgemeines Dateisystem mit starken POSIX-Semantiken, Snapshots und Komprimierung. Geeignet für Arbeitslasten, die traditionelle Dateisystemfunktionen neben hoher Leistung benötigen.
- Amazon Elastic File System (Amazon EFS) – Erbringt ein vollständig verwaltetes, elastisches Network File System (NFS)-Speicherungssystem. EFS unterstützt außerdem Zugriffspunkte, die die Isolierung der Verzeichnisse pro Team vereinfachen können, indem verschiedene Montagepunkte auf unterschiedliche Verzeichnisse mit festgelegten UIDs und GIDs umgeleitet werden.
Die Speicheranordnung folgt in der Regel dieser Struktur:
- Gemeinsame Verzeichnisse pro Team – Jeder Team hat ein gemeinsames Verzeichnis (z. B.
/fsx/TeamA,/fsx/TeamB) für Datensätze, Modelle und Artefakte, auf die alle Teammitglieder zugreifen können. - Perbenutzer-Home-Direktoren – Jeder Benutzer hat einen persönlichen Home-Direktor (zum Beispiel
/home/User1,/home/User2) für individuelle Arbeit, Experimente und Notizbücher.
Das POSIX-Permissionsmodell auf diesen Dateisystemen beruht auf UIDs, GIDs und zusätzlichen Gruppen, um Zugriffsgrenzen zu festlegen. Diese POSIX-Identitäten sollten dann in den Pod-Sicherheitskontext übernommen werden, wenn ein Benutzer einen HyperPod Space startet oder eine Trainingsaufgabe eingibt, sodass der Zugriff auf das Dateisystem die konfigurierte Eigentümerschaft und Berechtigungen respektiert. Wir empfehlen die Verwendung eines Kubernetes-mutierenden Admission-Webhooks, um Informationen über die POSIX-Identität aus Ihrem Identitätsstore abzurufen. Wenn eine Arbeitslast eingegeben wird, sucht der Webhook im Laufzeitmodus nach der Identität und ändert entsprechend den Sicherheitskontext des Pods.
# 1. Extract the caller's session identity from the admission request.
# On EKS, requests from IAM-assumed roles (including IAM Identity Center)
# surface the STS session name in userInfo.extra["sessionName"]. Its format
# depends on how the session is created (e.g., an SSO short name, an email,
# or a role-session-name); align your identity mapping with this value.
def extract_username(admission_request):
    extra = admission_request["userInfo"]["extra"]
    ...
    return extra["sessionName"][0]

# 2. Look up the POSIX identity from a mapping table (e.g. DynamoDB).
def lookup_posix_identity(username):
    item = posix_table.get_item(Key={"username": username})["Item"]
    ...
    return {
        "uid": int(item["uid"]),
        "gid": int(item["gid"]),
        "supplementalGroups": [int(g) for g in item["supplementalGroups"]],
    }

# 3. Patch the Pod security context with the resolved POSIX identity.
def build_security_context_patch(pod, posix):
    ...
    return [{
        "op": "add",
        "path": "/spec/securityContext",
        "value": {
            "runAsUser": posix["uid"],
            "runAsGroup": posix["gid"],
            "fsGroup": posix["gid"],
            "supplementalGroups": posix["supplementalGroups"],
        },
    }]
Erfahren Sie mehr: FSx für Lustre · FSx für OpenZFS · Amazon EFS
Amazon S3 Speicherung
Für den Objektspeicher wird der Zugriff auf die S3-Bucket durch die IAM-Exekutionsrolle des Teams geregelt. Sie können Bucket pro Team erstellen oder einen gemeinsamen Bucket mit Team-prefixen verwenden, wobei die IAM-Policies zur Durchsetzung der Isolation verwendet werden. Die Pods im Cluster benötigen geeignete Service-Konten, die mit IAM Roles for Service Accounts (IRSA) oder Pod Identity konfiguriert sind, um auf S3 zugreifen zu können. Für Einfachheit kann man die gleiche Ausführungsrolle, die auf dem SageMaker AI-Domain konfiguriert ist, mit einem Kubernetes-Serviceaccount im Namensraum des Teams verknüpfen, sodass eine konsistente Zugriffmöglichkeit auf S3 sowohl für Studio- als auch für Cluster-Arbeitslasten besteht.
Mehr erfahren: IAM-Rollen für Service-Konten (IRSA) · EKS Pod-Identität
HyperPod Spaces
HyperPod Spaces bieten interaktive Entwicklungsumgebungen (IDEs), die direkt auf Cluster-Noden laufen. Auf einem gemeinsamen Cluster müssen Spaces richtig in den Namensraum jedes Teams eingebettet und mit geeigneten Ressourctemplates konfiguriert werden.
Raum-Formate
Erstellen Sie für jedes Team Template für Räume, die mit einem Namespace abgegrenzt sind. Diese Templates definieren die Ressourcenkonfigurationen (Instanztypen, Speichervolumina, Umgebungsvariablen), die den Teammitgliedern bei der Erstellung von Räumen zur Verfügung stehen. Durch die Abgrenzung der Templates zu einem Namespace sichert man ab, dass jedes Team nur Räume innerhalb seines bestimmten Bereichs starten kann.
Wenn die HyperPod-Task-Governance aktiv ist, sollten die Vorlagen die Standard-Labeln enthalten, die das Governance-System erfordert (z. B. Teamidentifikatoren und Prioritätslabels). Der Cluster-Administrator konfiguriert diese Labeln vorab, sodass Teammitglieder sie beim Start von Spaces nicht manuell angeben müssen.
Der folgende Beispielcode zeigt ein JupyterLab-Space-Template, der auf das Team A beschränkt ist. Die für das Team spezifischen Teile sind die metadata.namespace, das Label für die Task-Govorki unter baseLabels sowie die defaultVolumes, die das gemeinsame Dateisystem des Teams und die Home-Direktore des Benutzers erweitern:
apiVersion: workspace.jupyter.org/v1alpha1
kind: WorkspaceTemplate
metadata:
  name: jl-smd-custom
  namespace: hyperpod-ns-team-a  # scopes the template to Team A's namespace
spec:
  displayName: "JupyterLab (team-a)"
  description: "SageMaker Distribution"
  appType: jupyterlab
  baseLabels:
  - key: kueue.x-k8s.io/queue-name  # Task Governance (Kueue) local queue for Team A
    value: hyperpod-ns-team-a-localqueue
  ...
  # container command, default CPU/memory resources, security context, access type, etc.
  ...
  defaultVolumes:
  - name: home-dir  # per-user home directory
    mountPath: /home
    persistentVolumeClaimName: fsx-openzfs-claim
  - name: shared-data  # Team A's shared directory
    mountPath: /fsx
    persistentVolumeClaimName: fsx-lustre-claim
  ...
  # primary (EBS) storage defaults and limits
  ...
Dauerhaftes Volumen-Anmeldungen
Erstellen Sie die entsprechenden Persistent Volume Claims (PVCs) in dem Namespace jedes Teams, indem Sie auf das gemeinsame Dateisystem Bezug nehmen. Diese PVCs montieren den gemeinsamen Ordner des Teams und die Heimatverzeichnis des Benutzers in den Space, wodurch Zugang zu Trainingsdaten, Checkpoints und persönlichen Arbeitsbereichen möglich ist.
Eigenen- und geteilte Räume
Berücksichtigen Sie die Anforderungen Ihrer Organisation bezüglich des Raumteilsammlens:
- Eigentümer-spezifische Räume – Jeder Raum ist nur für den Benutzer zugänglich, der ihn erstellt hat. Dies ist die Standardkonfiguration, die geeignet ist, wenn Teams an sensiblen oder unabhängigen Projekten arbeiten.
- Gemeinsame Räume – Mehrere Teammitglieder können den gleichen Raum nutzen, was für Paarprogrammierung, kollektive Fehlerbehebung oder gemeinsame Entwicklungsumgebungen nützlich ist. Wenn Sie gemeinsame Räume aktivieren, stellen Sie sicher, dass die POSIX-Rechte und ergänzende Gruppen so konfiguriert sind, dass der angemessene Zugriff auf die in dem Raum erstellten Dateien möglich ist.
Erfahren Sie mehr: Interaktive Entwicklungsumgebungen auf Amazon SageMaker HyperPod EKS Clustern
Studienerfahrung
Während die Teams das Cluster vollständig über die CLI mit kubectl interagieren können, bietet SageMaker Studio für Benutzer, die ein verwaltetes, GUI-basiertes Workflowsystem bevorzugen, eine grafische Eingangsstelle zum Cluster. In dieser Architektur erreicht jedes Team Studio über seinen eigenen SageMaker AI-Domain (wie zuvor beschrieben), meldet sich mit denselben Identitätszentrum-Kennzeichen an und arbeitet innerhalb der Grenzen des Namensraums des Teams.
Das folgende Bild zeigt das IAM Identity Center-Access-Portal, auf das die Benutzer nach dem Anmelden mit ihren Unternehmenskreditaten zugreifen können. Dadurch erhält man einen einzigen Anmeldevorgang für die ihnen zugewiesenen SageMaker Studio- und Amazon Managed Grafana-Anwendungen.
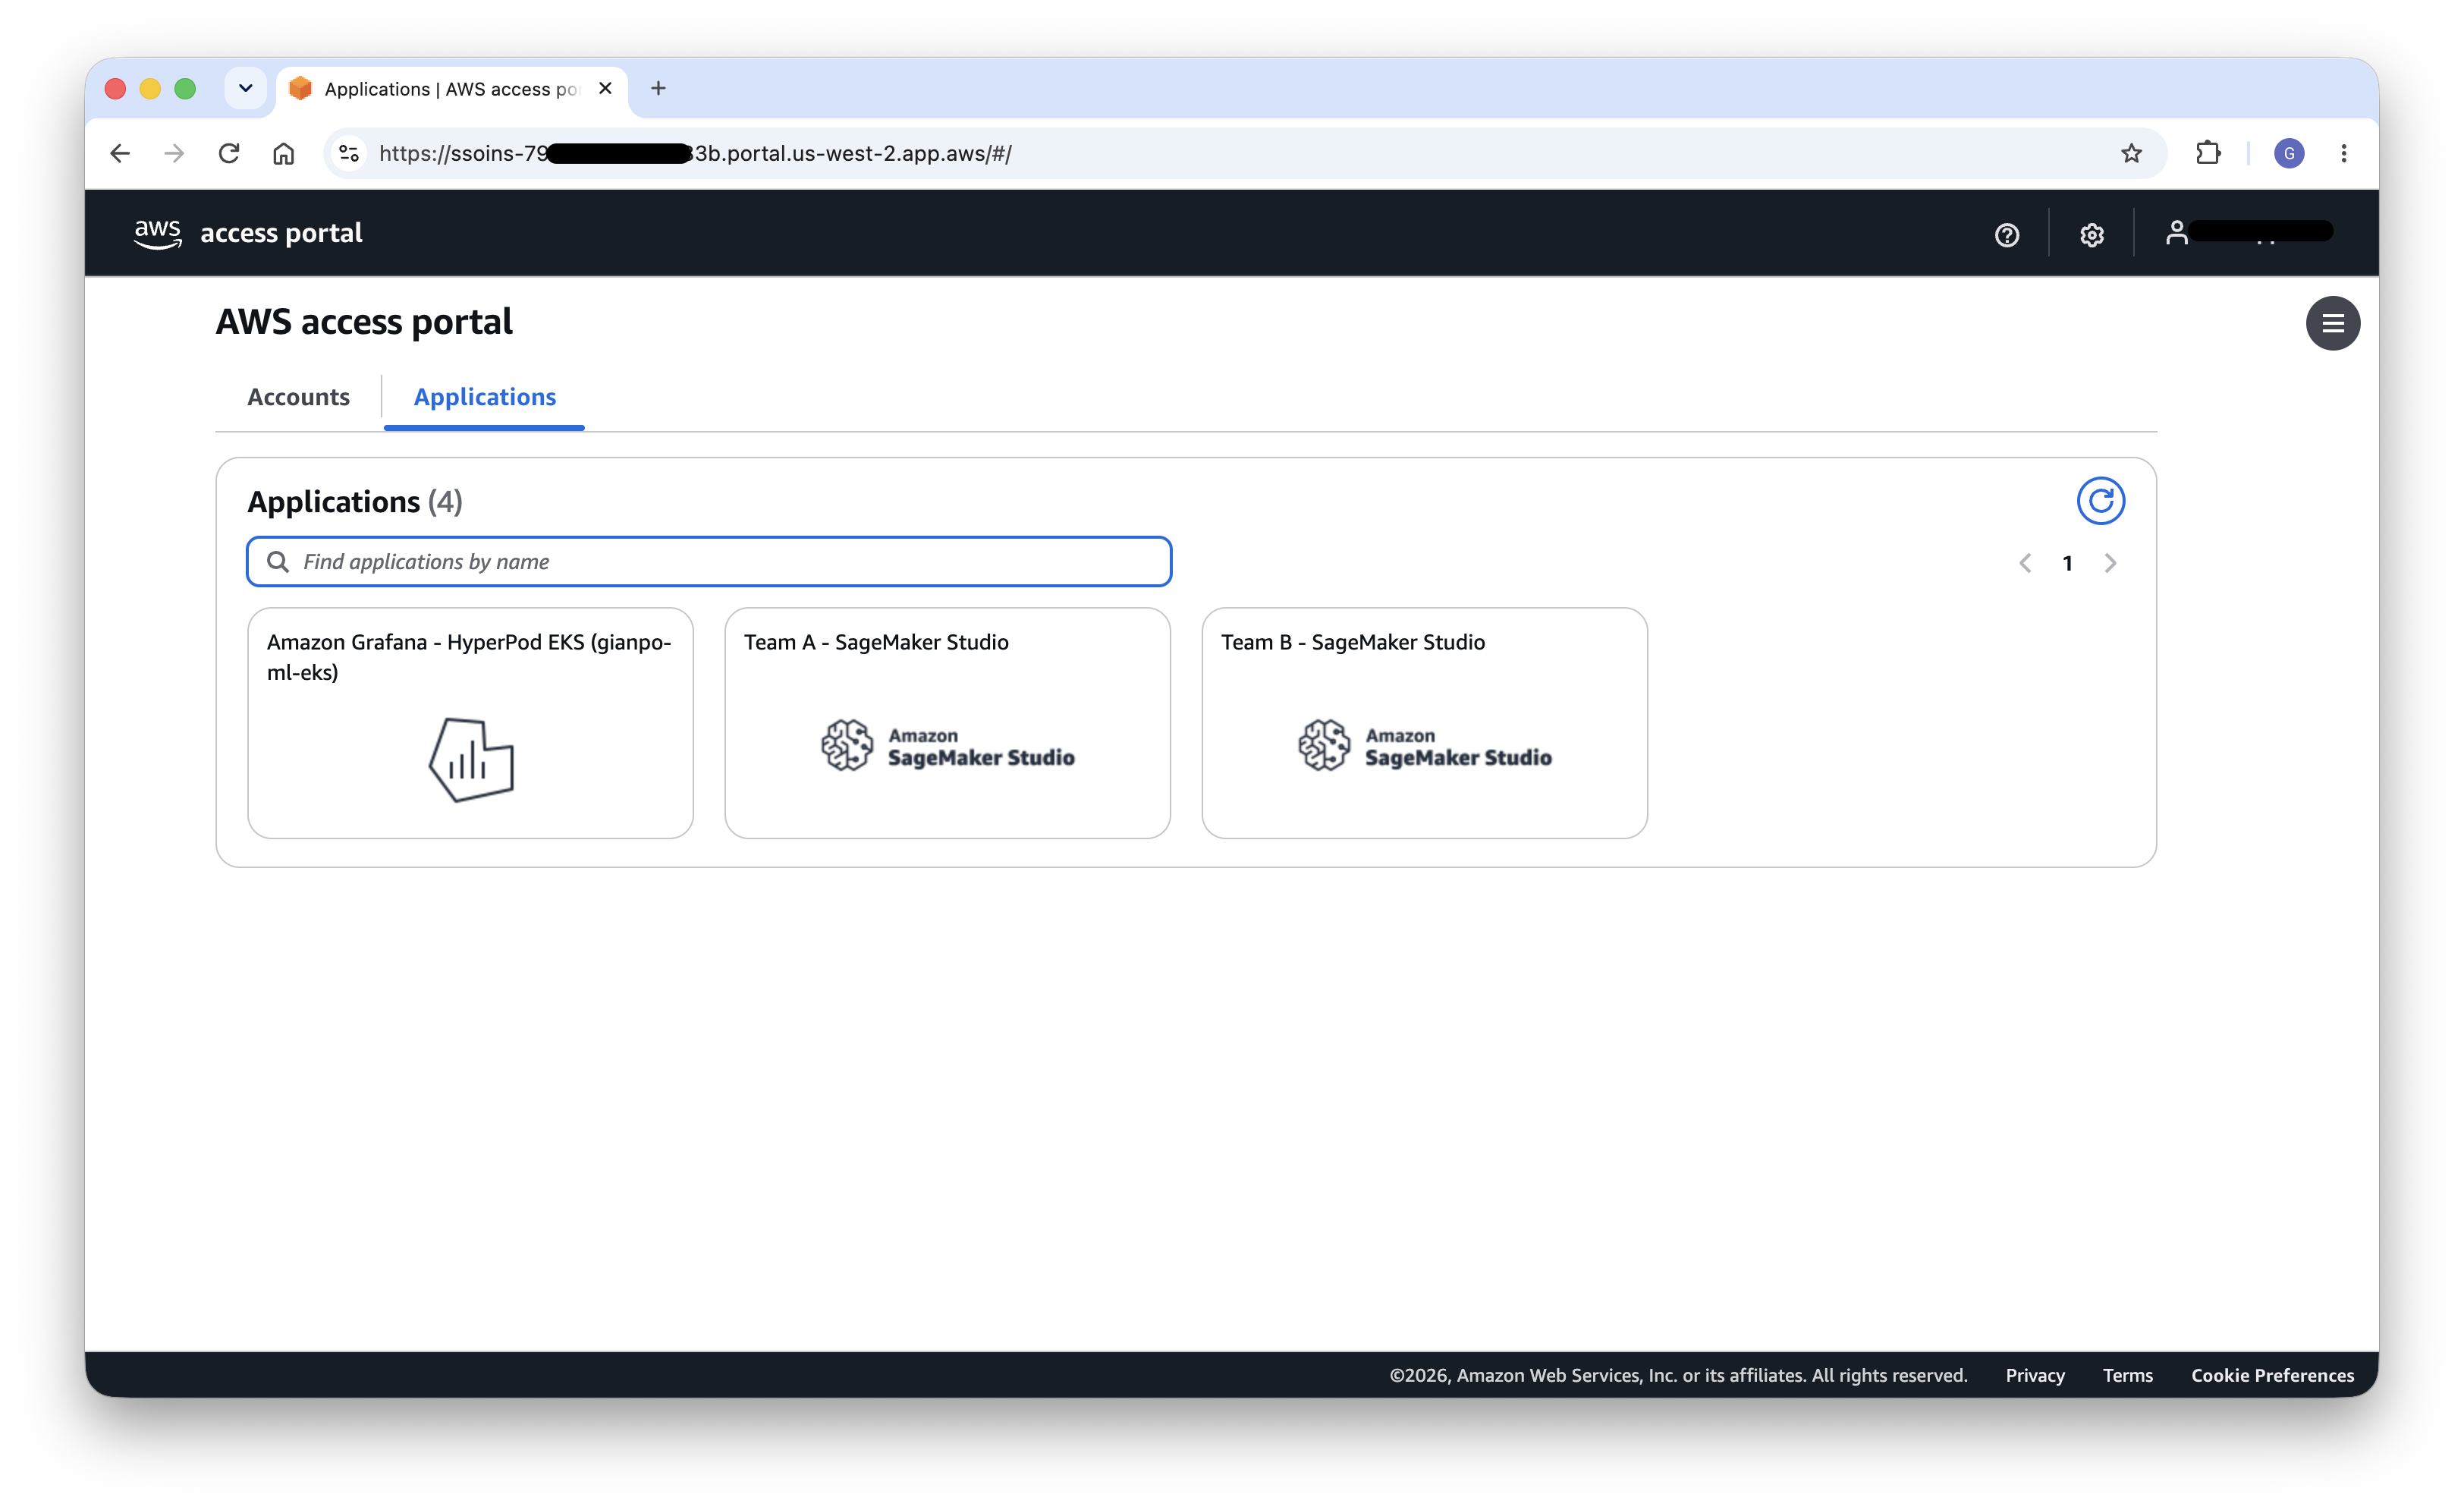
Abbildung 10: IAM Identity Center-Zugriffsportal mit Single Sign-On für zugewiesene Anwendungen
Von der Studio-Umgebung können Teammitglieder:
- HyperPod-Spaces verwalten – Start interaktive Entwicklungsumgebungen aus den von dem Administrator konfigurierten Space-Designs im Namespace, ohne Kubernetes-Manifests zu schreiben oder manuell Task Governance-Labeln anzugeben. Teammitglieder können außerdem ihre laufenden Spaces starten, stoppen und mit ihnen verbinden, indem sie das zugehörige IDE (z. B. JupyterLab) direkt im Browser öffnen.
- Ray-Arbeitslasten verwalten – Ray-Klustern erstellen und überwachen, ein JupyterLab- oder Code-Editor-Workspace an eine Klustern anschließen, verteilte Jobs einreichen sowie die Ray-Dashboard und die Amazon Managed Grafana-Beobachtungsdashboards öffnen, ohne Kubernetes-Manifeste zu schreiben oder
kubectl-Befehle auszuführen.
Da Studio durch die Domain-Execution-Rolle des Teams und den entsprechenden EKS-Zugriffstext verfügt, sind alle Aktionen im Namenraum des Teams beschränkt. Ein Benutzer, der einen Space oder einen Ray-Cluster aus Studio startet, kann ihn nur innerhalb der Grenzen seines eigenen Teams erstellen, was mit dem Isolationsmodell übereinstimmt, das für den CLI-Zugriff verwendet wird.
Die folgende Abbildung zeigt, wie ein HyperPod-Space aus der SageMaker Studio-UI erstellt wird, bei der ein Teammitglied ein Namespace-orientiertes Space-Template auswählt, ohne Kubernetes-Manifests zu schreiben oder manuell Task Governance-Labeln festzulegen.
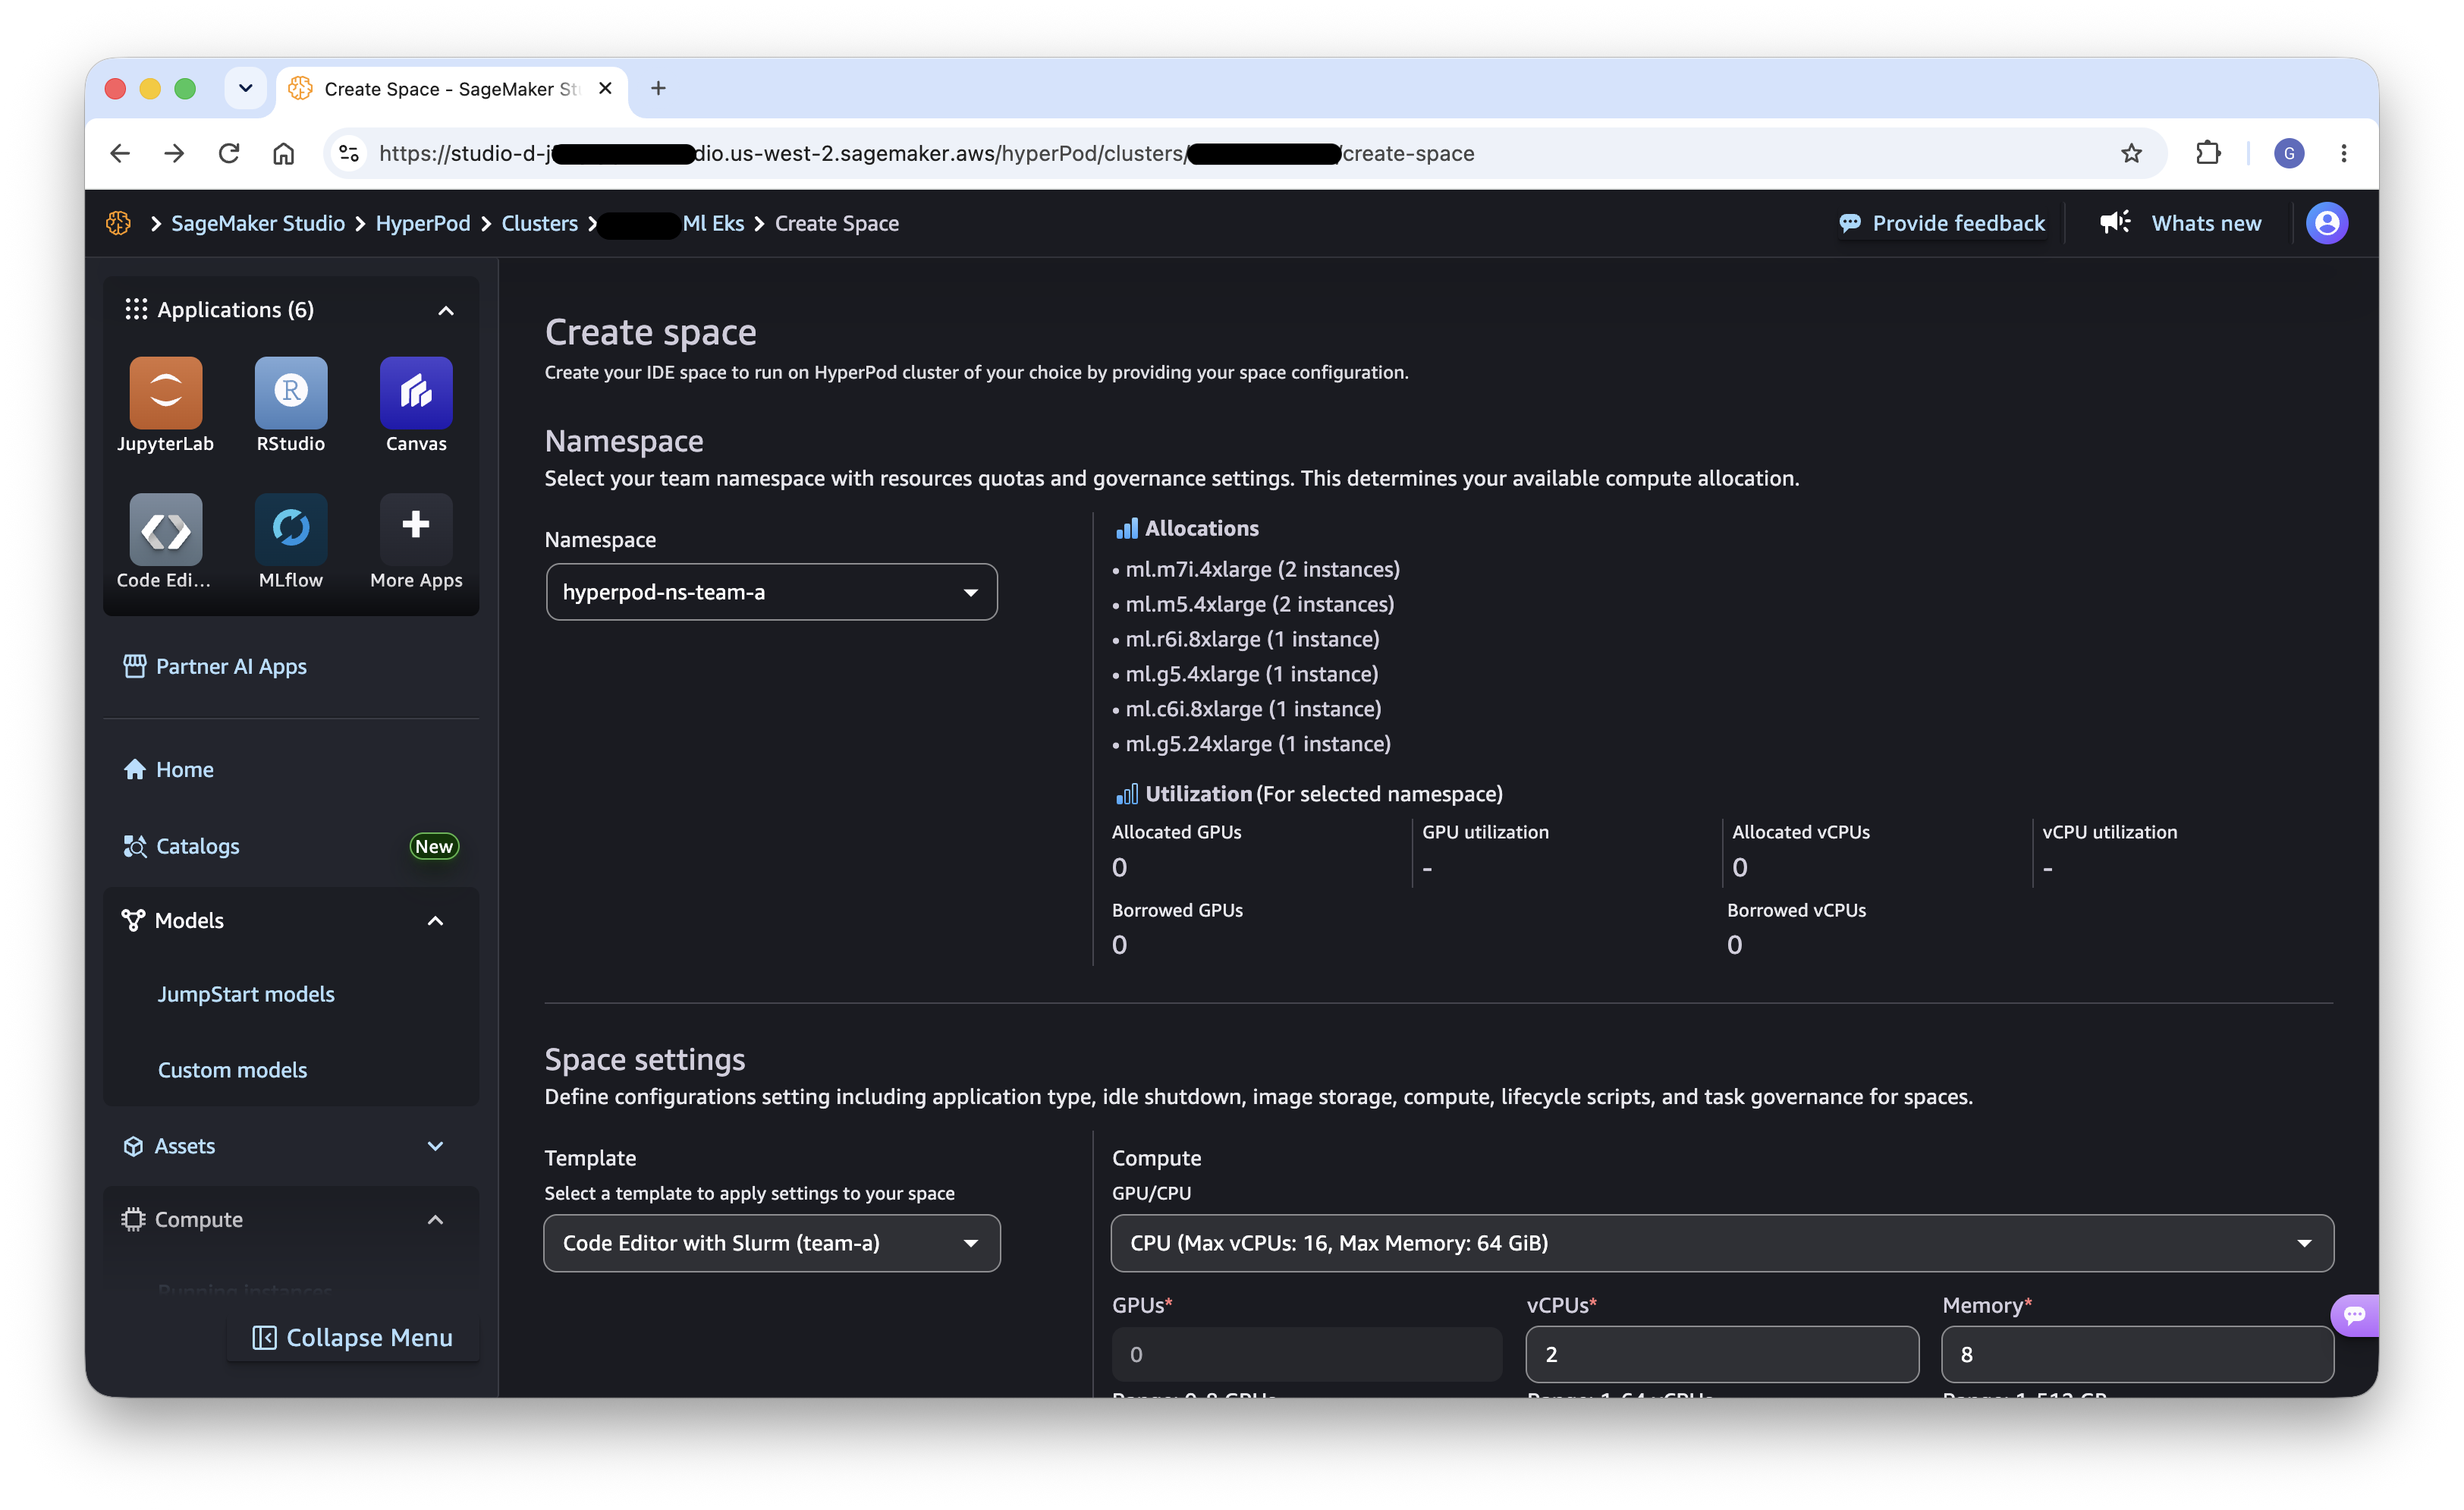
Abbildung 11: Erstellung eines HyperPod-Spaces aus einem namespace-spezifischen Template in SageMaker Studio
Erfahren Sie mehr: Interaktive Entwicklungsumgebungen auf Amazon SageMaker HyperPod EKS Clustern · Einführung neuer Ray-Funktionen auf SageMaker HyperPod
HyperPod Trainingsoperator
Der HyperPod-Training-Operator ermöglicht es den Teams, verteilte Training-Jobs als Kubernetes-konventionelle Ressourcen einzureichen (z. B. HyperPodPyTorchJob). In der multi-tenant Architektur sind die Training-Jobs namespace-orientiert, was bedeutet, dass sie automatisch die Isolationsgrenzen des Teams übernehmen.
Man kann Trainingsaufgaben über die CLI mit kubectl apply und dem entsprechenden Job-Manifest einreichen. Die Aufgabe läuft im Namespace des Teams, verwendet die Rechenquoten des Teams (falls Task Governance aktiv ist) und hat Zugriff auf die Speichervolumina des Teams.
Wenn die Task-Govorkunft aktiv ist, unterliegen die Trainingsaufgaben den zugewiesenen Quoten und Prioritätsanpassungen des Teams. Wenn ein Team seine garantierten Aufgaben verbraucht hat, können die Aufgaben in eine Warteschlange gelegt werden, bis neue Ressourcen verfügbar sind oder bis Arbeiten mit niedrigerer Priorität übernommen werden.
Die beiden Elemente, die eine Aufgabe an ein Team binden, sind der metadata.namespace (der die Aufgabe innerhalb der Isolationsgrenze des Teams beschränkt) und die Task-Govorktion-Label. Task-Govorktion basiert auf Kueue, sodass die Aufgabe über kueue.x-k8s.io/queue-name an die lokale Wartebene des Teams weitergeleitet wird. Ihr Planungspriorität wird durch kueue.x-k8s.io/priority-class zugewiesen, wobei der Wert der WorkloadPriorityClass, die im Cluster definiert ist, verwendet wird.
apiVersion: sagemaker.amazonaws.com/v1
kind: HyperPodPyTorchJob
metadata:
  name: team-a-training-job
  namespace: hyperpod-ns-team-a  # scopes the job to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: training-priority  # name of a WorkloadPriorityClass
spec:
  ...
  # replicaSpecs, container image, command, resources, volumes, etc.
  ...
Erfahren Sie mehr: Verwendung des HyperPod-Trainingsoperators
HyperPod Inferenzoperator
Der HyperPod-Inference-Operator ermöglicht es den Teams, Modelle direkt auf dem Cluster als Inference-Endpunkte einzusetzen. Ähnlich wie bei Trainingsaufgaben sind die Inference-Endpunkte im Namenbereich begrenzt und unterliegen den RBAC-Politiken der Team sowie den Quoten für Task-Gouvernance.
Man kann Modelle von der CLI aus bereitstellen, indem man Custom-Ressourcen für Inferenz-Endpunkte in seinem Namespace erstellt. Die Endpunkte sind pro Namespace isoliert, sodass Team A keine Zugriff auf oder Einfluss auf die Inferenz-Endpunkte von Team B haben kann.
Für Produktions-Inferierende-Arbeitslasten, die eine hohe Verfügbarkeit erfordern, sollte man den Scheduling-Priorität für die Inferierende-Endpunkte höher setzen als für die Trainingsaufgaben, damit das Modelldienstleistungsprozess nicht durch Batch-Trainings-Arbeitslasten unterbrochen wird.
Wie bei Trainingsjobs wird der Inferenzpunkt in der metadata.namespace des Teams platziert und trägt die Task-Govance-Label. Hier verweist kueue.x-k8s.io/priority-class auf eine höhere Prioritätige WorkloadPriorityClass, sodass das Modelldienstleistung den Batch-Training vorübergehend unterbrechen kann, wenn die Ressourcen des Teams begrenzt sind:
apiVersion: inference.sagemaker.aws.amazon.com/v1
kind: InferenceEndpointConfig
metadata:
  name: team-a-inference-endpoint
  namespace: hyperpod-ns-team-a  # scopes the endpoint to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: inference-priority  # higher-priority WorkloadPriorityClass
spec:
  ...
  # model source, instance type, replica count, autoscaling, etc.
  ...
Erfahren Sie mehr: Modelveröffentlichung auf Amazon SageMaker HyperPod
HyperPod Observability
Die Sicht auf die Gesundheit der Clustere, die Leistung des Arbeitsaufwands und die Ressourcennutzung ist für alle Teams unerlässlich. HyperPod Observability bietet integrierte Überwachungs- und Dashboard-Funktionen über Amazon Managed Grafana.
Konfiguration der Teamzugräfe auf Grafana
Die Teams benötigen Zugang zu den Observabilitätsdashboards, um ihre Arbeitslasten zu überwachen, Leistungsprobleme zu beheben und den Ressourcenzustand zu verstehen. In einer multi-tenant Umgebung sollte dieser Zugang jedoch typischerweise nur zum Lesen vorbehalten sein:
- Konfigurieren Sie die Authentifizierung von Identity Center für Amazon Managed Grafana – Auf der Konsole von Amazon Managed Grafana navigieren Sie zu „Authentication“ und aktivieren Sie AWS IAM Identity Center. Die Benutzer können anschließend mit den gleichen Unternehmenskreditkarten wie für SageMaker Studio bei Grafana einloggen.
- Zuteilen der Teamgruppen als Leser – Weisen die Identity Center-Gruppen (
TeamA,TeamB) den Rolle „Grafana Viewer“ zu. Dadurch erhalten Teammitglieder nur lesende Zugriff auf Dashboards und Metriken, ohne die Möglichkeit, Dashboards oder Datenquellen zu ändern. - Admin-Zugriff – Zuweisen Sie der
Admin-Gruppe die Rolle „Grafana Admin“ oder „Editor“, damit sie Dashboards erstellen und verändern, Alarme konfigurieren und Datenquellen verwalten können. - Team-spezifische Dashboards – Überlegen Sie sich die Erstellung dedizierter Dashboards, die Daten nach Namensraum filtern, sodass jede Teammitglieder nur ihre eigenen Arbeitslastmetriken sehen können. Amazon Managed Grafana unterstützt Grafana Teams (ein Grafana-nativees RBAC-Konzept, das sich von den organisatorischen Teams in dieser Architektur unterscheidet), die von den Gruppen im Identity Center abgebildet werden können, um die Sichtbarkeit der Dashboards einzuschränken und eine zusätzliche Schicht der Datenisolation zu bieten.
Das folgende Bild zeigt die Rollenzuweisungen in Amazon Managed Grafana. Die Teamgruppen (TeamA, TeamB) erhalten die Rolle „Viewer“ für einen Leserecht-Zugriff auf Dashboards und Metriken, während die Admin-Gruppe die Rolle „Admin“ erhält, die ihr das Recht gibt, Dashboards zu erstellen und zu ändern, Alarmen zu konfigurieren und Datenquellen zu verwalten.
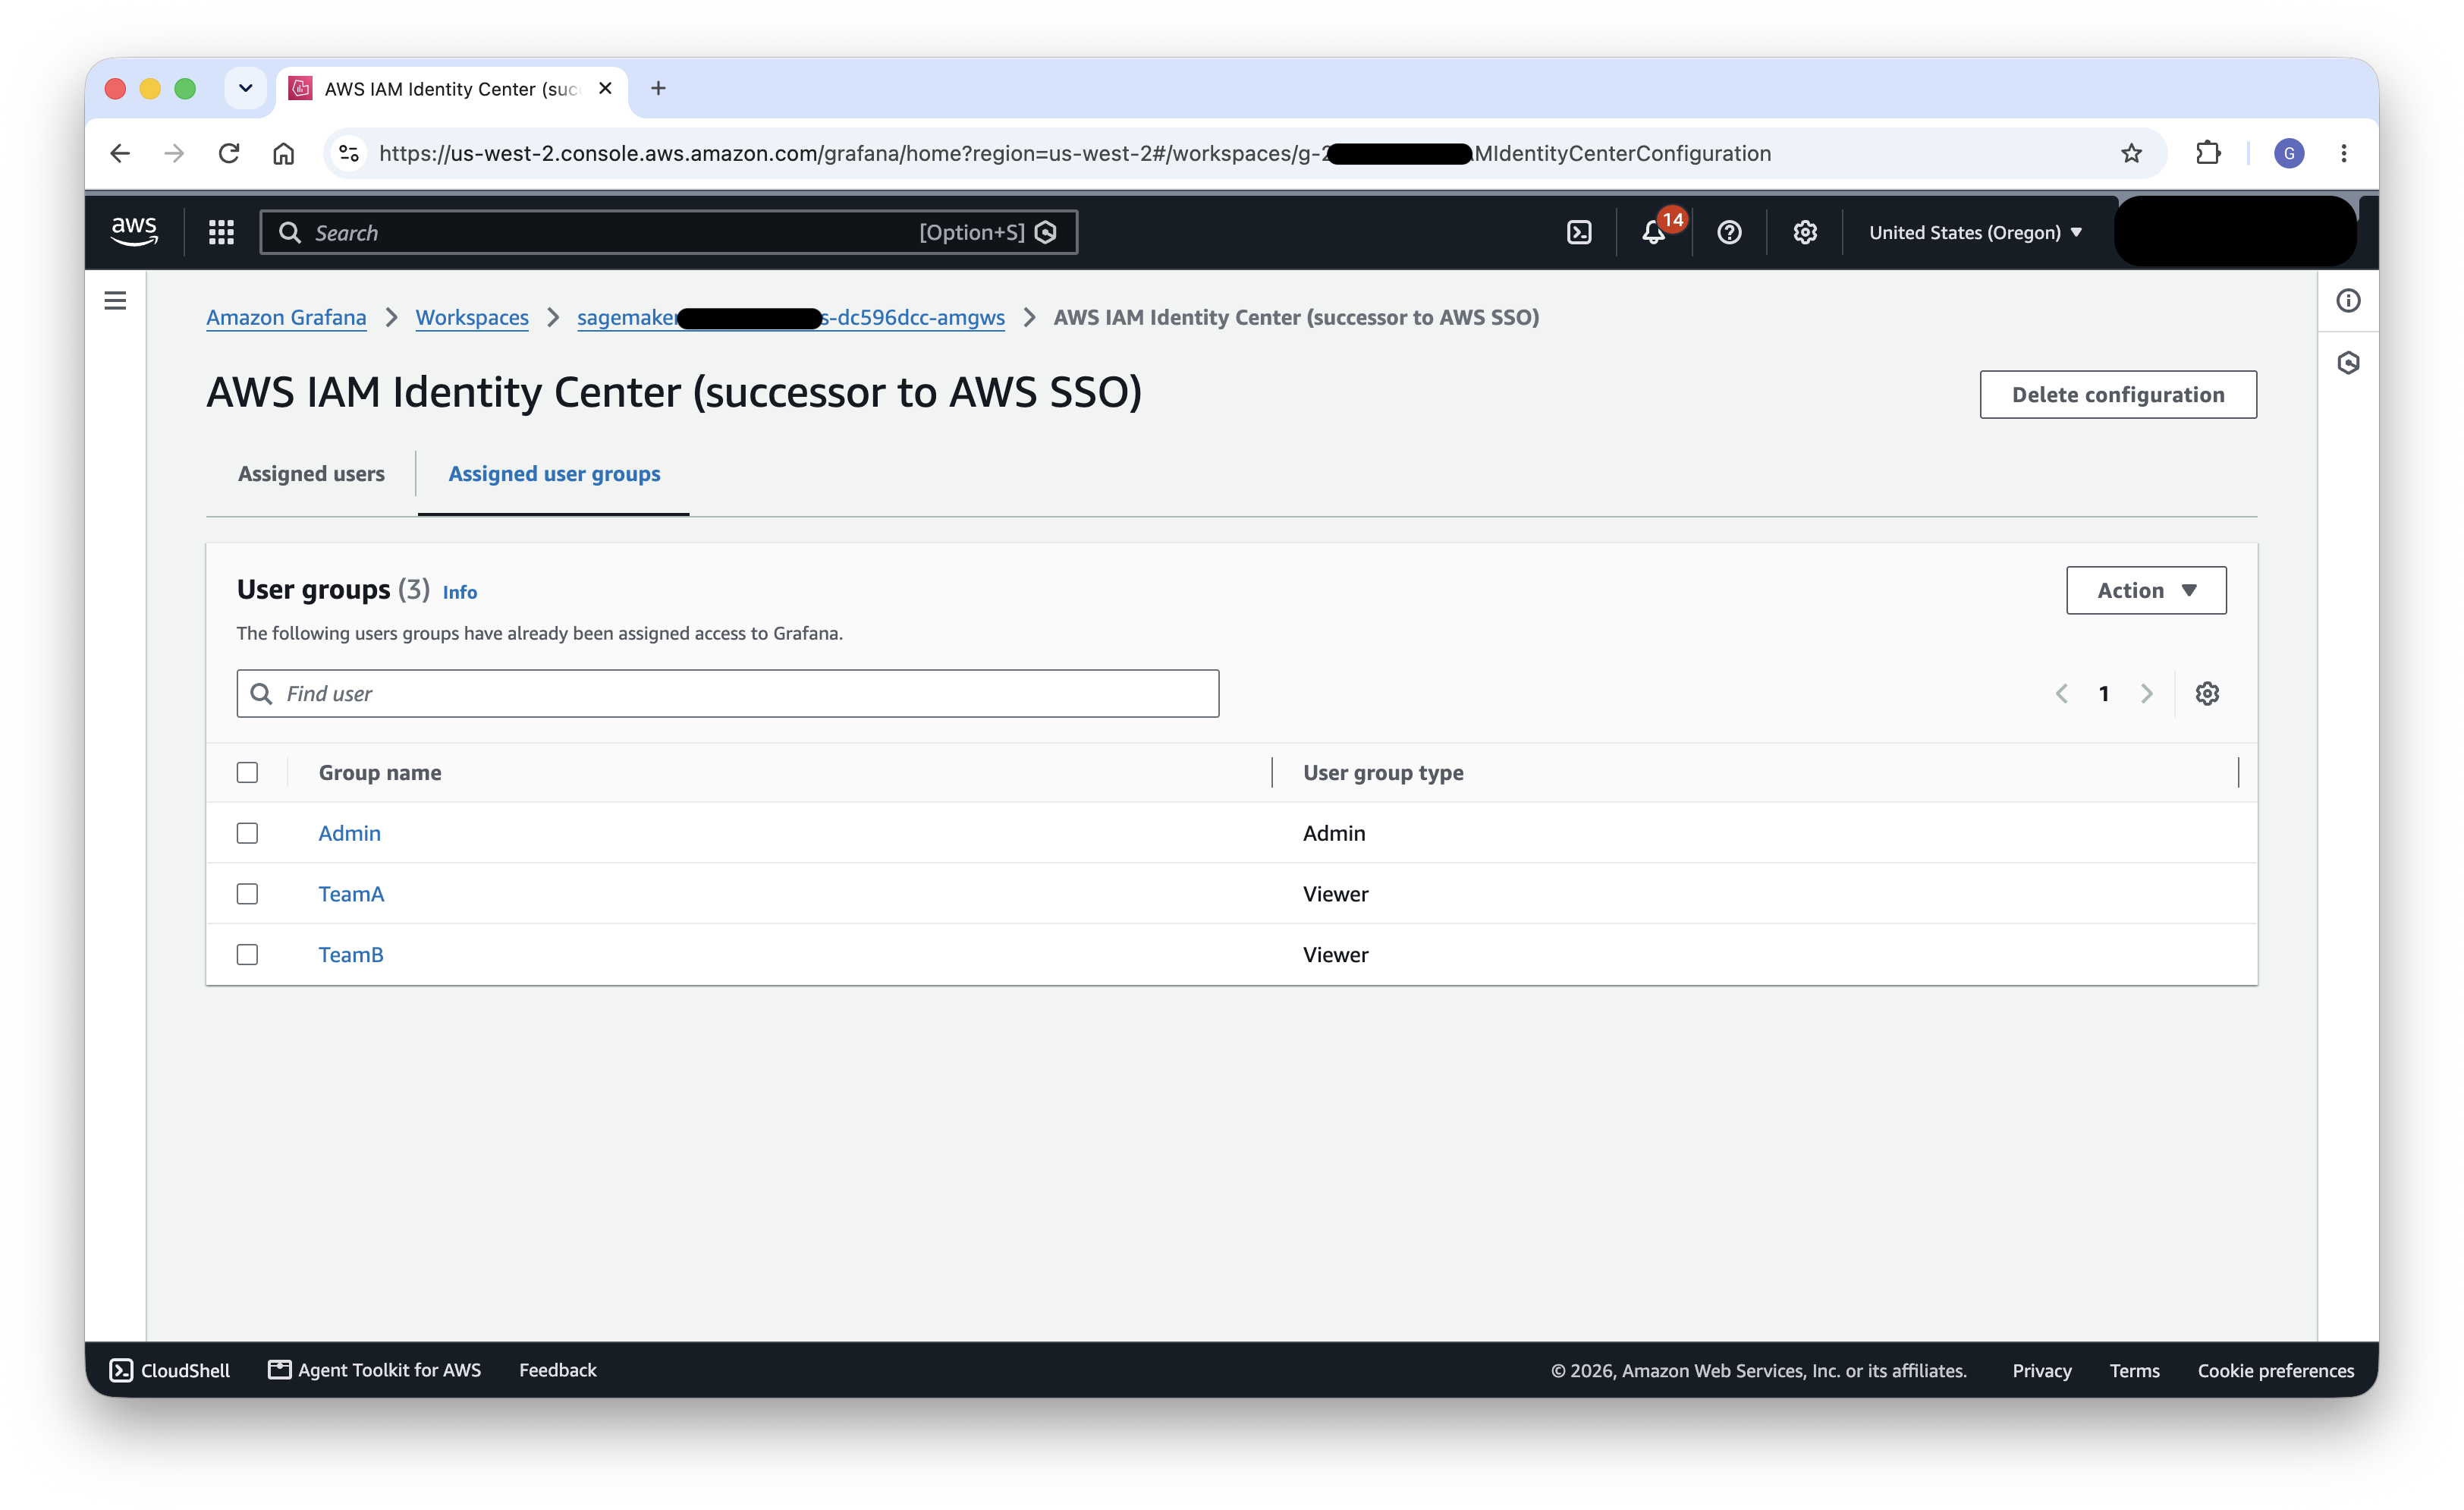
Abbildung 12: Grafana-Rolleingaben, die den Teams nur Leserechte als Zugriffgeber geben
Erfahren Sie mehr: Observabilität für den Amazon SageMaker HyperPod Cluster, der von Amazon EKS gesteuert wird
Kostenzuweisung und Chargeback
In einer Multi-tenant-Umgebung, in der Teams eine kostspielige GPU-Infrastruktur teilen, ist es wichtig zu verstehen, wer was verbraucht – für Rechenschaftspflicht, Budgetplanung und Gebührenabrechnung. Kubecost adressiert diese Anforderung, indem es die Ausgaben innerhalb des Clusters an natürliche Kubernetes-Konzepte (Namespace, Label, Deployment und Service) reduziert und sie auf organisatorische Konzepte wie Team, Projekt oder Umgebung übersetzt.
Da diese Architektur jedes Team bereits in einem speziellen Namensraum isoliert (hyperpod-ns-team-a, hyperpod-ns-team-b) befindet, entspricht die Kostenverteilung auf Ebene des Namensraums direkt den Grenzen der Teams. Dadurch erhalten die Plattformverwalter eine klare Übersicht über die GPU-, CPU-, Speicher-, Speicher- und Netzwerknutzung pro Team, ohne dass zusätzliche Arbeitslasten erforderlich sind. Für detaillierte Anleitungen zur Bereitstellung und Konfiguration von Kubecost auf einem HyperPod-Kluster siehe Kubecost auf SageMaker HyperPod.
Erhöhung der Sichtbarkeit des Teams
Nachdem Kubecost die Daten sammelt, gruppiert das Team den Kostenaufwand nach Namensraum im Allokationspanel, um die Ausgaben pro Team zu sehen. Da jedes Team einen Namensraum besitzt, ergibt sich direkt eine Aufschlüsselung der Kosten pro Team, die Berechnungen für Rechenleistung, Speicher und Netzwerk umfasst. Genau wie bei den Observability-Panelen profitieren die Teams von der Sichtbarkeit ihrer eigenen Kostendaten:
- Weiterende Ansichten zum Namensraum jedes Teams – Kubecost unterstützt die Filterung und das Speichern von Berichten nach Namensraum, sodass jeder Team seine eigene Verwendung und Trends unabhängig von den Daten anderer Teams überprüfen kann.
- Set Budgets und Warnungen – Konfigurieren Sie die Budgetgrenzen und Warnungen für jeden Namespace, sodass Teams und Plattformverwalter informiert werden, wenn der Ausgabeeinfluss die definierten Grenzen erreicht, und somit die gleichen Ressourcengerechtigkeitziele wie HyperPod Task Governance erreicht werden.
- Unterstützung für Chargeback und Showback – Berichte über die Zuweisung auf Namenstufen können die internen Prozesse für Chargeback (Billing-Teams für ihre Nutzung) oder Showback (Berichterstattung über Nutzung ohne Abrechnung) unterstützen. Dadurch erhalten Finanz- und Plattformteams die Daten, die sie benötigen, um die gemeinsamen GPU-Kosten fair zu veranlassen.
Das folgende Bild zeigt den Dashboard für die Kubecost-Allokationen, gruppiert nach Namespace, und zeigt den kumulierten Kostenstand der letzten 7 Tage für das Namespace jedes Teams.
Abbildung 13: Dashboard für Kubecost-Auslastungen nach Namensraum, für die Kosten pro Team
Lernen Sie mehr: Kubecost auf SageMaker HyperPod · Kubecost
Schlussfolgerung
Dieser Artikel beschreibt eine Referenzarchitektur für die Erstellung von Mehrteilnehmerumgebungen auf Amazon SageMaker HyperPod mit EKS. Durch die Kombination von AWS IAM Identity Center für Authentifizierung, IAM-Rollen pro Team für Berechtigungen auf AWS-Ebene, SageMaker AI-Domains für eine individuell angepasste Arbeitsumgebung, Kubernetes-Namen spaces für Arbeitslastenisolierung, HyperPod Task Governance für eine gerechte Ressourcenzuteilung und Kostenallokation auf Namen space-Ebene für die Sichtbarkeit der Ausgaben pro Team können mehrere Teams effizient einen einzigen HyperPod EKS-Kluster teilen.
Dies ist eine flexible, komponierbare Vorgehensweise, die mehrere Bausteine zu einer kohärenten Lösung verbindet. Die Architektur ermöglicht eine Vielzahl von Nutzungsfällen und Organisationsstrukturen. Beispielsweise können Organisationen dieses Muster erweitern, um Teams mit HyperPod Slurm-Clustern neben EKS zu verbinden und eine einheitliche Multi-tenant-Erfahrung über verschiedene Orchestrierungsbackends zu bieten.
Während diese Methode die Zusammenstellung und Konfiguration mehrerer Komponenten erfordert, ergibt sich ein hohes Maß an Kontrolle und Anpassbarkeit, das an die speziellen Isolierungs-, Compliance- und Betriebsanforderungen jeder Organisation angepasst werden kann. Die grundlegenden Muster (Identitätsföderation, Namespace-Isolation, RBAC, Quota-basierte Governance und Kostenvorhaltung) bleiben weiterhin anwendbar.
Um zu beginnen, versuchen Sie, diese mehrteilige Einrichtung selbst auf Ihrem Amazon SageMaker HyperPod EKS-Cluster zu erstellen und die Bausteine an die Isolierung, Governance und Kostenverteilungsanforderungen Ihrer Organisation anzupassen.