
Einen KI-Agenten für eine Demo zu bauen und einen für 40 Millionen Entwickler zu betreiben sind unterschiedliche ingenieurstechnische Probleme. Postman begann mit dem Bau von Agent Mode, einer KI-nativen Arbeitsweise über API-Tests, Dokumentation, Entdeckung und Implementierung hinweg. Das Team erwartete, dass Modellqualität und Prompt-Design die schwierigsten Probleme sein würden. Die tieferen Herausforderungen ergaben sich aus der Integration eines Agenten in ein ausgereiftes Produkt mit jahrelangen interface-getriebenen Annahmen, einer breiten Oberfläche und spezialisierten Konzepten.
In diesem Beitrag beschreiben Postman und AWS die architektonischen Muster, die beim Verständlichmachen eines ausgereiften Produkts für einen KI-Agenten entstanden. Diese Muster umfassen die Kontrolle von Tool-Sprawl, die Bereitstellung schemabasierter Lesezugriffe und die Behandlung von Kontext statt Fähigkeit als den primären Engpass.
Wir erklären auch, wie Agent Mode verwendet Amazon Bedrock für Modellflexibilität, geografisch abgegrenzte regionsübergreifende Inferenz, modellabhängige Null-Daten-Aufbewahrung und mehrstufiges Prompt-Caching. Zusammen können diese Erkenntnisse Teams helfen, Produktionsagenten über Prototypen hinauszubringen.
Warum Postman Agent Mode gebaut hat
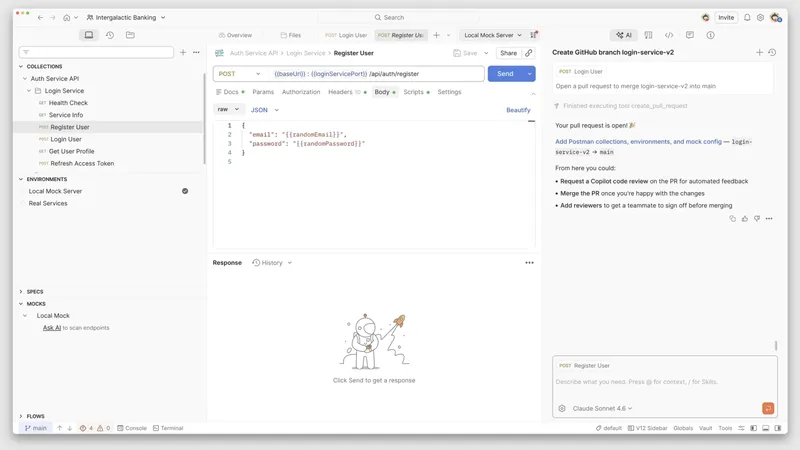
Agent Mode ist Postmans Portal für die Arbeit mit dem Produkt auf KI-native Weise über Tests, Dokumentation, Entdeckung und Implementierung hinweg. Postman hat sich über 11 Jahre entwickelt, und Entwickler und Nutzer lernten, Informationen über die Oberfläche zu finden, indem sie Seitenleisten aufklappten, Registerkarten prüften und Anfragen öffneten. Die Neukonstruktion dieses Bewusstseins für einen Agenten brachte strukturelle Annahmen in den APIs des Produkts, der Benutzererfahrung und der Verteilung des Produktwissens ans Licht. Ein Agent argumentiert über Daten, anstatt durch einen Bildschirm zu navigieren. Abbildung 1 zeigt, wie Agent Mode direkt gegen die Anwendung arbeitet.
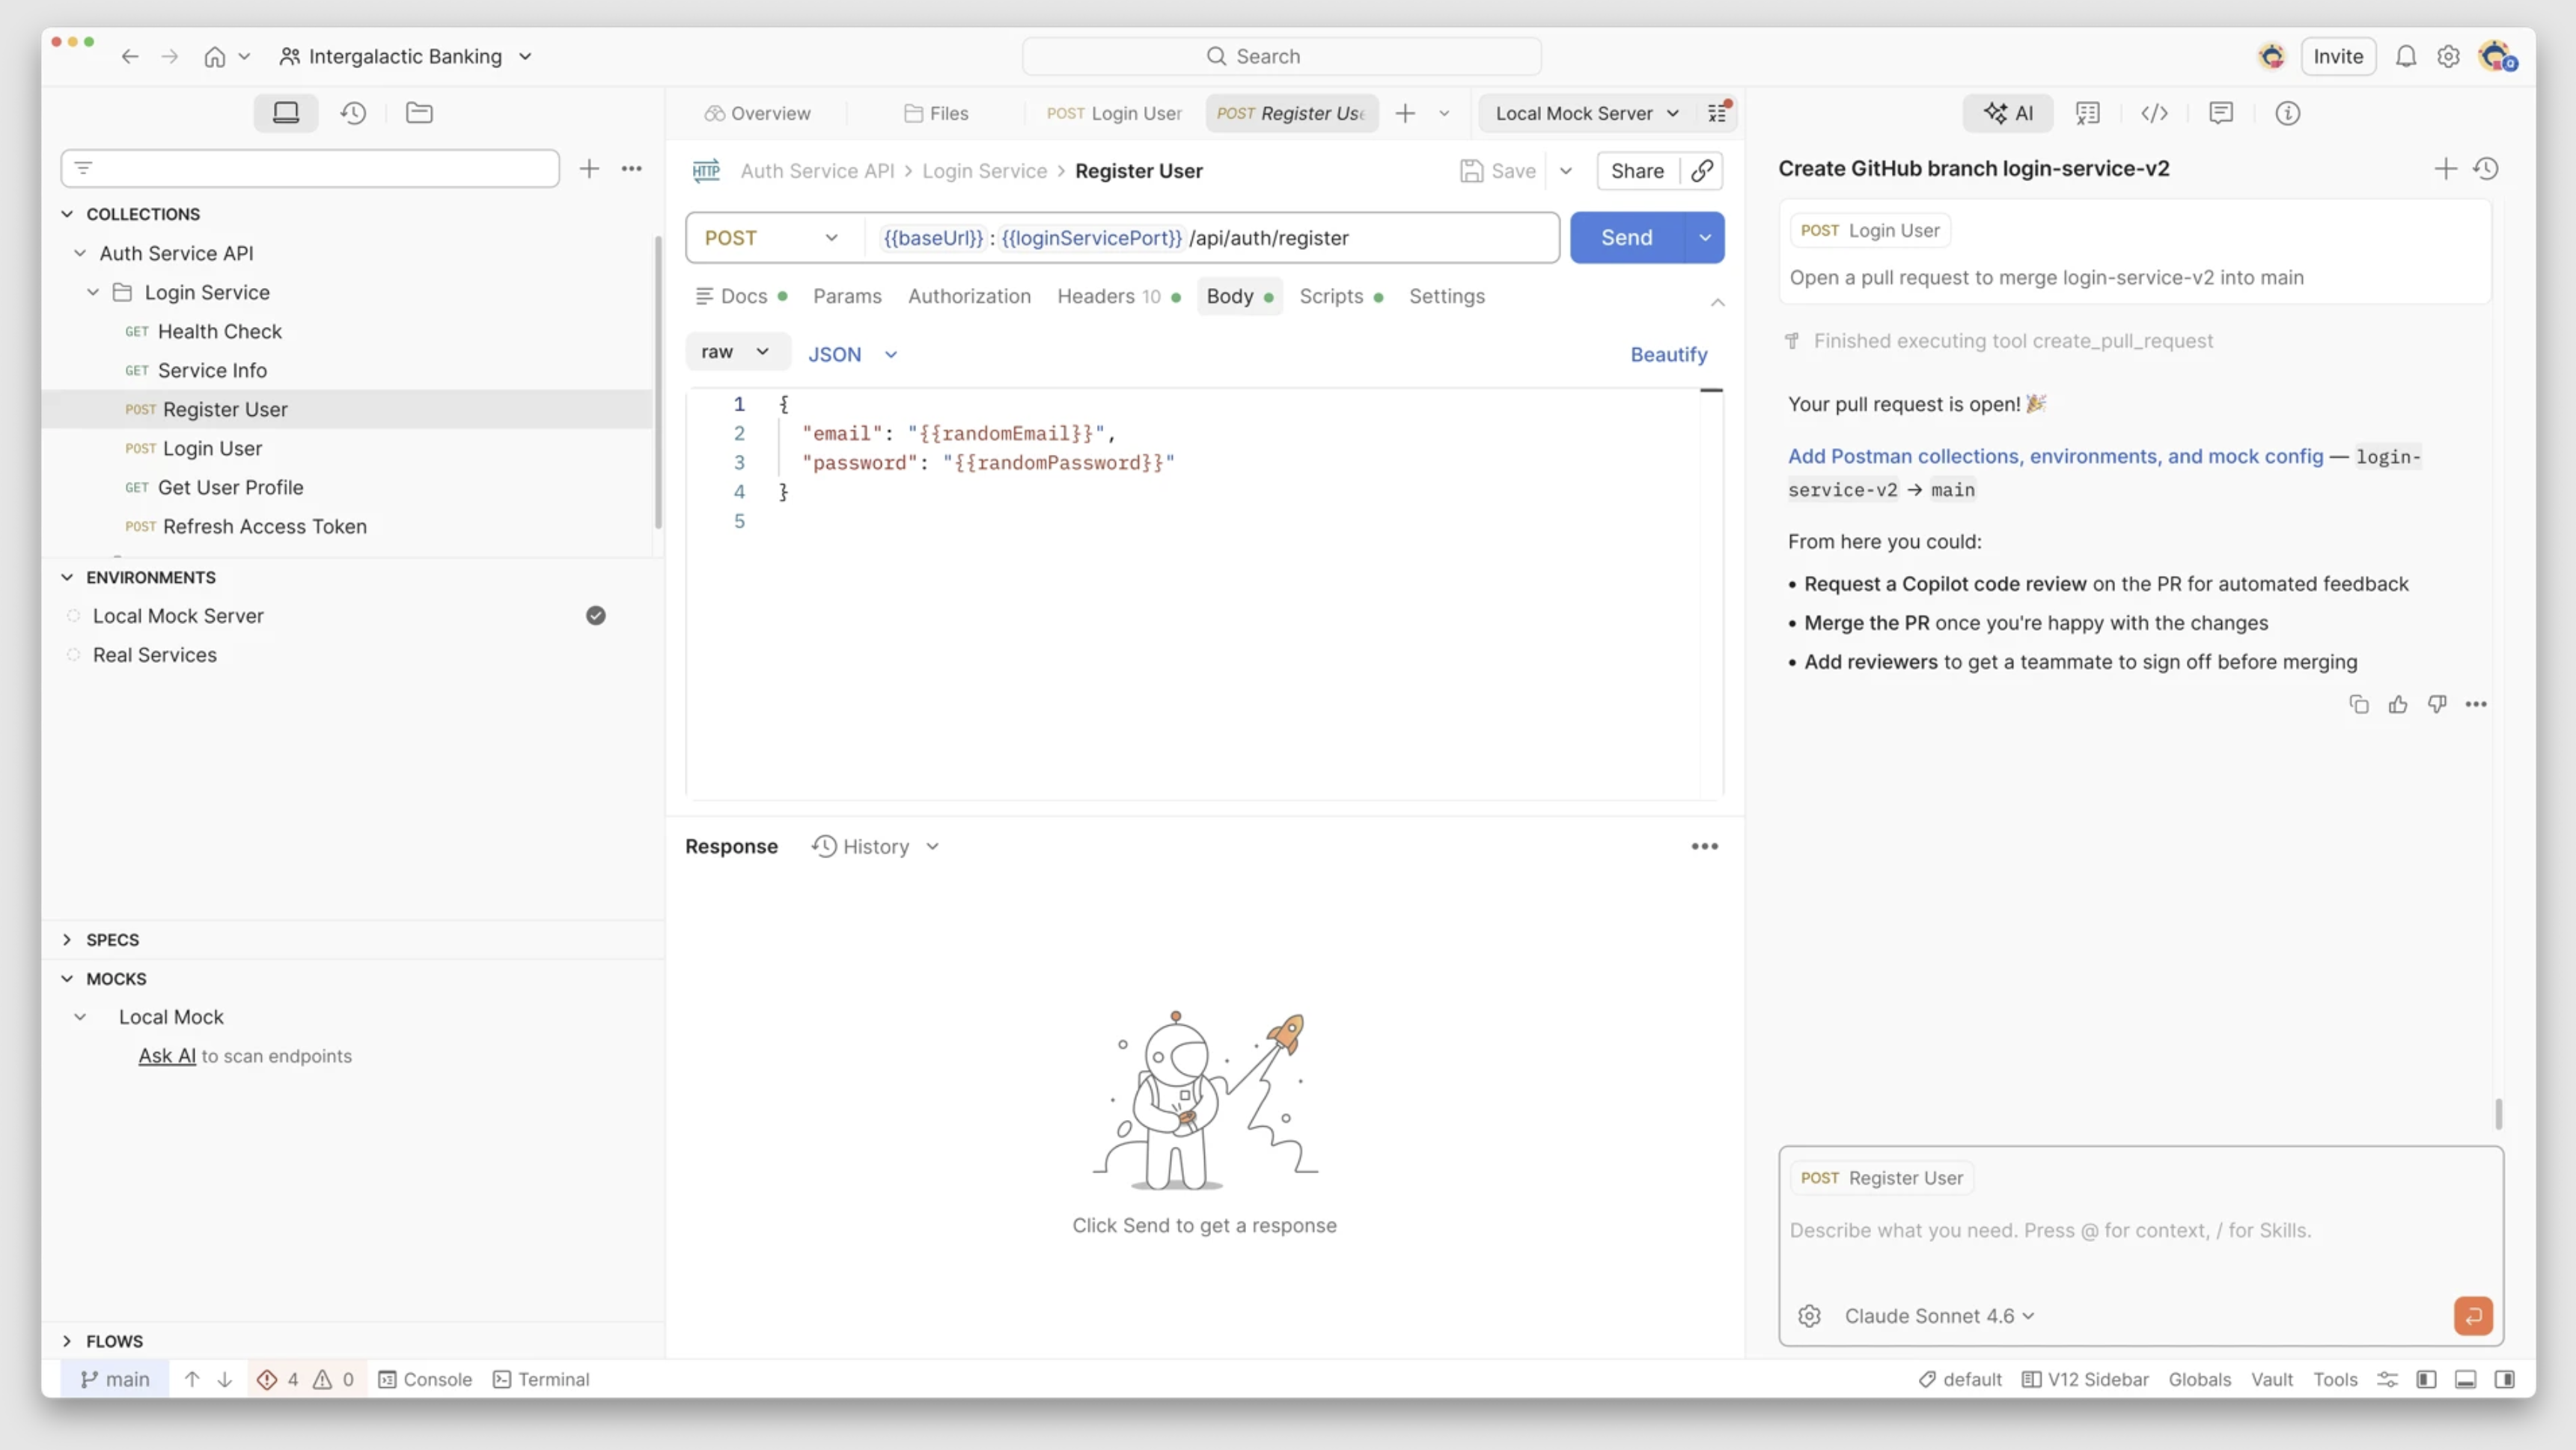
Abbildung 1: Agent Mode arbeitet direkt gegen die Postman-Anwendung. In diesem Beispiel öffnet er einen Pull-Request und schlägt nächste Schritte vor, ohne dass der Benutzer durch die Oberfläche navigieren muss
Agent Mode läuft auf Amazon Bedrock, das verwalteten Zugang zu Foundation Models hinter dem Agenten bereitstellt. Die Unterstützung von Postmans globaler Entwickler-Community erzeugt variable, latenzempfindliche Nachfrage mit scharfen Verkehrsspitzen. Mit Amazon Bedrock kann Postman diese Produktionsworkload skalieren, ohne eine eigene Modell-Serving-Infrastruktur zu betreiben, und behält dabei Flexibilität bei der Modellauswahl sowie Kontrolle über Durchsatz, geografische Verarbeitung und Kosten. Abbildung 2 bietet eine Übersicht der Produktionsarchitektur auf hoher Ebene, bevor die folgenden Abschnitte ihre Komponenten untersuchen.
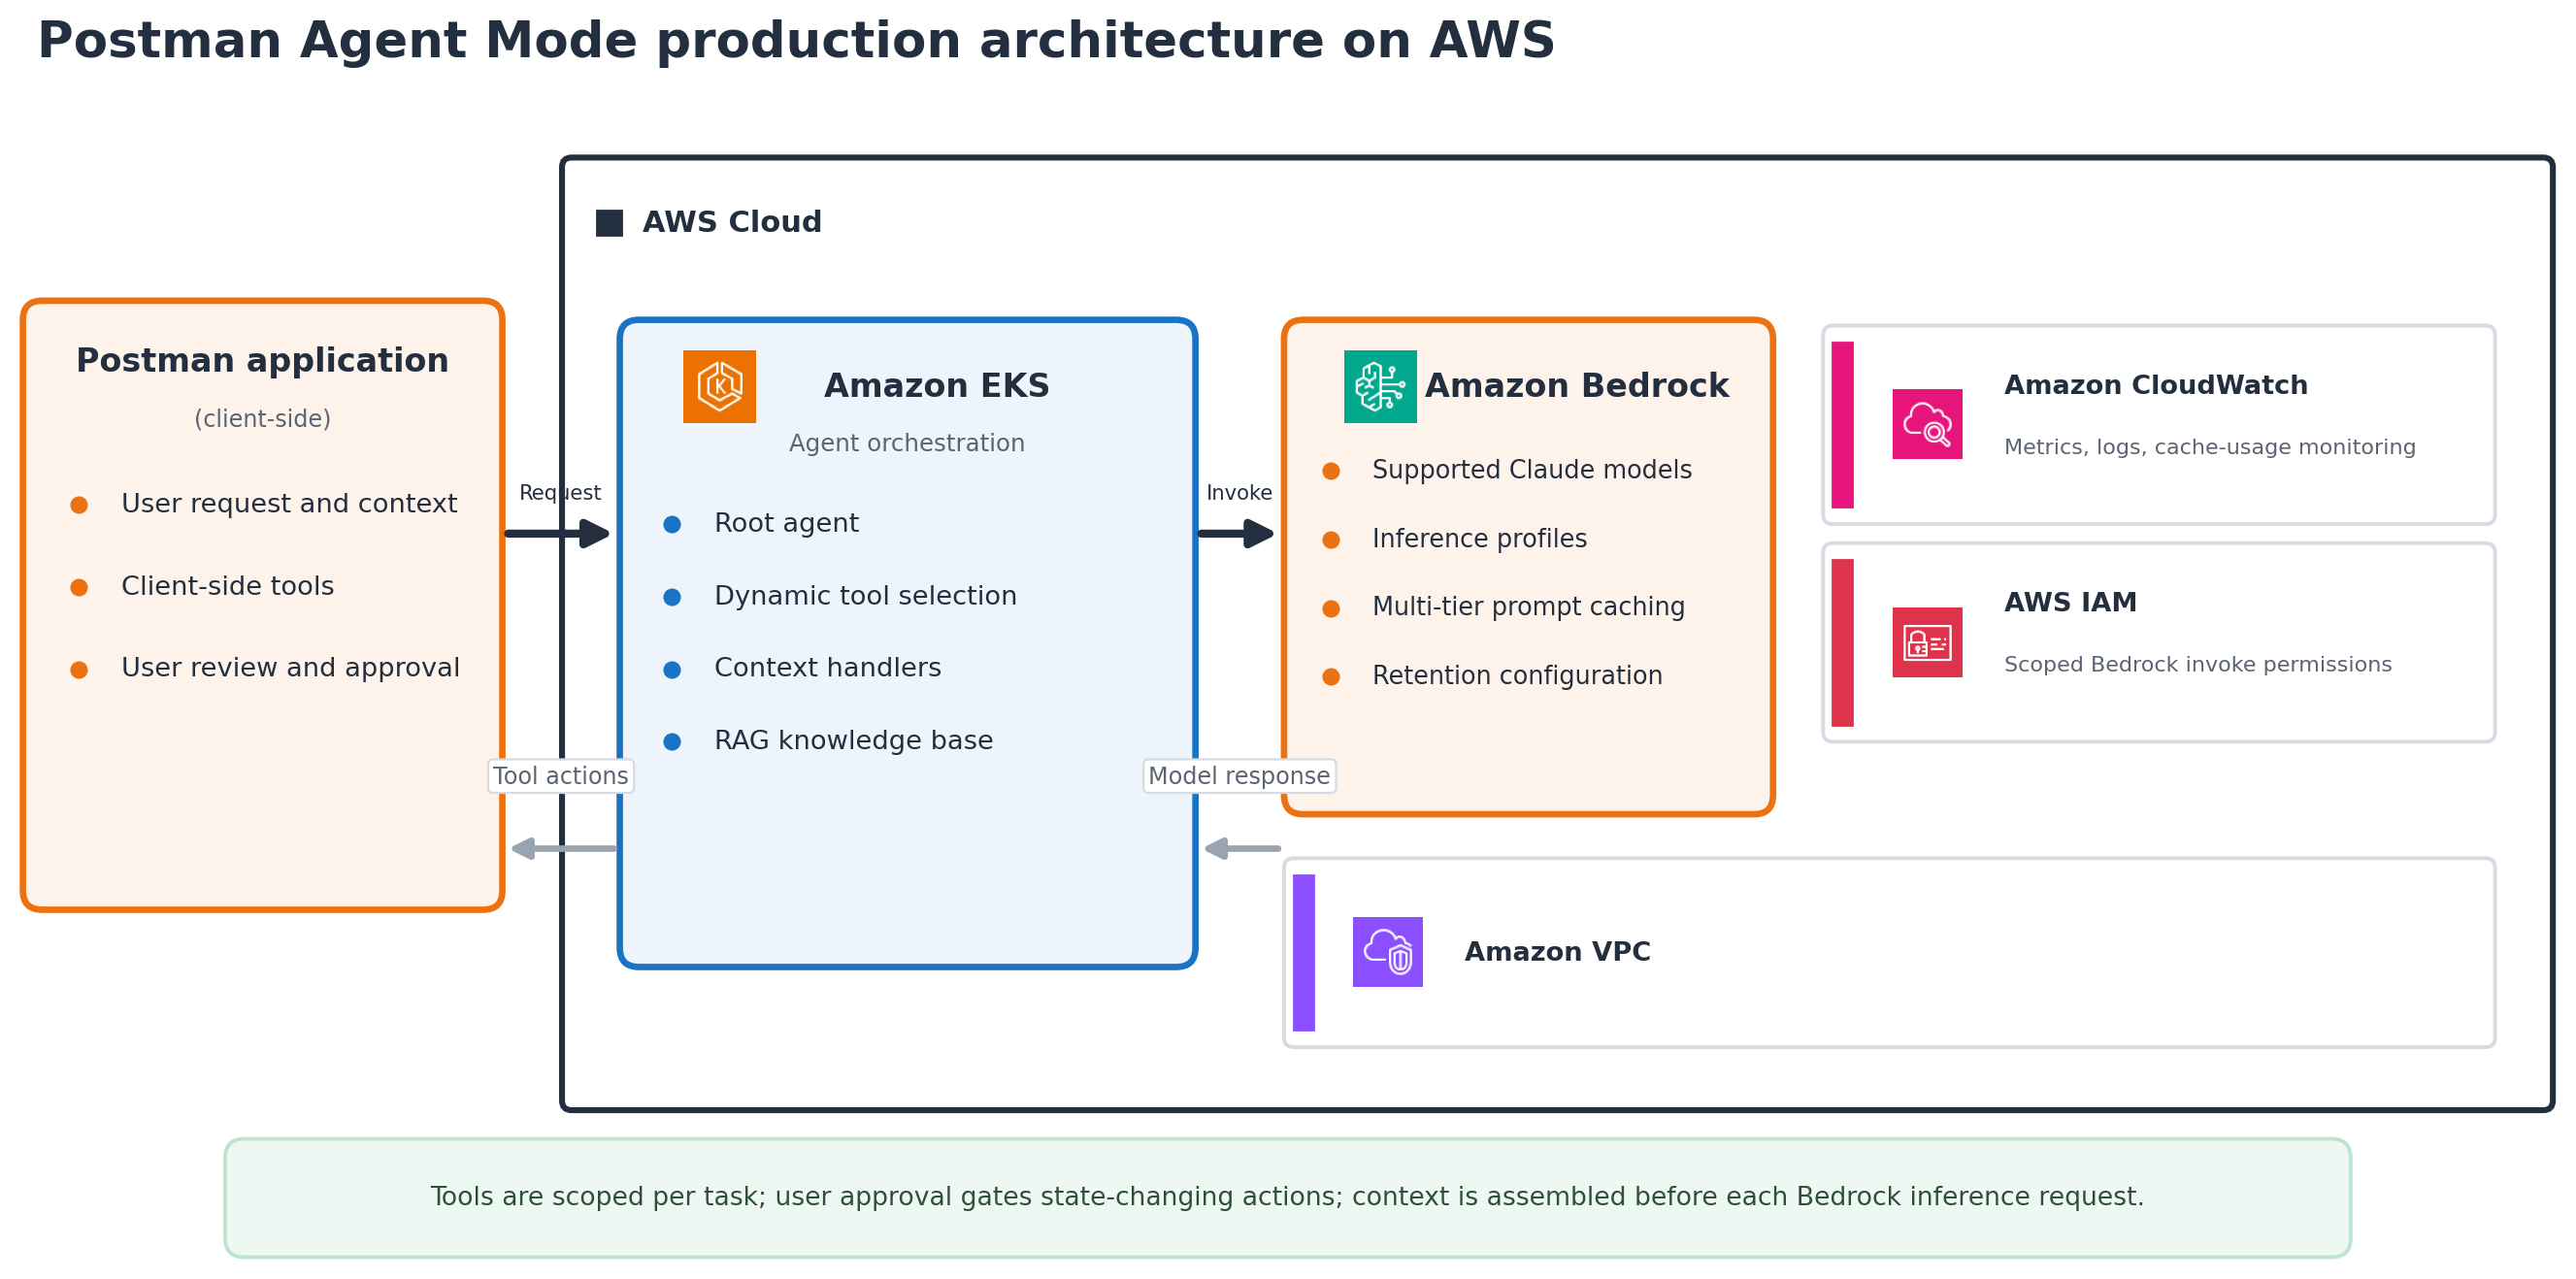
Abbildung 2: Postman Agent Mode kombiniert clientseitige Tools, Agenten-Orchestrierung, speziell erstellten Kontext und Amazon Bedrock-Modellinferenz. Tools sind für jede Aufgabe abgestimmt, und die Benutzerfreigabe bleibt Teil von Aktionen, die den Anwendungszustand ändern
Menschliche Aufsicht ist Teil des Produktionsdesigns. Agent Mode erfordert die Freigabe durch den Benutzer vor Aktionen, die den Anwendungszustand ändern. Postman beschränkt außerdem die verfügbaren Tools auf die Aufgabe, wählt speziell erstellten Kontext aus und wendet modellabhängige Datenaufbewahrungseinstellungen an. Diese Kontrollen reduzieren unbeabsichtigte Aktionen und unnötige Datenexposition, während Produktionstests und Überwachung weiterhin notwendig bleiben. Als verantwortungsvolle KI-Kontrolle verwendet Postman Amazon Bedrock Guardrails um personenbezogene Daten (PII) zu schwärzen, bevor sie das zugrunde liegende Large Language Model (LLM) erreichen. Unternehmensadministratoren können dies in den Guardrail-Einstellungen von Agent Mode aktivieren.
Umgang mit Tool-Sprawl
In Agent Mode definieren Tools, wie der Agent innerhalb von Postman handelt. Anfangs neigte das Team zu hochatomaren Tools: kleine, präzise Aktionen wie das Öffnen einer Anfrage, das Aktualisieren eines Feldes oder das Abrufen eines bestimmten Metadatums. Dieser Ansatz unterstützte Korrektheit und Kontrolle in frühen Iterationen, offenbarte aber auch mehrere Probleme.
Viele reale Workflows erfordern lange Sequenzen von Tool-Aufrufen. Selbst wenn jeder Schritt schnell war, wirkte die gesamte Erfahrung langsam, weil jede Aktion zum Modell zurückkehren musste, bevor die nächste beginnen konnte. Benutzer sahen zu, wie der Agent Aktionen durchlief, die sie geistig als einen einzigen Vorgang gruppiert hatten.
In Postmans Tests stiegen die Fehler bei der Toolauswahl an, sobald das sichtbare Toolset etwa 40 Tools überschritt. Der Agent konnte nicht existierende Tools aufrufen, trotz gültiger Schemas falsche Argumente übergeben oder Tools auswählen, die semantisch plausibel erschienen, im Kontext aber falsch waren. Größere oder neuere Modelle verringerten dieses Verhalten, schafften es aber nicht ab.
Ab einer bestimmten Toolset-Größe kann das Bereitstellen weiterer Tools die Wirksamkeit des Agents verringern. Die aktuelle Architektur wählt Tools bedarfs- und kontextbasiert aus und isoliert einzelne Ausführungsthreads. Das Modell sieht nur die Tools, die für die aktuelle Aufgabe relevant sind. Abbildung 3 veranschaulicht diesen dynamischen Auswahlprozess.
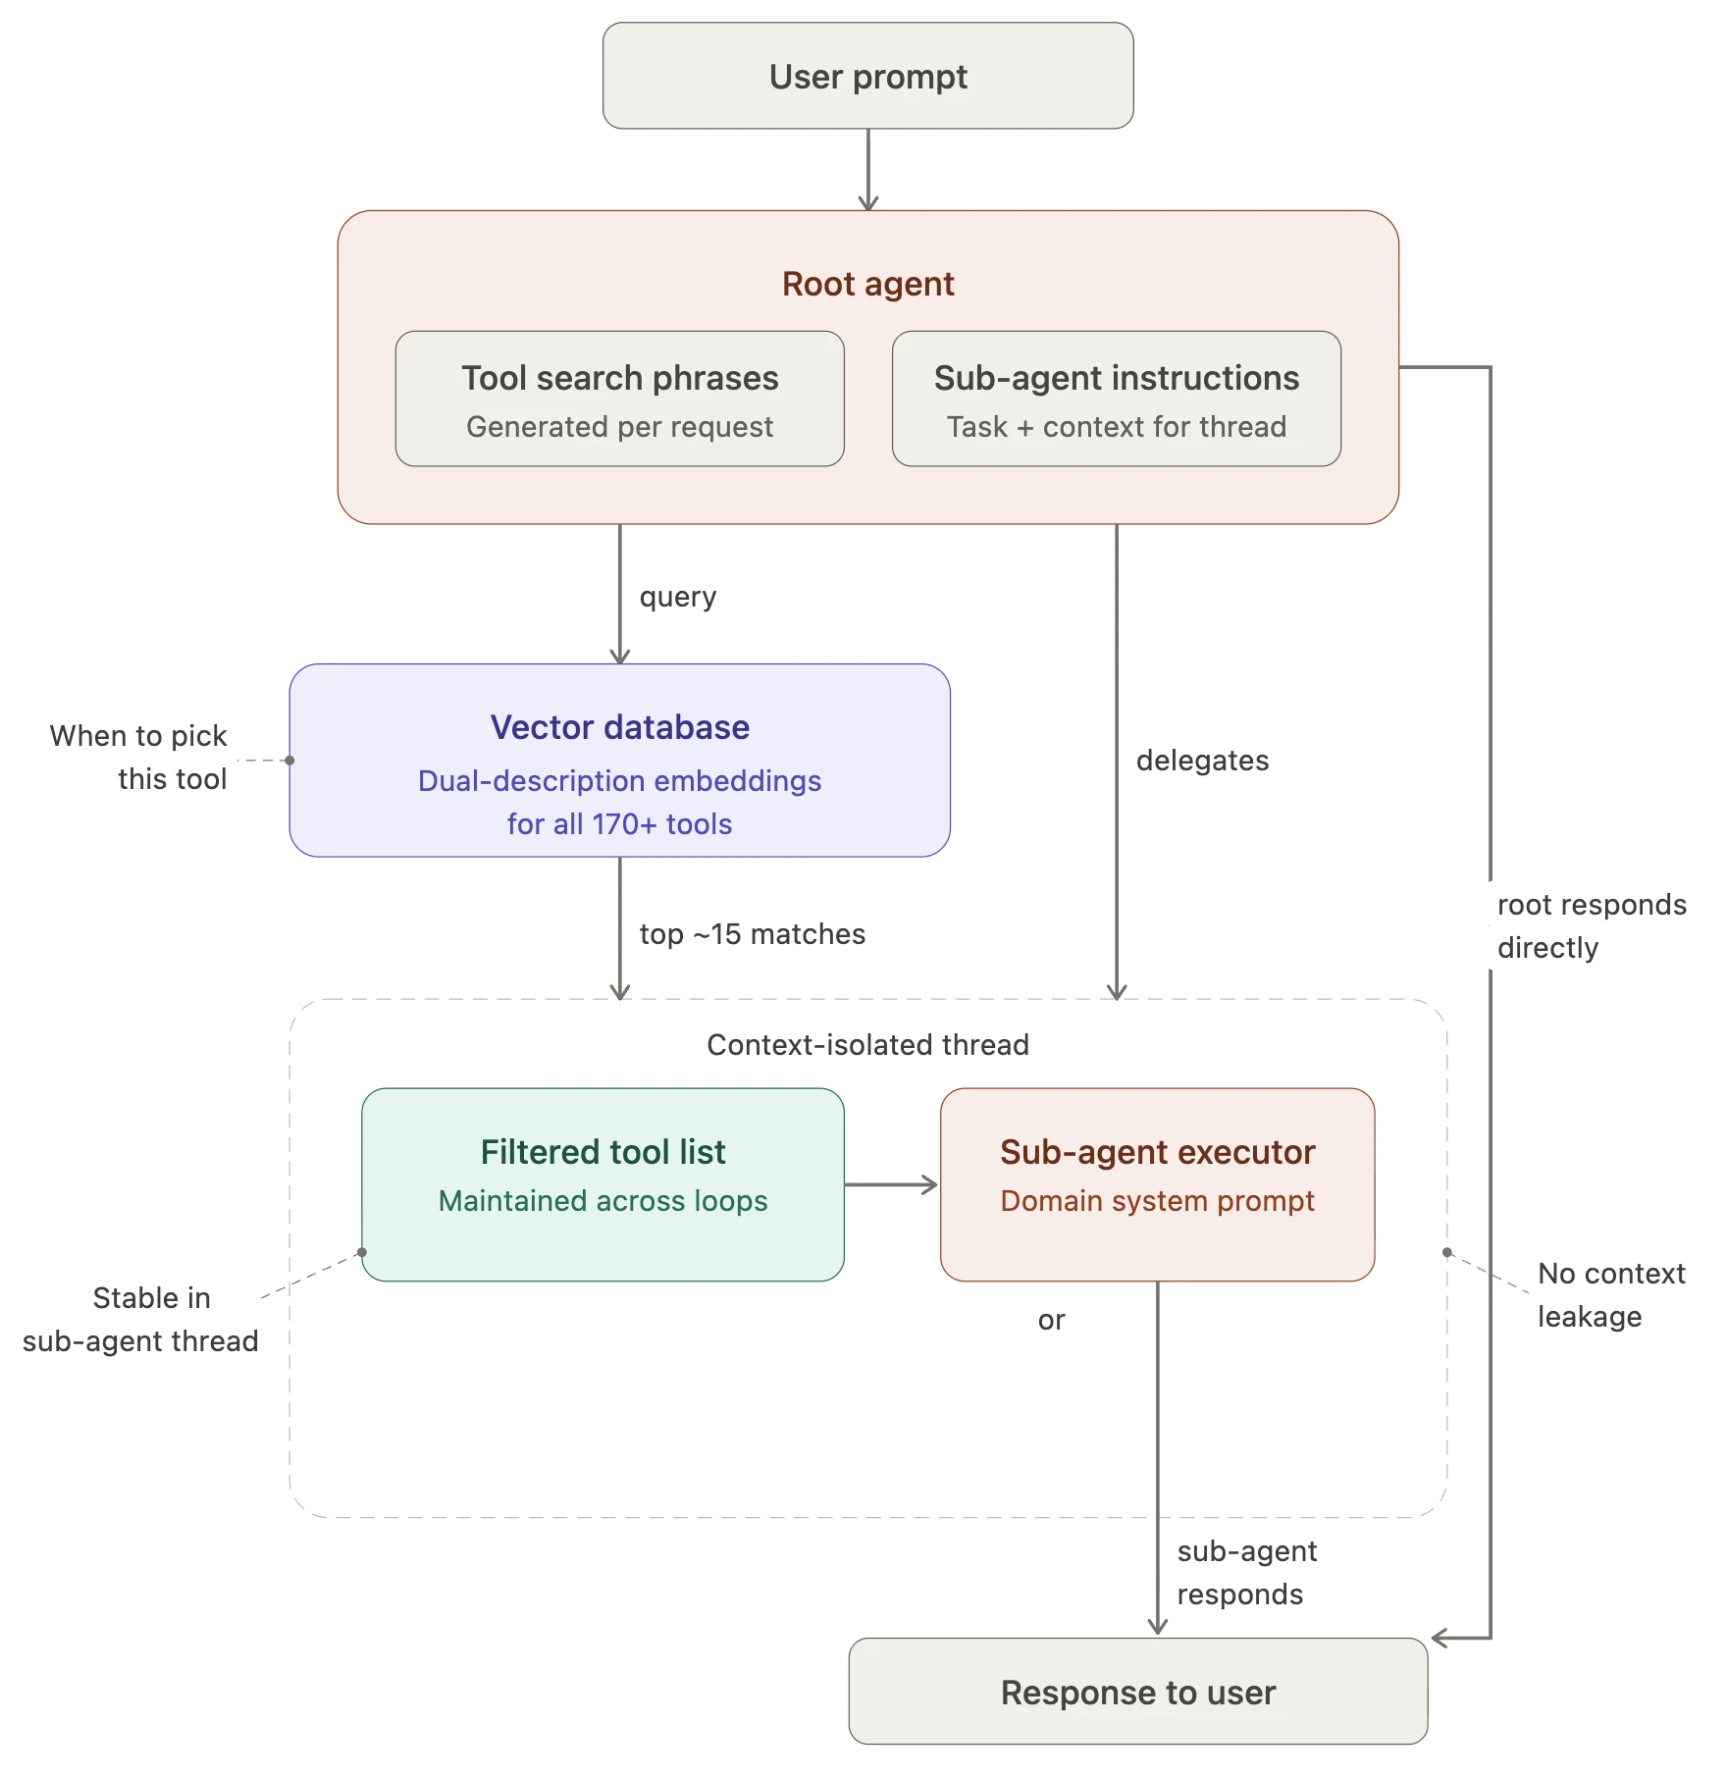
Abbildung 3: Der Root-Agent fragt eine Vektordatenbank mit Tool-Embeddings ab und verengt mehr als 170 Tools auf etwa 15, die für die Anfrage relevant sind. Anschließend übergibt er diese Tools einem kontextisolierten Sub-Agenten, sodass das Modell nur die für die Aufgabe benötigten Tools sieht
Ein subtileres Problem war, dass viele Client-APIs implizit an den Schnittstellenzustand gekoppelt waren. Tools, die Anfragen änderten, benötigten bestimmte geöffnete Elemente, während andere Tools als Nebeneffekt neue Tabs öffneten. Der Agent musste einen Anfrage-Tab öffnen, um sie zu lesen, und Schnittstelleninteraktionen nachahmen, statt über Daten nachzudenken. Postman entkoppelt Tools aktiv von Tabs, und die Funktion Native Git nutzt diesen Ansatz umfangreich. So kann der Agent Mode Anfragen jetzt im Hintergrund senden, ohne dass ein Tab geöffnet sein muss, obwohl weiterhin eine Nutzerfreigabe erforderlich ist.
Fazit für Entwickler: Behandeln Sie Ihren Tool-Katalog als Teil des Kontextbudgets. Begrenzen Sie den Umfang der dem Modell pro Aufgabe bereitgestellten Tools dynamisch, und entkoppeln Sie „was der Agent tun kann“ von „was die UI gerade geöffnet hat“.
Bereitstellung schemabasierter Lesezugriffe
Für Produkte wie den API Catalog hat Postman mehrere schmale Sichten zu einem einzigen Abfrage-Tool zusammengefasst. Diese Produkte legen strukturierte Daten wie Dienstverfügbarkeit, Testergebnisse und Endpunkt-Antwortzeiten über viele Dienste hinweg offen.
Angesichts der Schemas der zugrunde liegenden ClickHouse-Tabellen kann der Agent komplexe Abfragen mit Joins und WHERE-Klauseln generieren. Dies reduziert die Anzahl der unterschiedlichen Tools, die zur Beantwortung einer Analysefrage benötigt werden, erheblich:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;
Mit diesem Ansatz verlagert sich die Aufgabe der Entwickler von einem Tool pro Frage zu einer einmaligen, guten Modellierung der Daten. Der Agent kann dann eine weit größere Vielfalt an Abfragen generieren, als das Team jemals als einzelne Tools hätte aufzählen können.
Fazit für Entwickler: Wo gut strukturierte Daten vorliegen, geben Sie dem Agenten schema-bewussten Lesezugriff auf eine Abfrage-Engine, anstatt eine Vielzahl einzweckgebundener Lesertools bereitzustellen. Sie tauschen Tool-Anzahl gegen Datenmodellierung, was eine bessere Skalierungskurve ergibt.
Der Kontext war der eigentliche Engpass
Postman ging zunächst davon aus, dass fehlende Tools das größte Hindernis wären. In der Praxis verursachten fehlender oder unvollständiger Kontext mehr Fehler als fehlende Fähigkeiten.
Kontext ist das Verständnis des Agents darüber, wo sich der Nutzer in Postman befindet, welche Entitäten aktiv sind und welcher Zustand bereits hergestellt wurde. Wenn dieser Kontext falsch oder abwesend war, wurden selbst korrekte Tools wirkungslos. Abbildung 4 unterscheidet die beiden Formen von Kontext, die dem Agenten bereitgestellt werden.
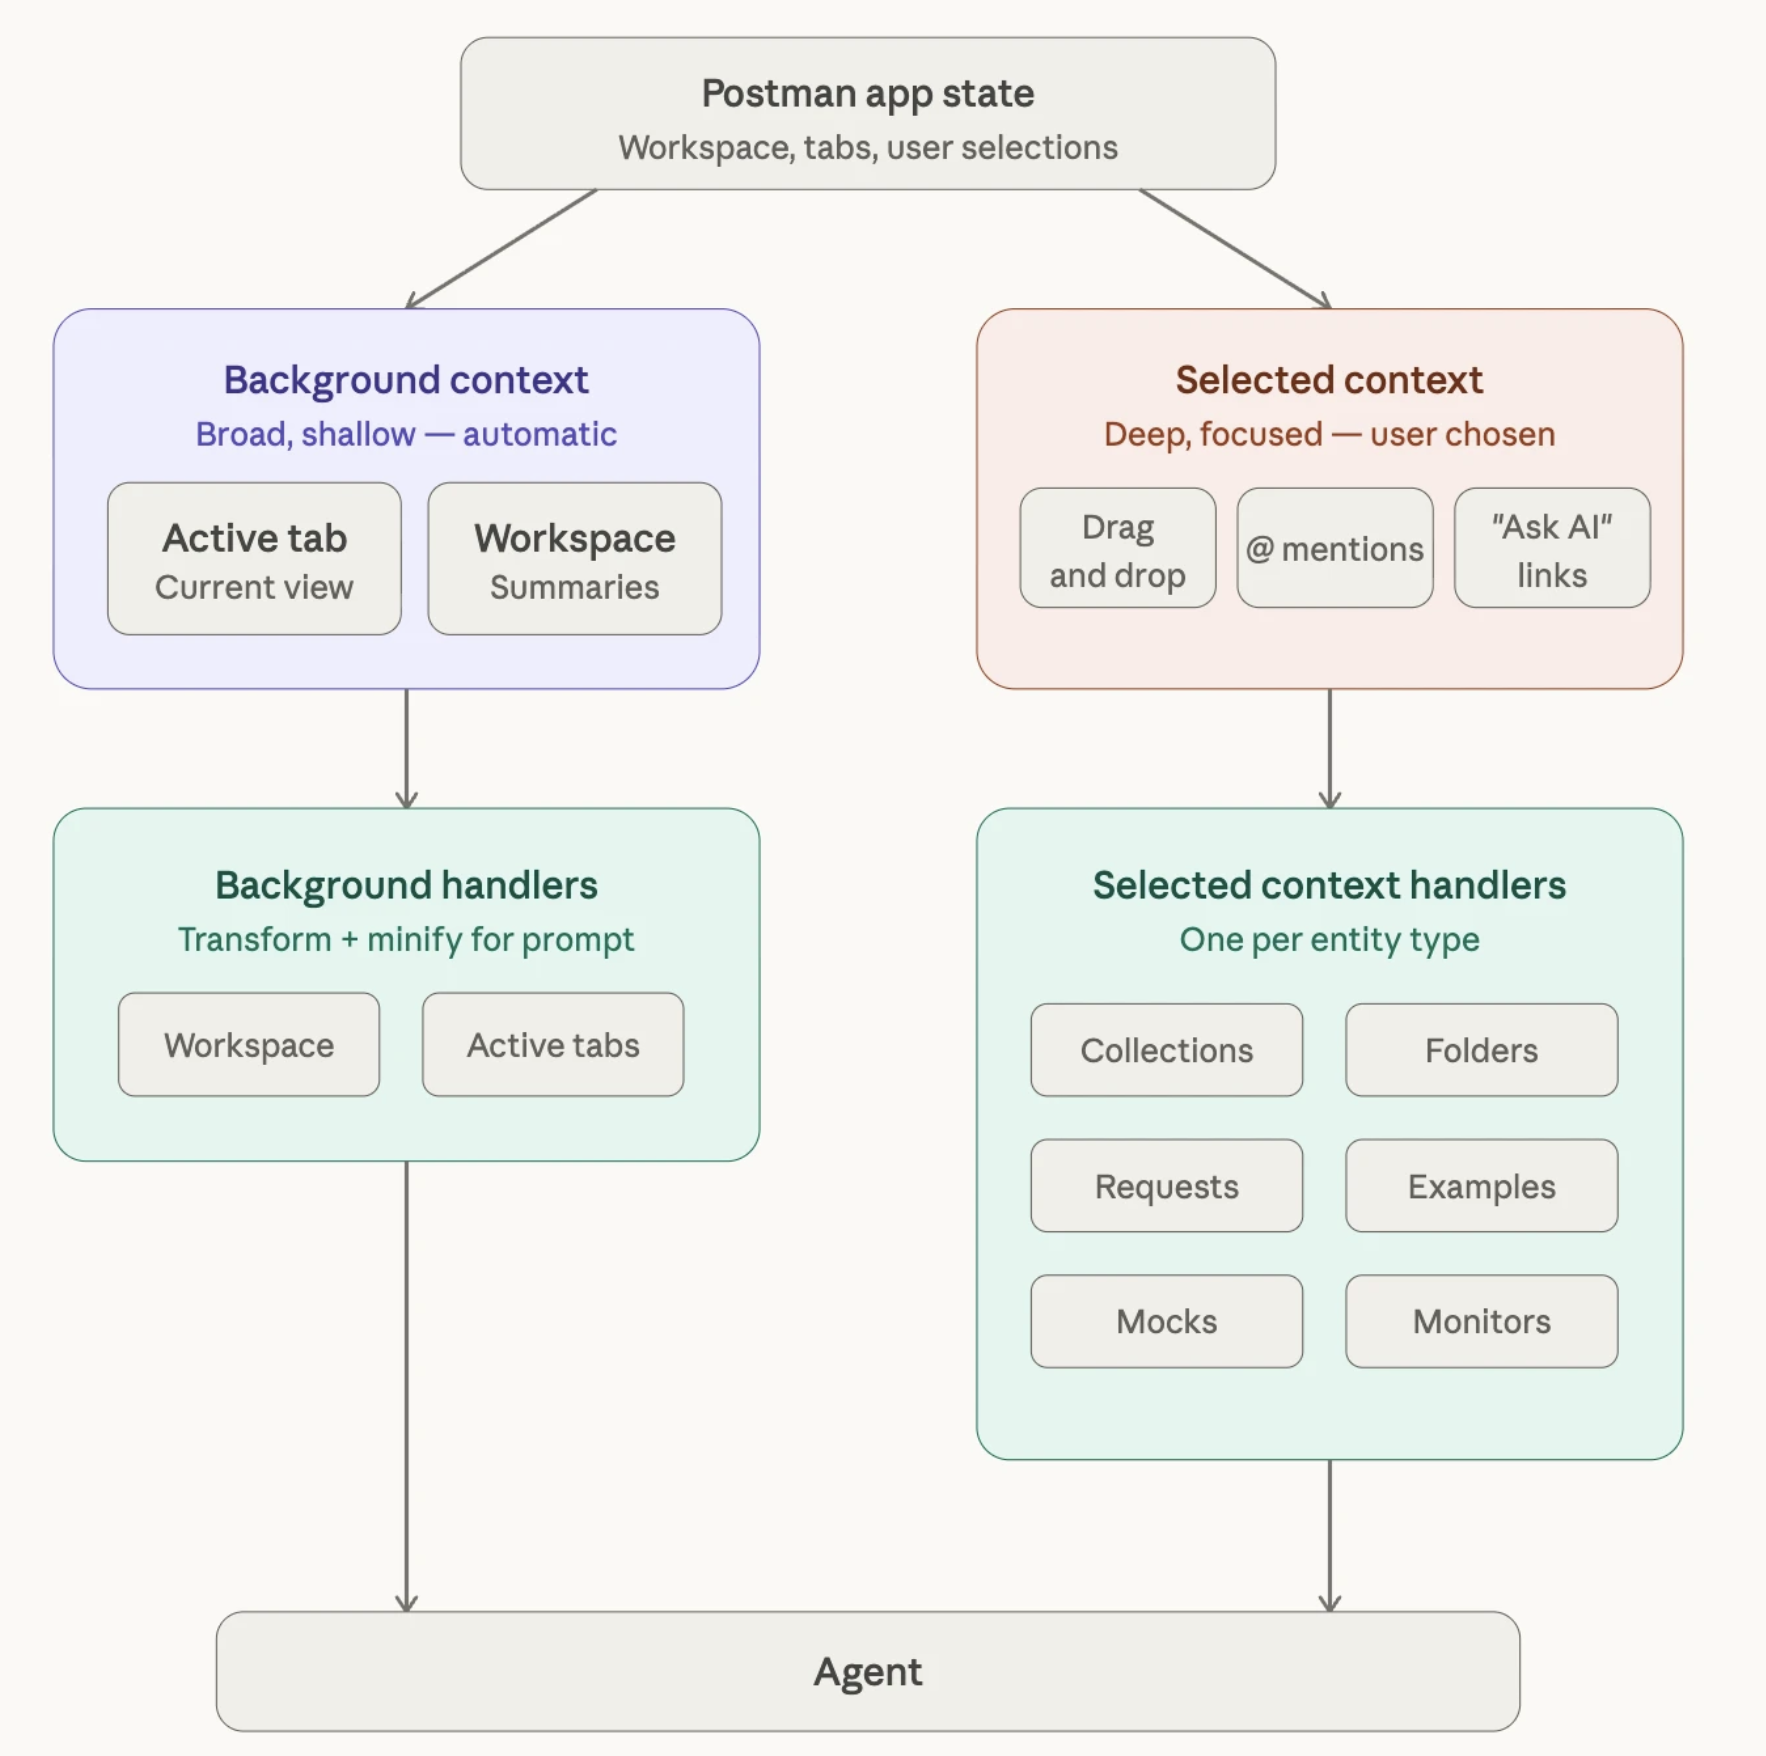
Abbildung 4: Zwei Arten von Kontext speisen den Agenten. Breiter, oberflächlicher Hintergrundkontext wird automatisch erfasst und für den Prompt verkleinert. Tiefgehender, fokussierter ausgewählter Kontext wird vom Nutzer gewählt und über einen dedizierten Handler für jeden Entitätstyp geleitet. Jeder Handler destilliert die Entität in die Informationen, die der Agent benötigt
Die Herausforderung war struktureller Natur. Über 11 Jahre hinweg lernten Entwickler und Nutzer, Informationen über die Schnittstelle zu finden. Diese Bewusstheit für einen Agenten neu zu gestalten erforderte mehrere Iterationen, um zu bestimmen, was für jeden Workflow wichtig war und was Rauschen war. Die Serialisierung des bestehenden Schnittstellen-Datenmodells ergab keinen nützlichen Kontext, da diese Objekte für Rendering und Datenübertragung geformt waren, nicht für Schlussfolgerungen. Postman baute daher dedizierte Kontext-Handler, die jede Entität in das destillierten, was der Agent wissen musste.
Als mehr Objekte Handler erhielten, wurde Truncation das nächste Problem. Viele Felder enthalten offene, nutzergenerierte Daten, darunter Anfragebeschreibungen, OpenAPI-Spezifikationen und Request-Payloads. Diese Daten können das Kontextfenster überfüllen. Eine sorgfältige Verwaltung des Kontextbudgets ist im großen Maßstab unerlässlich und unterstützt den dateisystembasierten Ansatz, den das Team untersucht, bei dem jeder Handler keine eigene Truncation- und Expansion-Logik benötigt.
Fazit für Entwickler: Füttern Sie das Modell nicht mit Ihrem Rendering-Datenmodell. Bauen Sie zweckgerichtete Kontext-Handler und behandeln Sie das Kontextfenster als knapes, aktiv verwaltetes Budget. Rauschen verdrängt das Signal lange bevor das Modell seine Grenze erreicht.
Das alles zusammenbringen
Als der Agent Mode weiterentwickelt wurde, wurde klar, dass das System drei unterschiedliche Komponenten zusammenführen musste, von denen jede ein anderes Problem löst.
- Clientseitige Tools leben in der Postman-Anwendung und repräsentieren die letzten Aktionen, die der Agent ausführen kann, wie das Öffnen von Anfragen, das Ändern von Einstellungen, das Ausführen von Collections und das Inspizieren von Authentifizierung. Agent Mode nutzt auch serverseitige Tools für Funktionen wie Websuche und Agent-Loop-Management, aber die meisten Tools arbeiten auf der Postman-Anwendung.
- Generische Agent-Anweisungen definieren das Verhalten auf Systemebene, einschließlich davon, wie proaktiv Agent Mode sein sollte, wie er Unsicherheit kommuniziert und welches Grundlagen-Produktwissen er mitbringt.
- Eine Wissensbasis verwendet einen Retrieval Augmented Generation (RAG)-Ansatz. Postman hat eine große Produktoberfläche, die mehrere Anfrageprotokolle, Mock-Server, Monitore, Dokumentation, das API Network, Workspace-Governance, Variablen, Helpers, Codegenerierung, Anfrageeinstellungen und Collection-Läufe umfasst.
All dies in statischen Prompts zu hinterlegen war nicht machbar, und das meiste davon ist für eine bestimmte Abfrage irrelevant. Für die anfängliche Befüllung nutzte das Team Postmans Learning Center, um prägnante, funktionsbezogene Artikel zu erstellen. Zur Laufzeit wählt der Agent Mode Wissensartikel anhand der eingehenden Abfrage und des verfügbaren Kontexts aus. Wenn ein Benutzer beispielsweise einen Mock-Server auswählt, injiziert der Agent Mode den zugehörigen Artikel automatisch. So bleibt der Agent standardmäßig schlank und bietet bei Bedarf Tiefe. Die Wissensbasis entwickelt sich mit der Anwendung weiter, sodass Teams die Agent-Mode-Dokumentation zusammen mit neuen Features ausliefern können.
Agent Mode auf Amazon Bedrock ausführen
Die drei zuvor beschriebenen Komponenten laufen auf dieselbe Laufzeitaktion hinaus: einen Inferenzaufruf an ein Foundation Model (FM). Im Umfang von Postman ist der Datenverkehr burstartig und entwicklergetrieben. Routing-, Caching- und geografische Verarbeitungssteuerungen helfen Postman, Verkehrsspitzen zu bewältigen, Inferenzkosten zu managen und workloadspezifische Verarbeitungsanforderungen zu erfüllen. Amazon Bedrock bietet vier Fähigkeiten, die hier am wichtigsten sind.
Modellflexibilität innerhalb der Claude-Familie
Der Agent-Modus ist nicht an ein einzelnes Modell gebunden. Durch Amazon Bedrock-Modell-Inferenz-APIs, kann Postman auf unterstützte Anthropic-Claude-Modelle zugreifen und jede Workload an ein geeignetes Modell weiterleiten. Ein schnelleres Modell kann interaktionen mit hohem Volumen und Latenzempfindlichkeit bedienen, während ein größeres Modell komplexe Schlussfolgerungen verarbeiten kann, bei denen Qualität wichtiger ist als Kosten. Der Wechsel zwischen unterstützten Claude-Modellen ist in erster Linie eine Konfigurationsänderung und keine neue Integration. Diese Flexibilität unterstützt direkt die zuvor beschriebenen Herausforderungen durch Tool-Vielfalt und Kontext. In Postmans Tests reduzierten neuere und größere Modelle Tool-Halluzinationen, und Postman kann unterstützte Modelle übernehmen, ohne die Integration neu aufzubauen. Siehe unterstützte Modelle nach AWS-Region in Amazon Bedrock.
Cross-Region-Inferenz für hohen Durchsatz
Der Entwicklerverkehr verläuft in Spitzen, und die Bereitstellung für Spitzenbedarf in einer einzigen AWS-Region kann kostspielig sein. Der Agent Mode verwendet Amazon Bedrock Cross-Region-Inferenz um Anfragen automatisch unter den von einem Inferenzprofil definierten Zielregionen weiterzuleiten. Zur Laufzeit übergibt die Anwendung die ausgewählte Inferenzprofil-ID oder den Amazon Resource Name (ARN) als modelId in Converse oder InvokeModel. Das Profil, die entsprechenden AWS Identity and Access Management (IAM)- und Service-Control-Richtlinien sowie Kontingente müssen jede Zielregion zulassen, die Bedrock auswählen könnte.
- Geografische Inferenzprofile leiten Anfragen nur zwischen unterstützten Regionen innerhalb einer definierten Geografie weiter, etwa den Vereinigten Staaten oder der Europäischen Union. Diese Option verbindet erhöhten Durchsatz mit einer konfigurierten geografischen Verarbeitungsgrenze.
- Globale Inferenzprofile können Anfragen zwischen unterstützten Zielregionen weltweit weiterleiten, um zusätzlichen Durchsatz bei Verkehrsspitzen zu bieten. Sie sind nur geeignet, wenn die Workload keine geografisch eingeschränkte Verarbeitungsgrenze erfordert.
Postman kann das Inferenzprofil pro Workload auswählen: ein globales Profil für maximal verfügbaren Durchsatz oder ein geografisches Profil, wenn die Verarbeitung innerhalb der definierten Geografie des Profils bleiben muss. Diese Wahl ist in der modelId ausdrücklich festgehalten, die für jede Bedrock-Inferenzanfrage verwendet wird.
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
Datenspeicherung und Unternehmenskontrollen
Für Unternehmenskunden kann die zulässige Verarbeitungsgeografie genauso wichtig sein wie der Durchsatz. Geografische Inferenzprofile beschränken das Bedrock-Routing auf die unterstützten Zielregionen des Profils innerhalb der ausgewählten Geografie. Das bedeutet nicht, dass die Inferenz innerhalb der eigenen AWS-Umgebung von Postman läuft. Amazon Bedrock verarbeitet Anfragen in den für dieses Profil zugelassenen AWS-Regionen, mit Datenverschlüsselung bei Übertragung und im Ruhezustand. AWS gibt an, dass Bedrock Prompts und Completions nicht zum Training von AWS-Modellen verwendet und diese nicht an Dritte weitergibt. Postman hat Zero-Data-Retention konfiguriert, wobei data_retention_mode für unterstützte Agent-Mode-Modelle auf none gesetzt ist. Verfügbarkeit und Verhalten sind modellabhängig, daher muss jedes Produktionsmodell gegen die aktuelle Amazon-Bedrock-Dokumentation zu Datenschutz und Aufbewahrung.
Prompt-Caching zur Kostenkontrolle
Ein Produktions-Agent sendet bei jedem Durchlauf umfangreichen stabilen Kontext erneut, einschließlich Systemanweisungen, generischem Agentenverhalten, einem Kernwerkzeugsatz, ausgewähltem Wissen und Konversationskontext. Die erneute Verarbeitung des unveränderten Präfixes bei jeder Anfrage fügt vermeidbare Latenz und Kosten hinzu.
Der Agent Mode verwendet Amazon Bedrock Prompt Caching um stabile Prompt-Präfixe wiederzuverwenden. Der nahezu unveränderliche Kern, einschließlich System-Prompt, Agenten-Anweisungen und Kern-Tool-Definitionen, verwendet einen Cache-Checkpoint von einer Stunde. Variablerer Kontext verwendet einen Fünf-Minuten-Checkpoint, der bei einem Cache-Treffer aktualisiert wird. Bedrock verlangt, dass der langlebigere Checkpoint vor dem kürzer lebigen Checkpoint erscheint. Die kürzere Stufe eignet sich für interaktive Sitzungen, da ungenutzter Kontext abläuft, während die Ein-Stunden-Stufe ihren höheren Cache-Write-Preis über viele Lesevorgänge amortisieren kann. Cache-Vorteile und unterstützte TTLs hängen vom ausgewählten Modell ab. Teams können das Verhalten über die Nutzungsfelder cacheReadInputTokens und cacheWriteInputTokens überprüfen und die Zeit bis zum ersten Token für ihre eigenen Workloads messen.
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
Was Entwickler mitnehmen sollten: Behandeln Sie Inferenz als Routing- und Caching-Problem, nicht nur als Modellwahl. Wählen Sie das Claude-Modell je nach Workload, wählen Sie das passende regionsübergreifende Inferenz-Profil und cachen Sie den stabilen Prompt-Präfix mit TTLs, die der Änderungshäufigkeit jeder Schicht entsprechen.
Best Practices für die Skalierung von Agenten in der Produktion
Destilliert aus Postmans Erfahrungsweg, für Entwickler, die mit Amazon Bedrock arbeiten:
- Budgetieren Sie Tools genauso sorgfältig wie Tokens. Wählen Sie dynamisch die Tools aus, die pro Aufgabe bereitgestellt werden. In Postmans Tests stiegen die Fehler bei der Tool-Auswahl, als das sichtbare Toolset groß wurde.
- Bevorzugen Sie schema-bewusste Lesezugriffe statt Tool-Vermehrung. Modellieren Sie Ihre Daten gut und lassen Sie den Agenten sie abfragen.
- Entkoppeln Sie Agentenaktionen vom Schnittstellenzustand. Wenn ein Tool einen geöffneten Tab erfordert, navigiert der Agent durch die Schnittstelle, statt direkt über Daten zu schlussfolgern.
- Gestalten Sie Kontext bewusst. Speziell entwickelte Kontext-Handler schlagen die Serialisierung Ihres Rendering-Modells jedes Mal.
- Verwalten Sie das Kontextfenster als knappe Ressource. Trunkierungs- und Erweiterungsstrategie ist ein erstklassiges Designproblem, kein Nachgedanke.
- Liefern Sie Dokumentation mit Features aus. Eine RAG-Wissensbasis bleibt nur dann nützlich, wenn sie sich im Gleichschritt mit dem Produkt weiterentwickelt.
- Routen und cachen Sie auf Bedrock. Ordnen Sie jede Workload dem passenden Claude-Modell zu, wählen Sie regionsübergreifende Inferenz entsprechend Durchsatz- und geografischen Anforderungen und wenden Sie gestuftes Caching auf stabile Prompt-Präfixe an.
Fazit
Der Aufbau von Agent Mode zwang Postman, sich mit der Lücke zwischen den Fähigkeiten großer Sprachmodelle und der Struktur ausgereifter Produkte auseinanderzusetzen: Schnittstellenannahmen, gekoppelte Clients, unübersichtliche Tool-Kataloge und Wissen, das über Dokumentation und Teams verteilt ist. Dynamische Tool-Auswahl, schema-basierte Lesezugriffe und bewusstes Kontext-Engineering erwiesen sich als wiederholbare Muster in der Größenordnung von Postmans Entwickler-Community. Amazon Bedrock bietet den verwalteten Modellzugriff, regionsübergreifende Inferenz, modellabhängige Aufbewahrungskontrollenund Prompt-Caching , die die Produktionsarchitektur unterstützen.
Ob Sie Ihren ersten Agenten bauen oder einen bestehenden skalieren – diese Muster können Teams helfen, häufige Herausforderungen bei Agenten-Integration und Skalierung zu vermeiden.
Weitere Informationen finden Sie in der Amazon Bedrock-Dokumentation, einschließlich Anleitungen für regionsübergreifende Inferenz, Prompt-Cachingsowie Datenschutz und Datenaufbewahrung. Weitere Hinweise zur Implementierung finden Sie in Effectively use prompt caching on Amazon Bedrock und Amazon Bedrock kündigt globale regionsübergreifende Inferenz für höheren Durchsatz an im AWS Machine Learning Blog. Um das Produkt zu erkunden, sehen Sie sich die Postman Agent Mode-Dokumentation.
an. Postmans Produktionsimplementierung ist proprietär und nicht als öffentliches Beispiel-Repository verfügbar.