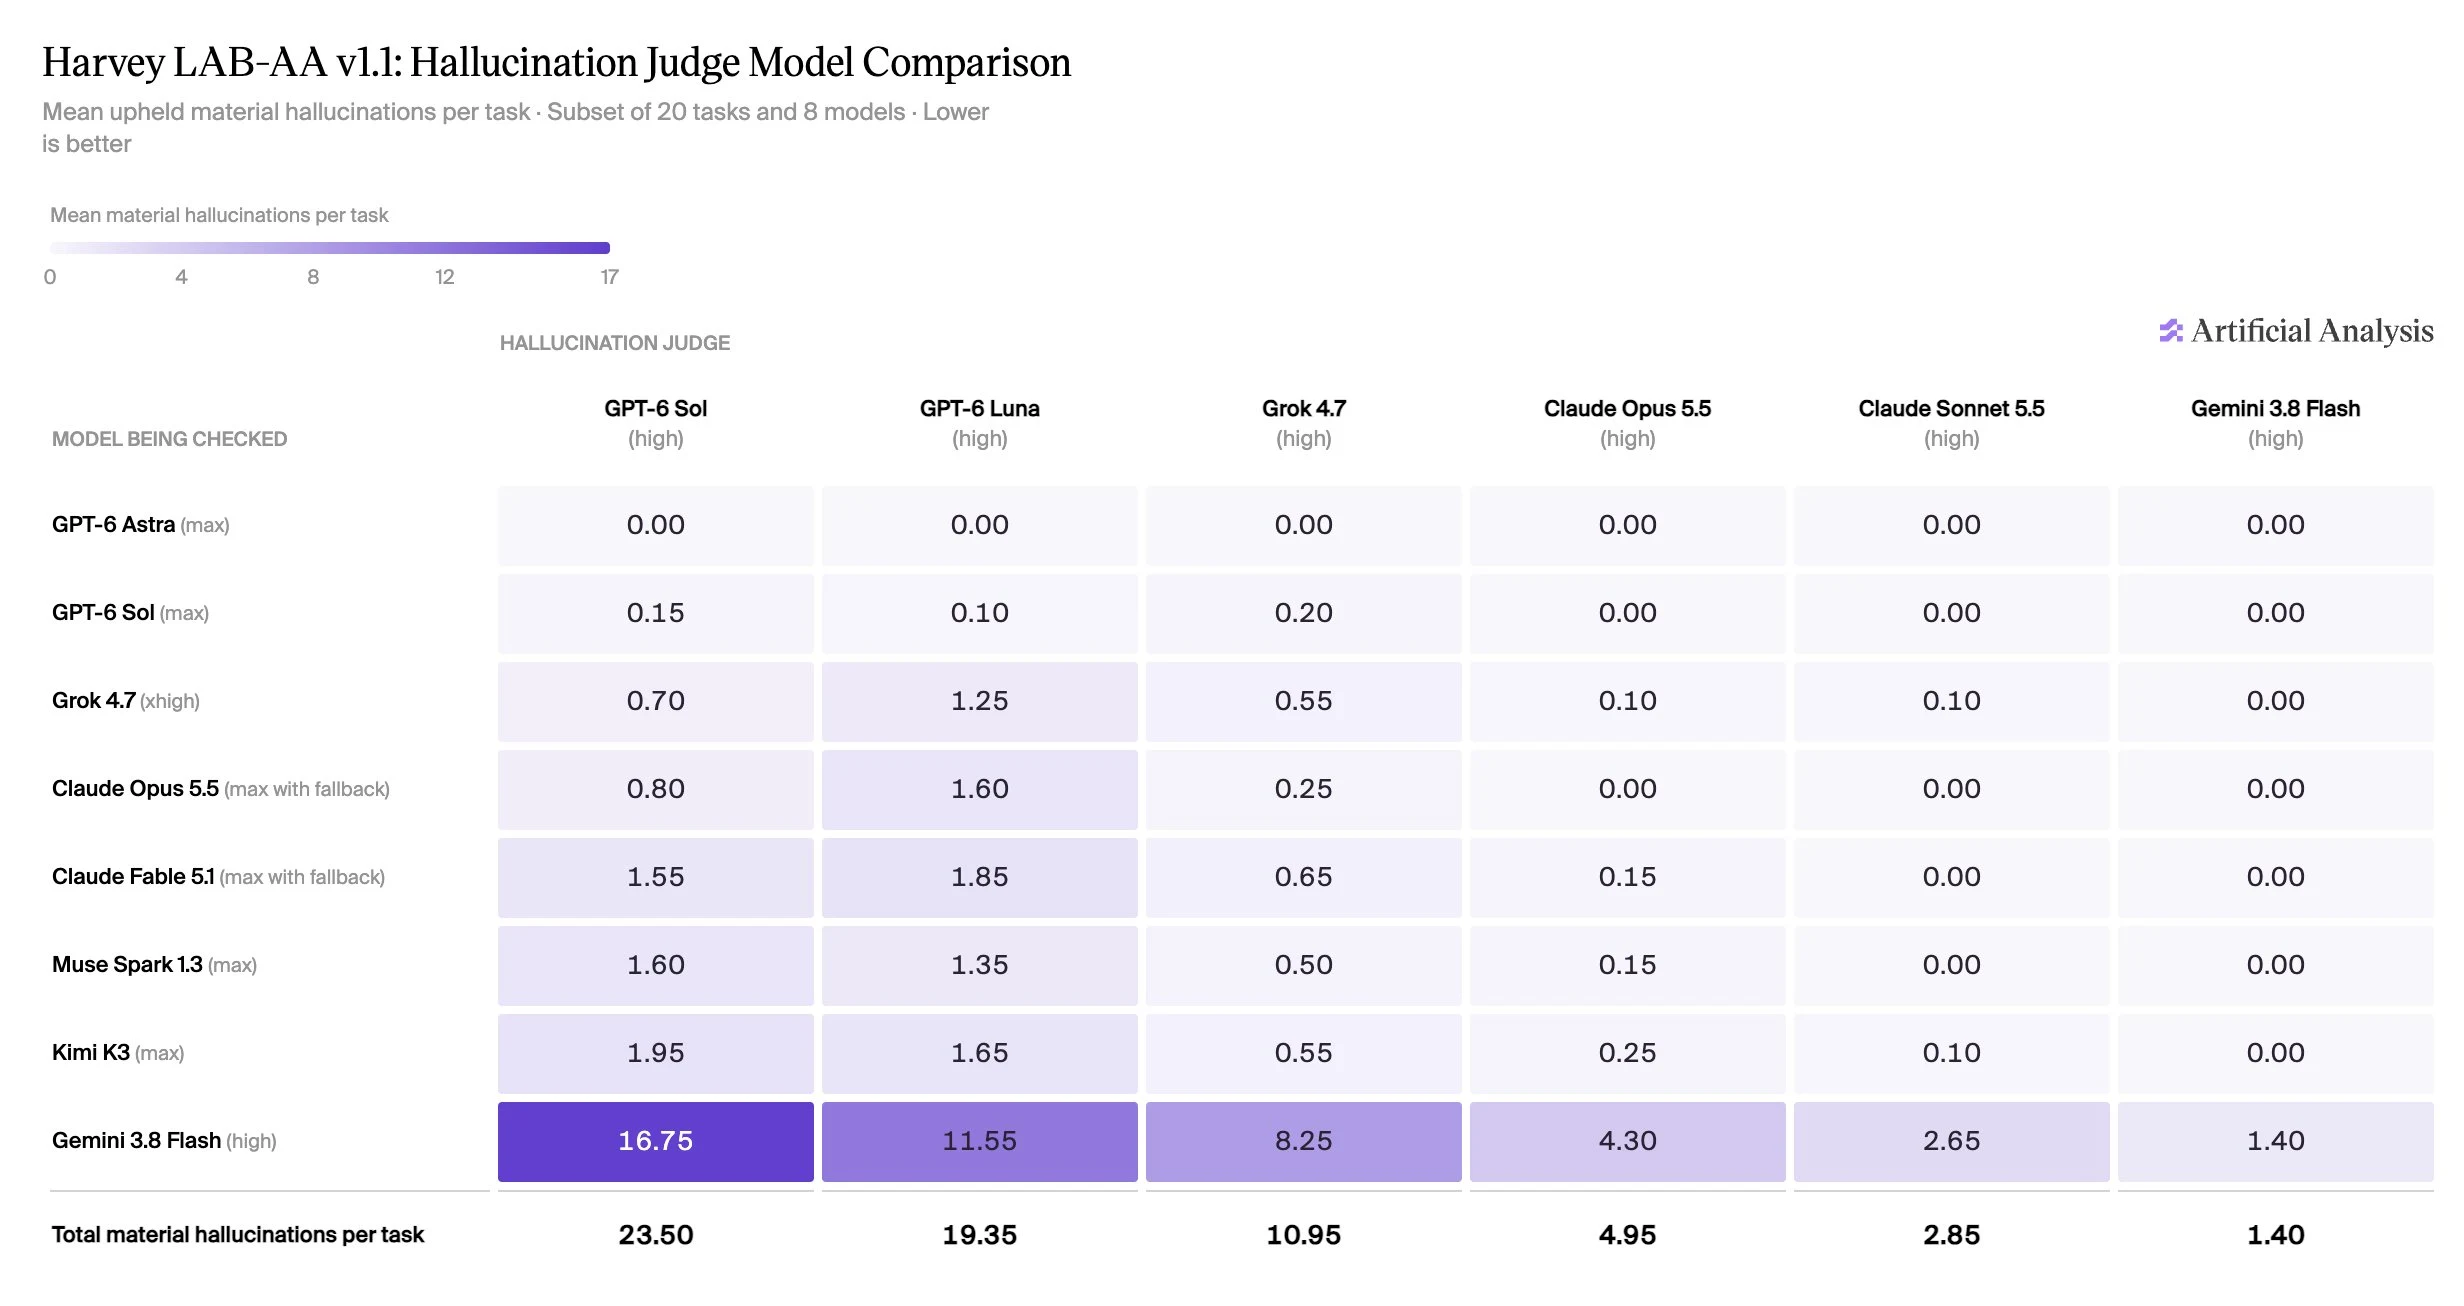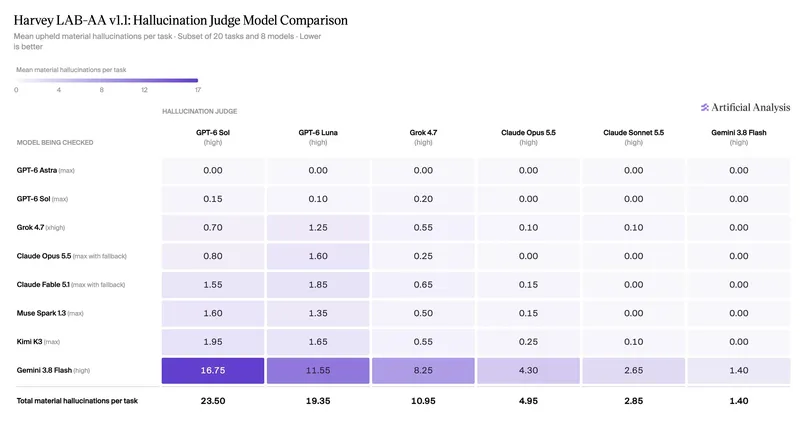
Wir verglichen sechs Halluzinationstests auf dieselben Leistungen aus einem festen Teilbereich von 20 Aufgaben und acht Modellen. Wir führten unseren zweistufigen Test mit GPT-6 Sol (hoch), GPT-6 Luna (hoch), Grok 4.7 (hoch), Claude Opus 5.5 (hoch), Claude Sonnet 5.5 (hoch) und Gemini 3.8 Flash (hoch) durch und wählten GPT-6 Sol (hoch) für den Produktionsgebrauch.
Über diesen 20-Aufgaben-Teil wurden bei GPT-6 Sol und GPT-6 Luna im Allgemeinen mehr materielle Halluzinationen identifiziert, während Claude Sonnet 5.5 und Gemini 3.8 Flash deutlich weniger erkannten. Claude Opus 5.5 lag in allen Modellreihen zwischen Grok 4.7 und Claude Sonnet 5.5. Insgesamt erkannte Opus 99 materielle Halluzinationen, während es bei Grok 219, bei Sonnet 57 und bei GPT-6 Sol 470 waren. GPT-6 Sol identifizierte mehr Materialhalluzinationen, obwohl die Kontrollmethode eine konservative Vorgehensweise bei der Erkennung von Fehlern verwendet hat, wodurch allgemeines Rechtswissen, das in den Quelldokumenten nicht enthalten ist, ausgeschlossen wird.
Alle sechs Prüfer fanden keine materiellen Halluzinationen in den Ausgaben von GPT-6 Astra, während GPT-6 Sol von 0 bis 0,20 pro Aufgabe lag. Beide gehörten zu den Modellen mit den wenigsten materiellen Halluzinationen unter allen Prüfern. Diese Vergleich zeigt Unterschiede im Verhalten der Prüfer; die Zahlen allein lassen keine Genauigkeit feststellen oder Selbstbevorzugung ausschließen.