
vLLM unterstützt jetzt Vera Rubin NVL72!
NVIDIA Vera Rubin ist die nächste Generation von Plattformen, die für agentische Inferenz entwickelt wurden. Seit der Ankündigung wurde vLLM von Inferact, NVIDIA, Red Hat und der vLLM-Community auf Vera Rubin NVL72 bereitgestellt. Heute läuft vLLM auf Vera Rubin NVL72 – mit täglichen Container-Builds und Unterstützung für Modelle von DeepSeek, Moonshot AI, Z.ai und MiniMax.
Dieser Beitrag gibt einen ersten Überblick darüber, wo die Situation ist, und hier sind einige Highlights aus der bisherigen Arbeit:
- Vera Rubin NVL72 Hardware: 5-mal so viele NVFP4 FLOPS, etwa 2,4-mal so breite HBM-Bandbreite und 1,7-mal so breite bidirektionale NVLink-Bandbreite wie bei GB200 NVL72, mit 2-4-mal schnelleren Exponentialen für softmax.
- Support für Tag-0: Rubin basiert auf der Architekturfamilie von Blackwell, sodass die Blackwell-Kerne von vLLM mit Rubin kompatibel sind. Dadurch unterstützt vLLM bereits diverse Modelle wie DeepSeek, Kimi, GLM und MiniMax auf Rubin.
- Rubin-geschliffene Kernels: Durch FlashInfer 0.7.0 erhält vLLM Rubin-geschliffene Attention-, GEMM- und MoE-Kernels. Wir haben außerdem unser MiniMax Sparse Attention (MSA) Prefill-Kernel für Rubin angepasst.
- Locality-verantwortlicher MoE: Um das erhöhte HBM-Bandbreitenverhältnis von Rubin optimal zu nutzen, nutzen wir die locality-Domains von CUDA 13.4, um die MoE-Werte zu teilen. Dadurch können die SMs die Werte nur aus dem am nächsten gelegenen Speicher lesen.
- Frühe Leistung: Die frühen Ergebnisse zeigen bereits beeindruckende Verbesserungen mit vLLM: 7,8-mal mehr Durchsatz pro GPU im Vergleich zum GB200 NVL72 bei gleichbleibender Interaktivität und bis zu 3,7-mal mehr VLM-Durchsatz im Vergleich zum GB300 NVL72 im MLPerf. Das ist erst der Anfang; wir erwarten, dass die Leistung weiter verbessert wird, während die Optimierungen fortgesetzt werden.
Was Rubin für die Inferenz ändert
Klicken Sie, um zu erweiternAbbildung 1. Vergleich pro GPU: NVIDIA Vera Rubin NVL72 und GB200 NVL72. Bewegen Sie den Cursor über ein Metrikum, um den Teil der GPU hervorzuheben; die Option „Tabelle anzeigen“ listet alle Werte auf. Quellen: NVIDIA Vera Rubin NVL72 und GB200 NVL72 Spezifikationsseiten sowie die NVIDIA Rubin-Entwickler-Blogs.
Die Vera Rubin-Plattform
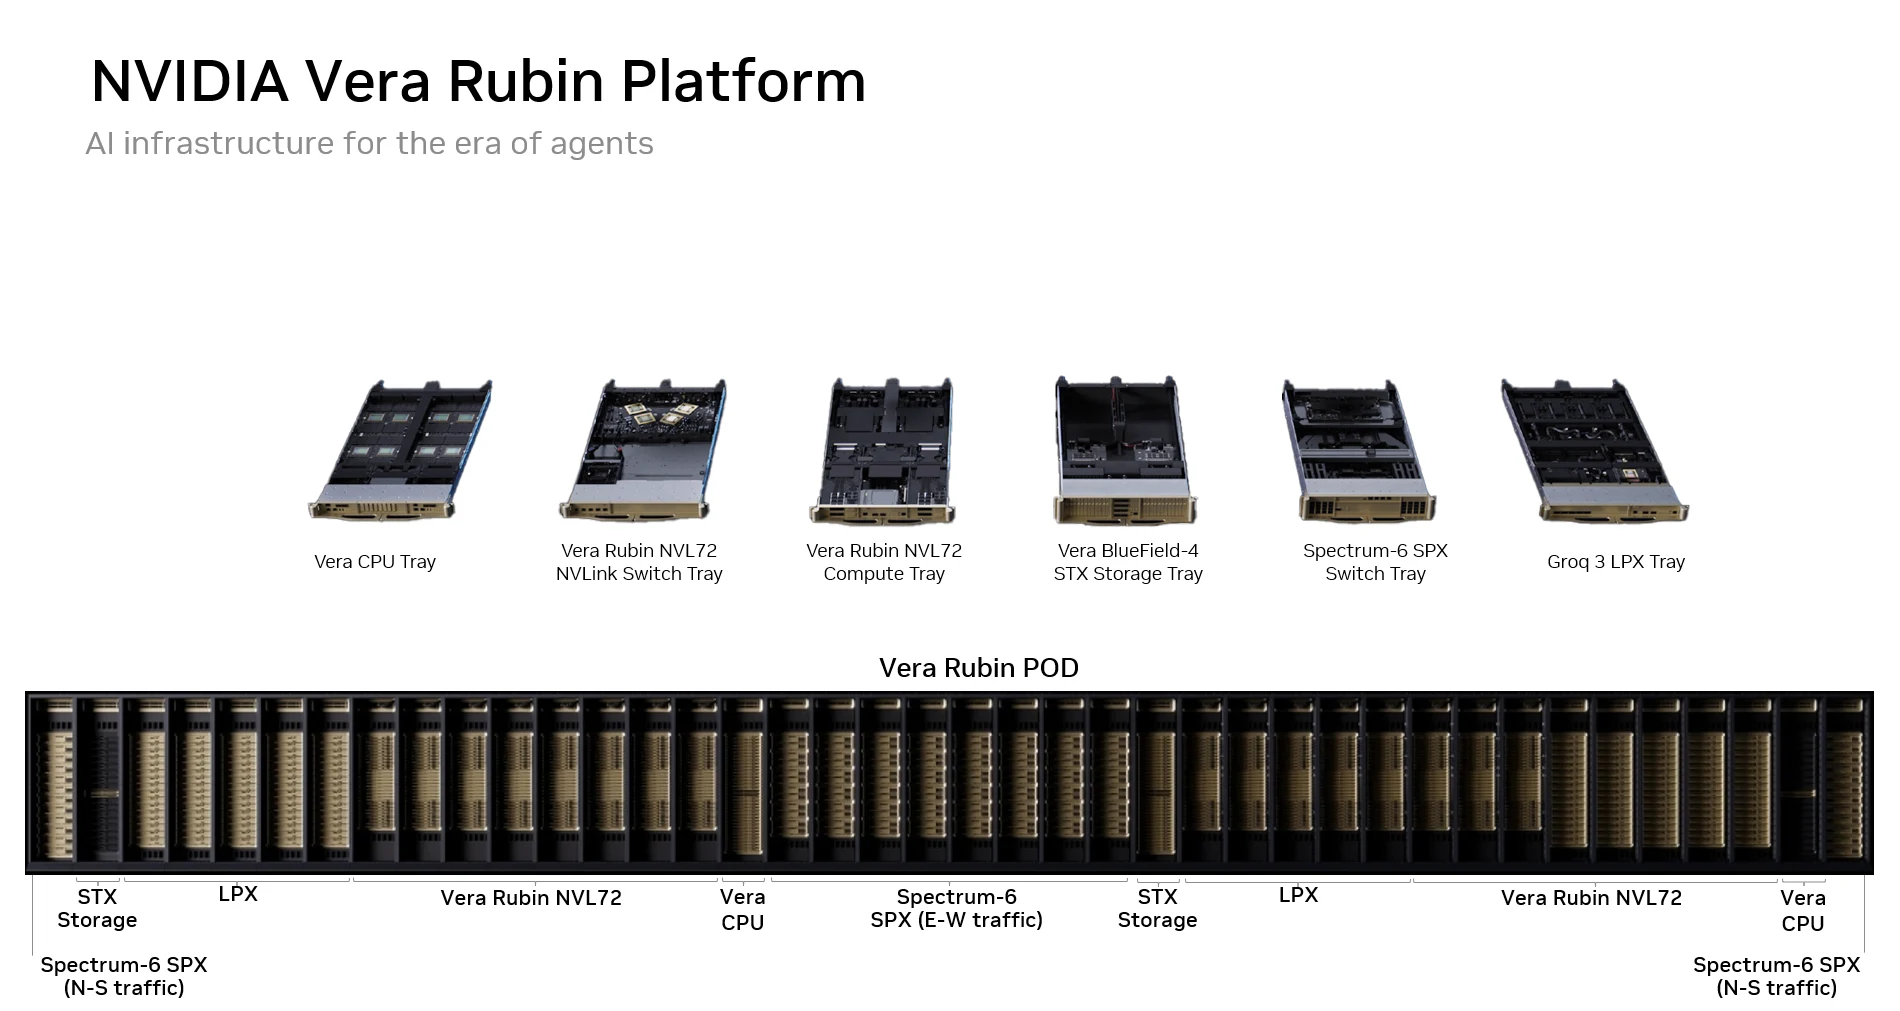
Die Vera Rubin-Plattform bietet hervorragende Leistung durch eine extreme Kombination der Rack-Komponenten – sie verfügt über fünf neue, unterschiedliche, speziell entwickelte Rack-Systeme für agentische AI-Arbeitslasten: Vera Rubin NVL72, Vera CPU rack, Groq 3 LPX, Spectrum-6 SPX und BlueField-4 STX Storage.
Eine einzige Vera Rubin NVL72 liefert 5-mal mehr NVFP4-Inferne-FLOPS als die GB200 NVL72 und 2,4-mal höhere Speicherbandbreite. Auf der Skalierungsseite des Netzwerks bietet die sechste-Generation-NVLink bis zu 1,7-mal mehr Bandbreite als Blackwell, was eine deutlich bessere Benutzerfreundlichkeit in Produktionsagenten-Dienste-Szenarien ermöglicht.
Softmax. Besonders ist, dass Rubin auch die Leistung von Softmax verbessert, was eine Kerroperation im LLM-Attention ist. Rubin erhöht den exponentiellen Durchsatz, darunter 2x FP32 und 4x BF16/FP16-Durchsatz im Vergleich zum NVIDIA GB200, wodurch Softmax mit schnelleren Matrizenoperationen Schritt halten kann.
Speicher. Der HBM in Rubin wurde von HBM3e auf HBM4 aktualisiert, wodurch die Bandbreite bis zu 2,4-mal höher ist als bei GB200 NVL72. In Kombination mit der leistungsstärkeren Rechenleistung beschleunigt das Rubin-GPU wichtige LLM-Inferenzoperationen wie GEMM, MoE (Mixture of Experts) und Attention, und erzielt eine deutlich höhere Gesamtleistung sowie eine geringere Dekodierlatenz (Details unten).
Netzwerktechnik. Die Inter-GPU-Netzwerkebene auf der Rubin-Plattform wurde ebenfalls stark verbessert. Der sechste-Generationen-NVLink bietet eine 1,7-mal höhere Netzwerkbandbreite als die vorherige Generation. Dies beschleunigt kollektive Operationen (z. B. AllReduce und All2all) sowie andere Kommunikationsvorgänge, was die Geschwindigkeit und Skalierbarkeit der großskaligen LLM-Inferenz verbessert (z. B. prefill/decode disaggregation, breiter Expertenparallellauf).
vLLM Rubin-Unterstützungsstatus
Die vLLM-Community hat sofort nach der öffentlichen Ankündigung mit der Bereitstellung von Rubin gearbeitet. Als wesentliche Bestandteile der vLLM-Community haben Ingenieure von NVIDIA, Inferact und Red Hat zusammengearbeitet und Beiträge geleistet, um sicherzustellen, dass alle Benutzer die Modelle auf der Rubin-Plattform problemlos deployen können.
In diesem Abschnitt betonen wir die laufende Unterstützung von vLLM für Rubin – insbesondere die Nutzung lokaler Domains – sowie die Verbesserungen der Benutzerfreundlichkeit, die es ermöglichen, direkt auf Rubin-Hardware zu arbeiten.
Lokationsdomänen-Unterstützung
Seit Ampere bieten NVIDIA-GPUs nicht-uniforme Zugriffe auf die globale Memoriaufnahme. Die Locality-Domain-Funktion in NVIDIA CUDA 13.4 ermöglicht es Anwendungen, die nicht-uniformen Zugriffe auf die globale Memoriaufnahme voll auszunutzen, indem sie Berechnungen und Daten innerhalb desselben Locality-Domains platzieren. Die SMs können die globale Memoriaufnahme innerhalb ihres eigenen Locality-Domains mit höherem Bandbreitenverhältnis und geringerem Latenzzeit als HBM in anderen Domains erreichen. Mit Green Contexts und CUDA-Streams können wir einen Kernel in jedem Locality-Domain starten, sodass jeder Kernel Zugriff auf die lokale Memoriaufnahme hat. Diese Funktion beschleunigt vor allem Arbeitslasten, die von der Memoriaufnahme abhängig sind, wie zum Beispiel die Dekodierung von MoE. Die Locality-Domains befinden sich weiterhin im aktiven Design- und Entwicklungsprozess. In diesem Abschnitt verwenden wir die Dekodierung von MoE als Beispiel für eine tiefgehende Untersuchung.
Klicken Sie, um zu erweiternAbbildung 3: Split-N in MoE-Forward auf zwei Lokalkomponenten. Die Gewichte W werden in den Spalten bei N/2 geteilt, und die SMs jeder Komponente lesen nur die Hälfte von W in ihrer eigenen HBM, sodass jede Komponente ihre lokale Speicherbandbreite nutzt. Die Eingabe X und die Ausgabe C liegen auf beiden Komponenten. Verwenden Sie Pause, Prev/Next oder die Schritt-Chips, um die Schritte durchzuführen.
Die MoE-Dekodierung ist an der Lesung von Gewichten aus HBM gebunden, daher ist unser Ziel die Optimierung des Speicherdurchflusses in den Lokalisierungsbereichen. Bei einem ersten Blick auf Rubins neue Merkmale für lokalisierte Bereiche verwenden wir die Split-N-Strategie in FC1 und FC2, wie in Abbildung 3 dargestellt. Wir teilen die Gewichtsspalten spaltenweise auf, platzieren jede Spalte in das globale Speicherverfassnis jedes Lokalisierungsbereichs und beschränken die SMs jedes Bereichs auf ihre lokale Spalte. Dies eliminiert die meisten Zugriffe auf das Speichermedium zwischen den Domänen, was zu einer Verbesserung der Kernleistung und einer Einsparung von Energie führt. Da das Aktivierungsspeicher bei der Dekodierung relativ klein ist, würde seine Nicht-Lokalisierung zwischen zwei Speicherdomänen nur minimalen Overhead verursachen.
SMs können nicht immer in gleich große Domänen unterteilt werden. Die Erstellung der Lokalkontext-Domäne umfasst standardmäßig keine SMs, wenn versucht wird, gleich große Partitionen zu erstellen. Um sicherzustellen, dass beide Partitionen dieselben SMs enthalten, müssen wir cudaDevSmResourceGroupBackfill (Backfill-Modus) bei der Erstellung der Domänen aktivieren (wir verweisen auf die offizielle Dokumentation zur Lokalkontext-Domäne für weitere Details). In unserer Leistungsexperiments studieren wir sowohl den Standardmodus (nur 200 SMs werden in beiden Domänen verwendet) als auch den Backfill-Modus (alle 212 SMs werden verwendet).
Abbildung 4 vergleicht die vorläufige Zeit vorwärts der MoE-Schicht (FC1 + FC2) mit den Lokalkontexten bei verschiedenen parallelen Strategien. Wir verwenden die MiniMax M3-MoE-Formen als Beispiel. Bei aktiviertem Lokalkontext erreichen wir im Durchschnitt eine Geschwindigkeitssteigerung von 1,2x in kleinen Token-Vorwärts-Szenarien. Die Trendlinie bleibt für andere TP- und EP-Serving-Strategien ebenfalls annähernd gleich. Selbst im Standardmodus, bei dem nur 200 der 212 SMs verwendet werden, führt die Aktivierung der Lokalkontexte zu einem ähnlichen Vorteil. Der Hauptgrund ist, dass bei der Dekodierung kleiner Token die Vorwärtsverarbeitung durch das Gewichtladen dominiert wird, und lokale Domains eine höhere HBM-Leistung ermöglichen. Diese frühen Ergebnisse sind nur ein Ausgangspunkt; es gibt Raum für weitere Anpassungen und Optimierungen, um die Leistungsvorteile der Lokalisierung auf Rubin zu maximieren.
Klicken Sie, um zu erweiternAbbildung 4. Vorläufige Latenzzeiten von FC1 + FC2 pro Rang des MiniMax M3 MoE-Layers auf Rubin, nicht-lokalisiert vs. lokalisiert (niedriger ist besser), mit der Beschleunigung (Nicht-lokalisiert ÷ Lokalisiert-Latenz) über jede Paarung. Die Tabellen wechseln die Parallelstrategie (TP2, TP4, EP2, EP4); die Schalter wechseln zwischen dem Backfill-Modus (alle 212 SMs) und dem Standardmodus (200 von 212 SMs). Gleichgewichtige Routing-Verfahren; der Kommunikationszeit ist nicht enthalten.
Tag-0-Nutzbarkeit
Die Benutzerfreundlichkeit ist immer die erste Priorität von vLLM. Seit heute können Nutzer die nächtlichen Bilder, die mit CUDA 13.4 und PyTorch 2.15 erstellt wurden, vom Docker Hub von vLLM herunterladen und verwenden – nämlich vllm/vllm-openai:cu134-nightly, für Rubin-Hardware.
Kompatibilität mit der Blackwell-Softwarestack. Rubin basiert auf der Architekturfamilie von Blackwell und verwendet erweiterte tcgen05-Tensor-Core-Instruktionen. Es handelt sich um einen neuen GPU-Compilierungsziel (sm107), aber die für das Blackwell-Familienziel (sm100f) erstellten Kernels können auch auf Rubin laufen. In der Praxis können die Blackwell-Kernel von vLLM, insbesondere diejenigen mit starkem GEMM-Verfahren wie Attention und MoE, bereits ohne Anpassungen auf Rubin laufen.
Tägliche Container-Builds. Die täglichen Container-Builds für Rubin sind bereits verfügbar (#55953), wurden durch #53443 und #54640 für den Rubin-Buildpfad auf CUDA 13.4 aktiviert, sowie durch #56545 und #59288 für die Aktualisierung der Rubin-Abhängigkeiten.
Modellabdeckung. Mit diesen Komponenten kann vLLM nun verschiedene Modelle wie DeepSeek, Kimi, GLM und MiniMax auf Rubin bereitstellen.
Rubin-gesteuerte Kernels
Allmählich werden Kernels veröffentlicht, die die speziellen Hardwarefunktionen und -merkmale von Rubin nutzen, und diese werden in Kernelbibliotheken wie FlashInfer, der Fork von MSA von vLLM (vllm-project/MSA), Humming (vllm-project/humming) usw. aufgespeichert. Seit heute hat vLLM einige wichtige Kernels integriert, um die Leistung von Rubin zu maximieren, darunter den dichten NVFP4- oder MXFP4-GEMM-, den NVFP4-MoE-, den FP8-Attention-, den FP8-MSA-Prefill- und viele weitere.
Leistung
Wir bewerten die Leistung von vLLM, das auf Vera Rubin NVL72-GPUs läuft, mit zwei repräsentativen Benchmarks: SemiAnalysis AgentX (in unserem vorherigen Artikel) und MLPerf Inference v6.1.
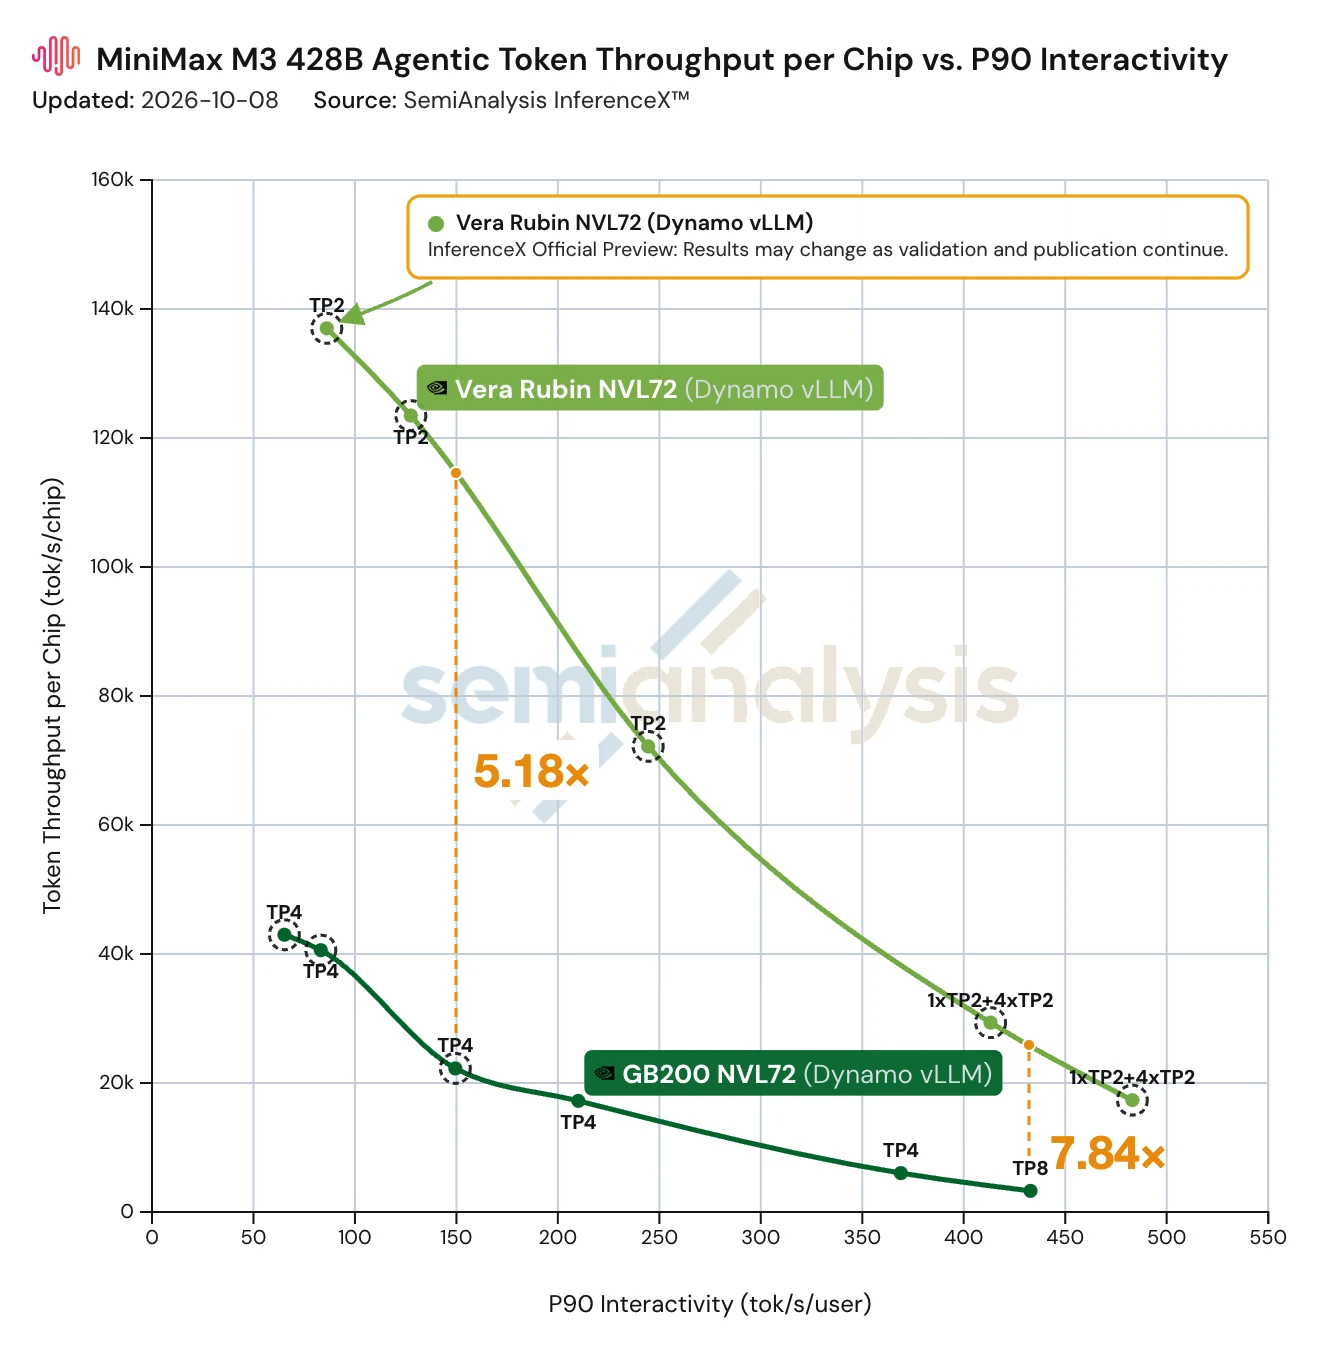
Auf AgentX liefert vLLM mit MiniMax M3 auf dem Vera Rubin NVL72 bis zu 7,84-mal mehr Durchsatz pro NVIDIA GB200 bei gleichbleibender Interaktivität und 5,18-mal mehr Durchsatz unter einer Beschränkung von 150 TPS. Dies ist eine sehr frühe Einschätzung der Inferenzfähigkeiten der Plattform. Da wir Zugang zu mehr Vera Rubin NVL72-Noden erhalten, werden wir die Tests erweitern und die Optimierung beschleunigen, wobei weitere Leistungssteigerungen erwartet werden, so wie das Projekt voranschreitet.
Die MLPerf Inference v6.1-Runde war der erste Testumfeld, in dem vLLM auf der NVIDIA Vera Rubin NVL72-Plattform eingesetzt wurde. Im Benchmark für Vision-Language-Modelle (VLM) liefert die Vera Rubin NVL72 mit der Verwendung des Qwen3-VL-235B-A22B-Modells über vLLM als Backend-Inference-Engine und Dynamo als Frontend-Router eine bis zu 3,7x höhere Durchsatzleistung im Vergleich zur GB300 NVL72 – sowohl in offline-, Server- als auch in interaktiven Szenarien. Weitere Details zu den veröffentlichten MLPerf Inference v6.1-Ergebnissen finden sich in Nvidias Blogpost.
Nächste Schritte
„Rome wurde nicht an einem Tag gebaut“, und die Verbesserung der Benutzerfreundlichkeit und Leistung auf den Vera Rubin NVL72-GPUs wird ein kontinuierlicher Prozess sein, der voller Spannung steckt. In naher Zukunft planen wir, gemeinsam als Gemeinschaft viele weitere neue Funktionen für die Rubin-GPUs zu ermöglichen, einschließlich – aber nicht begrenzt auf:
- Integrieren Sie den sm107 FlashInfer MegaMoE in vLLM über FlashInfer.
- Erhöhen Sie vollständig die Lokalkomponenten für MoE-Schichten.
- Entfalten und nutzen Sie mehr überlappende Möglichkeiten zwischen verschiedenen Schichten oder Kernen durch PDL und Lamport-Sync.
- Erkunden Sie die Mega-Kerne für Anwendungsfälle mit besonderer Sorgfalt bei Latenzproblemen.
- Optimieren Sie die KDA- und MLA-Kerne für Rubin für Kimi K3.
- Integrieren Sie die Rubin CSA- und HCA-Kerne für DeepSeek-V4.1-Flash.
- Fertigstellen und die Rubin MSA-Dekodier-Kerne integrieren.
- Integrieren Sie das CFT-counted-write-MoE-All-to-all-Kernel in vLLM durch FlashInfer.
Danksagungen
Dieses Projekt ist eine gemeinsame Anstrengung von Inferact, NVIDIA, Red Hat und der breiteren vLLM-Community. Wir möchten uns besondere danken für:
- NVIDIA – für frühe Zugang zu Vera Rubin NVL72 und enge Zusammenarbeit während des Entwicklungsprozesses.
- Inferact und NVIDIA, um die Rubin-Kollaboration zu leiten, die Leistungseinstellungen voranzutreiben, die MSA-Kerne zu integrieren und das Leistungsverhalten eines lokalisierungsbewussten MoE zu untersuchen.
- NVIDIA und Red Hat – für die Einrichtung und Aktivierung der täglichen Docker-Builds für Rubin.
- Die vLLM-Community bietet kontinuierlichen Support und Beiträge während des gesamten Prozesses.
Anhang: vLLM auf Vera Rubin NVL72 ausführen
Zeigen Sie die Kernelkonfigurationen für Rubin anvLLM hat bereits einige hochoptimierte Kernels für Rubin integriert. Dieser Abschnitt beschreibt die entsprechenden Konfigurationen, um diese auf den Rubin-GPUs maximal performant zu nutzen.
- CuTe-DSL dichtes NVFP4 oder MXFP4 GEMM. Standardmäßig für einen NVFP4/MXFP4-Modell-Checkpoint, aber Sie können
--linear-backend flashinfer_cutedslfür NVFP4 oder--linear-backend flashinfer_cutlassfür MXFP4 setzen, um sicherzustellen, dass es aktiviert ist. - CuTe-DSL NVFP4 MoE. Sie können es über
--moe-backend flashinfer_cutedslaktivieren. - CuTe-DSL maskiert gruppiertes GEMM für NVFP4 W4A4 MoE im „batched“-Expertenformat. Dies gilt für eine Bereitstellung mit
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_ep, wobeiN>1ist. In diesem Fall würde--moe-backend auto|flashinfer_cutedslbeide auf dieses Kernel ausweisen. - CuTe-DSL FP8 BMM für statische per-Tensor-FP8 W8A8-lineare Layers. Standardmäßig aktiviert und kann vom FlashInfer Autotuner genutzt werden.
- Trtllm-gen FP8 attention. Um es zu aktivieren, benötigen Sie eine FP8 KV-Cache über
--kv-cache-dtype fp8oder einen Checkpoint, der eine FP8 KV-Cache angibt, sowie die Einstellung--attention-backend FLASHINFER|FLASHINFER_MLA. Für den DeepSeek-Stil MLA-Prefill fügen Sie bitte auch-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=truehinzu. - CuTe-DSL FP8 MSA Prefill. Um ihn zu aktivieren, benötigen Sie eine FP8 KV-Cache über
--kv-cache-dtype fp8oder einen Checkpoint, der eine FP8 KV-Cache angibt, sowie die Einstellung--attention-config.minimax_m3_msa_decode_backend=cutlass.