
Anwendungen, die Anfragen weiterleiten, Agentenaktionen auswählen oder politische Ergebnisse zuweisen, benötigen häufig Scores über eine feste Auswahlmenge anstatt freien Text. Das Bereitstellen dieser Entscheidungsmodelle mit llama.cpp auf Amazon SageMaker AI bietet Ihnen einen verwalteten Weg, quantisierte Modelle auf CPU- oder GPU-Infrastruktur zu servieren.
Dieser Beitrag setzt eine Serie über spezialisierte AWS Deep Learning Containers (DLCs) für generative KI-Inferenz fort. Frühere Beiträge behandeln WhisperX, vLLM-Omni – Teil 1sowie vLLM-Omni – Teil 2.
In diesem Beitrag verwenden Sie zunächst den AWS DLC für llama.cpp , um OpenAI-kompatible Chat-Completions über SageMaker AI zu servieren InvokeEndpoint. Anschließend erweitern Sie dieselbe Laufzeit mit SemIf, früher OpenJev, das Wahrscheinlichkeiten über deklarierte Optionen zurückgibt, ohne ein Antwort-Token zu dekodieren. Das begleitende Codebeispiel enthält CPU- und GPU-Bereitstellungsoptionen.
Lösungsübersicht
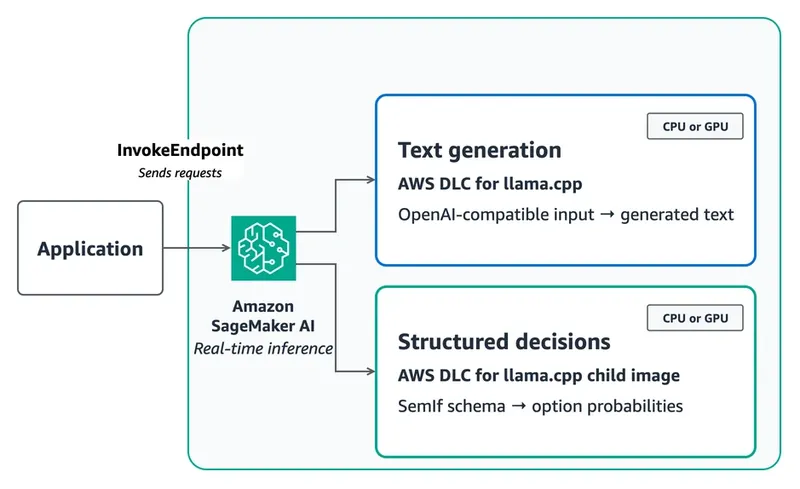
Abbildung 1 zeigt zwei Bereitstellungspfade ausgehend von demselben paketierten Modell. Der Textgenerierungspfad verwendet den AWS DLC für llama.cpp und gibt generierte Antworten über die OpenAI-kompatible API zurück. Der strukturierte Entscheidungspfad erstellt ein Child-Image, das den Standardserver durch einen SemIf-Adapter ersetzt und Wahrscheinlichkeiten für deklarierte Optionen zurückgibt.
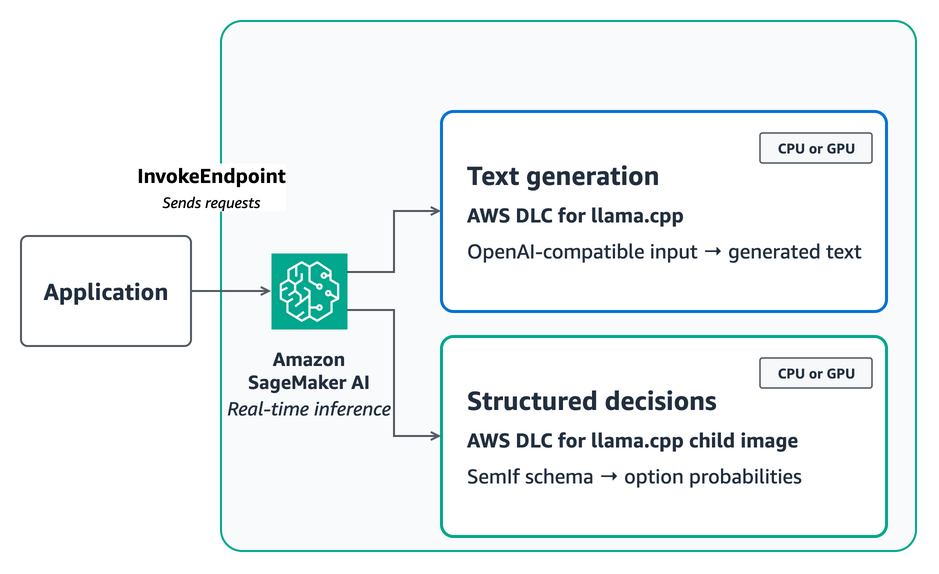
Abbildung 1: Führen Sie den AWS DLC für llama.cpp oder das SemIf-Child-Image auf CPU oder GPU aus, abhängig von den API- und Latenzanforderungen Ihrer Workload
Für den Standardpfad paketieren Sie das Modell als model.tar.gz in Amazon Simple Storage Service (Amazon S3) und verweisen direkt auf das veröffentlichte DLC-Image. Der Container findet die erste .gguf Datei unter /opt/ml/model, ordnet POST /invocations zu llama-server zu /v1/chat/completions, und übergibt SM_LLAMA_CPP_* Umgebungsvariablen an llama.cpp-Argumente.
Die llama-server HTTP-API stellt die Logits der Endposition und die Statusoperationen, die SemIf verwendet, nicht bereit. Der Pfad für strukturierte Entscheidungen verwendet daher AWS CodeBuild , um ein Child-Image zu erstellen und in Amazon Elastic Container Registry (Amazon ECR)zu speichern. Das Child-Image behält die kompilierten CPU- oder CUDA-Bibliotheken des DLC bei und ersetzt dessen Entry Point durch einen SageMaker-kompatiblen Adapter.
Verstehen der Eingabe- und Ausgabeschemata
Das AWS-DLC für llama.cpp akzeptiert das OpenAI-Chat-Completions-Schema. Senden Sie ein messages Array mit role und contentsowie Generierungssteuerungen wie max_tokens und stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
Die Antwort verwendet das OpenAI-kompatible choices Array. Lesen Sie den generierten Text aus choices[0].message.content.
SemIf verwendet stattdessen ein eingeschränktes Entscheidungsschema anstelle von Chat-Nachrichten. Die Anfrage enthält eine vom Aufrufer definierte ID, unstrukturierten Zustand, eine Frage und eine geordnete Liste zulässiger Optionen:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
Die Antwort gibt option_ids, probabilitiesund rohe option_logits in derselben Reihenfolge zurück, zusammen mit Prompt-, Timing- und pinned Model-Metadaten. Mit stabilen Options-IDs kann Ihre Anwendung Schwellenwerte, Fallbacks und Richtlinienprüfungen anwenden, ohne generierte Prosa zu parsen.
SemIf gehört zu einer breiteren Klasse von Entscheidungsmodellen, die anwendungsdefinierte Ergebnisse aus unstrukturiertem Zustand bewerten. Andere Implementierungen umfassen Jev, das Entscheidungsmodell von TypeSafe, und dessen /v1/systemone API; Kev, einen Modellserver, der für TypeSafe-API-Kompatibilität konzipiert ist; und Strands Decider 2B, ein speziell entwickeltes Modell für Agenten-Workflows mit kalibrierten Ausgaben.
Auswahl der richtigen Entscheidungs-Workflows
Verwenden Sie dieses Muster, wenn Ihre Anwendung die zulässigen Auswahlmöglichkeiten zur Anfragezeit definiert und ein Modell benötigt, um unstrukturierten Kontext zu interpretieren. Beispiele hierfür sind die Weiterleitung eines Falls an eine Warteschlange, das Extrahieren eines Werts aus einer bekannten Menge, das Zuweisen einer Incident-Priorität, das Prüfen eines Richtlinienergebnisses oder das Auswählen einer Agentenaktion. Halten Sie Autorisierung und deterministische Geschäftsregeln außerhalb des Modells und validieren Sie die Modellwahrscheinlichkeiten, bevor Sie sie als operatives Vertrauen behandeln.
Verwenden Sie den Standard-SageMaker-AI-Pfad für Textgenerierung, wenn Sie OpenAI-kompatible Chat-Vervollständigungen über InvokeEndpointbenötigen. Das SageMaker-AI-Image ordnet POST /invocations dem llama-server /v1/chat/completions -Endpunkt zu. Erstellen Sie ein untergeordnetes Image nur dann, wenn Ihre Anwendung Verhaltensweisen benötigt, die diese Schnittstelle nicht bietet, wie z. B. den direkten Zugriff auf Logits und Zustände von SemIf.
Das Weglassen der Antwort-Token-Generierung entfernt nicht die Modellinferenz. Das Modell verarbeitet weiterhin den vollständigen Zustand, die Frage und die Optionsbeschreibungen, bevor SemIf die finalen Logits liest. Halten Sie die Prompts fokussiert und evaluieren Sie das ausgewählte Modell mit beschrifteten Entscheidungen aus Ihrer Anwendung, bevor Sie es in der Produktion einsetzen.
Abstimmen auf Ihre Latenz- und Qualitätsziele
Der folgende Benchmark bezieht sich auf die SemIf-Erweiterung, nicht auf den Textgenerierungs-Endpunkt. Modellgröße, Quantisierung, Prompt-Länge, Laufzeit und CPU-Thread-Anzahl beeinflussen jede Entscheidung. Um diese Abwägungen zu quantifizieren, haben wir dieselben 231 öffentlichen JevBench -Aufgaben nacheinander an einen CPU-Endpunkt und einen GPU-Endpunkt gesendet.
| Konfiguration | AWS DLC für llama.cpp | Gültige Antworten | Genauigkeit | Client p50 | Client p95 |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge, 32 Threads |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715 Sekunden | 19.291 Sekunden |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge, vollständiges GPU-Offloading |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352 Sekunden | 0.599 Sekunden |
Im Vergleich zur CPU-Konfiguration war der GPU-Endpunkt bei p50 4,9-mal und bei p95 32,2-mal schneller. Das Beispiel verwendet die SageMaker-AI-Funktion der Instanzpools, um kompatible GPU-Instanztypen in Prioritätenreihenfolge aufzulisten, sodass SageMaker eine Alternative auswählen kann, wenn die erste Präferenz nicht verfügbar ist. Der Pool ordnete g6e, g6, g5, dann g4dn. SageMaker wählte ml.g6e.xlarge, und die Startprotokolle bestätigten, dass llama.cpp alle 34 Modellschichten auf eine NVIDIA L40S ausgelagert hat. Die CPU- und GPU-Images verwendeten unterschiedliche llama.cpp-Builds und lieferten bei sechs schwierigen Aufgaben unterschiedliche Vorhersagen. Behandeln Sie den Genauigkeitsunterschied von einer Antwort als Laufzeitvariation, nicht als Beleg dafür, dass GPU-Offloading die Modellqualität verbessert.
Kleinere Modelle reduzierten die Medianlatenz, aber die 2B- und 0.8B-Kandidaten erreichten 66,7 Prozent bzw. 58,4 Prozent Genauigkeit. Das Beispiel behält daher das 4B- Q4_K_M -Modell als qualitätsorientierten Standard bei. Diese Messungen umfassen die Netzwerklatenz und sind keine Servicegarantien.
Benchmarken Sie die vollständige Modell- und Infrastrukturkonfiguration gegen Ihre eigenen Entscheidungen. Verwenden Sie CPU für Hintergrund-, Offline- oder Workloads mit geringem Durchsatz, die nicht latenzempfindlich sind und Sekunden an Antwortzeit tolerieren können. Verwenden Sie GPU für interaktive Entscheidungen, lange Prompts oder Workloads mit strikten Tail-Latency-Zielen. Halten Sie Zustands- und Optionsbeschreibungen prägnant, gruppieren Sie Entscheidungen, die denselben Zustand teilen, in einer Anfrage, und skalieren Sie Endpunkt-Instanzen für Nebenläufigkeit. Das Shared-State-Scoring verwendet das gemeinsame Prompt-Präfix wieder, während der Adapter wiederholbare HTTP zurückgibt 503 Antworten zu liefern, anstatt eine unbegrenzte Warteschlange um den zustandsbehafteten llama.cpp-Kontext zuzulassen.
Voraussetzungen
Sie benötigen:
- Ein AWS-Konto und einen S3-Bucket in der AWS-Region, in der Sie bereitstellen.
- Python 3.10 oder höher, Git und die AWS Command Line Interface (AWS CLI).
- Eine zweckspezifische CodeBuild-Service-Rolle für die optionale SemIf-Erweiterung.
- Eine AWS Identity and Access Management (IAM) -Rolle, die SageMaker AI annehmen kann.
- Berechtigungen für SageMaker AI, Amazon ECR, Amazon S3, CodeBuild, IAM-Pass-Roll-Aktionen und Amazon CloudWatch Logs.
- Kontingent für einen kompatiblen x86-CPU- oder NVIDIA-GPU-SageMaker-Echtzeit-Endpunkt.
Das Textgenerierungsbeispiel verwendet die CPU-DLC und eine feste CPU-Instance. Die SemIf-Erweiterung behält CPU als Standard für Workloads bei, die nicht latenzempfindlich sind, und bietet ein optionales CUDA-Image mit geordneten Instance-Pools. Prüfen Sie SageMaker AI-Preise , bevor Sie einen Endpunkt erstellen.
Bereitstellen eines Entscheidungsmodells und Erweitern mit SemIf
Verwenden Sie das folgende Verfahren, um den standardmäßigen Textgenerierungs-Endpunkt bereitzustellen, und erstellen Sie dann die optionale SemIf-Erweiterung für strukturierte Entscheidungen auf CPU oder GPU.
- Klonen Sie das Codebeispiel und installieren Sie seine Abhängigkeiten.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - Legen die Deployment-Werte für Ihr Konto fest.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - Pakettieren Sie das fixierte GGUF-Modell und den Tokenizer mit CodeBuild.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
Warten Sie, bis die zurückgegebene Build-ID
SUCCEEDEDerreicht. Der Build zeichnet die Quellrevisionen und Prüfsummen inmodel-manifest.jsonauf und bricht ab, wenn die GGUF-Prüfsumme vom validierten Wert abweicht. - Deployen Sie das GGUF-Modell mit dem AWS DLC für llama.cpp.
Lösen Sie ein digest-fixiertes
server-sagemaker-cpu-v1Image aus der AWS-DLC-für-llama.cpp-Dokumentationauf und erstellen Sie dann das SageMaker-AI-Modell, die Endpunkt-Konfiguration und den Endpunkt:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"Wählen Sie ein
server-sagemaker-cpu-v1- oderserver-sagemaker-cuda-v1Image statt des entsprechenden EC2-Images. Die SageMaker-AI-Images implementieren den/ping- und/invocationsContainervertrag und ordnen Aufruf-Payloads Chat-Completions zu.Diese Anleitung liefert das GGUF-Modell über das SageMaker-AI-Modell-Artefakt in Amazon S3. Alternativ können Sie
SM_LLAMA_CPP_HF_REPOundSM_LLAMA_CPP_HF_FILEkonfigurieren, um eine GGUF-Datei von Hugging Face herunterzuladen, wenn der Endpunkt über Netzwerk-Egress verfügt.Für diesen Pfad benötigen Sie weder ein Dockerfile noch ein ECR-Repository. Warten Sie, bis der Endpunkt den Status
InServiceerreicht, und senden Sie dann eine OpenAI-kompatible Chat-Anfrage:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - Erstellen Sie das optionale SemIf-Child-Image und ermitteln Sie seinen unveränderlichen Digest.
Für CPU:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
Für GPU erstellen Sie stattdessen das CUDA-Child-Image:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
Nach erfolgreichem Build konstruieren Sie die unveränderliche Image-URI:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
Das Deployment-Skript lehnt veränderliche Image-Tags ab.
- Deployen Sie den SemIf-Endpunkt.
Die CPU-Konfiguration verwendet einen festen Instanztyp:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
Warten Sie, bis der zurückgegebene Endpunktname den Status
InServiceerreicht. Dieser Pfad setztn_gpu_layers=0. Der Adapter serialisiert die Inferenz um einen zustandsbehafteten llama.cpp-Kontext. Skalieren Sie daher nach Messung Ihrer Workload mit Endpunkt-Instanzen horizontal, anstatt von paralleler Inferenz innerhalb eines Containers auszugehen.Geben Sie für das GPU-Image geordnete Instanzpools an und fordern Sie ein vollständiges Model Offload an:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
Instance-Pools sind geordnete Platzierungs-Fallbacks, kein Inferenz-Lastenausgleich. SageMaker wählt einen verfügbaren Typ für die Variante aus. Die Erstellung des Endpunkts kann länger dauern, während SageMaker AI den Pool durchläuft. Prüfen Sie die Startprotokolle auf die ausgewählte GPU und eine Meldung, die bestätigt, dass alle Modellschichten ausgelagert wurden.
- Rufen Sie den SemIf-Endpunkt mit der Beispielentscheidung auf.
Die Anfrage deklariert stabile IDs für jede erlaubte Option:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"Die Antwort bewahrt die Reihenfolge der Optionen und enthält bedingte Wahrscheinlichkeiten, rohe Logits, Token- und Prompt-Metadaten sowie die fixierte Modellidentität:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
Wenden Sie Schwellenwerte und Fallbacks auf Anwendungsebene an. Verwenden Sie keine Modellentscheidung als Ersatz für eine Autorisierung.
Aufräumen
Löschen Sie den SageMaker-AI-Endpunkt, die Endpunktkonfiguration und das Modell:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
Das Skript löscht nur die explizit genannten SageMaker-AI-Ressourcen. Löschen Sie die CodeBuild-Projekte, das ECR-Repository, Modell- und Quellobjekte in Amazon S3, Protokolle und zweckgebundene IAM-Rollen, wenn Sie sie nicht mehr benötigen.
Fazit
Das AWS DLC für llama.cpp bietet Ihnen eine verwaltete Grundlage für den Betrieb von Entscheidungsmodellen auf SageMaker AI über CPU- und GPU-Instances hinweg. Es kann GGUF-Modelle aus SageMaker-AI-Modellartefakten oder einem konfigurierten Hugging-Face-Repository laden und dann OpenAI-kompatible Chat-Completions bereitstellen über InvokeEndpoint ohne dass ein benutzerdefinierter Container erforderlich ist. Wenn Ihre Anwendung direkte Logits und Modellzustandsoperationen benötigt, können Sie das DLC mit einem SemIf-Adapter erweitern. Wählen Sie CPU für Workloads, die nicht latenzempfindlich sind, und GPU, wenn Prompt-Prefill und Tail-Latenz die Anwendungserfahrung beeinflussen.
Sehen Sie sich die Codebeispiel, AWS-DLC-für-llama.cpp-Dokumentationsowie die SageMaker-AI-Vertragsbedingungen für benutzerdefinierte Inferenzcontainer an, um die Bereitstellung für Ihre Workload anzupassen.