
Dieser Beitrag zeigt, wie man ein großes Sprachmodell (LLM) auf zwei GPU-Knoten auf Amazon Elastic Kubernetes Service (Amazon EKS) mit der Multi-Node bereitstellt. Ray LLM Deep Learning Containers. Es verwendet separate Prefill- und Decode-Knoten hinter einem OpenAI-kompatiblen Endpunkt. Diese Art von Multi-Node-Setup ist bei Tensor-, Pipeline- und Datenparallelität sowie bei Prefill/Decode-Disaggregation-Inference-Workloads üblich. In einem vorheriger Beitrag, stellten wir die Ray Serve DLC und damit ein kleines Modell hinter einem HTTP-Endpunkt auf einem einzelnen GPU-Knoten aufgesetzt. Man hatte einen funktionierenden Inferenz-Endpunkt, und der Container hält den GPU-Stack kompatibel, einschließlich der CUDA-Bibliotheken, sodass kein Boilerplate-Code geschrieben werden musste.
Ray ist ein verteiltes Rechen-Framework, sodass Ray Serve Deployments sich über mehrere Knoten erstrecken können. Kunden nutzen Multi-Node Ray Serve aus mehreren Gründen. Einige möchten Foundation- oder Open-Weight-Modelle ausführen, die zu groß für eine einzelne GPU sind. Andere benötigen mehr Durchsatz, als ein einzelnes Replikat liefern kann. Wieder andere möchten die beiden Phasen der Inferenz trennen, um die Leistung zu verbessern. In jedem Fall müssen Kunden die Abhängigkeitskette selbst aufbauen: kompatible Bibliotheken für den GPU-Stack auswählen und Probleme beheben, wenn eine Komponente aus der Übereinstimmung gerät. Das ist Arbeit ohne Mehrwert, die Zeit und Aufwand von der Bereitstellung von Modellen abzieht.
AWS Deep Learning Containers "(DLCs) haben diese Art von Problem für Trainings- und Inferencing-Workloads schon lange gelöst. DLCs sind vorgefertigte, leistungsoptimierte Docker-Images, die ein Framework, seine Abhängigkeiten und den GPU-Stack in einer getesteten und gepatchten Kombination bündeln, die Sie sofort abrufen und verwenden können. Mit dem Launch der Ray LLM DLC für Multi-Node-Deployments erstreckt sich derselbe Ansatz nun auch auf Multi-Node-Inferenz. Sie erhalten einen Container, der speziell für das Serving von Modellen hinter einem HTTP-Endpoint entwickelt wurde, von AWS gepflegt und getestet, mit bereits komplett zusammengestelltem Inferenz-Stack.
Dieser Beitrag führt durch die Implementierung von verteilter Inferenz über mehrere Knoten hinweg unter Verwendung des Multi-Node Ray LLM DLC: Bereitstellung eines einzelnen großen Sprachmodells auf zwei GPU-basierten Knoten auf Amazon EKS das hinter einem einzelnen Endpunkt zusammenarbeiten. Während einer der GPU-Knoten die Prefill-Phase verarbeitet, übernimmt der andere GPU-Knoten die Decode-Phase. Die Trennung der Phasen verhindert, dass rechenintensive lange Prompts die Token-Generierung für bereits laufende Anfragen blockieren. Dieser Ansatz eignet sich gut für Workloads wie Retrieval Augmented Generation (RAG), Dokumentenzusammenfassung und agentische Anwendungen. Wir verwenden das Multi-Node-Ray-LLM-DLC, das geliefert wird Ray Serve LLM, NVIDIA Inference Transfer Library (NIXL), und die Elastic Fabric Adapter (EFA) Stack und stellt eine OpenAI-kompatible API bereit, ohne dass Anwendungscode nötig ist. Der vollständige Code ist in der begleitendes Repository.
Warum Prefill/Decode (PD) Disaggregation
Die LLM-Inferenz besteht aus zwei verschiedenen Phasen. Prefill verarbeitet den gesamten Eingabeprompt parallel und baut den Key-Value-(KV)-Cache auf. Entschlüsseln und erzeugt dann die Antwort Token für Token, indem es diesen Cache liest und erweitert. Prefill ist rechenlastig (compute bound), und Decode ist durch die Speicherbandbreite begrenzt. Wenn beide Phasen sich eine GPU teilen, konkurrieren sie um dieselben Ressourcen, und die schwankungsanfällige, rechenintensive Prefill-Arbeit beeinträchtigt die gleichmäßige, latenzempfindliche Decode-Arbeit. Die Trennung der Prefill-Phase von der Decode-Phase bedeutet, dass Sie die Hardware und die Serving-Eigenschaften für jede Phase einzeln auswählen können, was die Gesamtleistung bei Skalierung verbessert.
Die PD-Disaggregation verlagert die beiden Phasen auf separate Knoten, sodass jede Phase ohne Beeinträchtigung der anderen läuft und unabhängig skaliert werden kann. Der Nachteil besteht darin, dass der während des Prefill aufgebaute KV-Cache an den Decode-Knoten übergeben werden muss, und diese Übertragung sollte schnell genug sein, um den Vorteil nicht zunichtezumachen. Genau deshalb ist die Verbindung zwischen den Knoten so wichtig.
Was die Ray LLM DLC bietet
AWS DLCs sind vorgefertigte, leistungsoptimierte Docker-Images, die ein Framework, seine Abhängigkeiten und den GPU-Stack in einer getesteten, gepatchten Kombination bündeln, die Sie sofort abrufen und verwenden können. Alle Komponenten werden vor jeder Veröffentlichung gemeinsam validiert, sodass es keine Versionsabweichung zwischen der CUDA-Laufzeit, dem Framework und der Serving-Schicht gibt. Sicherheitspatches werden zur Build-Zeit angewendet.
Die Ray LLM DLC erweitert dies auf verteiltes LLM-Serving. Sie liefert vLLM als Inferenz-Engine, Ray Serve’s HTTP als Serving-Schicht, NIXL für die KV-Cache-Übertragung zwischen Knoten und den EFA-Stack (libfabric und aws-ofi-nccl) für die Hochbandbreit-Kommunikation zwischen Knoten. Da die Ray Serve LLM library einen integrierten Application Builder enthält, ist die gesamte Serving-Anwendung ein Block YAML. Es gibt keine Handler-Klasse, keinen Model Archiver und kein benutzerdefiniertes Image zu erstellen. Ein einzelner Helfer, build_pd_openai_app, nimmt eine Prefill-Konfiguration und eine Decode-Konfiguration entgegen und verdrahtet die KV-Cache-Übertragung zwischen ihnen hinter einem einzigen OpenAI-kompatiblen Endpunkt.
Architektur
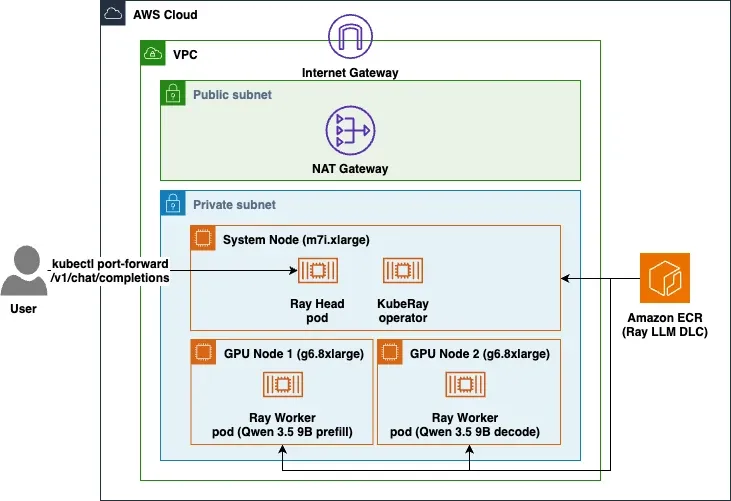
Das folgende Diagramm zeigt, wie die Bereitstellung auf Amazon EKS aufgebaut ist. Eine Benutzeranfrage erreicht den Ray Head auf dem CPU-Systemknoten, und die beiden GPU-Worker-Knoten führen die Prefill- und Decode-Phasen des Modells aus.
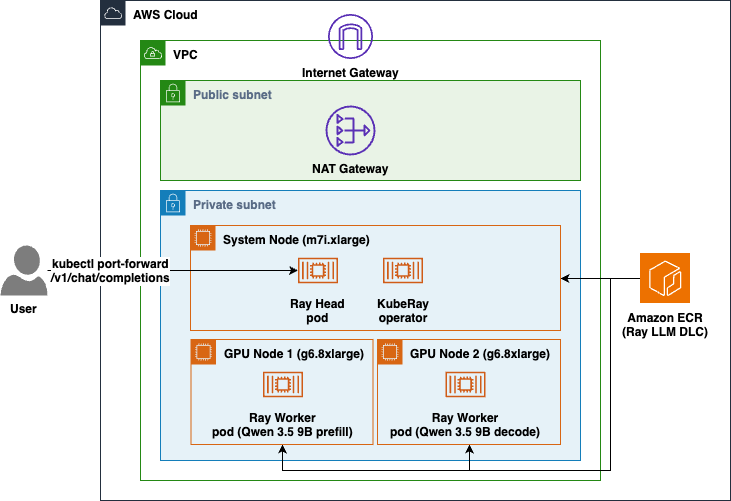
Abbildung 1: Multi-Node-Inferenzarchitektur auf Amazon EKS, mit dem Ray Head auf einem CPU-Systemknoten und den Prefill- und Decode-Phasen auf zwei GPU-Worker-Knoten
Die Bereitstellung ist ein EKS-Cluster innerhalb einer Virtual Private Cloud (VPC). Knoten laufen in privaten Subnetzen mit ausgehendem Zugriff über ein NAT Gateway. Ein CPU- system node (m7i.xlarge) hostet System-Workloads, den KubeRay Operator und den Ray-Head-Pod, der nur CPU verwendet. Zwei GPU- worker nodes (g6.8xlarge) führen die Ray-Worker aus: einer bedient die Prefill-Phase, der andere die Decode-Phase. Beide Knoten ziehen die Ray LLM DLC aus der Amazon Elastic Container Registry (Amazon ECR).
KubeRay überwacht die RayService, die Sie anwenden, und verdrahtet die Head-to-Worker-Verbindung automatisch. Ray Serve platziert die Prefill- und Decode-Deployments auf den beiden GPU-Workern. Der KV-Cache fließt über NIXL vom Prefill-Worker zum Decode-Worker, wobei EFA über NIXL’s libfabric-Backend genutzt wird. Die GPU-Knotengruppe ist auf eine einzelne Availability Zone (AZ) festgelegt, da EFA keine AZ-übergreifende Kommunikation ermöglicht.
Voraussetzungen
Um diesem Beitrag zu folgen, benötigen Sie:
- Ein AWS-Konto mit aktivierter Abrechnung.
- Ausreichendes Service-Kontingent für den Betrieb von zwei g6.8xlarge-Instanzen (mindestens 64 vCPU) in Ihrer Ziel-Region.
- AWS Command Line Interface (AWS CLI) mit konfigurierten Anmeldeinformationen.
- kubectl-CLI zur Kommunikation mit der Control Plane eines Kubernetes-Clusters.
- eksctl-CLI zum Erstellen und Verwalten von Clustern auf EKS.
- helm (Paketmanager für Kubernetes) zur Installation des KubeRay-Operators.
- envsubst-Dienstprogramm (Teil von GNU gettext) zum Rendern des Manifests.
Überprüfen Sie mit dem folgenden Befehl, ob Ihre AWS-Anmeldeinformationen aktiv sind:
aws sts get-caller-identityVerwenden der vorgefertigten Anwendung für Inferenz
Die Anwendung ist der serveConfigV2 Block in manifest/rayservice.yaml. Sie verwendet build_pd_openai_app, das einen prefill_config und einen decode_config entgegennimmt und die KV-Cache-Übertragung zwischen ihnen verbindet:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
Wenige Einstellungen tragen den größten Teil der Wirkung. max_model_len: 4096 passt die Kontextgröße an den gemessenen KV-Cache auf der GPU an. dtype: bfloat16 und gpu_memory_utilization: 0.90 legen die Präzision fest sowie wie viel VRAM vLLM belegen darf. enforce_eager: true überspringt das Capture von CUDA-Graphen, um den maximalen GPU-Speicherverbrauch zu reduzieren (modell- und eingabeabhängig). Die kv_transfer_config -Einstellung macht Disaggregation überhaupt erst möglich: Beide Phasen verwenden NixlConnector mit kv_role: kv_both und einem jeweiligen engine_id (Prefill auf dem einen, Decode auf dem anderen). Die entscheidende Einstellung ist kv_connector_extra_config: { backends: ["LIBFABRIC"] }. Ohne diese Zeile greift NIXL standardmäßig auf UCX zurück, was selbst auf EFA mit TCP-Geschwindigkeit läuft.
Der Rest des Manifests, in rayClusterConfig, beschreibt die Pods. Der Head-Pod ist CPU-only (num-gpus: "0") und an die System-Node-Group gebunden. Jeder Worker-Pod fordert eine GPU und ein EFA-Interface an (nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1") und zielt über nodeSelector: { role: gpu-worker }auf die GPU-Knoten. Er läuft privileged: true , weil NIXL CUDA-VRAM bei der EFA-NIC registriert. Die IPC_LOCK -Capability allein reicht nicht aus. Die Worker setzen FI_PROVIDER=efa, lesen VLLM_HOST_IP aus der Pod-IP und mounten ein Shared-Memory-Volume. Die Speicherlimits liegen deutlich über den rund 18 GiB des Checkpoints, damit der OS-Page-Cache diesen halten kann. Beim Laden des Qwen3.5-9B-Modells auf g6.8xlarge mit der oben genannten Cache-Konfiguration sinkt das Laden der Modellgewichte bei einem Neustart von rund 145 Sekunden auf etwa 2 Sekunden.
Auf Amazon EKS bereitstellen
Alle Skripte teilen sich eine einzige Konfigurationsdatei, scripts/env.sh. Das Skript enthält Standardwerte für CLUSTER_NAME, REGION, K8S_VERSIONund NAMESPACE. Weitere Standardwerte betreffen die System- und GPU-Node-Groups, die KubeRay-Version und das Modell. Überschreiben Sie eine beliebige Variable, indem Sie sie vor dem Ausführen eines Skripts exportieren.
Setzen Sie vom Projektstamm aus ein Basisverzeichnis und laden Sie dann die Variablen:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
Schritt 1: Erstellen des EKS-Clusters
./deploy_cluster.shDies stellt den EKS-Cluster bereit (VPC, OIDC-Provider, Core-Add-ons) sowie eine CPU-System-Node-Group, die System-Workloads, den KubeRay-Operator und den Ray-Head ausführt. Die Nodes laufen in privaten Subnetzen mit Egress über ein NAT Gateway, und die Cluster-Subnetze werden in den Availability Zones platziert, die den GPU-Instanztyp anbieten. Das Skript ist idempotent und dauert bei einem ersten Lauf 15–20 Minuten.
Schritt 2: GPU-Worker-Nodes hinzufügen
./deploy_node_group.shDies erstellt die GPU-Node-Group: zwei g6.8xlarge-Instanzen mit aktiviertem EFA, an eine einzige AZ gebunden und gelabelt, role=gpu-worker sodass die Ray-Worker diese ansteuern. Die Aktivierung von EFA installiert auch das EFA Device Plugin, das vpc.amazonaws.com/efa auf jedem Node anzeigt. Dieser Schritt dauert etwa 5-20 Minuten, bei einem ersten Lauf meist länger.
Schritt 3: Den KubeRay-Operator installieren
./install_kuberay.shDies installiert den KubeRay-Operator mit Helm, gebunden an die System-Node-Group, damit die GPU-Nodes für Inferenz verfügbar bleiben. KubeRay beobachtet den RayService, den Sie im nächsten Schritt anwenden, und verdrahtet das Head-to-Worker-Joining automatisch. Dieser Schritt dauert etwa 1–2 Minuten.
Schritt 4: Den RayService bereitstellen
./deploy_ray_service.shDies rendert manifest/rayservice.yaml mit Ihren Image-, Modell- und Namensvariablen mittels envsubst und wendet es an. KubeRay erstellt den Head- und zwei Worker-Pods, und Ray Serve LLM bringt die Prefill- und Decode-Deployments hoch. Das Skript wartet darauf, dass der Head Ready ist, beide Worker Running sind und schließlich die Serve-App RUNNING meldet. Da jeder Node das Modell lädt, erwarten Sie für diesen Schritt mehrere Minuten.
Überprüfen Sie jederzeit den Status, einschließlich der Frage, auf welchem Node sich jeder Pod befindet und welche GPU-Kapazität verfügbar ist:
./deploy_ray_service.sh statusDas Modell aufrufen
Nachdem die Serve-App fehlerfrei ist, erstellt KubeRay einen stabilen <rayservice-name>-serve-svc Service. Leiten Sie mit Port-Forwarding dorthin weiter:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000Da das DLC eine OpenAI-kompatible API bereitstellt, können Sie Modelle auflisten und eine Standard-Chat-Completion-Anfrage ohne benutzerdefiniertes Schema senden:
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
Verifizieren, dass EFA verwendet wird
NIXL fällt auf einen Transport mit TCP-Geschwindigkeit zurück, wenn es libfabric nicht verwenden kann, und tut dies, ohne einen Fehler auszulösen, daher lohnt es sich, das gewählte Backend zu bestätigen. Durchsuchen Sie die Worker-Logs mit grep:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh gibt beim Erstellen der Group bereits die vpc.amazonaws.com/efa -Anzahl pro Node aus. Für eine bandbreitenbezogene Zahl über Nodes hinweg liefert das DLC einen vorgefertigten NVIDIA Collective Communications Library (NCCL)-Benchmark unter /usr/local/bin/all_reduce_perf.
Aufräumen
Um laufende Kosten zu vermeiden, entfernen Sie die Ressourcen in umgekehrter Reihenfolge:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
Fazit und nächste Schritte
Sie haben ein einzelnes Modell über zwei GPU-Nodes hinweg mit Prefill/Decode-Disaggregation bereitgestellt, und die gesamte Anwendung war ein YAML-Block – ohne Handler-Code, ohne Model Archiver und ohne handmontierten GPU- und EFA-Stack. Das Multi-Node-Ray-LLM-DLC lieferte den getesteten Inferenz-Stack, KubeRay orchestrierte den Ray-Cluster, und NIXL über EFA transportierte den KV-Cache zwischen den Nodes. Ihre Aufgabe war es, es zu konfigurieren, nicht zu bauen.
Gängige Muster für den Betrieb von Multi-Node-Inferenz sind Tensor- und Pipeline-Parallelismus (Sharding eines Modells, das zu groß für eine Instanz ist), Datenparallelismus (Replizieren eines Modells für höheren Durchsatz) und Prefill/Decode-Disaggregation (Trennen der beiden Inferenzphasen auf verschiedene Nodes).
Von hier aus können Sie die Decode-Replikate für mehr Durchsatz skalieren, zu größeren Modellen mit Tensor- oder Pipeline-Parallelismus auf größeren GPU-Instanzen wechseln oder zusätzliche Bibliotheken auf dieselbe getestete Basis legen, wenn Modelle sie benötigen. Den vollständigen Code, die aktuelle Liste der Image-Tags und die zugrunde liegenden Mechanismen finden Sie im begleitenden Repository, die Ray LLM DLC verfügbaren Images Seite, die Ray Serve LLM Prefill/Decode-Dokumentationsowie die EFA-Dokumentation.