

Metas neues Frontier-Modell Muse Wonder Full drängt sich in die Spitzenklasse der KI ein
 Matthias Bastian
Das LinkedIn-Profil von Matthias Bastian ansehen
Oct 12, 2026
 Meta
Schlüsselpunkte
- Metas zwei neuen Modellen, Muse Wonder und Muse Wonder Full, schließen den Abstand zu den führenden Modellen.
- Die größten Vorteile liegen im agentischen Coding und der autonomen Problemlösung.
- Beide Versionen kosten fast dreimal so viel pro API-Aufruf wie ihre Vorläuferversion, die Muse Spark 1.3.
Meta veröffentlichte das Frontier-Modell Muse Wonder in zwei Varianten – und beide gehören zu den besten AI-Modellen, die es gibt.
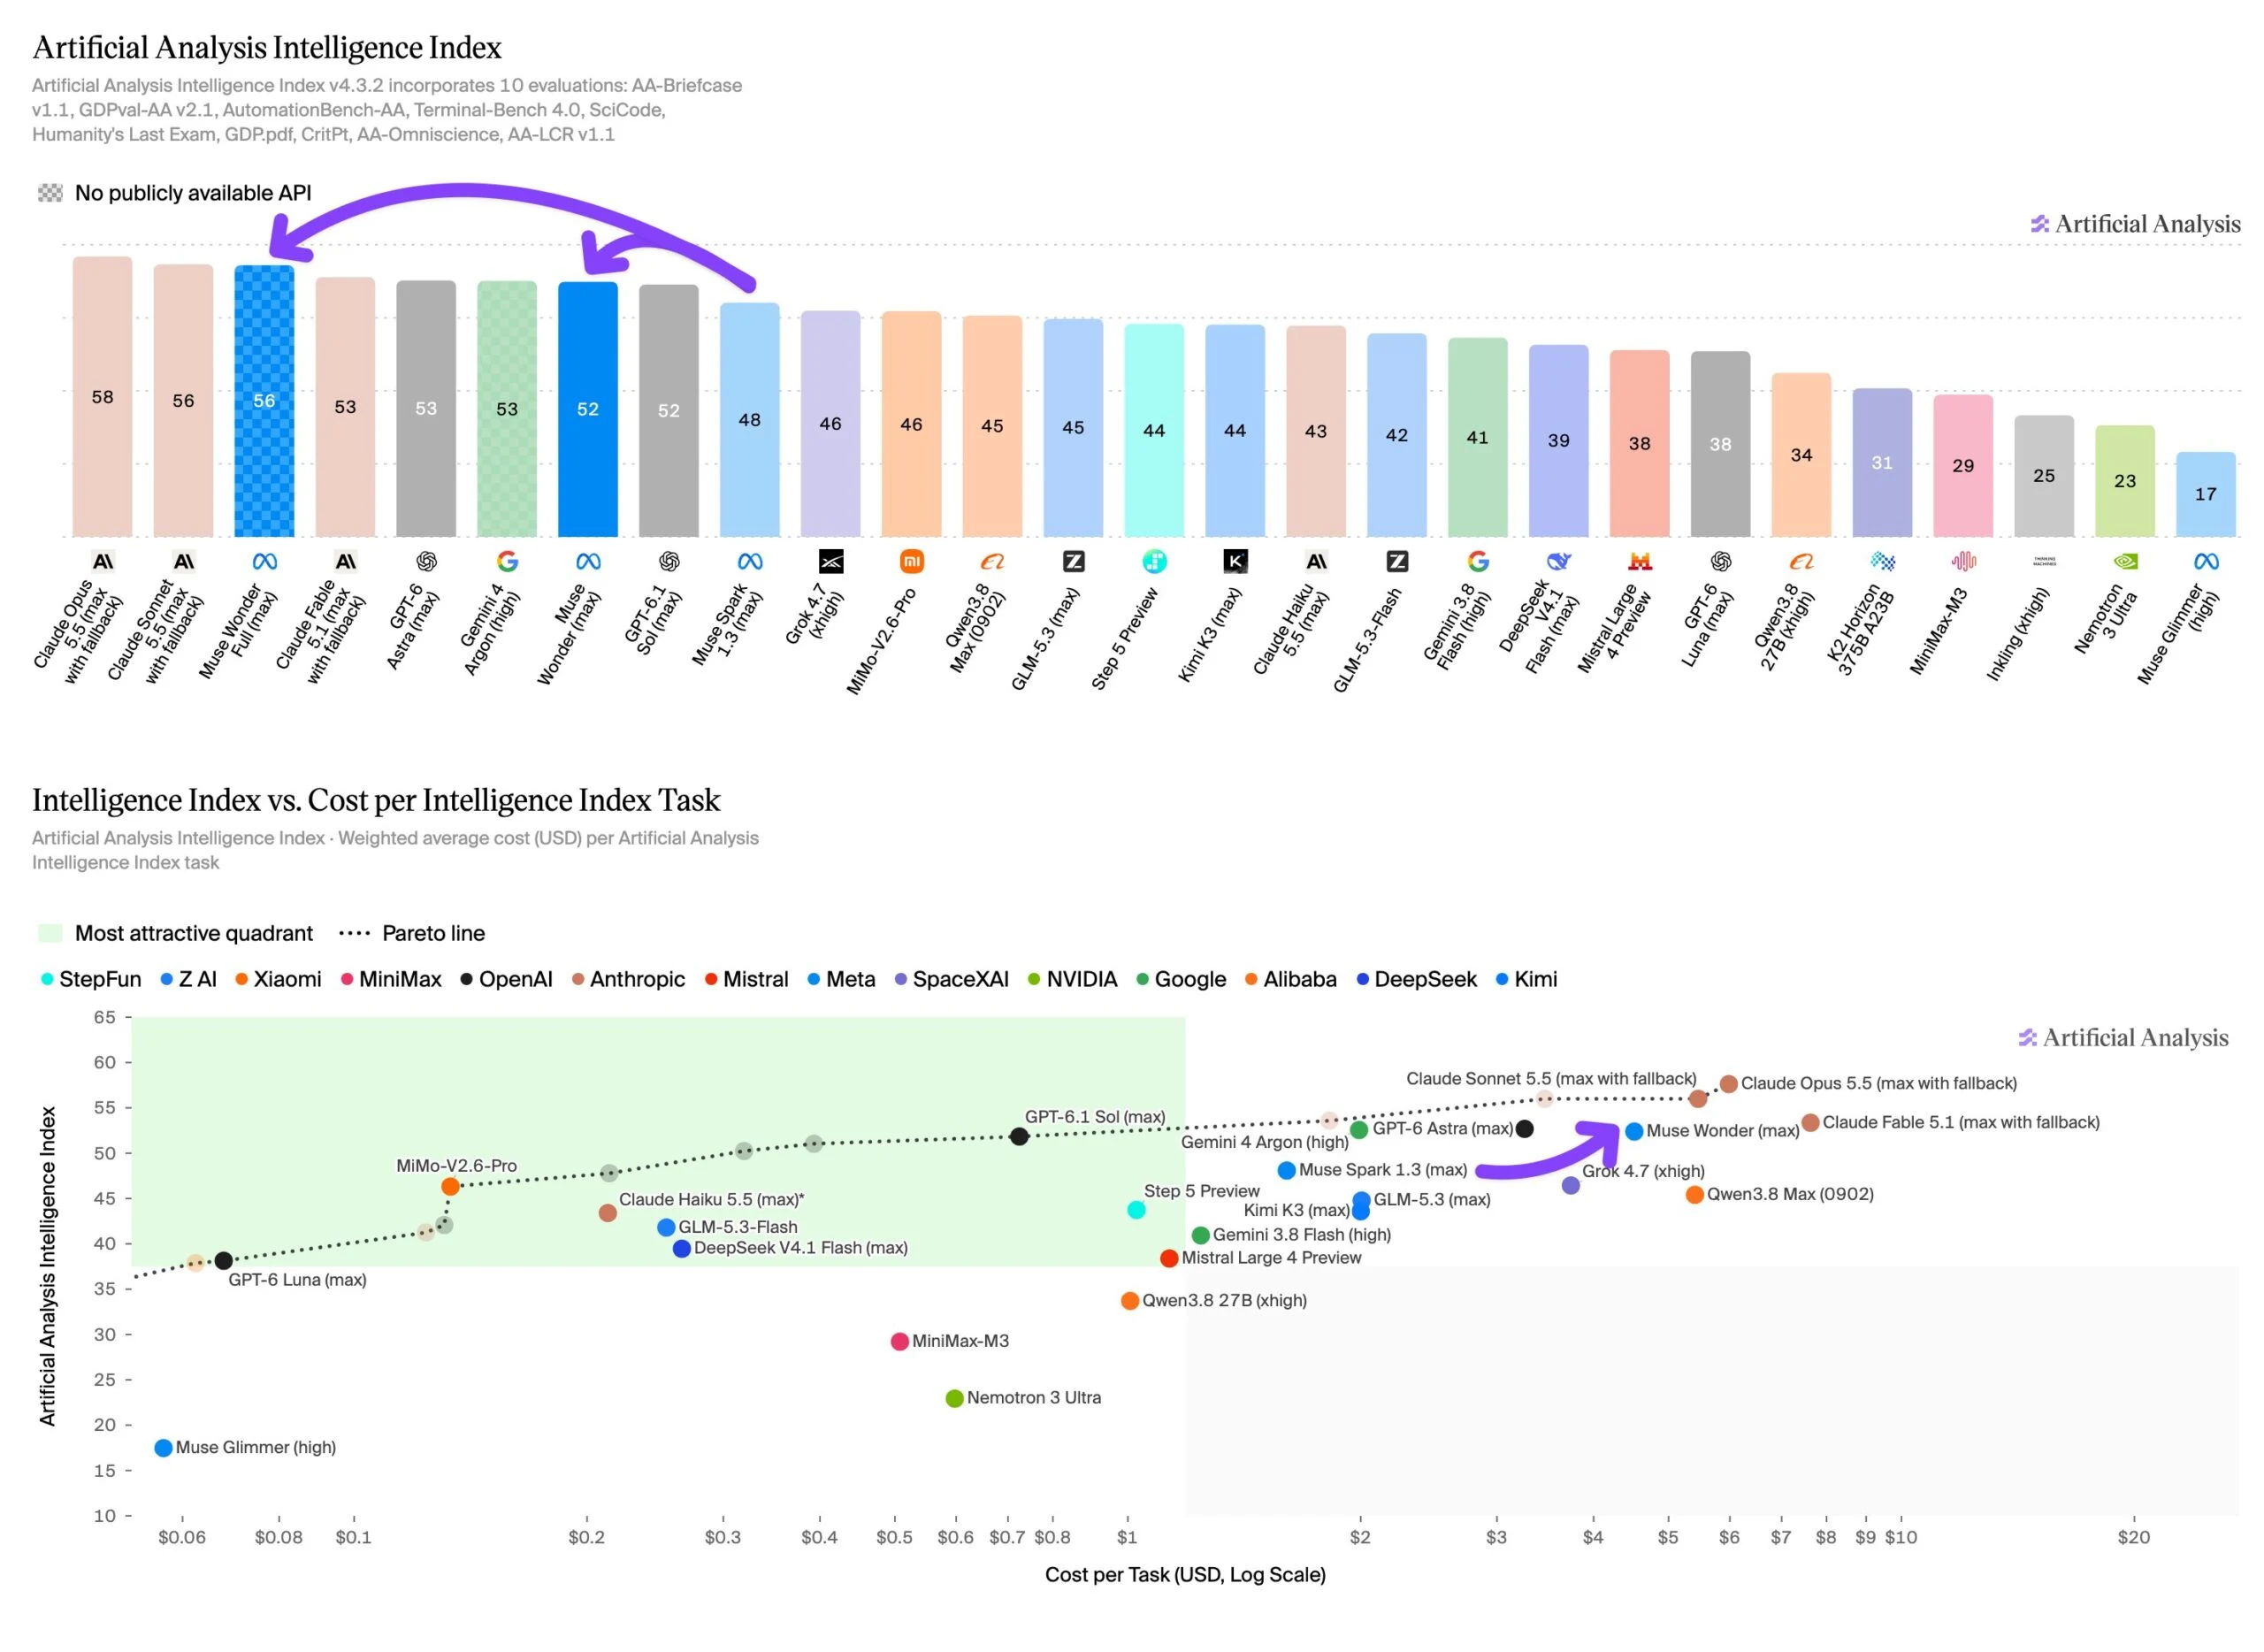
Muse Wonder Full erzielt 56 Punkte im Artificial Analysis Intelligence Index v4.3, während Muse Wonder 52 Punkte erreicht. Sein Vorgänger, Muse Spark 1.3, erreichte 48 Punkte, was einen signifikanten Sprung von einem mittelklassigen Modell darstellt.
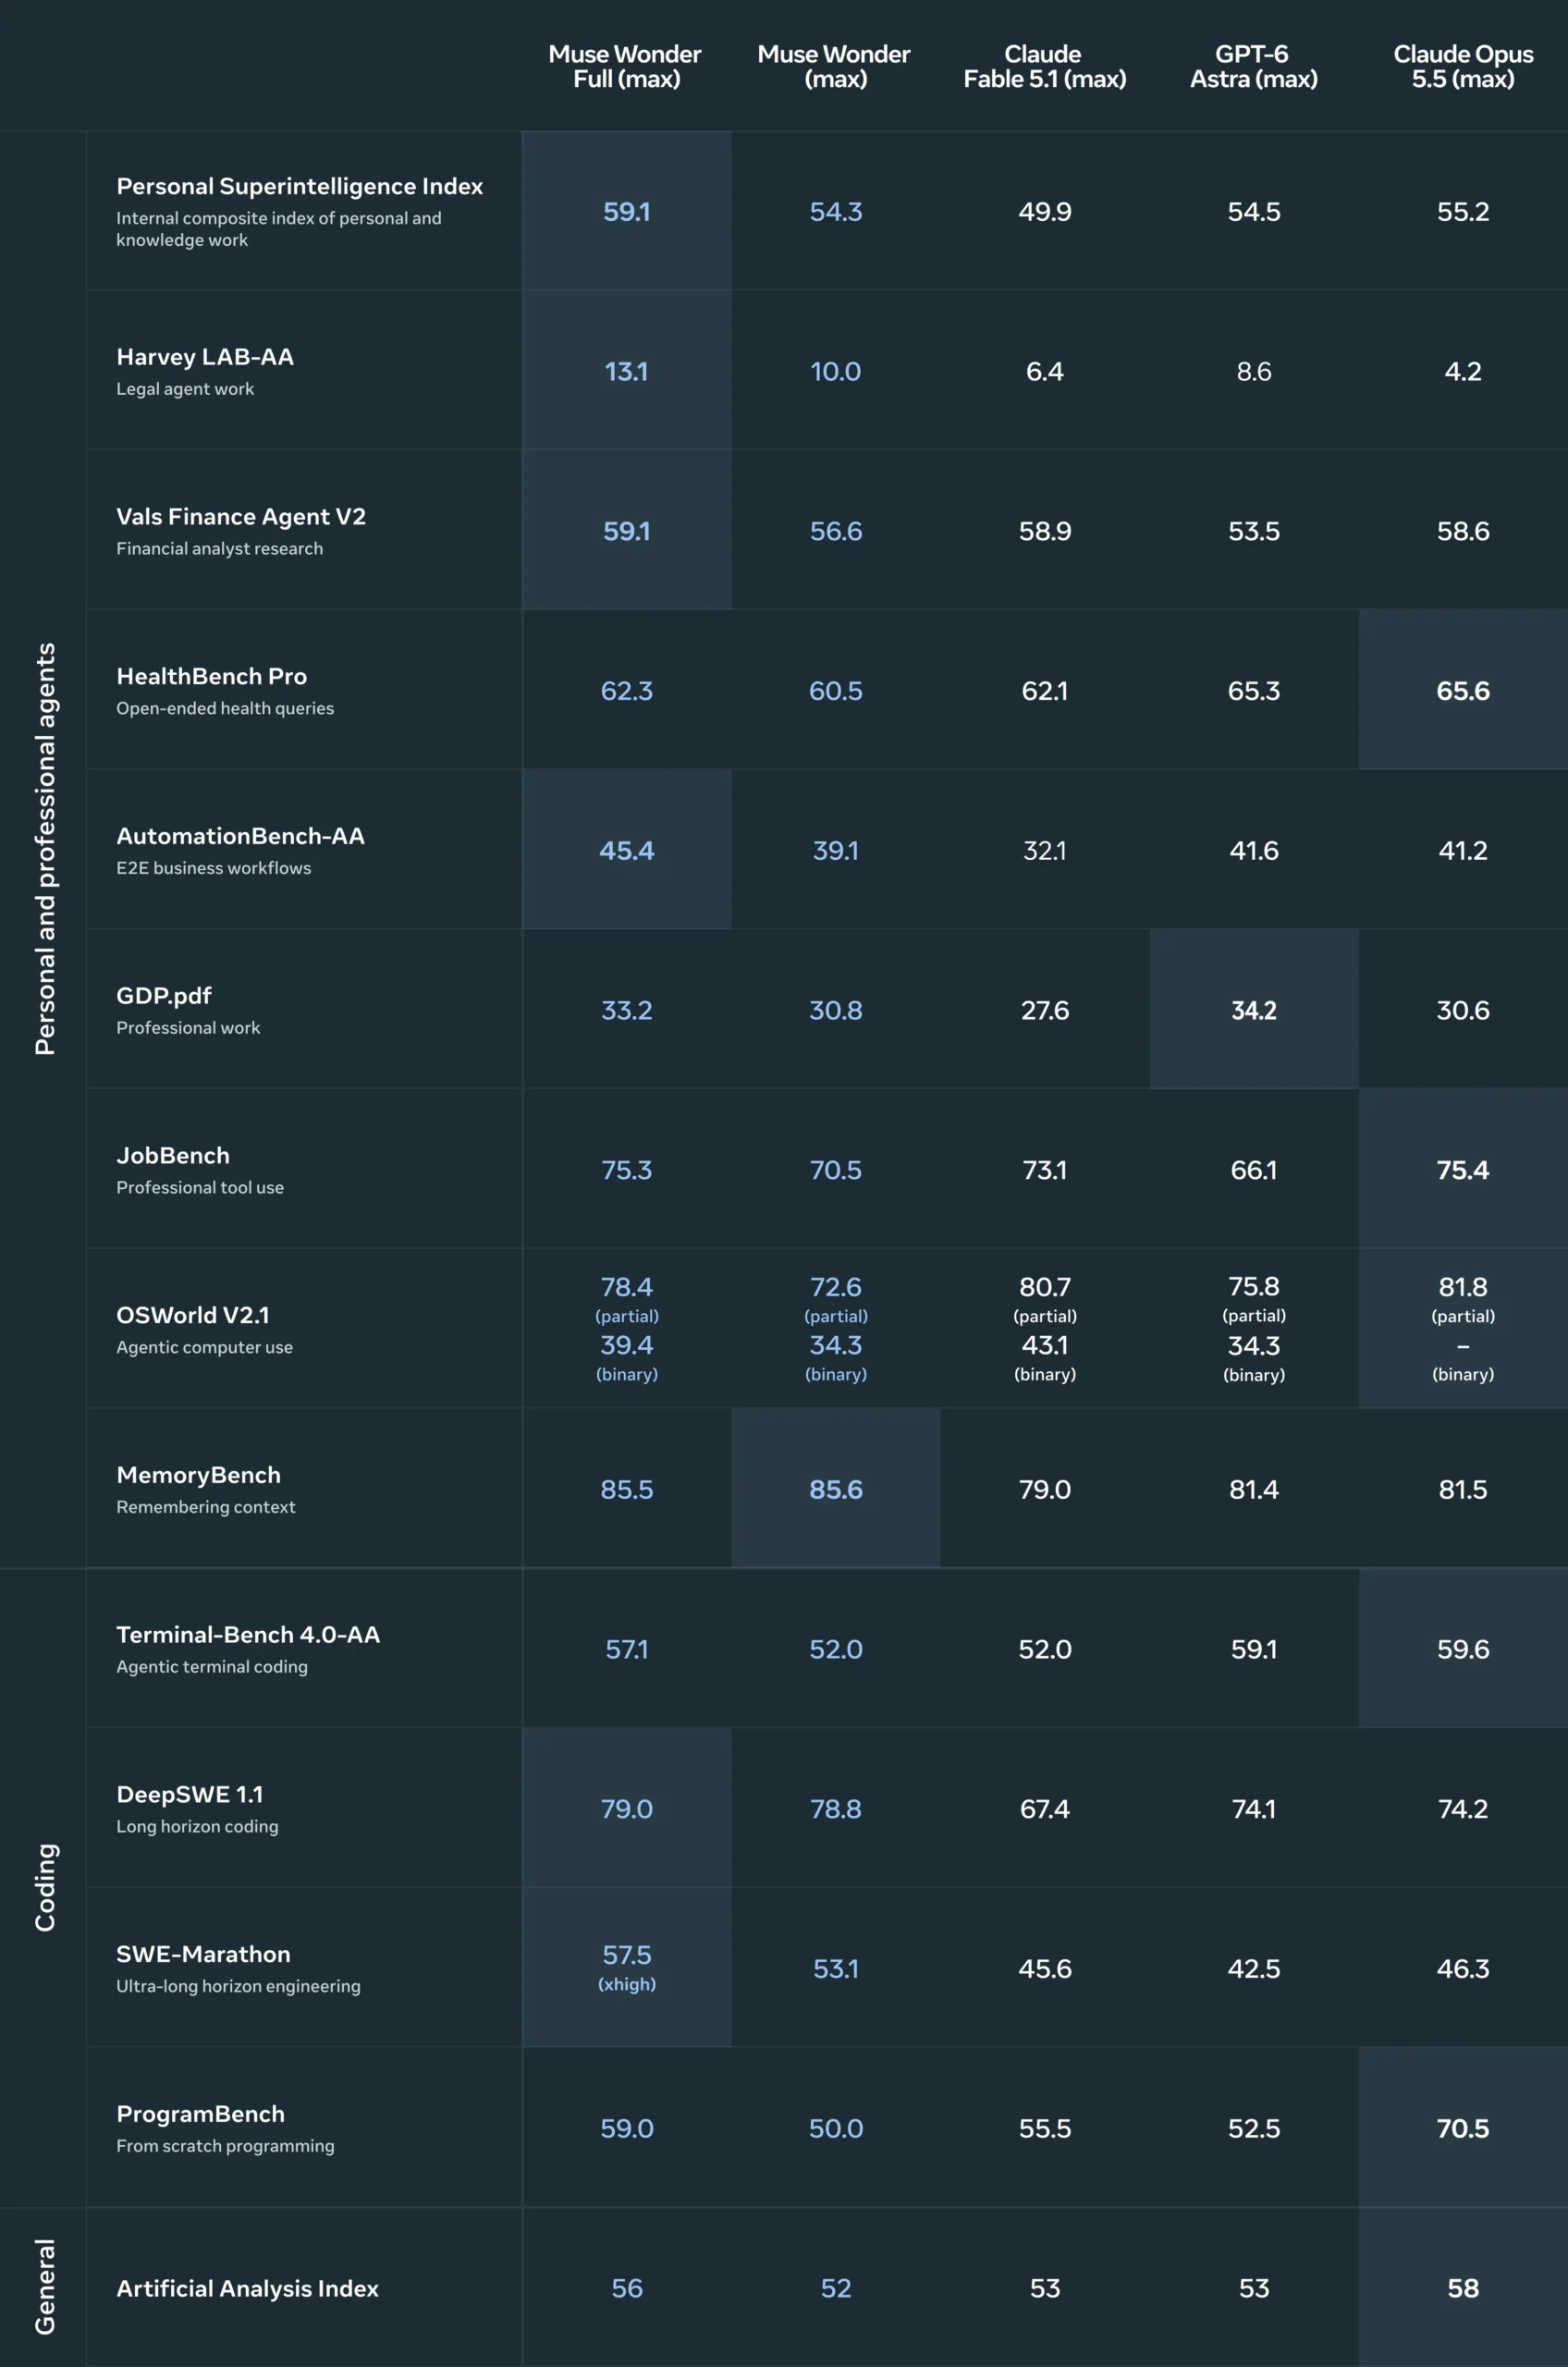
Die größten Erfolge zeigen sich in agentischen Bewertungen – Tests, die messen, wie gut ein KI-Modell allein komplexe Aufgaben bewältigen kann. Auf dem Terminal-Bench 4.0 stieg die Leistung von 33 auf 57 Prozent. Muse Wonder Full belegt in sechs von zehn Benchmarks insgesamt Platz eins, was ein starkes Ergebnis für Meta ist, das nach einer schwächeren Phase mit seinen offenen Llama-Modellen wieder auf die Beine kommt.
Meta hebt zwei neue Funktionen hervor. „Active Memory“ ermöglicht es dem Modell, wichtige Informationen über verschiedene Gespräche zu speichern und sie bei Bedarf wieder abzurufen. „Active Focus“ ist die Fähigkeit des Modells, schwierige Aufgaben durchzuziehen, alternative Ansätze auszuprobieren und nachforschende Fragen zu stellen, wenn etwas unklar ist. Beides ist zentral für Metas Angebot eines persönlichen AI-Agenten, der Zugriff auf Kalender, Nachrichten und Dokumente hat.
Beide Modelle unterstützen eine Kontextfenstergröße von einer Million Tokens und akzeptieren Text, Bilder, Videos und Audiodaten als Eingabe. Muse Wonder ist über die Meta’s API sowie die Muse Code verfügbar, während Muse Wonder Full derzeit nur für Nutzer von Muse Code verfügbar ist. Muse Wonder wird bald auch die Muse-App unterstützen, angefangen bei bezahlten Abonnenten. Im Laufe der Zeit plant Meta, spezialisierte Modelle aus diesem Datenpool für alle Nutzer zu entwickeln.
Die Kodierung springt stark, aber das faktische Wissen bleibt zurück.
Beide Modelle zeigen große Verbesserungen im Kodieren. Der Muse Wonder Full erreicht 68 Punkte auf der Coding Agents-Index-Liste und schließt Claude Code mit Sonnet 5,5 ab. Der Muse Wonder erzielt 63 Punkte – mehr als die 54 Punkte seines Vorgängers.
Faktisches Wissen bleibt ein Schwachpunkt. Bei der AA-Omniscience-Wissensprüfung erzielt Muse Wonder Full nur 30 Punkte, und Muse Wonder erreicht 25 Punkte. Das liegt deutlich hinter Claude Opus 5.5 (46), GPT-6 Astra (43) und Gemini 4 Argon (42). Dies deutet darauf hin, dass die Wonder-Serie auf einem kleineren Basismodell basiert als ihre Konkurrenten. Niedrige Halluzinationen helfen, diesen Unterschied auszugleichen. Muse Wonder Full senkt seine Halluzinationen von 33 Prozent auf 23 Prozent im Vergleich zu seinem Vorgänger – das ist das zweitniedrigste Niveau unter allen Modellen, die mindestens 45 Indexpunkte erreichen. Nur Gemini 4 Argon (15 Prozent) verursacht seltener Halluzinationen.
Meta beantwortet eine häufige Kritik in seinem Blogbeitrag, dass die Muse-Modelle für Benchmarktests optimiert sind, aber im realen Einsatz versagen. Das Unternehmen sagt, dass Muse Wonder Full bei unbekannten Aufgaben besser abschneidet als erwartet, und zwar ohne dass dies Teil der Optimierung des Trainings war, und zieht dies auf eine stärkere Grundmodell zurück.
Bei dem Vals AI Index erreicht Muse Wonder Full (Max) den fünften Platz und übertrifft alle OpenAI-Modelle, wie Vals AI berichtet. Nur die aktuellen Anthropic-Modelle erzielen höhere Punkte. Muse Wonder erreicht den zehnten Platz.
Die größten Verbesserungen kommen von der Programmierung und den Mathematikaufgaben. Auf ProofBench, einem privaten Benchmark für mathematische Beweise, löst Muse Wonder Full 94 von 100 Aufgaben – gegenüber 58 bei dem Vorgänger. Damit liegt sie nur fünf bis sechs Punkte hinter den Top-Modellen (99 bis 100). Auf Terminal-Bench 4 verdoppelte sich die Leistung von Muse Wonder Full, obwohl die Anzahl der Ausgabetoken um 30 Prozent reduziert wurde. Die Leistung bei Finanz- und Rechtsaufgaben blieb auf dem Niveau des Vorgängers, sank jedoch um bis zu zwei Punkte.
Bessere Leistung hat einen hohen Preis
Laut der künstlichen Analyse kostet Muse Wonder $4,52 pro Aufgabe auf dem Intelligenzindex – fast dreimal so viel wie Muse Spark 1,3 ($1,60). Die Preise für Token sind ebenfalls gestiegen: $4 pro Million Einzeltoken und $20 für das Output, gegenüber $1,25 und $4,25 beim Vorgänger. Muse Wonder verwendet außerdem 28 Prozent mehr Einzeltoken pro Aufgabe, und diese machen 76 Prozent der Gesamtkosten aus.
Das liegt Muse Wonder unter Claude Fable 5.1 ($7.63) und Claude Opus 5.5 ($5.98) in den Preisen, aber über GPT-6 Astra ($3.26), Gemini 4 Argon ($1.99) und GPT-6.1 Sol ($0.72). Es gibt noch keine Tokenpreise für Muse Wonder Full. Beide Modelle verwenden etwa 10 Prozent weniger Ausgabe-Tokens als ihr Vorgänger.
Meta gibt an, dass sie die Modelle im eigenen Prometheus-Datacenter auf Gigawatt-Ebene trainiert hat. Weitere Details finden sich in der Modelleintragung.
AI-News ohne Hype – von Menschen zusammengestellt
Abonnieren Sie THE DECODER, um eine adsfreie Lektüre, ein wöchentliches AI-Newsletter, unseren exklusiven „AI Radar“-Frontier-Report sechsmal pro Jahr, Zugang zum vollständigen Archiv und Zugang zur Kommentarspalte zu erhalten.
Quelle: Meta | Artificial Analysis | Model-Karte